


Pathways est un système conçu pour permettre la création de systèmes de machine learning (ML) à grande échelle, multitâches et à activation partielle. Il vous permet d'utiliser des milliers ou des dizaines de milliers d'accélérateurs, avec la possibilité d'allouer dynamiquement différentes quantités de ressources de calcul pour différentes tâches en fonction de leurs exigences de traitement.
Pathways simplifie les calculs de ML à grande échelle en permettant à un seul client JAX d'orchestrer des charges de travail sur de grandes tranches de TPU, qui peuvent s'étendre sur des milliers de puces TPU.
Google utilise Pathways en interne pour entraîner des modèles volumineux tels que Gemini. Pathways sur Cloud offre les mêmes avantages aux clients Google Cloud .
Avant de commencer
-
Sélectionnez l'onglet correspondant à la façon dont vous prévoyez d'utiliser les exemples de cette page :
gcloud
Installez la Google Cloud CLI, puis connectez-vous à la gcloud CLI avec votre identité fédérée. Après vous être connecté, initialisez la Google Cloud CLI en exécutant la commande suivante :
gcloud initREST
Pour utiliser les exemples API REST de cette page dans un environnement de développement local, vous devez utiliser les identifiants que vous fournissez à la gcloud CLI.
Installez la Google Cloud CLI, puis connectez-vous à la gcloud CLI avec votre identité fédérée.
Pour en savoir plus, consultez la section S'authentifier pour utiliser REST dans la documentation sur l'authentification Google Cloud .
Avant de commencer
Vous pouvez exécuter Pathways sur Google Kubernetes Engine (GKE) ou sur un cluster Cluster Director avec Slurm. Sélectionnez l'onglet correspondant à votre plate-forme.
GKE
Remplissez les conditions préalables suivantes :
Ce document explique comment utiliser les TPU gérés par Pathways sur GKE pour les charges de travail par lot, en temps réel et interactives. Il suppose que vous connaissez déjà l'utilisation des TPU dans GKE, y compris les TPU à tranche unique et les TPU Multislice sur GKE, et que vous avez une expérience générale des TPU Multislice.
Cluster Director
Remplissez les conditions préalables suivantes :
Ce document explique comment utiliser Pathways avec des TPU sur un cluster Cluster Director pour les charges de travail par lot et interactives. Nous partons du principe que vous connaissez déjà Cluster Director, les machines TPU dans Cluster Director et l'exécution de jobs avec Slurm, et que vous avez une expérience générale des TPU Multislice.
Pour créer un cluster, consultez Créer un cluster Cluster Director avec Pathways.
Contrôleur unique et multicontrôleur
Il existe deux méthodes principales pour gérer et orchestrer les calculs sur plusieurs appareils :
| Fonctionnalité | Contrôleur unique (Pathways) | Multi-contrôleur (par défaut pour JAX) |
|---|---|---|
Contrôle |
Point de contrôle unique : un seul programme client agit en tant que contrôleur central. |
Contrôle distribué : plusieurs processus participent, chacun avec sa propre instance d'interpréteur Python. |
Afficher |
Vue unifiée : le client voit tous les appareils comme un seul système unifié. |
Vue localisée : chaque processus Python ne voit que les appareils qui lui sont connectés. |
Programmation |
Programmation simplifiée : vous interagissez avec un seul client, ce qui fait apparaître le système comme une seule grande machine dotée de nombreux accélérateurs locaux. |
SPMD (Single Program, Multiple Data) : utilise principalement le paradigme SPMD, qui nécessite que tous les appareils exécutent le même programme. |
Flexibilité |
Prise en charge des modèles de calcul complexes au-delà du SPMD, y compris le parallélisme de pipeline asymétrique et la rareté des calculs. |
Peut être moins flexible dans la gestion des ressources, en particulier sur différentes tranches de TPU. |
Composants des parcours
Les sections suivantes décrivent les principaux composants de l'architecture Pathways.
Gestionnaire de ressources Pathways
Ce composant est le plan de contrôle central du système Pathways. Il gère toutes les ressources d'accélérateur et coordonne l'allocation des accélérateurs pour vos jobs. Il surveille l'état des nœuds de calcul et gère la planification, la mise en pause et la reprise des jobs. Il sert de point de contact unique pour les erreurs et l'état du système. Ce composant ne nécessite que des ressources de processeur.
Client Pathways
Ce composant est une implémentation de l'environnement d'exécution du framework provisoire (IFRT) qui sert de point d'entrée dans le système Pathways. Il reçoit des opérations de haut niveau (HLO) de votre programme. Le client Pathways se coordonne avec le gestionnaire de ressources Pathways pour déterminer où placer les programmes compilés pour l'exécution en fonction de votre code. Il présente une vue unifiée du système à un client JAX donné. Ce composant ne nécessite que des ressources de processeur.
Travailleur Pathways
Les processus de calcul Pathways s'exécutent sur les machines d'accélérateur (VM TPU). Ils reçoivent les exécutables compilés de votre programme depuis le serveur proxy IFRT et effectuent les calculs sur les TPU. Les nœuds de calcul Pathways renvoient les données à votre programme via le serveur proxy IFRT. Ce composant nécessite des ressources d'accélérateur.
Client proxy IFRT
Le client proxy IFRT est une implémentation Open Source de l'API Interim Framework Runtime (IFRT) qui dissocie le code utilisateur de l'environnement d'exécution sous-jacent et améliore la portabilité et la transparence du code. JAX utilise cette implémentation comme alternative à son environnement d'exécution multi-contrôleur par défaut. Le client proxy IFRT sert de pont de communication entre votre programme et les composants Pathways. Il envoie des requêtes au serveur proxy IFRT et reçoit les résultats de celui-ci. Ce composant ne nécessite que des ressources de processeur.
Serveur proxy IFRT
Le serveur proxy IFRT est un serveur gRPC qui reçoit les requêtes du client proxy IFRT et les transmet au client Pathways, qui gère la distribution du travail. Ce composant ne nécessite que des ressources de processeur.
Serveur side-car
Le serveur side-car est un serveur gRPC colocalisé avec le nœud de calcul Pathways sur la VM de l'accélérateur. Il exécute le code Python spécifié par l'utilisateur directement sur la VM de l'accélérateur pour réduire la latence de transfert de données entre le contrôleur et les accélérateurs. Le serveur side-car interagit avec le nœud de calcul Pathways via un protocole personnalisé avec gestion des versions sur le transport gRPC.
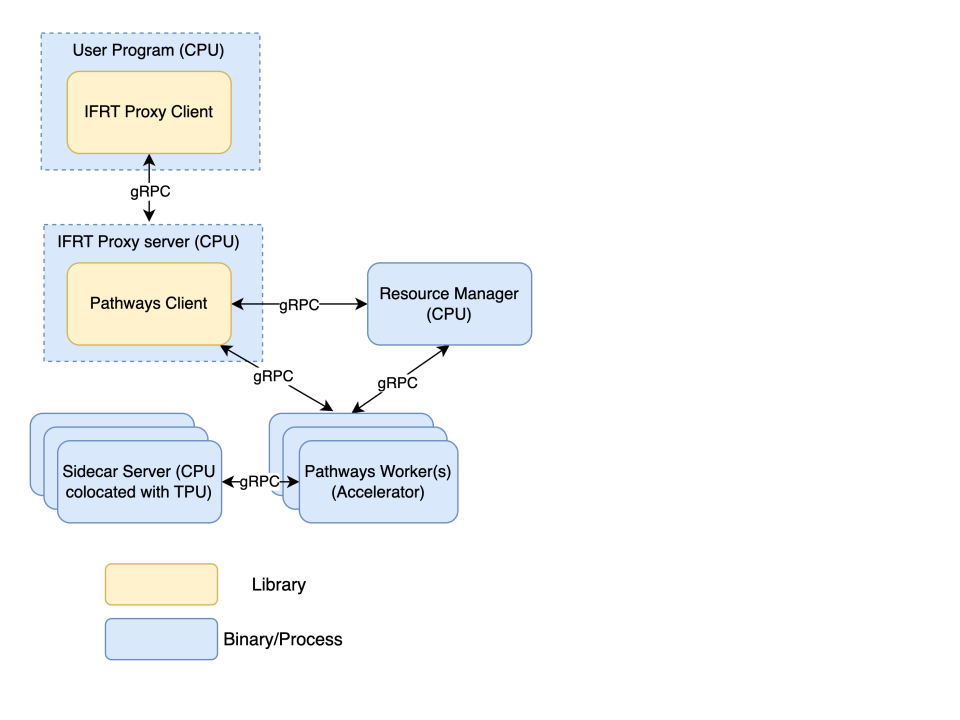
Composants Pathways sur GKE
Cette section met en correspondance les composants Pathways avec les composants GKE tels que les conteneurs et les pods.
Vous trouverez les images de conteneurs Pathways aux emplacements suivants :
| Type de conteneur | Emplacement |
|---|---|
Serveur proxy IFRT |
|
Gestionnaire/Travailleur des ressources Pathways |
|
Gestionnaire de ressources Pathways
Après avoir créé un cluster GKE, vous pouvez utiliser le containerSpec suivant pour déployer le gestionnaire de ressources Pathways :
  - name: pathways-rm
    image: us-docker.pkg.dev/cloud-tpu-v2-images/cloud-pathways/server:latest
    imagePullPolicy: Always
    env:
    - name: HOST_ADDRESS
      valueFrom:
        fieldRef:
          fieldPath: "metadata.labels['jobset.sigs.k8s.io/coordinator']"
    - name: TPU_SKIP_MDS_QUERY
      value: "true"
    args:
    - --server_port=29001
    - --node_type=resource_manager
    - --instance_count=WORKLOAD_NODEPOOL_COUNT
    - --instance_type=SLICE_TOPOLOGY
    - --gcs_scratch_location=gs://BUCKET_NAME
Le conteneur utilise les arguments suivants :
--server_port: port utilisé par le gestionnaire de ressources Pathways pour communiquer avec d'autres composants Pathways.--node_type: type de nœud. Définissez cet argument surresource_managerpour le gestionnaire de ressources Pathways. Il n'est pas nécessaire pour les autres conteneurs.--instance_count: nombre de tranches de TPU.--instance_type: type de TPU et topologie de la tranche, au formattpuTPU_TYPE:TOPOLOGY(par exemple,tpuv5e:4x4).--gcs_scratch_location: bucket Cloud Storage utilisé pour les fichiers temporaires.
Serveur proxy IFRT
Vous pouvez utiliser le containerSpec suivant pour déployer un serveur proxy IFRT :
  - name: pathways-proxy
    image: us-docker.pkg.dev/cloud-tpu-v2-images/cloud-pathways/proxy_server:latest
    imagePullPolicy: Always
    env:
    - name: PATHWAYS_HEAD
      valueFrom:
        fieldRef:
          fieldPath: "metadata.labels['jobset.sigs.k8s.io/coordinator']"
    args:
    - --resource_manager_address=$(PATHWAYS_HEAD):29001
    - --server_port=29000
    - --gcs_scratch_location=gs://BUCKET_NAME
    ports:
    - containerPort: 29000
Le conteneur utilise les arguments suivants :
--resource_manager_address: nom d'hôte et port utilisés par le serveur proxy pour communiquer avec le gestionnaire de ressources Pathways. Le port doit correspondre à la valeur--server_portutilisée pour le conteneur du gestionnaire de ressources Pathways.--server_port: port utilisé par le serveur proxy IFRT pour communiquer avec le client proxy IFRT.--gcs_scratch_location: bucket Cloud Storage utilisé pour les fichiers temporaires.
Travailleur Pathways
Vous pouvez utiliser le containerSpec suivant pour déployer des nœuds de calcul Pathways :
- name: worker
  image: us-docker.pkg.dev/cloud-tpu-v2-images/cloud-pathways/server:latest
  imagePullPolicy: Always
  env:
  - name: PATHWAYS_HEAD
    valueFrom:
      fieldRef:
        fieldPath: "metadata.labels['jobset.sigs.k8s.io/coordinator']"
  - name: MEGASCALE_NUM_SLICES
    valueFrom:
      fieldRef:
        fieldPath: "metadata.labels['jobset.sigs.k8s.io/replicatedjob-replicas']"
  - name: MEGASCALE_SLICE_ID
    valueFrom:
      fieldRef:
        fieldPath: "metadata.labels['jobset.sigs.k8s.io/job-index']"
  - name: MEGASCALE_COORDINATOR_ADDRESS
    value: "$(PATHWAYS_HEAD)"
  args:
  - --server_port=29001
  - --resource_manager_address=$(PATHWAYS_HEAD):29001
  - --gcs_scratch_location=gs://BUCKET_NAME
  ports:
  - containerPort: 29001
  resources:
    limits:
      google.com/tpu: "4"
Le conteneur utilise les arguments suivants :
--resource_manager_address: nom d'hôte et port que les travailleurs TPU utilisent pour communiquer avec le gestionnaire de ressources Pathways. Le port doit correspondre à la valeur--server_portutilisée pour le conteneur du gestionnaire de ressources Pathways.--server_port: port utilisé par les nœuds de calcul pour communiquer avec le serveur proxy et le gestionnaire de ressources Pathways.--gcs_scratch_location: bucket Cloud Storage utilisé pour les fichiers temporaires.
Le gestionnaire de ressources Pathways, le serveur proxy IFRT et les nœuds de calcul Pathways peuvent tous avoir des ports différents, mais dans cet exemple, le gestionnaire de ressources Pathways et le nœud de calcul Pathways partagent le même port.
Composants Pathways sur Cluster Director
Cette section met en correspondance les composants Pathways avec les jobs Slurm sur un cluster Cluster Director.
Les scripts Pathways exécutent les composants Pathways avec Enroot. Le script setup_env.sh utilise les images de conteneur suivantes, qui correspondent à la version JAX (0.11.1) de l'environnement Python qu'il crée :
| Type de conteneur | Emplacement |
|---|---|
Serveur proxy IFRT |
|
Gestionnaire/Travailleur des ressources Pathways |
|
Vous démarrez les composants Pathways en envoyant le script start_pathways.sh en tant que job du service Pathways. Vous n'écrivez pas vous-même les commandes suivantes : les scripts dérivent les arguments des variables d'environnement que vous définissez lorsque vous envoyez start_pathways.sh, telles que SLICE_SHAPE, MIN_SLICES, MAX_SLICES et GCS_BUCKET.
Gestionnaire de ressources Pathways
Le job de service Pathways exécute le gestionnaire de ressources Pathways sur un nœud de processeur. Il exécute la commande suivante dans le conteneur serveur Pathways :
/pathways/server \
    --server_port=29001 \
    --node_type=resource_manager \
    --instance_type=tpuTPU_TYPE:TOPOLOGY \
    --instance_count=MAX_SLICES \
    --gcs_scratch_location=gs://BUCKET_NAME/pathways-scratch/shared \
    --enable_gcs_olm=false
La commande utilise les arguments suivants :
--server_port: port sur lequel le gestionnaire de ressources Pathways écoute. Le serveur proxy IFRT et les nœuds de calcul Pathways se connectent à ce port.--node_type: type de nœud,resource_manager. Seul le gestionnaire de ressources Pathways définit cet argument.--instance_type: type de TPU et topologie de chaque tranche, à partir deSLICE_SHAPE. Par exemple,SLICE_SHAPE=2x4définittpuv6e:2x4.--instance_count: nombre de tranches de TPU, à partir deMAX_SLICES.--gcs_scratch_location: chemin d'accès dans votre bucket Cloud Storage, à partir deGCS_BUCKET, utilisé pour les fichiers temporaires tels que le cache de compilation.--enable_gcs_olm: indique si Pathways crée des règles de cycle de vie des objets Cloud Storage pour nettoyer les anciennes entrées du cache de compilation. Le script désactive cette option, car elle nécessite des autorisations supplémentaires sur le bucket.
Serveur proxy IFRT
Le job du service Pathways exécute le serveur proxy IFRT sur le même nœud de processeur que le gestionnaire de ressources Pathways. Il exécute la commande suivante dans le conteneur serveur proxy IFRT :
/pathways/proxy_server \
    --server_port=29000 \
    --resource_manager_address=RM_IP:29001 \
    --gcs_scratch_location=gs://BUCKET_NAME/pathways-scratch/shared \
    --num_elastic_instances=MAX_SLICES
La commande utilise les arguments suivants :
--server_port: port sur lequel le serveur proxy IFRT écoute. Votre programme JAX se connecte à ce port.--resource_manager_address: adresse du gestionnaire de ressources Pathways.RM_IPest l'adresse IP interne du nœud de processeur.--gcs_scratch_location: même chemin d'accès Cloud Storage que le gestionnaire de ressources Pathways.--num_elastic_instances: nombre de tranches pouvant être indisponibles sans arrêter la session du proxy IFRT, deMAX_SLICES. Votre charge de travail appliqueMIN_SLICES.
Lorsqu'au moins MIN_SLICES tranches sont en cours d'exécution, le job de service écrit l'adresse du serveur proxy IFRT dans ~/pathways/cluster.env. Votre programme JAX, le client proxy IFRT, lit ce fichier pour se connecter à Pathways. Le programme JAX s'exécute en tant que charge de travail (par exemple, run_maxtext.sh) ou dans un notebook Jupyter.
Travailleur Pathways
Le job du service Pathways envoie un tableau de jobs Slurm (run_worker_slice.sh) avec une tâche de tableau pour chaque tranche de TPU. Chaque tâche de tableau exécute la commande suivante dans le conteneur serveur Pathways sur chaque VM TPU de sa tranche :
/pathways/server \
    --server_port=29001 \
    --resource_manager_address=RM_IP:29001 \
    --gcs_scratch_location=gs://BUCKET_NAME/pathways-scratch/shared \
    --enable_gcs_olm=false
La commande utilise les arguments suivants :
--server_port: port sur lequel le nœud de calcul Pathways écoute. Le gestionnaire de ressources Pathways et le serveur proxy IFRT se connectent à ce port.--resource_manager_address: adresse du gestionnaire de ressources Pathways, identique à celle du serveur proxy IFRT.--gcs_scratch_location,--enable_gcs_olm: identique à celui du gestionnaire de ressources Pathways.
Le script définit également la topologie TPU et les variables d'environnement MEGASCALE_* pour chaque nœud de calcul à partir des nœuds de la tranche et de l'index de la tâche de tableau.
Si une tranche TPU est préemptée ou échoue, Slurm remet sa tâche de tableau en file d'attente. Si vous disposez de sudo sans mot de passe sur les nœuds du cluster, le job de service arrête également les nœuds de la tranche afin que Slurm puisse les recréer. Le gestionnaire de ressources Pathways et le serveur proxy IFRT continuent de s'exécuter. Votre programme JAX n'a donc pas besoin de se connecter à une nouvelle adresse.
Étapes suivantes
- Créer un cluster GKE avec Pathways
- Créer un cluster Cluster Director avec Pathways
- Exécuter une charge de travail par lot avec Pathways
- Exécuter une charge de travail interactive avec Pathways
- Entraînement résilient avec Pathways
- Transférer des charges de travail JAX vers Pathways
- Résoudre les problèmes liés à Pathways sur Cloud
- Exécuter des charges de travail avec Pathways dans Cluster Toolkit