


Pathways è un runtime distribuito per JAX che utilizza un modello di esecuzione con un singolo controller per orchestrare workload di machine learning (ML) su larga scala, multi-task e attivati in modo sparso su una o più sezioni TPU. Consente a un singolo processo Python (il controller) di coordinare i calcoli su migliaia o decine di migliaia di chip TPU e di allocare dinamicamente il calcolo tra le attività.
Anziché eseguire una copia separata del programma Python su ogni VM TPU, il workload JAX viene eseguito in un processo CPU client (il controller) e comunica tramite gRPC con un control plane Pathways su un nodo head della CPU, ovvero una VM dedicata solo alla CPU nel cluster che ospita i servizi di coordinamento e compilazione di Pathways. Il control plane compila il codice e invia i calcoli ai worker Pathways in esecuzione sulle VM TPU.
Google utilizza Pathways internamente per addestrare modelli di grandi dimensioni come Gemini. Pathways on Cloud offre la stessa architettura ai clienti Google Cloud .
Prima di iniziare
Puoi eseguire Pathways su Google Kubernetes Engine (GKE) o su un cluster Cluster Director con Slurm. Seleziona la scheda della tua piattaforma per visualizzare i prerequisiti.
GKE
Completa i seguenti prerequisiti:
Questo documento presuppone che tu abbia già familiarità con l'utilizzo delle TPU in GKE, incluse le TPU a sezione singola e multisezione su GKE, e che tu abbia un'esperienza generale con le TPU multisezione.
Per creare un cluster, consulta Crea un cluster GKE con Pathways.
Cluster Director
Completa i seguenti prerequisiti:
Questo documento presuppone che tu abbia già familiarità con Cluster Director, macchine TPU in Cluster Director e l'esecuzione di job con Slurm e che tu abbia un'esperienza generale con TPU multislice.
Per creare un cluster, consulta Crea un cluster Cluster Director con Pathways.
Controller singolo e multicontroller
I workload ML distribuiti su TPU utilizzano un modello di esecuzione multi-controller (l'impostazione predefinita in JAX) o un modello di esecuzione single-controller (utilizzato da Pathways). I due modelli differiscono per il punto in cui viene eseguito il codice Python, per il modo in cui il programma visualizza gli acceleratori e per il modo in cui i workload vengono coordinati tra le sezioni TPU.
Workload multi-controller (impostazione predefinita di JAX)
Nel modello multi-controller, ogni VM TPU nelle sezioni TPU esegue lo stesso script Python. Ogni VM TPU funge da controller indipendente per i chip TPU collegati direttamente all'host. I workload multi-controller hanno le seguenti caratteristiche:
- Controllo distribuito: ogni VM TPU esegue una copia dello script Python in sincronia e coordina le operazioni collettive tra i processi.
- Visualizzazione dei dispositivi localizzati: ogni processo Python gestisce direttamente solo i chip TPU collegati alla sua VM locale (
jax.local_devices()), mentrejax.devices()elenca tutti i dispositivi nel cluster. - Esecuzione SPMD (Single Program, Multiple Data): poiché ogni host esegue lo stesso script contemporaneamente, i workload multi-controller seguono principalmente il paradigma SPMD. L'orchestrazione di operazioni diverse su sottoinsiemi diversi di sezioni TPU richiede una logica di coordinamento multi-host personalizzata.
- Ciclo di vita accoppiato all'host: poiché i controller Python vengono eseguiti direttamente sulle VM TPU, se una VM TPU viene prerilasciata o non funziona, tutti i processi del controller devono arrestarsi e riavviarsi insieme.
Workload con controller singolo (Pathways)
Nel modello a controller singolo di Pathways, un singolo processo Python funge da controller centrale per l'intero workload. Il programma JAX (il controller) viene eseguito su un host CPU, ad esempio un container batch su un nodo head della CPU o una VM client esterna, e comunica con il runtime Pathways tramite gRPC anziché essere eseguito direttamente sulle VM TPU. I workload con un singolo controller hanno le seguenti caratteristiche:
- Controllo centralizzato: esegui e monitori un processo del controller Python che invia i calcoli al runtime di Pathways, che gestisce l'esecuzione in tutte le VM TPU.
- Visualizzazione unificata dei dispositivi: il programma JAX vede tutte le sezioni TPU come un unico sistema unificato. Nel codice,
jax.process_index()è sempre0e siajax.devices()chejax.local_devices()restituiscono ogni chip TPU in tutti gli slice allocati come se fossero collegati a una singola macchina di grandi dimensioni. - Pattern di calcolo flessibili: oltre all'addestramento SPMD standard, un singolo controller può pianificare calcoli diversi su sottoinsiemi distinti di acceleratori, supportando il parallelismo della pipeline asimmetrico, i workload multitasking e la scarsità computazionale.
- Ciclo di vita del controller disaccoppiato: poiché il programma Python viene eseguito all'esterno delle VM TPU, il processo del controller può rimanere in esecuzione mentre il gestore delle risorse Pathways recupera o sostituisce le sezioni TPU prerilasciate. Quando devi eseguire il codice Python locale dell'host sulle VM TPU, ad esempio per il caricamento, la pre-elaborazione o il checkpoint dei dati con throughput elevato, puoi utilizzare Python in co-locazione per eseguire funzioni Python specifiche sulle CPU host TPU tramite un server sidecar.
Componenti di Pathways
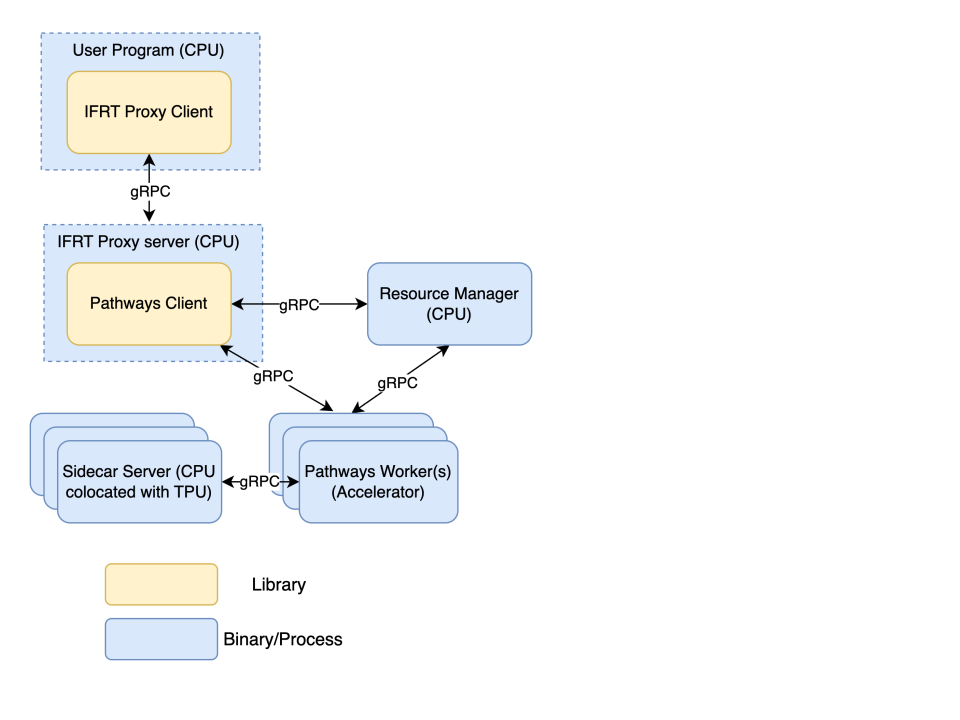
L'architettura Pathways distribuisce i componenti in tre ambienti: l'ambiente CPU client, un nodo head della CPU e le VM worker TPU. Il seguente diagramma illustra l'interazione tra questi componenti e dove viene eseguito ciascuno:
Ambiente CPU client
Viene eseguito in un container del workload sul nodo head della CPU (tipico per i job batch su GKE) o in un container client separato, un job Slurm o una VM CPU esterna (per workload interattivi o Cluster Director):
- Programma utente (controller): il processo JAX Python, che definisce il modello, il ciclo di addestramento e lo sharding dei dispositivi e vede tutti i chip TPU tra le sezioni come dispositivi locali.
- Client proxy IFRT: una libreria open source Interim Framework Runtime (IFRT) incorporata nel processo JAX. Quando importi
pathwaysutilse impostiJAX_PLATFORMS=proxy, il codice viene disaccoppiato dal runtime sottostante e le richieste vengono inviate tramite gRPC al server proxy IFRT.
Nodo head della CPU
Viene eseguito su una VM dedicata solo per CPU nel cluster (un nodo del pool di nodi della CPU su GKE o un nodo di computing della CPU su Cluster Director):
- Server proxy IFRT: un contenitore del server gRPC che riceve le richieste dal client proxy IFRT e le inoltra alla libreria client Pathways incorporata.
- Client Pathways: una libreria di runtime IFRT incorporata nel contenitore del server proxy IFRT. Invia programmi HLO (High-Level Optimizer) al servizio di compilazione nel gestore delle risorse Pathways e coordina il posizionamento tramite gRPC. Quindi invia le richieste di esecuzione e i dati dei tensori ai worker Pathways e presenta una visualizzazione unificata dei dispositivi a JAX.
- Pathways resource manager: il container del control plane centrale. Gestisce
le sezioni dell'acceleratore, monitora lo stato dei worker, pianifica i job e ospita il
servizio di compilazione Pathways, che compila i programmi HLO in eseguibili XLA
archiviati nella cache di compilazione in
--gcs_scratch_location.
VM worker Cloud TPU
Ogni VM worker TPU gestisce i chip Cloud TPU collegati (che eseguono calcoli XLA compilati) tramite i container della CPU host:
- Worker Pathways: carica i file eseguibili compilati dalla cache di compilazione e riceve richieste di esecuzione e dati dei tensori dal client Pathways tramite gRPC. Esegue calcoli sui chip Cloud TPU collegati, scambia dati con altri worker tramite interconnessioni ad alta velocità e segnala lo stato di integrità a Resource Manager.
- Server sidecar (facoltativo, solo GKE): un container gRPC (
colocated-python-sidecar) che esegue funzioni Python specificate dall'utente (come il caricamento dei dati e il checkpoint) sulla VM TPU. Scambia i buffer dei tensori con il worker Pathways locale tramite la memoria host condivisa con copia zero. Consulta Esegui Python in co-locazione con Pathways.
Componenti Pathways su GKE
In GKE, il pod pathways-head viene eseguito su un pool di nodi di CPU e ospita pathways-rm e pathways-proxy (oltre al container del workload batch, se applicabile). Ogni pod worker TPU esegue worker (o pathways-worker) e, se Python in co-locazione è abilitato, colocated-python-sidecar.
Puoi trovare le immagini container di Pathways nelle seguenti posizioni:
| Tipo di contenitore | Località |
|---|---|
Server proxy IFRT |
|
Pathways resource manager and worker |
|
Sidecar Python in co-location (facoltativo) |
|
Pathways resource manager
Dopo aver
creato un cluster GKE,
puoi utilizzare il seguente containerSpec per eseguire il deployment del resource manager di Pathways:
  - name: pathways-rm
    image: us-docker.pkg.dev/cloud-tpu-v2-images/cloud-pathways/server:latest
    imagePullPolicy: Always
    env:
    - name: HOST_ADDRESS
      valueFrom:
        fieldRef:
          fieldPath: "metadata.labels['jobset.sigs.k8s.io/coordinator']"
    - name: TPU_SKIP_MDS_QUERY
      value: "true"
    args:
    - --server_port=29001
    - --node_type=resource_manager
    - --instance_count=WORKLOAD_NODEPOOL_COUNT
    - --instance_type=SLICE_TOPOLOGY
    - --gcs_scratch_location=gs://BUCKET_NAME
Sostituisci quanto segue:
WORKLOAD_NODEPOOL_COUNT: il numero di sezioni TPU.SLICE_TOPOLOGY: il tipo di TPU e la topologia della sezione, nel formatotpuTPU_TYPE:TOPOLOGY, ad esempiotpuv5e:4x4.BUCKET_NAME: il bucket Cloud Storage utilizzato per i file temporanei.
Il container utilizza anche i seguenti argomenti:
--server_port: la porta utilizzata dal gestore delle risorse Pathways per comunicare con altri componenti Pathways (29001in questo esempio).--node_type: il tipo di nodo. Imposta questo argomento suresource_managerper il gestore delle risorse Pathways. Non è necessario per gli altri container.
Server proxy IFRT
Puoi utilizzare il seguente containerSpec per eseguire il deployment di un server proxy IFRT:
  - name: pathways-proxy
    image: us-docker.pkg.dev/cloud-tpu-v2-images/cloud-pathways/proxy_server:latest
    imagePullPolicy: Always
    env:
    - name: PATHWAYS_HEAD
      valueFrom:
        fieldRef:
          fieldPath: "metadata.labels['jobset.sigs.k8s.io/coordinator']"
    args:
    - --resource_manager_address=$(PATHWAYS_HEAD):29001
    - --server_port=29000
    - --gcs_scratch_location=gs://BUCKET_NAME
    ports:
    - containerPort: 29000
Sostituisci BUCKET_NAME con il nome del bucket Cloud Storage utilizzato per i file temporanei.
Il container utilizza anche i seguenti argomenti:
--resource_manager_address: il nome host e la porta utilizzati dal server proxy per comunicare con Pathways Resource Manager. La porta deve corrispondere al valore--server_portutilizzato per il container del gestore delle risorse Pathways.--server_port: la porta utilizzata dal server proxy IFRT per comunicare con il client proxy IFRT (29000in questo esempio).--gcs_scratch_location: il percorso Cloud Storage utilizzato per i file temporanei.
Lavoratore Pathways
Puoi utilizzare i seguenti containerSpec per eseguire il deployment dei worker Pathways:
- name: worker
  image: us-docker.pkg.dev/cloud-tpu-v2-images/cloud-pathways/server:latest
  imagePullPolicy: Always
  env:
  - name: PATHWAYS_HEAD
    valueFrom:
      fieldRef:
        fieldPath: "metadata.labels['jobset.sigs.k8s.io/coordinator']"
  - name: MEGASCALE_NUM_SLICES
    valueFrom:
      fieldRef:
        fieldPath: "metadata.labels['jobset.sigs.k8s.io/replicatedjob-replicas']"
  - name: MEGASCALE_SLICE_ID
    valueFrom:
      fieldRef:
        fieldPath: "metadata.labels['jobset.sigs.k8s.io/job-index']"
  - name: MEGASCALE_COORDINATOR_ADDRESS
    value: "$(PATHWAYS_HEAD)"
  args:
  - --server_port=29001
  - --resource_manager_address=$(PATHWAYS_HEAD):29001
  - --gcs_scratch_location=gs://BUCKET_NAME
  ports:
  - containerPort: 29001
  resources:
    limits:
      google.com/tpu: "4"
Sostituisci BUCKET_NAME con il nome del bucket Cloud Storage utilizzato per i file temporanei.
Il container utilizza anche i seguenti argomenti:
--server_port: la porta utilizzata dai worker per comunicare con il server proxy e il gestore delle risorse Pathways (29001in questo esempio).--resource_manager_address: il nome host e la porta utilizzati dai worker TPU per comunicare con il gestore delle risorse Pathways. La porta deve corrispondere al valore--server_portutilizzato per il container del gestore delle risorse Pathways.--gcs_scratch_location: il percorso Cloud Storage utilizzato per i file temporanei.
Il gestore delle risorse Pathways, il server proxy IFRT e i worker Pathways possono avere tutti porte diverse, ma in questo esempio il gestore delle risorse Pathways e il worker Pathways condividono la stessa porta.
Componenti Pathways su Cluster Director
Questa sezione mappa i componenti di Pathways ai job Slurm su un cluster Cluster Director.
Gli script Pathways eseguono i componenti Pathways con Enroot. Lo script setup_env.sh utilizza le seguenti immagini container, che corrispondono alla versione JAX (0.11.1) dell'ambiente Python che crea:
| Tipo di contenitore | Località |
|---|---|
Server proxy IFRT |
|
Pathways resource manager and worker |
|
Per avviare i componenti Pathways, invia lo script start_pathways.sh come job del servizio Pathways. Non devi scrivere personalmente i seguenti comandi.
Gli script derivano gli argomenti dalle variabili di ambiente impostate quando invii start_pathways.sh, ad esempio SLICE_SHAPE, MIN_SLICES, MAX_SLICES e GCS_BUCKET.
Pathways resource manager
Il job del servizio Pathways esegue il gestore delle risorse Pathways su un nodo CPU. Esegue il seguente comando nel contenitore del server Pathways:
/pathways/server \
    --server_port=29001 \
    --node_type=resource_manager \
    --instance_type=tpuTPU_TYPE:TOPOLOGY \
    --instance_count=MAX_SLICES \
    --gcs_scratch_location=gs://BUCKET_NAME/pathways-scratch/shared \
    --enable_gcs_olm=false
Lo script compila i seguenti segnaposto nel comando:
TPU_TYPEeTOPOLOGY: il tipo di TPU e la topologia di ogni sezione, derivati daSLICE_SHAPE, ad esempioSLICE_SHAPE=2x4impostatpuv6e:2x4.MAX_SLICES: il numero massimo di sezioni TPU, daMAX_SLICES.BUCKET_NAME: il nome del tuo bucket Cloud Storage, daGCS_BUCKET.
Il comando utilizza i seguenti argomenti:
--server_port: la porta su cui ascolta il gestore delle risorse Pathways. Il server proxy IFRT e i worker Pathways si connettono a questa porta.--node_type: il tipo di nodo,resource_manager. Solo il gestore delle risorse Pathways imposta questo argomento.--instance_type: il tipo di TPU e la topologia di ogni sezione.--instance_count: il numero di sezioni TPU.--gcs_scratch_location: il percorso Cloud Storage utilizzato per i file temporanei, ad esempio la cache di compilazione.--enable_gcs_olm: indica se Pathways crea regole del ciclo di vita degli oggetti Cloud Storage per ripulire le voci della cache di compilazione precedenti. Lo script disattiva questa opzione perché richiede autorizzazioni aggiuntive sul bucket.
Server proxy IFRT
Il job del servizio Pathways esegue il server proxy IFRT sullo stesso nodo CPU del gestore delle risorse Pathways. Esegue il seguente comando nel contenitore del server proxy IFRT:
/pathways/proxy_server \
    --server_port=29000 \
    --resource_manager_address=RM_IP:29001 \
    --gcs_scratch_location=gs://BUCKET_NAME/pathways-scratch/shared \
    --num_elastic_instances=MAX_SLICES
Lo script compila i seguenti segnaposto nel comando:
RM_IP: l'indirizzo IP interno del nodo CPU che esegue il gestore delle risorse Pathways.BUCKET_NAME: il nome del tuo bucket Cloud Storage, daGCS_BUCKET.MAX_SLICES: il numero massimo di sezioni TPU, daMAX_SLICES.
Il comando utilizza i seguenti argomenti:
--server_port: la porta su cui il server proxy IFRT rimane in ascolto. Il tuo programma JAX si connette a questa porta.--resource_manager_address: l'indirizzo e la porta del gestore delle risorse Pathways.--gcs_scratch_location: lo stesso percorso Cloud Storage del gestore delle risorse Pathways.--num_elastic_instances: il numero di sezioni che possono non essere disponibili senza interrompere la sessione del proxy IFRT, daMAX_SLICES. Il tuo workload applicaMIN_SLICES.
Quando sono in esecuzione almeno MIN_SLICES sezioni, il job del servizio scrive l'indirizzo del server proxy IFRT in ~/pathways/cluster.env. Il tuo programma JAX, il client proxy IFRT, legge questo file per connettersi a Pathways. Il programma JAX viene eseguito come workload, ad esempio run_maxtext.sh, o in un notebook Jupyter.
Lavoratore Pathways
Il job del servizio Pathways invia un array di job Slurm (run_worker_slice.sh) con
un'attività dell'array per ogni sezione TPU. Ogni attività dell'array esegue il seguente comando nel contenitore del server Pathways su ogni VM TPU nella sua sezione:
/pathways/server \
    --server_port=29001 \
    --resource_manager_address=RM_IP:29001 \
    --gcs_scratch_location=gs://BUCKET_NAME/pathways-scratch/shared \
    --enable_gcs_olm=false
Lo script compila RM_IP con l'indirizzo IP interno del nodo CPU e BUCKET_NAME con il nome del bucket Cloud Storage.
Il comando utilizza i seguenti argomenti:
--server_port: la porta su cui è in ascolto il worker Pathways. Il gestore delle risorse Pathways e il server proxy IFRT si connettono a questa porta.--resource_manager_address: l'indirizzo del gestore delle risorse Pathways, lo stesso del server proxy IFRT.--gcs_scratch_locatione--enable_gcs_olm: gli stessi del gestore delle risorse Pathways.
Lo script imposta anche la topologia TPU e le variabili di ambiente MEGASCALE_* per ogni worker dai nodi della sezione e dall'indice delle attività dell'array.
Se una sezione TPU viene prerilasciata o non funziona, Slurm mette nuovamente in coda il relativo job di array. Se hai passwordless
sudo
sui nodi del cluster, il job di servizio spegne anche i nodi dello slice in modo che
Slurm possa ricrearli. Il gestore delle risorse Pathways e il server proxy IFRT
continuano a funzionare, quindi il tuo programma JAX non deve connettersi a un nuovo indirizzo.
Passaggi successivi
- Crea un cluster GKE con Pathways
- Crea un cluster Cluster Director con Pathways
- Esegui un workload batch con Pathways
- Esegui un workload interattivo con Pathways
- Addestramento resiliente con Pathways
- Porta i workload JAX su Pathways
- Esegui Python in co-locazione con Pathways
- Risolvi i problemi relativi ai percorsi su Cloud
- Esegui i workload con Pathways in Cluster Toolkit