


Pathways는 단일 컨트롤러 실행 모델을 사용하여 하나 이상의 TPU 슬라이스에서 대규모 멀티태스크 희소 활성화 머신러닝(ML) 워크로드를 조정하는 JAX용 분산 런타임입니다. 이를 통해 단일 Python 프로세스(컨트롤러)가 수천 또는 수만 개의 TPU 칩에서 계산을 조정하고 태스크 간에 컴퓨팅을 동적으로 할당할 수 있습니다.
모든 TPU VM에서 Python 프로그램의 별도 사본을 실행하는 대신 JAX 워크로드가 클라이언트 CPU 프로세스(컨트롤러)에서 실행되고 gRPC를 통해 CPU 헤드 노드의 Pathways 컨트롤 플레인과 통신합니다. 이 노드는 Pathways 조정 및 컴파일 서비스를 호스팅하는 클러스터의 전용 CPU 전용 VM입니다. 컨트롤 플레인은 코드를 컴파일하고 TPU VM에서 실행되는 Pathways 워커에 계산을 전달합니다.
Google은 내부적으로 Pathways를 사용하여 Gemini와 같은 대규모 모델을 학습시킵니다. Pathways on Cloud는 Google Cloud 고객에게 동일한 아키텍처를 제공합니다.
시작하기 전에
Google Kubernetes Engine(GKE) 또는 Slurm이 있는 Cluster Director 클러스터에서 Pathways를 실행할 수 있습니다. 플랫폼의 탭을 선택하여 기본 요건을 확인합니다.
GKE
다음 기본 요건을 완료합니다.
이 문서에서는 사용자가 단일 슬라이스 및 GKE의 멀티슬라이스 TPU를 포함하여 GKE의 TPU를 사용하는 데 이미 익숙하고 멀티슬라이스 TPU에 대한 일반적인 경험이 있다고 가정합니다.
클러스터를 만들려면 Pathways를 사용하여 GKE 클러스터 만들기를 참조하세요.
Cluster Director
다음 기본 요건을 완료합니다.
- gcloud CLI를 설치합니다.
- Hypercompute Cluster API를 사용 설정합니다.
이 문서에서는 사용자가 Cluster Director, Cluster Director의 TPU 머신, Slurm을 사용한 작업 실행에 이미 익숙하고 멀티슬라이스 TPU에 대한 일반적인 경험이 있다고 가정합니다.
클러스터를 만들려면 Pathways를 사용하여 Cluster Director 클러스터 만들기를 참조하세요.
단일 컨트롤러 및 다중 컨트롤러
TPU의 분산 ML 워크로드는 멀티 컨트롤러 실행 모델(JAX의 기본값) 또는 단일 컨트롤러 실행 모델(Pathways에서 사용)을 사용합니다. 두 모델은 Python 코드가 실행되는 위치, 프로그램에서 가속기를 보는 방식, TPU 슬라이스 간에 워크로드가 조정되는 방식이 다릅니다.
멀티 컨트롤러 워크로드(JAX 기본값)
멀티 컨트롤러 모델에서는 TPU 슬라이스의 모든 TPU VM이 동일한 Python 스크립트를 실행합니다. 각 TPU VM은 해당 호스트에 직접 연결된 TPU 칩의 독립적인 컨트롤러 역할을 합니다. 멀티 컨트롤러 워크로드에는 다음과 같은 특성이 있습니다.
- 분산 제어: 모든 TPU VM은 Python 스크립트의 사본을 동기화된 방식으로 실행하고 프로세스 간에 집합 연산을 조정합니다.
- 현지화된 기기 뷰: 각 Python 프로세스는 로컬 VM(
jax.local_devices())에 연결된 TPU 칩만 직접 관리하는 반면jax.devices()는 클러스터의 모든 기기를 나열합니다. - 단일 프로그램, 다중 데이터(SPMD) 실행: 모든 호스트가 동일한 스크립트를 동시에 실행하므로 멀티 컨트롤러 워크로드는 주로 SPMD 패러다임을 따릅니다. TPU 슬라이스의 여러 하위 집합에서 다양한 작업을 조정하려면 커스텀 멀티 호스트 조정 로직이 필요합니다.
- 호스트 결합 수명 주기: Python 컨트롤러가 TPU VM에서 직접 실행되므로 TPU VM이 선점되거나 실패하면 모든 컨트롤러 프로세스가 함께 중지되고 다시 시작되어야 합니다.
단일 컨트롤러 워크로드(Pathways)
Pathways 단일 컨트롤러 모델에서 단일 Python 프로세스는 전체 워크로드의 중앙 컨트롤러 역할을 합니다. JAX 프로그램(컨트롤러)은 CPU 헤드 노드의 일괄 컨테이너 또는 외부 클라이언트 VM과 같은 CPU 호스트에서 실행되며 TPU VM에서 직접 실행되는 대신 gRPC를 통해 Pathways 런타임과 통신합니다. 단일 컨트롤러 워크로드에는 다음과 같은 특성이 있습니다.
- 중앙 집중식 제어: 모든 TPU VM에서 실행을 관리하는 Pathways 런타임에 계산을 전달하는 Python 컨트롤러 프로세스 하나를 실행하고 모니터링합니다.
- 통합 기기 뷰: JAX 프로그램은 모든 TPU 슬라이스를 단일 통합 시스템으로 인식합니다. 코드에서
jax.process_index()는 항상0이고jax.devices()및jax.local_devices()는 모두 할당된 모든 슬라이스에서 모든 TPU 칩을 하나의 큰 머신에 연결된 것처럼 반환합니다. - 유연한 계산 패턴: 단일 컨트롤러는 표준 SPMD 학습 외에도 다양한 가속기 하위 집합에서 다양한 계산을 예약하여 비대칭 파이프라인 동시 로드, 멀티태스킹 워크로드, 계산 희소성을 지원할 수 있습니다.
- 분리된 컨트롤러 수명 주기: Python 프로그램이 TPU VM 외부에서 실행되므로 Pathways 리소스 관리자가 선점형 TPU 슬라이스를 복구하거나 교체하는 동안 컨트롤러 프로세스가 계속 실행될 수 있습니다. 높은 처리량의 데이터 로드, 전처리, 체크포인트 저장과 같이 TPU VM에서 호스트 로컬 Python 코드를 실행해야 하는 경우 코로케이션된 Python을 사용하여 사이드카 서버를 통해 TPU 호스트 CPU에서 특정 Python 함수를 실행할 수 있습니다.
Pathways 구성요소
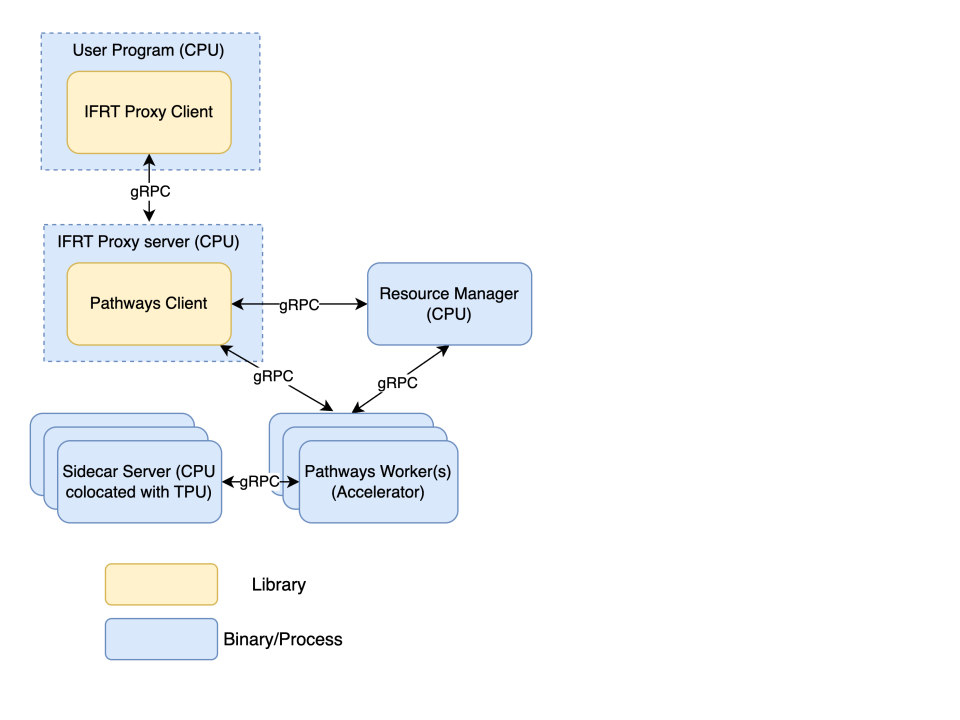
Pathways 아키텍처는 클라이언트 CPU 환경, CPU 헤드 노드, TPU 워커 VM의 세 가지 환경에 구성요소를 분산합니다. 다음 다이어그램은 이러한 구성요소가 상호작용하는 방식과 각 구성요소가 실행되는 위치를 보여줍니다.
클라이언트 CPU 환경
CPU 헤드 노드의 워크로드 컨테이너(GKE의 일괄 작업에 일반적) 또는 별도의 클라이언트 컨테이너, Slurm 작업 또는 외부 CPU VM(대화형 워크로드 또는 클러스터 디렉터용)에서 실행됩니다.
- 사용자 프로그램(컨트롤러): 모델, 학습 루프, 기기 샤딩을 정의하고 슬라이스 전반의 모든 TPU 칩을 로컬 기기로 인식하는 Python JAX 프로세스입니다.
- IFRT 프록시 클라이언트: JAX 프로세스에 삽입된 오픈소스 임시 프레임워크 런타임(IFRT) 라이브러리입니다.
pathwaysutils를 가져오고JAX_PLATFORMS=proxy를 설정하면 기본 런타임에서 코드가 분리되고 gRPC를 통해 IFRT 프록시 서버로 요청이 전송됩니다.
CPU 헤드 노드
클러스터의 전용 CPU 전용 VM(GKE의 CPU 노드 풀 노드 또는 Cluster Director의 CPU 컴퓨팅 노드)에서 실행됩니다.
- IFRT 프록시 서버: IFRT 프록시 클라이언트로부터 요청을 수신하고 이를 내장된 Pathways 클라이언트 라이브러리로 전달하는 gRPC 서버 컨테이너입니다.
- Pathways 클라이언트: IFRT 프록시 서버 컨테이너 내에 삽입된 IFRT 런타임 라이브러리입니다. Pathways 리소스 관리자의 컴파일 서비스에 고수준 옵티마이저(HLO) 프로그램을 전송하고 gRPC를 통해 배치를 조정합니다. 그런 다음 실행 요청과 텐서 데이터를 Pathways 작업자에게 전달하고 JAX에 통합 기기 뷰를 제공합니다.
- Pathways 리소스 관리자: 중앙 컨트롤 플레인 컨테이너입니다. 가속기 슬라이스를 관리하고, 작업자 상태를 모니터링하고, 작업을 예약하고, Pathways 컴파일 서비스를 호스팅합니다. 이 서비스는 HLO 프로그램을
--gcs_scratch_location의 컴파일 캐시에 저장된 XLA 실행 파일로 컴파일합니다.
Cloud TPU 워커 VM
각 TPU 워커 VM은 호스트 CPU 컨테이너를 통해 연결된 Cloud TPU 칩(컴파일된 XLA 계산을 실행함)을 관리합니다.
- Pathways 워커: 컴파일 캐시에서 컴파일된 실행 파일을 로드하고 gRPC를 통해 Pathways 클라이언트에서 실행 요청 및 텐서 데이터를 수신합니다. 연결된 Cloud TPU 칩에서 계산을 실행하고, 고속 상호 연결을 통해 다른 워커와 데이터를 교환하고, 리소스 관리자에 상태를 보고합니다.
- 사이드카 서버(선택사항, GKE만 해당): TPU VM에서 사용자 지정 Python 함수(예: 데이터 로드 및 체크포인트 저장)를 실행하는 gRPC 컨테이너(
colocated-python-sidecar)입니다. 제로 복사 공유 호스트 메모리를 통해 로컬 Pathways 작업자와 텐서 버퍼를 교환합니다. Pathways로 공동 배치된 Python 실행을 참조하세요.
GKE의 Pathways 구성요소
GKE에서 pathways-head 포드는 CPU 노드 풀에서 실행되고 pathways-rm 및 pathways-proxy(해당하는 경우 일괄 워크로드 컨테이너)를 호스팅합니다. 각 TPU 워커 포드는 worker(또는 pathways-worker)를 실행하고, 공동 배치된 Python이 사용 설정된 경우 colocated-python-sidecar를 실행합니다.
Pathways 컨테이너 이미지는 다음 위치에서 찾을 수 있습니다.
| 컨테이너 유형 | 위치 |
|---|---|
IFRT 프록시 서버 |
|
Pathways 리소스 관리자 및 작업자 |
|
공동 배치된 Python 사이드카(선택사항) |
|
Pathways 리소스 관리자
GKE 클러스터를 만든 후 다음 containerSpec를 사용하여 Pathways 리소스 관리자를 배포할 수 있습니다.
  - name: pathways-rm
    image: us-docker.pkg.dev/cloud-tpu-v2-images/cloud-pathways/server:latest
    imagePullPolicy: Always
    env:
    - name: HOST_ADDRESS
      valueFrom:
        fieldRef:
          fieldPath: "metadata.labels['jobset.sigs.k8s.io/coordinator']"
    - name: TPU_SKIP_MDS_QUERY
      value: "true"
    args:
    - --server_port=29001
    - --node_type=resource_manager
    - --instance_count=WORKLOAD_NODEPOOL_COUNT
    - --instance_type=SLICE_TOPOLOGY
    - --gcs_scratch_location=gs://BUCKET_NAME
다음을 바꿉니다.
WORKLOAD_NODEPOOL_COUNT: TPU 슬라이스 수입니다.SLICE_TOPOLOGY: 슬라이스의 TPU 유형 및 토폴로지입니다(tpuTPU_TYPE:TOPOLOGY형식, 예:tpuv5e:4x4).BUCKET_NAME: 임시 파일에 사용되는 Cloud Storage 버킷입니다.
컨테이너는 다음 인수도 사용합니다.
--server_port: Pathways 리소스 관리자가 다른 Pathways 구성요소와 통신하는 데 사용하는 포트입니다(이 예시에서는29001).--node_type: 노드 유형입니다. Pathways 리소스 관리자의 경우 이 인수를resource_manager로 설정합니다. 다른 컨테이너에는 필요하지 않습니다.
IFRT 프록시 서버
다음 containerSpec를 사용하여 IFRT 프록시 서버를 배포할 수 있습니다.
  - name: pathways-proxy
    image: us-docker.pkg.dev/cloud-tpu-v2-images/cloud-pathways/proxy_server:latest
    imagePullPolicy: Always
    env:
    - name: PATHWAYS_HEAD
      valueFrom:
        fieldRef:
          fieldPath: "metadata.labels['jobset.sigs.k8s.io/coordinator']"
    args:
    - --resource_manager_address=$(PATHWAYS_HEAD):29001
    - --server_port=29000
    - --gcs_scratch_location=gs://BUCKET_NAME
    ports:
    - containerPort: 29000
BUCKET_NAME을 임시 파일에 사용되는 Cloud Storage 버킷 이름으로 바꿉니다.
컨테이너는 다음 인수도 사용합니다.
--resource_manager_address: 프록시 서버가 Pathways 리소스 관리자와 통신하는 데 사용하는 호스트 이름 및 포트입니다. 포트는 Pathways 리소스 관리자 컨테이너에 사용되는--server_port값과 일치해야 합니다.--server_port: IFRT 프록시 서버가 IFRT 프록시 클라이언트와 통신하는 데 사용하는 포트입니다(이 예시에서는29000).--gcs_scratch_location: 임시 파일에 사용되는 Cloud Storage 경로입니다.
Pathways 작업자
다음 containerSpec를 사용하여 Pathways 작업자를 배포할 수 있습니다.
- name: worker
  image: us-docker.pkg.dev/cloud-tpu-v2-images/cloud-pathways/server:latest
  imagePullPolicy: Always
  env:
  - name: PATHWAYS_HEAD
    valueFrom:
      fieldRef:
        fieldPath: "metadata.labels['jobset.sigs.k8s.io/coordinator']"
  - name: MEGASCALE_NUM_SLICES
    valueFrom:
      fieldRef:
        fieldPath: "metadata.labels['jobset.sigs.k8s.io/replicatedjob-replicas']"
  - name: MEGASCALE_SLICE_ID
    valueFrom:
      fieldRef:
        fieldPath: "metadata.labels['jobset.sigs.k8s.io/job-index']"
  - name: MEGASCALE_COORDINATOR_ADDRESS
    value: "$(PATHWAYS_HEAD)"
  args:
  - --server_port=29001
  - --resource_manager_address=$(PATHWAYS_HEAD):29001
  - --gcs_scratch_location=gs://BUCKET_NAME
  ports:
  - containerPort: 29001
  resources:
    limits:
      google.com/tpu: "4"
BUCKET_NAME을 임시 파일에 사용되는 Cloud Storage 버킷 이름으로 바꿉니다.
컨테이너는 다음 인수도 사용합니다.
--server_port: 작업자가 프록시 서버 및 Pathways 리소스 관리자와 통신하는 데 사용하는 포트입니다(이 예시에서는29001).--resource_manager_address: TPU 워커가 Pathways 리소스 관리자와 통신하는 데 사용하는 호스트 이름 및 포트입니다. 포트는 Pathways 리소스 관리자 컨테이너에 사용되는--server_port값과 일치해야 합니다.--gcs_scratch_location: 임시 파일에 사용되는 Cloud Storage 경로입니다.
Pathways 리소스 관리자, IFRT 프록시 서버, Pathways 작업자는 모두 다른 포트를 가질 수 있지만 이 예시에서는 Pathways 리소스 관리자와 Pathways 작업자가 동일한 포트를 공유합니다.
Cluster Director의 Pathways 구성요소
이 섹션에서는 Pathways 구성요소를 Cluster Director 클러스터의 Slurm 작업에 매핑합니다.
Pathways 스크립트는 Enroot를 사용하여 Pathways 구성요소를 실행합니다. setup_env.sh 스크립트는 빌드하는 Python 환경의 JAX 버전(0.11.1)과 일치하는 다음 컨테이너 이미지를 사용합니다.
| 컨테이너 유형 | 위치 |
|---|---|
IFRT 프록시 서버 |
|
Pathways 리소스 관리자 및 작업자 |
|
Pathways 서비스 작업으로 start_pathways.sh 스크립트를 제출하여 Pathways 구성요소를 시작합니다. 다음 명령어는 직접 작성하지 않습니다.
스크립트는 start_pathways.sh를 제출할 때 설정한 환경 변수(예: SLICE_SHAPE, MIN_SLICES, MAX_SLICES, GCS_BUCKET)에서 인수를 가져옵니다.
Pathways 리소스 관리자
Pathways 서비스 작업은 하나의 CPU 노드에서 Pathways 리소스 관리자를 실행합니다. Pathways 서버 컨테이너에서 다음 명령어를 실행합니다.
/pathways/server \
    --server_port=29001 \
    --node_type=resource_manager \
    --instance_type=tpuTPU_TYPE:TOPOLOGY \
    --instance_count=MAX_SLICES \
    --gcs_scratch_location=gs://BUCKET_NAME/pathways-scratch/shared \
    --enable_gcs_olm=false
스크립트는 명령어의 다음 자리표시자를 채웁니다.
TPU_TYPE및TOPOLOGY:SLICE_SHAPE에서 파생된 각 슬라이스의 TPU 유형 및 토폴로지(예:SLICE_SHAPE=2x4는tpuv6e:2x4를 설정함)MAX_SLICES: 최대 TPU 슬라이스 수입니다(MAX_SLICES).BUCKET_NAME:GCS_BUCKET의 Cloud Storage 버킷 이름입니다.
이 명령어는 다음 인수를 사용합니다.
--server_port: Pathways 리소스 관리자가 리슨하는 포트입니다. IFRT 프록시 서버와 Pathways 작업자가 이 포트에 연결합니다.--node_type: 노드 유형,resource_managerPathways 리소스 관리자만 이 인수를 설정합니다.--instance_type: 각 슬라이스의 TPU 유형 및 토폴로지입니다.--instance_count: TPU 슬라이스 수입니다.--gcs_scratch_location: 컴파일 캐시와 같은 임시 파일에 사용되는 Cloud Storage 경로입니다.--enable_gcs_olm: Pathways가 이전 컴파일 캐시 항목을 정리하기 위해 Cloud Storage 객체 수명 주기 규칙을 만드는지 여부입니다. 스크립트는 버킷에 대한 추가 권한이 필요하므로 이 기능을 사용 중지합니다.
IFRT 프록시 서버
Pathways 서비스 작업은 Pathways 리소스 관리자와 동일한 CPU 노드에서 IFRT 프록시 서버를 실행합니다. IFRT 프록시 서버 컨테이너에서 다음 명령어를 실행합니다.
/pathways/proxy_server \
    --server_port=29000 \
    --resource_manager_address=RM_IP:29001 \
    --gcs_scratch_location=gs://BUCKET_NAME/pathways-scratch/shared \
    --num_elastic_instances=MAX_SLICES
스크립트는 명령어의 다음 자리표시자를 채웁니다.
RM_IP: Pathways 리소스 관리자를 실행하는 CPU 노드의 내부 IP 주소입니다.BUCKET_NAME:GCS_BUCKET의 Cloud Storage 버킷 이름입니다.MAX_SLICES: 최대 TPU 슬라이스 수입니다(MAX_SLICES).
이 명령어는 다음 인수를 사용합니다.
--server_port: IFRT 프록시 서버가 리슨하는 포트입니다. JAX 프로그램이 이 포트에 연결됩니다.--resource_manager_address: Pathways 리소스 관리자의 주소 및 포트입니다.--gcs_scratch_location: Pathways 리소스 관리자와 동일한 Cloud Storage 경로입니다.--num_elastic_instances: IFRT 프록시 세션을 중지하지 않고 사용할 수 없는 슬라이스 수입니다(MAX_SLICES). 워크로드에서MIN_SLICES를 시행합니다.
MIN_SLICES개 이상의 슬라이스가 실행 중이면 서비스 작업이 IFRT 프록시 서버 주소를 ~/pathways/cluster.env에 씁니다. JAX 프로그램인 IFRT 프록시 클라이언트는 이 파일을 읽어 Pathways에 연결합니다. JAX 프로그램은 워크로드(예: run_maxtext.sh) 또는 Jupyter 노트북에서 실행됩니다.
Pathways 작업자
Pathways 서비스 작업은 각 TPU 슬라이스에 대해 하나의 배열 태스크가 있는 Slurm 작업 배열(run_worker_slice.sh)을 제출합니다. 각 배열 태스크는 슬라이스의 모든 TPU VM에 있는 Pathways 서버 컨테이너에서 다음 명령어를 실행합니다.
/pathways/server \
    --server_port=29001 \
    --resource_manager_address=RM_IP:29001 \
    --gcs_scratch_location=gs://BUCKET_NAME/pathways-scratch/shared \
    --enable_gcs_olm=false
스크립트는 RM_IP를 CPU 노드의 내부 IP 주소로 채우고 BUCKET_NAME를 Cloud Storage 버킷 이름으로 채웁니다.
이 명령어는 다음 인수를 사용합니다.
--server_port: Pathways 작업자가 리슨하는 포트입니다. Pathways 리소스 관리자와 IFRT 프록시 서버가 이 포트에 연결됩니다.--resource_manager_address: Pathways 리소스 관리자의 주소로, IFRT 프록시 서버와 동일합니다.--gcs_scratch_location및--enable_gcs_olm: Pathways 리소스 관리자와 동일합니다.
또한 이 스크립트는 슬라이스의 노드와 배열 태스크 색인에서 각 작업자의 TPU 토폴로지와 MEGASCALE_* 환경 변수를 설정합니다.
TPU 슬라이스가 선점되거나 실패하면 Slurm은 배열 작업을 다시 큐에 추가합니다. 클러스터 노드에 비밀번호 없는 sudo가 있는 경우 서비스 작업은 Slurm이 다시 만들 수 있도록 슬라이스의 노드 전원도 끕니다. Pathways 리소스 관리자와 IFRT 프록시 서버는 계속 실행되므로 JAX 프로그램이 새 주소에 연결할 필요가 없습니다.