


Pathways est un environnement d'exécution distribué pour JAX qui utilise un modèle d'exécution à contrôleur unique pour orchestrer des charges de travail de machine learning (ML) multitâches, à grande échelle et à activation partielle sur une ou plusieurs tranches de TPU. Il permet à un seul processus Python (le contrôleur) de coordonner les calculs sur des milliers ou des dizaines de milliers de puces TPU et d'allouer dynamiquement les ressources de calcul entre les tâches.
Au lieu d'exécuter une copie distincte de votre programme Python sur chaque VM TPU, votre charge de travail JAX s'exécute dans un processus de processeur client (le contrôleur) et communique via gRPC avec un plan de contrôle Pathways sur un nœud principal de processeur, qui est une VM dédiée uniquement au processeur dans votre cluster qui héberge les services de coordination et de compilation Pathways. Le plan de contrôle compile votre code et distribue les calculs aux nœuds de calcul Pathways exécutés sur vos VM TPU.
Google utilise Pathways en interne pour entraîner des modèles de grande taille tels que Gemini. Pathways sur Cloud offre la même architecture aux clients Google Cloud .
Avant de commencer
Vous pouvez exécuter Pathways sur Google Kubernetes Engine (GKE) ou sur un cluster Cluster Director avec Slurm. Sélectionnez l'onglet correspondant à votre plate-forme pour afficher les conditions préalables.
GKE
Remplissez les conditions préalables suivantes :
Ce document suppose que vous connaissez déjà l'utilisation des TPU dans GKE, y compris les TPU à tranche unique et les TPU Multislice sur GKE, et que vous avez une expérience générale des TPU Multislice.
Pour créer un cluster, consultez Créer un cluster GKE avec Pathways.
Cluster Director
Remplissez les conditions préalables suivantes :
Ce document suppose que vous connaissez déjà Cluster Director, les machines TPU dans Cluster Director et l'exécution de jobs avec Slurm, et que vous avez une expérience générale des TPU Multislice.
Pour créer un cluster, consultez Créer un cluster Cluster Director avec Pathways.
Contrôleur unique et multicontrôleur
Les charges de travail de ML distribuées sur les TPU utilisent un modèle d'exécution multi-contrôleur (par défaut dans JAX) ou un modèle d'exécution à contrôleur unique (utilisé par Pathways). Les deux modèles diffèrent selon l'emplacement d'exécution de votre code Python, la façon dont votre programme affiche les accélérateurs et la façon dont les charges de travail sont coordonnées entre les tranches de TPU.
Charges de travail multicontrôleurs (par défaut pour JAX)
Dans le modèle multi-contrôleur, chaque VM TPU de vos tranches TPU exécute le même script Python. Chaque VM TPU agit en tant que contrôleur indépendant pour les puces TPU directement associées à cet hôte. Les charges de travail multicontrôleurs présentent les caractéristiques suivantes :
- Contrôle distribué : chaque VM TPU exécute une copie de votre script Python en mode synchrone et coordonne les opérations collectives entre les processus.
- Vue localisée des appareils : chaque processus Python ne gère directement que les puces TPU associées à sa VM locale (
jax.local_devices()), tandis quejax.devices()liste tous les appareils du cluster. - Exécution SPMD (Single Program, Multiple Data) : étant donné que chaque hôte exécute le même script simultanément, les charges de travail multi-contrôleurs suivent principalement le paradigme SPMD. L'orchestration de différentes opérations sur différents sous-ensembles de tranches de TPU nécessite une logique de coordination multi-hôte personnalisée.
- Cycle de vie couplé à l'hôte : étant donné que les contrôleurs Python s'exécutent directement sur les VM TPU, si une VM TPU est préemptée ou échoue, tous les processus du contrôleur doivent s'arrêter et redémarrer ensemble.
Charges de travail à contrôleur unique (Pathways)
Dans le modèle à contrôleur unique Pathways, un seul processus Python sert de contrôleur central pour l'ensemble de votre charge de travail. Votre programme JAX (le contrôleur) s'exécute sur un hôte de processeur, tel qu'un conteneur de traitement par lot sur un nœud principal de processeur ou une VM cliente externe, et communique avec l'environnement d'exécution Pathways via gRPC au lieu de s'exécuter directement sur vos VM TPU. Les charges de travail à contrôleur unique présentent les caractéristiques suivantes :
- Contrôle centralisé : vous exécutez et surveillez un processus de contrôleur Python qui distribue les calculs à l'environnement d'exécution Pathways, qui gère l'exécution sur toutes les VM TPU.
- Vue unifiée des appareils : votre programme JAX voit toutes les tranches de TPU comme un seul système unifié. Dans votre code,
jax.process_index()est toujours0, etjax.devices()etjax.local_devices()renvoient toutes les puces TPU de toutes les tranches allouées comme si elles étaient associées à une seule grande machine. - Modèles de calcul flexibles : en plus de l'entraînement SPMD standard, un seul contrôleur peut planifier différents calculs sur des sous-ensembles distincts d'accélérateurs, ce qui permet d'assurer le parallélisme asymétrique des pipelines, les charges de travail multitâches et la rareté des calculs.
- Cycle de vie du contrôleur dissocié : comme votre programme Python s'exécute en dehors des VM TPU, le processus du contrôleur peut continuer à s'exécuter pendant que le gestionnaire de ressources Pathways récupère ou remplace les tranches de TPU préemptées. Lorsque vous devez exécuter du code Python local sur les VM TPU (par exemple, pour le chargement de données à haut débit, le prétraitement ou la création de points de contrôle), vous pouvez utiliser Python colocalisé pour exécuter des fonctions Python spécifiques sur les processeurs hôtes TPU via un serveur side-car.
Composants des parcours
L'architecture Pathways distribue les composants sur trois environnements : l'environnement de processeur client, un nœud principal de processeur et les VM de nœud de calcul TPU. Le schéma suivant illustre les interactions entre ces composants et l'emplacement d'exécution de chacun d'eux :
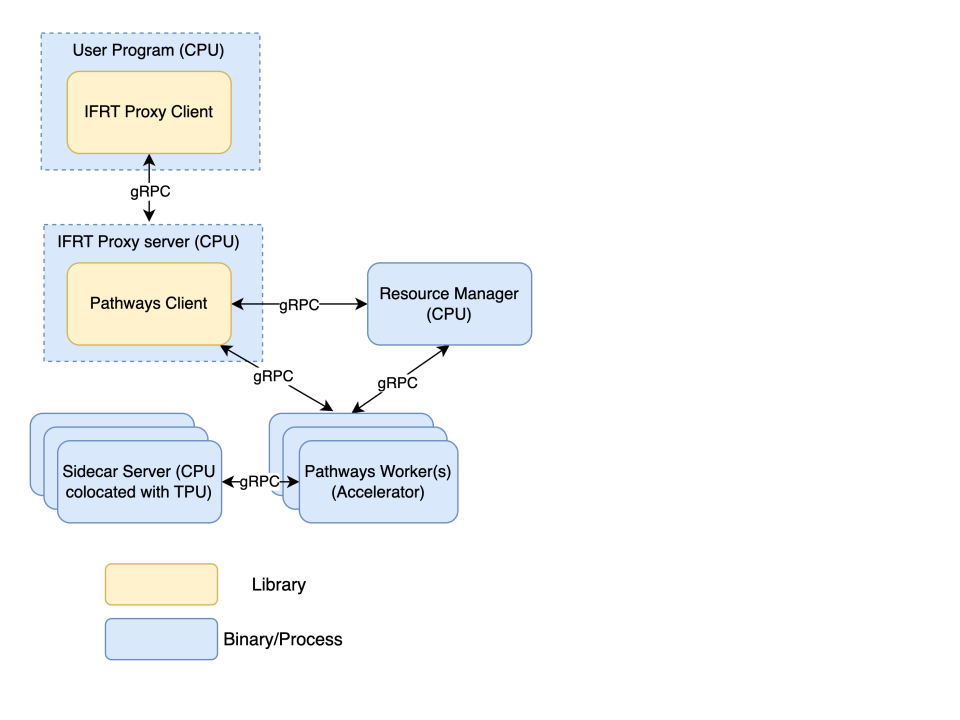
Environnement du processeur client
S'exécute dans un conteneur de charge de travail sur le nœud principal du processeur (généralement pour les jobs par lot sur GKE), ou dans un conteneur client distinct, un job Slurm ou une VM de processeur externe (pour les charges de travail interactives ou Cluster Director) :
- Programme utilisateur (contrôleur) : votre processus Python JAX, qui définit votre modèle, votre boucle d'entraînement et le partitionnement des appareils, et qui voit toutes les puces TPU des tranches comme des appareils locaux.
- Client proxy IFRT : bibliothèque Interim Framework Runtime (IFRT) Open Source intégrée à votre processus JAX. Lorsque vous importez
pathwaysutilset définissezJAX_PLATFORMS=proxy, votre code est dissocié de l'environnement d'exécution sous-jacent et les requêtes sont envoyées via gRPC au serveur proxy IFRT.
Nœud principal du processeur
S'exécute sur une VM dédiée uniquement au processeur dans votre cluster (un nœud de pool de nœuds de processeur sur GKE ou un nœud de calcul de processeur sur Cluster Director) :
- Serveur proxy IFRT : conteneur de serveur gRPC qui reçoit les requêtes du client proxy IFRT et les transfère à sa bibliothèque cliente Pathways intégrée.
- Client Pathways : bibliothèque d'exécution IFRT intégrée au conteneur du serveur proxy IFRT. Il envoie des programmes d'optimisation de haut niveau (HLO) au service de compilation dans le gestionnaire de ressources Pathways et coordonne l'emplacement sur gRPC. Il envoie ensuite les requêtes d'exécution et les données de tenseur aux nœuds de calcul Pathways, et présente une vue unifiée des appareils à JAX.
- Gestionnaire de ressources Pathways : conteneur du plan de contrôle central. Il gère les tranches d'accélérateur, surveille l'état des nœuds de calcul, planifie les jobs et héberge le service de compilation Pathways, qui compile les programmes HLO en exécutables XLA stockés dans le cache de compilation sous
--gcs_scratch_location.
VM de nœud de calcul Cloud TPU
Chaque VM de nœud de calcul TPU gère ses puces Cloud TPU associées (qui exécutent des calculs XLA compilés) via des conteneurs de processeur hôte :
- Nœud de calcul Pathways : charge les exécutables compilés à partir du cache de compilation, et reçoit les requêtes d'exécution et les données de tenseur du client Pathways via gRPC. Il exécute des calculs sur les puces Cloud TPU associées, échange des données avec d'autres nœuds de calcul via des interconnexions à haut débit et signale l'état au gestionnaire de ressources.
- Serveur side-car (facultatif, GKE uniquement) : conteneur gRPC (
colocated-python-sidecar) qui exécute des fonctions Python spécifiées par l'utilisateur (comme le chargement de données et la création de points de contrôle) sur la VM TPU. Il échange des tampons de tenseurs avec le nœud de calcul Pathways local via une mémoire hôte partagée sans copie. Consultez Exécuter du code Python colocalisé avec Pathways.
Composants Pathways sur GKE
Sur GKE, le pod pathways-head s'exécute sur un pool de nœuds de processeur et héberge pathways-rm et pathways-proxy (ainsi que votre conteneur de charge de travail par lot, le cas échéant). Chaque pod de travailleur TPU exécute worker (ou pathways-worker) et, lorsque Python colocalisé est activé, colocated-python-sidecar.
Vous trouverez les images de conteneurs Pathways aux emplacements suivants :
| Type de conteneur | Emplacement |
|---|---|
Serveur proxy IFRT |
|
Gestionnaire de ressources et nœud de calcul Pathways |
|
Side-car Python colocalisé (facultatif) |
|
Gestionnaire de ressources Pathways
Après avoir créé un cluster GKE, vous pouvez utiliser le containerSpec suivant pour déployer le gestionnaire de ressources Pathways :
  - name: pathways-rm
    image: us-docker.pkg.dev/cloud-tpu-v2-images/cloud-pathways/server:latest
    imagePullPolicy: Always
    env:
    - name: HOST_ADDRESS
      valueFrom:
        fieldRef:
          fieldPath: "metadata.labels['jobset.sigs.k8s.io/coordinator']"
    - name: TPU_SKIP_MDS_QUERY
      value: "true"
    args:
    - --server_port=29001
    - --node_type=resource_manager
    - --instance_count=WORKLOAD_NODEPOOL_COUNT
    - --instance_type=SLICE_TOPOLOGY
    - --gcs_scratch_location=gs://BUCKET_NAME
Remplacez les éléments suivants :
WORKLOAD_NODEPOOL_COUNT: nombre de tranches de TPU.SLICE_TOPOLOGY: type de TPU et topologie de la tranche, au formattpuTPU_TYPE:TOPOLOGY(par exemple,tpuv5e:4x4).BUCKET_NAME: bucket Cloud Storage utilisé pour les fichiers temporaires.
Le conteneur utilise également les arguments suivants :
--server_port: port utilisé par le gestionnaire de ressources Pathways pour communiquer avec d'autres composants Pathways (29001dans cet exemple).--node_type: type de nœud. Définissez cet argument surresource_managerpour le gestionnaire de ressources Pathways. Il n'est pas nécessaire pour les autres conteneurs.
Serveur proxy IFRT
Vous pouvez utiliser le containerSpec suivant pour déployer un serveur proxy IFRT :
  - name: pathways-proxy
    image: us-docker.pkg.dev/cloud-tpu-v2-images/cloud-pathways/proxy_server:latest
    imagePullPolicy: Always
    env:
    - name: PATHWAYS_HEAD
      valueFrom:
        fieldRef:
          fieldPath: "metadata.labels['jobset.sigs.k8s.io/coordinator']"
    args:
    - --resource_manager_address=$(PATHWAYS_HEAD):29001
    - --server_port=29000
    - --gcs_scratch_location=gs://BUCKET_NAME
    ports:
    - containerPort: 29000
Remplacez BUCKET_NAME par le nom du bucket Cloud Storage utilisé pour les fichiers temporaires.
Le conteneur utilise également les arguments suivants :
--resource_manager_address: nom d'hôte et port utilisés par le serveur proxy pour communiquer avec le gestionnaire de ressources Pathways. Le port doit correspondre à la valeur--server_portutilisée pour le conteneur du gestionnaire de ressources Pathways.--server_port: port utilisé par le serveur proxy IFRT pour communiquer avec le client proxy IFRT (29000dans cet exemple).--gcs_scratch_location: chemin d'accès Cloud Storage utilisé pour les fichiers temporaires.
Travailleur Pathways
Vous pouvez utiliser le containerSpec suivant pour déployer des nœuds de calcul Pathways :
- name: worker
  image: us-docker.pkg.dev/cloud-tpu-v2-images/cloud-pathways/server:latest
  imagePullPolicy: Always
  env:
  - name: PATHWAYS_HEAD
    valueFrom:
      fieldRef:
        fieldPath: "metadata.labels['jobset.sigs.k8s.io/coordinator']"
  - name: MEGASCALE_NUM_SLICES
    valueFrom:
      fieldRef:
        fieldPath: "metadata.labels['jobset.sigs.k8s.io/replicatedjob-replicas']"
  - name: MEGASCALE_SLICE_ID
    valueFrom:
      fieldRef:
        fieldPath: "metadata.labels['jobset.sigs.k8s.io/job-index']"
  - name: MEGASCALE_COORDINATOR_ADDRESS
    value: "$(PATHWAYS_HEAD)"
  args:
  - --server_port=29001
  - --resource_manager_address=$(PATHWAYS_HEAD):29001
  - --gcs_scratch_location=gs://BUCKET_NAME
  ports:
  - containerPort: 29001
  resources:
    limits:
      google.com/tpu: "4"
Remplacez BUCKET_NAME par le nom du bucket Cloud Storage utilisé pour les fichiers temporaires.
Le conteneur utilise également les arguments suivants :
--server_port: port utilisé par les nœuds de calcul pour communiquer avec le serveur proxy et le gestionnaire de ressources Pathways (29001dans cet exemple).--resource_manager_address: nom d'hôte et port que les travailleurs TPU utilisent pour communiquer avec le gestionnaire de ressources Pathways. Le port doit correspondre à la valeur--server_portutilisée pour le conteneur du gestionnaire de ressources Pathways.--gcs_scratch_location: chemin d'accès Cloud Storage utilisé pour les fichiers temporaires.
Le gestionnaire de ressources Pathways, le serveur proxy IFRT et les nœuds de calcul Pathways peuvent tous avoir des ports différents, mais dans cet exemple, le gestionnaire de ressources Pathways et le nœud de calcul Pathways partagent le même port.
Composants Pathways sur Cluster Director
Cette section met en correspondance les composants Pathways avec les jobs Slurm sur un cluster Cluster Director.
Les scripts Pathways exécutent les composants Pathways avec Enroot. Le script setup_env.sh utilise les images de conteneur suivantes, qui correspondent à la version JAX (0.11.1) de l'environnement Python qu'il crée :
| Type de conteneur | Emplacement |
|---|---|
Serveur proxy IFRT |
|
Gestionnaire de ressources et nœud de calcul Pathways |
|
Vous démarrez les composants Pathways en envoyant le script start_pathways.sh en tant que job du service Pathways. Vous n'écrivez pas vous-même les commandes suivantes.
Les scripts dérivent les arguments des variables d'environnement que vous définissez lorsque vous envoyez start_pathways.sh, telles que SLICE_SHAPE, MIN_SLICES, MAX_SLICES et GCS_BUCKET.
Gestionnaire de ressources Pathways
Le job de service Pathways exécute le gestionnaire de ressources Pathways sur un nœud de processeur. Elle exécute la commande suivante dans le conteneur serveur Pathways :
/pathways/server \
    --server_port=29001 \
    --node_type=resource_manager \
    --instance_type=tpuTPU_TYPE:TOPOLOGY \
    --instance_count=MAX_SLICES \
    --gcs_scratch_location=gs://BUCKET_NAME/pathways-scratch/shared \
    --enable_gcs_olm=false
Le script remplace les espaces réservés suivants dans la commande :
TPU_TYPEetTOPOLOGY: type de TPU et topologie de chaque tranche, dérivés deSLICE_SHAPE(par exemple,SLICE_SHAPE=2x4définittpuv6e:2x4).MAX_SLICES: nombre maximal de tranches de TPU, à partir deMAX_SLICES.BUCKET_NAME: nom de votre bucket Cloud Storage, issu deGCS_BUCKET.
La commande utilise les arguments suivants :
--server_port: port sur lequel le gestionnaire de ressources Pathways écoute. Le serveur proxy IFRT et les nœuds de calcul Pathways se connectent à ce port.--node_type: type de nœud,resource_manager. Seul le gestionnaire de ressources Pathways définit cet argument.--instance_type: type de TPU et topologie de chaque tranche.--instance_count: nombre de tranches de TPU.--gcs_scratch_location: chemin d'accès Cloud Storage utilisé pour les fichiers temporaires tels que le cache de compilation.--enable_gcs_olm: indique si Pathways crée des règles de cycle de vie des objets Cloud Storage pour nettoyer les anciennes entrées du cache de compilation. Le script désactive cette option, car elle nécessite des autorisations supplémentaires sur le bucket.
Serveur proxy IFRT
Le job du service Pathways exécute le serveur proxy IFRT sur le même nœud de processeur que le gestionnaire de ressources Pathways. Il exécute la commande suivante dans le conteneur du serveur proxy IFRT :
/pathways/proxy_server \
    --server_port=29000 \
    --resource_manager_address=RM_IP:29001 \
    --gcs_scratch_location=gs://BUCKET_NAME/pathways-scratch/shared \
    --num_elastic_instances=MAX_SLICES
Le script remplace les espaces réservés suivants dans la commande :
RM_IP: adresse IP interne du nœud de processeur exécutant le gestionnaire de ressources Pathways.BUCKET_NAME: nom de votre bucket Cloud Storage, issu deGCS_BUCKET.MAX_SLICES: nombre maximal de tranches de TPU, à partir deMAX_SLICES.
La commande utilise les arguments suivants :
--server_port: port sur lequel le serveur proxy IFRT écoute. Votre programme JAX se connecte à ce port.--resource_manager_address: adresse et port du gestionnaire de ressources Pathways.--gcs_scratch_location: même chemin d'accès Cloud Storage que le gestionnaire de ressources Pathways.--num_elastic_instances: nombre de tranches pouvant être indisponibles sans arrêter la session du proxy IFRT, à partir deMAX_SLICES. Votre charge de travail appliqueMIN_SLICES.
Lorsqu'au moins MIN_SLICES tranches sont en cours d'exécution, le job de service écrit l'adresse du serveur proxy IFRT dans ~/pathways/cluster.env. Votre programme JAX, le client proxy IFRT, lit ce fichier pour se connecter à Pathways. Le programme JAX s'exécute en tant que charge de travail (par exemple, run_maxtext.sh) ou dans un notebook Jupyter.
Travailleur Pathways
Le job du service Pathways envoie un tableau de jobs Slurm (run_worker_slice.sh) avec une tâche de tableau pour chaque tranche de TPU. Chaque tâche de tableau exécute la commande suivante dans le conteneur serveur Pathways sur chaque VM TPU de sa tranche :
/pathways/server \
    --server_port=29001 \
    --resource_manager_address=RM_IP:29001 \
    --gcs_scratch_location=gs://BUCKET_NAME/pathways-scratch/shared \
    --enable_gcs_olm=false
Le script remplit RM_IP avec l'adresse IP interne du nœud de processeur et BUCKET_NAME avec le nom de votre bucket Cloud Storage.
La commande utilise les arguments suivants :
--server_port: port sur lequel le nœud de calcul Pathways écoute. Le gestionnaire de ressources Pathways et le serveur proxy IFRT se connectent à ce port.--resource_manager_address: adresse du gestionnaire de ressources Pathways, identique à celle du serveur proxy IFRT.--gcs_scratch_locationet--enable_gcs_olm: identiques à ceux du gestionnaire de ressources Pathways.
Le script définit également la topologie TPU et les variables d'environnement MEGASCALE_* pour chaque nœud de calcul à partir des nœuds de la tranche et de l'index de la tâche de tableau.
Si une tranche TPU est préemptée ou échoue, Slurm remet sa tâche de tableau en file d'attente. Si vous avez sans mot de passe sudo sur les nœuds du cluster, le job de service éteint également les nœuds de la tranche afin que Slurm puisse les recréer. Le gestionnaire de ressources Pathways et le serveur proxy IFRT continuent de s'exécuter. Votre programme JAX n'a donc pas besoin de se connecter à une nouvelle adresse.
Étapes suivantes
- Créer un cluster GKE avec Pathways
- Créer un cluster Cluster Director avec Pathways
- Exécuter une charge de travail par lot avec Pathways
- Exécuter une charge de travail interactive avec Pathways
- Entraînement résilient avec Pathways
- Transférer des charges de travail JAX vers Pathways
- Exécuter du code Python colocalisé avec Pathways
- Résoudre les problèmes liés à Pathways sur Cloud
- Exécuter des charges de travail avec Pathways dans Cluster Toolkit