


Pathways는 대규모 멀티태스크 희소 활성화 머신러닝(ML) 시스템을 만들 수 있도록 설계된 시스템입니다. 이를 통해 수천 또는 수만 개의 가속기를 사용할 수 있으며, 처리 요구사항에 따라 다양한 태스크에 다양한 양의 컴퓨팅을 동적으로 할당할 수 있습니다.
Pathways는 단일 JAX 클라이언트가 대규모 TPU 슬라이스에서 워크로드를 조정할 수 있도록 지원하여 대규모 ML 계산을 간소화합니다. 이는 수천 개의 TPU 칩에 걸쳐 있을 수 있습니다.
Google은 내부적으로 Pathways를 사용하여 Gemini와 같은 대규모 모델을 학습시킵니다. Cloud의 Pathways는 Google Cloud 고객에게도 동일한 이점을 제공합니다.
시작하기 전에
-
이 페이지의 샘플 사용 방법에 대한 탭을 선택하세요.
gcloud
Google Cloud CLI를 설치한 후 제휴 ID로 gcloud CLI에 로그인합니다. 로그인한 후 다음 명령어를 실행하여 Google Cloud CLI를 초기화합니다.
gcloud initREST
로컬 개발 환경에서 이 페이지의 REST API 샘플을 사용하려면 gcloud CLI에 제공한 사용자 인증 정보를 사용합니다.
Google Cloud CLI를 설치한 후 제휴 ID로 gcloud CLI에 로그인합니다.
자세한 내용은 Google Cloud 인증 문서의 REST 사용을 위한 인증을 참조하세요.
시작하기 전에
Google Kubernetes Engine(GKE) 또는 Slurm이 있는 Cluster Director 클러스터에서 Pathways를 실행할 수 있습니다. 플랫폼 탭을 선택합니다.
GKE
다음 기본 요건을 완료합니다.
이 문서에서는 GKE에서 Pathways 관리형 TPU를 배치, 실시간, 대화형 워크로드에 사용하는 방법을 간략하게 설명합니다. 이 문서에서는 사용자가 단일 슬라이스 및 GKE의 멀티슬라이스 TPU를 포함하여 GKE의 TPU 사용에 이미 익숙하고 멀티슬라이스 TPU에 대한 일반적인 경험이 있다고 가정합니다.
Cluster Director
다음 기본 요건을 완료합니다.
이 문서에서는 일괄 및 대화형 워크로드를 위해 Cluster Director 클러스터에서 TPU와 함께 Pathways를 사용하는 방법을 간략히 설명합니다. 여기서는 Cluster Director, Cluster Director의 TPU 머신, Slurm을 사용한 작업 실행에 이미 익숙하고 멀티슬라이스 TPU에 대한 일반적인 경험이 있다고 가정합니다.
클러스터를 만들려면 Pathways를 사용하여 Cluster Director 클러스터 만들기를 참조하세요.
단일 컨트롤러 및 멀티 컨트롤러
여러 기기에서 계산을 관리하고 조정하는 방법에는 크게 두 가지가 있습니다.
| 기능 | 단일 컨트롤러(Pathways) | 멀티 컨트롤러(JAX 기본값) |
|---|---|---|
제어 |
단일 제어 지점: 단일 클라이언트 프로그램이 중앙 컨트롤러 역할을 합니다. |
분산 제어: 여러 프로세스가 참여하며 각 프로세스에는 자체 Python 인터프리터 인스턴스가 있습니다. |
보기 |
통합 뷰: 클라이언트는 모든 기기를 하나의 통합 시스템으로 봅니다. |
현지화된 뷰: 각 Python 프로세스는 연결된 기기만 확인합니다. |
편성 |
간소화된 프로그래밍: 단일 클라이언트와 상호작용하여 시스템이 많은 로컬 가속기가 있는 단일 대형 머신으로 표시됩니다. |
단일 프로그램, 다중 데이터(SPMD): 주로 SPMD 패러다임을 사용하므로 모든 기기에서 동일한 프로그램을 실행해야 합니다. |
유연성 |
비대칭 파이프라인 동시 로드 및 계산 희소성을 포함하여 SPMD를 넘어서는 복잡한 계산 패턴을 지원합니다. |
리소스 관리, 특히 여러 TPU 슬라이스에서 유연성이 떨어질 수 있습니다. |
Pathways 구성요소
다음 섹션에서는 Pathways 아키텍처의 주요 구성요소를 간략하게 설명합니다.
Pathways 리소스 관리자
이 구성요소는 Pathways 시스템의 중앙 컨트롤 플레인입니다. 모든 가속기 리소스를 관리하고 작업에 대한 가속기 할당을 조정합니다. 작업자의 상태를 모니터링하고 작업 예약, 일시중지, 재개를 처리합니다. 오류 및 시스템 상태의 단일 연락 지점 역할을 합니다. 이 구성요소에는 CPU 리소스만 필요합니다.
Pathways 클라이언트
이 구성요소는 Pathways 시스템의 진입점 역할을 하는 Interim Framework Runtime(IFRT)의 구현입니다. 프로그램에서 고수준 작업(HLO)을 수신합니다. Pathways 클라이언트는 Pathways 리소스 관리자와 조정하여 코드에 따라 실행을 위해 컴파일된 프로그램을 배치할 위치를 결정합니다. 지정된 JAX 클라이언트에 시스템의 통합 뷰를 제공합니다. 이 구성요소에는 CPU 리소스만 필요합니다.
Pathways 작업자
Pathways 워커 프로세스는 가속기 머신(TPU VM)에서 실행됩니다. IFRT 프록시 서버에서 프로그램의 컴파일된 실행 파일을 수신하고 TPU에서 계산을 수행합니다. Pathways 작업자는 IFRT 프록시 서버를 통해 데이터를 프로그램으로 다시 전송합니다. 이 구성요소에는 가속기 리소스가 필요합니다.
IFRT 프록시 클라이언트
IFRT 프록시 클라이언트는 기본 런타임에서 사용자 코드를 분리하고 코드 이식성과 투명성을 향상시키는 임시 프레임워크 런타임(IFRT) API의 오픈소스 구현입니다. JAX는 이 구현을 기본 멀티 컨트롤러 런타임의 대안으로 사용합니다. IFRT 프록시 클라이언트는 프로그램과 Pathways 구성요소 간의 통신 브리지 역할을 합니다. IFRT 프록시 서버에 요청을 전송하고 결과를 수신합니다. 이 구성요소에는 CPU 리소스만 필요합니다.
IFRT 프록시 서버
IFRT 프록시 서버는 IFRT 프록시 클라이언트로부터 요청을 수신하고 이를 Pathways 클라이언트에 전달하는 gRPC 서버로, Pathways 클라이언트는 작업 분산을 처리합니다. 이 구성요소에는 CPU 리소스만 필요합니다.
사이드카 서버
사이드카 서버는 가속기 VM에서 Pathways 워커와 함께 배치되는 gRPC 서버입니다. 가속기 VM에서 직접 사용자 지정 Python 코드를 실행하여 컨트롤러와 가속기 간의 데이터 전송 지연 시간을 줄입니다. 사이드카 서버는 gRPC 전송의 커스텀 버전 프로토콜을 통해 Pathways 워커와 상호작용합니다.
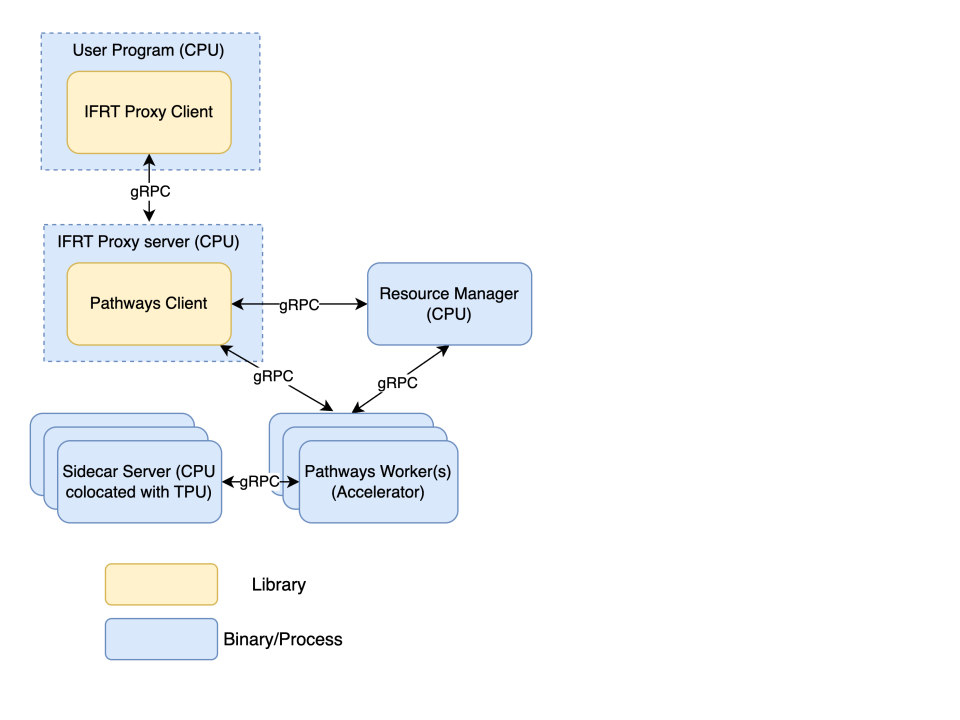
GKE의 Pathways 구성요소
이 섹션에서는 Pathways 구성요소를 컨테이너 및 포드와 같은 GKE 구성요소에 매핑합니다.
Pathways 컨테이너 이미지는 다음 위치에서 찾을 수 있습니다.
| 컨테이너 유형 | 위치 |
|---|---|
IFRT 프록시 서버 |
|
Pathways 리소스 관리자/작업자 |
|
Pathways 리소스 관리자
GKE 클러스터를 만든 후 다음 containerSpec를 사용하여 Pathways 리소스 관리자를 배포할 수 있습니다.
  - name: pathways-rm
    image: us-docker.pkg.dev/cloud-tpu-v2-images/cloud-pathways/server:latest
    imagePullPolicy: Always
    env:
    - name: HOST_ADDRESS
      valueFrom:
        fieldRef:
          fieldPath: "metadata.labels['jobset.sigs.k8s.io/coordinator']"
    - name: TPU_SKIP_MDS_QUERY
      value: "true"
    args:
    - --server_port=29001
    - --node_type=resource_manager
    - --instance_count=WORKLOAD_NODEPOOL_COUNT
    - --instance_type=SLICE_TOPOLOGY
    - --gcs_scratch_location=gs://BUCKET_NAME
컨테이너는 다음 인수를 사용합니다.
--server_port: Pathways 리소스 관리자가 다른 Pathways 구성요소와 통신하는 데 사용하는 포트입니다.--node_type: 노드 유형입니다. Pathways 리소스 관리자의 경우 이 인수를resource_manager로 설정합니다. 다른 컨테이너에는 필요하지 않습니다.--instance_count: TPU 슬라이스 수입니다.--instance_type: 슬라이스의 TPU 유형 및 토폴로지(tpuTPU_TYPE:TOPOLOGY형식)(예:tpuv5e:4x4)--gcs_scratch_location: 임시 파일에 사용되는 Cloud Storage 버킷입니다.
IFRT 프록시 서버
다음 containerSpec를 사용하여 IFRT 프록시 서버를 배포할 수 있습니다.
  - name: pathways-proxy
    image: us-docker.pkg.dev/cloud-tpu-v2-images/cloud-pathways/proxy_server:latest
    imagePullPolicy: Always
    env:
    - name: PATHWAYS_HEAD
      valueFrom:
        fieldRef:
          fieldPath: "metadata.labels['jobset.sigs.k8s.io/coordinator']"
    args:
    - --resource_manager_address=$(PATHWAYS_HEAD):29001
    - --server_port=29000
    - --gcs_scratch_location=gs://BUCKET_NAME
    ports:
    - containerPort: 29000
컨테이너는 다음 인수를 사용합니다.
--resource_manager_address: 프록시 서버가 Pathways 리소스 관리자와 통신하는 데 사용하는 호스트 이름 및 포트입니다. 포트는 Pathways 리소스 관리자 컨테이너에 사용되는--server_port값과 일치해야 합니다.--server_port: IFRT 프록시 서버가 IFRT 프록시 클라이언트와 통신하는 데 사용하는 포트입니다.--gcs_scratch_location: 임시 파일에 사용되는 Cloud Storage 버킷입니다.
Pathways 작업자
다음 containerSpec를 사용하여 Pathways 작업자를 배포할 수 있습니다.
- name: worker
  image: us-docker.pkg.dev/cloud-tpu-v2-images/cloud-pathways/server:latest
  imagePullPolicy: Always
  env:
  - name: PATHWAYS_HEAD
    valueFrom:
      fieldRef:
        fieldPath: "metadata.labels['jobset.sigs.k8s.io/coordinator']"
  - name: MEGASCALE_NUM_SLICES
    valueFrom:
      fieldRef:
        fieldPath: "metadata.labels['jobset.sigs.k8s.io/replicatedjob-replicas']"
  - name: MEGASCALE_SLICE_ID
    valueFrom:
      fieldRef:
        fieldPath: "metadata.labels['jobset.sigs.k8s.io/job-index']"
  - name: MEGASCALE_COORDINATOR_ADDRESS
    value: "$(PATHWAYS_HEAD)"
  args:
  - --server_port=29001
  - --resource_manager_address=$(PATHWAYS_HEAD):29001
  - --gcs_scratch_location=gs://BUCKET_NAME
  ports:
  - containerPort: 29001
  resources:
    limits:
      google.com/tpu: "4"
컨테이너는 다음 인수를 사용합니다.
--resource_manager_address: TPU 워커가 Pathways 리소스 관리자와 통신하는 데 사용하는 호스트 이름 및 포트입니다. 포트는 Pathways 리소스 관리자 컨테이너에 사용되는--server_port값과 일치해야 합니다.--server_port: 작업자가 프록시 서버 및 Pathways 리소스 관리자와 통신하는 데 사용하는 포트입니다.--gcs_scratch_location: 임시 파일에 사용되는 Cloud Storage 버킷입니다.
Pathways 리소스 관리자, IFRT 프록시 서버, Pathways 작업자는 모두 다른 포트를 가질 수 있지만 이 예시에서는 Pathways 리소스 관리자와 Pathways 작업자가 동일한 포트를 공유합니다.
Cluster Director의 Pathways 구성요소
이 섹션에서는 Pathways 구성요소를 Cluster Director 클러스터의 Slurm 작업에 매핑합니다.
Pathways 스크립트는 Enroot를 사용하여 Pathways 구성요소를 실행합니다. setup_env.sh 스크립트는 빌드하는 Python 환경의 JAX 버전(0.11.1)과 일치하는 다음 컨테이너 이미지를 사용합니다.
| 컨테이너 유형 | 위치 |
|---|---|
IFRT 프록시 서버 |
|
Pathways 리소스 관리자/작업자 |
|
start_pathways.sh 스크립트를 Pathways 서비스 작업으로 제출하여 Pathways 구성요소를 시작합니다. 다음 명령어를 직접 작성하지 않습니다. 스크립트는 start_pathways.sh를 제출할 때 설정한 환경 변수(예: SLICE_SHAPE, MIN_SLICES, MAX_SLICES, GCS_BUCKET)에서 인수를 파생합니다.
Pathways 리소스 관리자
Pathways 서비스 작업은 하나의 CPU 노드에서 Pathways 리소스 관리자를 실행합니다. Pathways 서버 컨테이너에서 다음 명령어를 실행합니다.
/pathways/server \
    --server_port=29001 \
    --node_type=resource_manager \
    --instance_type=tpuTPU_TYPE:TOPOLOGY \
    --instance_count=MAX_SLICES \
    --gcs_scratch_location=gs://BUCKET_NAME/pathways-scratch/shared \
    --enable_gcs_olm=false
이 명령어는 다음 인수를 사용합니다.
--server_port: Pathways 리소스 관리자가 리슨하는 포트입니다. IFRT 프록시 서버와 Pathways 작업자가 이 포트에 연결합니다.--node_type: 노드 유형(resource_manager)입니다. Pathways 리소스 관리자만 이 인수를 설정합니다.--instance_type: 각 슬라이스의 TPU 유형 및 토폴로지입니다(SLICE_SHAPE). 예를 들어SLICE_SHAPE=2x4은tpuv6e:2x4을 설정합니다.--instance_count: TPU 슬라이스 수입니다(MAX_SLICES).--gcs_scratch_location:GCS_BUCKET에서 컴파일 캐시와 같은 임시 파일에 사용되는 Cloud Storage 버킷의 경로입니다.--enable_gcs_olm: Pathways가 이전 컴파일 캐시 항목을 정리하기 위해 Cloud Storage 객체 수명 주기 규칙을 만드는지 여부입니다. 스크립트는 버킷에 대한 추가 권한이 필요하므로 이 기능을 사용 중지합니다.
IFRT 프록시 서버
Pathways 서비스 작업은 Pathways 리소스 관리자와 동일한 CPU 노드에서 IFRT 프록시 서버를 실행합니다. IFRT 프록시 서버 컨테이너에서 다음 명령어를 실행합니다.
/pathways/proxy_server \
    --server_port=29000 \
    --resource_manager_address=RM_IP:29001 \
    --gcs_scratch_location=gs://BUCKET_NAME/pathways-scratch/shared \
    --num_elastic_instances=MAX_SLICES
이 명령어는 다음 인수를 사용합니다.
--server_port: IFRT 프록시 서버가 리슨하는 포트입니다. JAX 프로그램이 이 포트에 연결됩니다.--resource_manager_address: Pathways 리소스 관리자의 주소입니다.RM_IP는 CPU 노드의 내부 IP 주소입니다.--gcs_scratch_location: Pathways 리소스 관리자와 동일한 Cloud Storage 경로입니다.--num_elastic_instances: IFRT 프록시 세션을 중지하지 않고 사용할 수 없는 슬라이스 수입니다(MAX_SLICES). 워크로드가MIN_SLICES를 적용합니다.
MIN_SLICES개 이상의 슬라이스가 실행 중이면 서비스 작업이 IFRT 프록시 서버 주소를 ~/pathways/cluster.env에 씁니다. JAX 프로그램인 IFRT 프록시 클라이언트는 이 파일을 읽어 Pathways에 연결합니다. JAX 프로그램은 워크로드(예: run_maxtext.sh) 또는 Jupyter 노트북에서 실행됩니다.
Pathways 작업자
Pathways 서비스 작업은 각 TPU 슬라이스에 대해 하나의 배열 태스크가 있는 Slurm 작업 배열(run_worker_slice.sh)을 제출합니다. 각 배열 태스크는 슬라이스의 모든 TPU VM에 있는 Pathways 서버 컨테이너에서 다음 명령어를 실행합니다.
/pathways/server \
    --server_port=29001 \
    --resource_manager_address=RM_IP:29001 \
    --gcs_scratch_location=gs://BUCKET_NAME/pathways-scratch/shared \
    --enable_gcs_olm=false
이 명령어는 다음 인수를 사용합니다.
--server_port: Pathways 작업자가 리슨하는 포트입니다. Pathways 리소스 관리자와 IFRT 프록시 서버가 이 포트에 연결됩니다.--resource_manager_address: Pathways 리소스 관리자의 주소로, IFRT 프록시 서버와 동일합니다.--gcs_scratch_location,--enable_gcs_olm: Pathways 리소스 관리자와 동일합니다.
또한 이 스크립트는 슬라이스의 노드와 배열 태스크 색인에서 각 작업자의 TPU 토폴로지와 MEGASCALE_* 환경 변수를 설정합니다.
TPU 슬라이스가 선점되거나 실패하면 Slurm은 배열 작업을 다시 큐에 추가합니다. 클러스터 노드에 비밀번호 없는 sudo가 있는 경우 서비스 작업은 Slurm이 다시 만들 수 있도록 슬라이스의 노드 전원도 끕니다. Pathways 리소스 관리자와 IFRT 프록시 서버는 계속 실행되므로 JAX 프로그램이 새 주소에 연결할 필요가 없습니다.