


Diese Säule im Google Cloud Well-Architected Framework enthält Empfehlungen zur Optimierung der Leistung von Arbeitslasten inGoogle Cloud.
Dieses Dokument richtet sich an Architekten, Entwickler und Administratoren, die Arbeitslasten in Google Cloudplanen, entwerfen, bereitstellen und verwalten.
Die Empfehlungen in dieser Säule können Ihrem Unternehmen helfen, effizient zu arbeiten, die Kundenzufriedenheit zu verbessern, den Umsatz zu steigern und die Kosten zu senken. Beispiel: Wenn die Backend-Verarbeitungszeit einer Anwendung abnimmt, genießen Nutzer schnellere Antwortzeiten, was zu einer höheren Nutzerbindung und mehr Umsatz führen kann.
Der Prozess der Leistungsoptimierung kann einen Kompromiss zwischen Leistung und Kosten erfordern. Manchmal kann die Leistungsoptimierung jedoch helfen, die Kosten zu senken. Beispiel: Wenn die Last zunimmt, kann Autoscaling eine vorhersagbare Leistung bieten, da die Systemressourcen nicht überlastet werden. Außerdem können Sie mit Autoscaling die Kosten senken, indem Sie in Zeiten geringer Last nicht verwendete Ressourcen entfernen.
Die Leistungsoptimierung ist ein kontinuierlicher Prozess, keine einmalige Aktivität. Das folgende Diagramm zeigt die Phasen des Leistungsoptimierungsprozesses:
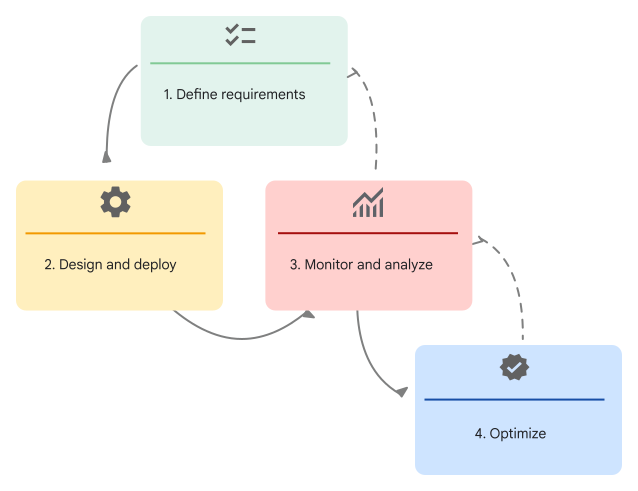
Der Leistungsoptimierungsprozess ist ein fortlaufender Zyklus, der die folgenden Phasen umfasst:
- Anforderungen definieren: Definieren Sie detaillierte Leistungsanforderungen für jede Ebene des Anwendungsstacks, bevor Sie Ihre Anwendungen entwerfen und entwickeln. Berücksichtigen Sie bei der Planung der Ressourcenzuweisung die wichtigsten Merkmale der Arbeitslast und die Leistungserwartungen.
- Entwerfen und bereitstellen: Verwenden Sie elastische und skalierbare Designmuster, mit denen Sie Ihre Leistungsanforderungen erfüllen können.
- Überwachen und analysieren: Überwachen Sie die Leistung kontinuierlich mithilfe von Logs, Tracing, Messwerten und Benachrichtigungen.
Optimieren: Ziehen Sie potenzielle Neugestaltungen in Betracht, wenn sich Ihre Anwendungen weiterentwickeln. Passen Sie die Größe von Cloud-Ressourcen an und verwenden Sie neue Funktionen, um sich ändernden Leistungsanforderungen gerecht zu werden.
Wie im vorherigen Diagramm dargestellt, setzen Sie den Zyklus aus Monitoring, Neubewertung der Anforderungen und Anpassung der Cloud-Ressourcen fort.
Prinzipien und Empfehlungen zur Leistungsoptimierung, die speziell für KI- und ML-Arbeitslasten gelten, finden Sie im Well-Architected Framework unter KI- und ML-Perspektive: Leistungsoptimierung.
Arbeitslasten mit einem KI-Agenten-Skill bewerten
Wenn Sie KI-Agenten ermöglichen möchten, Ihre Cloud-Arbeitslasten anhand der Prinzipien und Empfehlungen in dieser Säule zu bewerten, verwenden Sie den Skill google-cloud-waf-performance-optimization, der im Google Agent Skills-Repository auf GitHub verfügbar ist.
Führen Sie den folgenden Befehl im Client oder Terminal Ihres Agenten aus, um den Skill zu installieren:
npx skills add google/skills --skill google-cloud-waf-performance-optimization
Geben Sie bei entsprechender Aufforderung die KI-Agenten an, für die Sie den Skill installieren möchten, und legen Sie den Installationsbereich (Projekt oder global) fest.
Wenn Sie den Skill bereits installiert haben, können Sie ihn mit dem folgenden Befehl auf die aktuelle Version aktualisieren:
npx skills update
Grundprinzipien
Die Empfehlungen in der Säule „Leistungsoptimierung“ des Well-Architected Framework sind den folgenden Grundprinzipien zugeordnet:
- Ressourcenzuweisung planen
- Vorteile der Elastizität nutzen
- Modulares Design fördern
- Leistung kontinuierlich überwachen und verbessern
Beitragende
Autor*innen:
- Daniel Lees | Cloudsicherheitsarchitekt
- Gary Harmson | Principal Architect
- Luis Urena | Developer Relations Engineer
- Zach Seils | Networking Specialist
Weitere Beitragende:
- Filipe Gracio, PhD | Customer Engineer, AI/ML Specialist
- Jose Andrade | Customer Engineer, SRE-Spezialist
- Kumar Dhanagopal | Cross-Product Solution Developer
- Marwan Al Shawi | Partner Customer Engineer
- Nicolas Pintaux | Customer Engineer, Application Modernization Specialist
- Ryan Cox | Principal Architect
- Radhika Kanakam | Program Lead, Google Cloud Well-Architected Framework
- Samantha He | Technical Writer
- Wade Holmes | Global Solutions Director
Ressourcenzuweisung planen
Dieses Prinzip in der Säule „Leistungsoptimierung“ des Google Cloud Well-Architected Framework enthält Empfehlungen zur Planung von Ressourcen für Ihre Arbeitslasten inGoogle Cloud. Es wird betont, wie wichtig es ist, detaillierte Anforderungen zu definieren, bevor Sie Anwendungen für Cloud Deploy oder die Migration entwerfen und entwickeln.
Übersicht über die Prinzipien
Damit Ihre Geschäftsanforderungen erfüllt werden, ist es wichtig, dass Sie die Leistungsanforderungen für Ihre Anwendungen vor dem Entwurf und der Entwicklung definieren. Definieren Sie diese Anforderungen für die gesamte Anwendung und für jede Schicht des Anwendungspakets so detailliert wie möglich. In der Speicherebene müssen Sie beispielsweise den Durchsatz und die E/A-Vorgänge pro Sekunde (IOPS) berücksichtigen, die die Anwendungen benötigen.
Planen Sie Anwendungsdesigns von Anfang an mit Blick auf Leistung und Skalierbarkeit. Berücksichtigen Sie Faktoren wie die Anzahl der Nutzer, das Datenvolumen und das potenzielle Wachstum im Laufe der Zeit.
Die Leistungsanforderungen für die einzelnen Arbeitslasten variieren und hängen von der Art der Arbeitslast ab. Jede Arbeitslast kann eine Mischung aus Komponentensystemen und Diensten mit jeweils eigenen Leistungsmerkmalen enthalten. Ein System, das für die regelmäßige Batchverarbeitung großer Datasets verantwortlich ist, hat beispielsweise andere Leistungsanforderungen als eine interaktive virtuelle Desktoplösung. Ihre Optimierungsstrategien müssen auf die spezifischen Anforderungen der einzelnen Arbeitslasten zugeschnitten sein.
Wählen Sie Dienste und Features aus, die den Leistungszielen der einzelnen Arbeitslasten entsprechen. Für die Leistungsoptimierung gibt es keine Einheitslösung. Wenn Sie jede Arbeitslast optimieren, kann das gesamte System eine optimale Leistung und Effizienz erreichen.
Berücksichtigen Sie die folgenden Arbeitslastmerkmale, die sich auf Ihre Leistungsanforderungen auswirken können:
- Bereitstellungs-Archetyp: Der Bereitstellungs-Archetyp, den Sie für eine Anwendung auswählen, kann sich auf die Auswahl von Produkten und Features auswirken, die dann die Leistung bestimmen, die Sie von Ihrer Anwendung erwarten können.
- Ressourcenplatzierung: Wenn Sie eine Google Cloud Region für Ihre Anwendungsressourcen auswählen, empfehlen wir, niedrige Latenz für Endnutzer zu priorisieren, die Vorschriften zur Datenlokalität einzuhalten und die Verfügbarkeit der erforderlichen Google Cloud Produkte und Dienste sicherzustellen.
- Netzwerkverbindung: Wählen Sie Netzwerkdienste aus, die den Datenzugriff und die Inhaltsübermittlung optimieren. Nutzen Sie das globale Netzwerk, die Hochgeschwindigkeits-Backbones, die Interconnect-Standorte und die Caching-Dienste von Google Cloud.
- Anwendungshosting-Optionen: Wenn Sie eine Hosting-Plattform auswählen, müssen Sie die Leistungsvorteile und -nachteile der einzelnen Optionen bewerten. Beispiele hierfür sind Bare-Metal-Maschinen, virtuelle Maschinen, Container und serverlose Plattformen.
- Speicherstrategie: Wählen Sie eine optimale Speicherstrategie aus, die auf Ihren Leistungsanforderungen basiert.
- Ressourcenkonfigurationen: Der Maschinentyp, die IOPS und der Durchsatz können erhebliche Auswirkungen auf die Leistung haben. Außerdem müssen Sie früh in der Designphase die entsprechenden Sicherheitsfunktionen und ihre Auswirkungen auf die Ressourcen berücksichtigen. Wenn Sie Sicherheitsfunktionen planen, sollten Sie die erforderlichen Leistungseinbußen berücksichtigen, um unvorhergesehene Auswirkungen zu vermeiden.
Empfehlungen
Beachten Sie die Empfehlungen in den folgenden Abschnitten, um eine optimale Ressourcenzuweisung zu gewährleisten.
Kontingente konfigurieren und verwalten
Achten Sie darauf, dass Ihre Anwendung nur die erforderlichen Ressourcen wie Arbeitsspeicher, Speicher und Rechenleistung verwendet. Eine Überzuweisung kann zu unnötigen Ausgaben führen, während eine Unterzuweisung zu Leistungseinbußen führen kann.
Um die elastische Skalierung zu ermöglichen und sicherzustellen, dass ausreichende Ressourcen verfügbar sind, sollten Sie die Kapazität Ihrer Kontingente regelmäßig überwachen. Außerdem können Sie die Kontingentnutzung verfolgen, um potenzielle Skalierungseinschränkungen oder Probleme mit der Überallokation zu erkennen und dann fundierte Entscheidungen über die Ressourcenzuweisung zu treffen.
Aufklären und Bewusstsein schaffen
Informieren Sie Ihre Nutzer über die Leistungsanforderungen und stellen Sie Schulungsmaterialien zu effektiven Techniken für das Leistungsmanagement bereit.
Dokumentieren Sie regelmäßig die Soll- und Ist-Leistung, um den Fortschritt zu bewerten und Bereiche mit Verbesserungspotenzial zu identifizieren. Führen Sie einen Lasttest für Ihre Anwendung durch, um potenzielle Fehlerquellen zu finden und zu verstehen, wie Sie die Anwendung skalieren können.
Leistungsmesswerte überwachen
Mit Cloud Monitoring können Sie Trends in Leistungsmesswerten analysieren, die Auswirkungen von Tests analysieren, Benachrichtigungen für kritische Messwerte definieren und rückblickende Analysen durchführen.
Active Assist ist eine Reihe von Tools, die Statistiken und Empfehlungen zur Optimierung der Ressourcennutzung liefern können. Diese Empfehlungen können Ihnen helfen, die Ressourcenzuweisung anzupassen und die Leistung zu verbessern.
Elastizität nutzen
Dieses Prinzip in der Säule „Leistungsoptimierung“ des Google Cloud Well-Architected Framework enthält Empfehlungen, die Ihnen helfen, Elastizität einzubinden. Elastizität ist die Fähigkeit, Ressourcen dynamisch an Änderungen der Arbeitslastanforderungen anzupassen.
Dank der Elastizität können verschiedene Komponenten eines Systems unabhängig voneinander skaliert werden. Diese gezielte Skalierung kann die Leistung und Kosteneffizienz verbessern, da Ressourcen genau dort zugewiesen werden, wo sie benötigt werden, ohne dass Ressourcen über- oder unterdimensioniert werden.
Übersicht über die Prinzipien
Die Leistungsanforderungen eines Systems beeinflussen direkt, wann und wie das System vertikal oder horizontal skaliert wird. Sie müssen die Kapazität des Systems bewerten und die Last bestimmen, die das System voraussichtlich bei der Baseline bewältigen muss. Anschließend müssen Sie festlegen, wie das System auf Laststeigerungen und -senkungen reagieren soll.
Wenn die Last steigt, muss das System horizontal skalieren, vertikal skalieren oder beides. Fügen Sie für die horizontale Skalierung Replikatknoten hinzu, um sicherzustellen, dass das System insgesamt über genügend Kapazität verfügt, um die erhöhte Nachfrage zu erfüllen. Ersetzen Sie für die vertikale Skalierung die vorhandenen Komponenten der Anwendung durch Komponenten mit mehr Kapazität, mehr Arbeitsspeicher und mehr Speicher.
Wenn die Last abnimmt, muss das System herunterskaliert werden (horizontal, vertikal oder beides).
Legen Sie die Umstände fest, unter denen das System hoch- oder herunterskaliert wird. Planen Sie, Systeme für bekannte Zeiträume mit hohem Traffic manuell hochzuskalieren. Verwenden Sie Tools wie Autoscaling, das auf zunehmende oder abnehmende Last reagiert.
Empfehlungen
Wenn Sie die Elastizität nutzen möchten, beachten Sie die Empfehlungen in den folgenden Abschnitten.
Spitzenlastzeiten planen
Sie müssen einen effizienten Skalierungspfad für bekannte Ereignisse planen, z. B. erwartete Zeiträume mit erhöhter Kundennachfrage.
Erwägen Sie, Ihr System vor bekannten Zeiten mit hohem Traffic hochzuskalieren. Wenn Sie beispielsweise ein Einzelhandelsunternehmen sind, erwarten Sie, dass die Nachfrage während saisonaler Verkäufe steigt. Wir empfehlen, Ihre Systeme vor diesen Verkäufen manuell hoch- oder horizontal zu skalieren, damit sie die erhöhte Last sofort bewältigen können, oder vorhandene Limits sofort anzupassen. Andernfalls kann es einige Minuten dauern, bis das System Ressourcen als Reaktion auf Echtzeitänderungen hinzufügt. Die Kapazität Ihrer Anwendung erhöht sich möglicherweise nicht schnell genug, was bei einigen Nutzern zu Verzögerungen führen kann.
Bei unbekannten oder unerwarteten Ereignissen wie einem plötzlichen Anstieg der Nachfrage oder des Traffics können Sie Autoscaling-Funktionen verwenden, um eine elastische Skalierung basierend auf Messwerten auszulösen. Diese Messwerte können die CPU-Auslastung, die Bereitstellungskapazität des Load Balancers, die Latenz und sogar benutzerdefinierte Messwerte umfassen, die Sie in Cloud Monitoring definieren.
Angenommen, Sie haben eine Anwendung, die in einer verwalteten Instanzgruppe (MIG) von Compute Engine ausgeführt wird. Diese Anwendung erfordert, dass jede Instanz optimal funktioniert, bis die durchschnittliche CPU-Auslastung 75 % erreicht. In diesem Beispiel können Sie eine Autoscaling-Richtlinie definieren, die mehr Instanzen erstellt, wenn die CPU-Auslastung den Schwellenwert erreicht. Diese neu erstellten Instanzen tragen dazu bei, die Last zu bewältigen, sodass die durchschnittliche CPU-Auslastung auf einem optimalen Niveau bleibt, bis die maximale Anzahl von Instanzen erreicht ist, die Sie für die MIG konfiguriert haben. Wenn die Nachfrage sinkt, werden die nicht mehr benötigten Instanzen durch die Autoscaling-Richtlinie entfernt.
Planen Sie Ressourcen-Slot-Reservierungen in BigQuery oder passen Sie die Limits für Autoscaling-Konfigurationen in Spanner mit dem verwalteten Autoscaler an.
Vorausschauendes Autoscaling verwenden
Wenn Ihre Systemkomponenten Compute Engine enthalten, müssen Sie prüfen, ob vorausschauendes Autoscaling für Ihre Arbeitslast geeignet ist. Beim vorausschauenden Autoscaling wird die zukünftige Last anhand der Verlaufsdaten Ihrer Messwerte prognostiziert, z. B. der CPU-Auslastung. Prognosen werden alle paar Minuten neu berechnet, sodass das Autoscaling seine Prognose schnell an die neuesten Laständerungen anpasst. Ohne vorausschauendes Autoscaling kann ein Autoscaling eine Gruppe nur reaktiv skalieren, basierend auf beobachteten Echtzeitänderungen der Last. Das vorausschauende Autoscaling funktioniert sowohl mit Echtzeitdaten als auch mit Verlaufsdaten, um sowohl auf die aktuelle als auch auf die prognostizierte Last zu reagieren.
Serverlose Architekturen implementieren
Erwägen Sie die Implementierung einer serverlosen Architektur mit serverlosen Diensten, die von Natur aus elastisch sind, z. B.:
Im Gegensatz zum Autoscaling bei anderen Diensten, die die Feinabstimmung von Regeln erfordern (z. B. Compute Engine), ist das serverlose Autoscaling sofort einsatzbereit und kann auf null Ressourcen heruntergefahren werden.
Autopilot-Modus für Kubernetes verwenden
Für komplexe Anwendungen, die mehr Kontrolle über Kubernetes erfordern, sollten Sie den Autopilot-Modus in der Google Kubernetes Engine (GKE) in Betracht ziehen. Der Autopilot-Modus bietet standardmäßig Automatisierung und Skalierbarkeit. GKE skaliert Knoten und Ressourcen automatisch basierend auf dem Traffic. Die GKE verwaltet Knoten, erstellt neue Knoten für Ihre Anwendungen und konfiguriert automatische Upgrades und Reparaturen.
Modulares Design fördern
Dieses Prinzip in der Säule zur Leistungsoptimierung des Google Cloud Well-Architected Framework enthält Empfehlungen zur Förderung eines modularen Designs. Modulare Komponenten und klare Schnittstellen ermöglichen eine flexible Skalierung, unabhängige Updates und eine zukünftige Trennung von Komponenten.
Übersicht über die Prinzipien
Abhängigkeiten zwischen den Anwendungskomponenten und den Systemkomponenten verstehen, um ein skalierbares System zu entwerfen.
Ein modulares Design ermöglicht Flexibilität und Ausfallsicherheit, unabhängig davon, ob ursprünglich eine monolithische oder eine Mikrodienstarchitektur bereitgestellt wurde. Wenn Sie das System in klar definierte, unabhängige Module mit klaren Schnittstellen zerlegen, können Sie einzelne Komponenten skalieren, um bestimmte Anforderungen zu erfüllen.
Die gezielte Skalierung kann die Ressourcenauslastung optimieren und die Kosten auf folgende Weise senken:
- Stellt jeder Komponente nur die erforderlichen Ressourcen bereit und weist weniger anspruchsvollen Komponenten weniger Ressourcen zu.
- Fügt in Zeiten mit hohem Traffic weitere Ressourcen hinzu, um die Nutzerfreundlichkeit aufrechtzuerhalten.
- Entfernt nicht ausgelastete Ressourcen, ohne die Leistung zu beeinträchtigen.
Modularität verbessert auch die Wartbarkeit. Kleinere, eigenständige Einheiten sind leichter zu verstehen, zu debuggen und zu aktualisieren, was zu schnelleren Entwicklungszyklen und einem geringeren Risiko führen kann.
Die Modularität bietet zwar erhebliche Vorteile, Sie müssen jedoch die potenziellen Leistungseinbußen berücksichtigen. Die verstärkte Kommunikation zwischen Modulen kann zu Latenz und Mehraufwand führen. Streben Sie ein ausgewogenes Verhältnis zwischen Modularität und Leistung an. Ein hochgradig modulares Design ist möglicherweise nicht universell geeignet. Wenn die Leistung entscheidend ist, kann ein enger gekoppelter Ansatz sinnvoll sein. Das Systemdesign ist ein iterativer Prozess, bei dem Sie Ihr modulares Design kontinuierlich überprüfen und verfeinern.
Empfehlungen
Beachten Sie die Empfehlungen in den folgenden Abschnitten, um modulare Designs zu fördern.
Lose Kopplung berücksichtigen
Entwerfen Sie eine lose gekoppelte Architektur. Unabhängige Komponenten mit minimalen Abhängigkeiten können Ihnen helfen, skalierbare und robuste Anwendungen zu erstellen. Wenn Sie die Grenzen für Ihre Dienste planen, müssen Sie die Anforderungen an Verfügbarkeit und Skalierbarkeit berücksichtigen. Wenn eine Komponente beispielsweise andere Anforderungen als Ihre anderen Komponenten hat, können Sie die Komponente als eigenständigen Dienst entwerfen. Implementieren Sie einen Plan für kontrollierte Fehler für weniger wichtige Unterprozesse oder Dienste, die sich nicht auf die Antwortzeit der primären Dienste auswirken.
Für Nebenläufigkeit und Parallelität entwickeln
Entwerfen Sie Ihre Anwendung so, dass mehrere Aufgaben gleichzeitig unterstützt werden, z. B. die Verarbeitung mehrerer Nutzeranfragen oder die Ausführung von Hintergrundjobs, während Nutzer mit Ihrem System interagieren. Teilen Sie große Aufgaben in kleinere Blöcke auf, die von mehreren Dienstinstanzen gleichzeitig verarbeitet werden können. Mit der Nebenläufigkeit von Aufgaben können Sie Funktionen wie Autoscaling verwenden, um die Ressourcenzuweisung in Produkten wie den folgenden zu erhöhen:
Modularität für flexible Ressourcenzuweisung ausgleichen
Achten Sie nach Möglichkeit darauf, dass jede Komponente nur die erforderlichen Ressourcen (z. B. Arbeitsspeicher, Speicher und Rechenleistung) für bestimmte Vorgänge verwendet. Eine Überbelegung von Ressourcen kann zu unnötigen Kosten führen, während eine Unterbelegung die Leistung beeinträchtigen kann.
Gut definierte Schnittstellen verwenden
Sorgen Sie dafür, dass modulare Komponenten effektiv über klare, standardisierte Schnittstellen (wie APIs und Nachrichtenwarteschlangen) kommunizieren, um den Overhead durch Übersetzungsebenen oder irrelevanten Traffic zu reduzieren.
Zustandslose Modelle verwenden
Ein zustandsloses Modell kann dazu beitragen, dass jede Anfrage oder Interaktion mit dem Dienst unabhängig von vorherigen Anfragen verarbeitet werden kann. Dieses Modell erleichtert die Skalierbarkeit und Wiederherstellbarkeit, da Sie den Dienst vergrößern, verkleinern oder neu starten können, ohne die Daten zu verlieren, die für laufende Anfragen oder Prozesse erforderlich sind.
Ergänzende Technologien auswählen
Wählen Sie Technologien aus, die das modulare Design ergänzen. Bewerten Sie Programmiersprachen, Frameworks und Datenbanken im Hinblick auf ihre Unterstützung für Modularität.
Weitere Informationen finden Sie in den folgenden Ressourcen:
Leistung kontinuierlich überwachen und verbessern
Dieses Prinzip in der Säule zur Leistungsoptimierung des Google Cloud Well-Architected Framework enthält Empfehlungen, mit denen Sie die Leistung kontinuierlich überwachen und verbessern können.
Nachdem Sie Anwendungen bereitgestellt haben, können Sie deren Leistung mithilfe von Logs, Tracing, Messwerten und Benachrichtigungen kontinuierlich überwachen. Wenn Ihre Anwendungen wachsen und weiterentwickelt werden, können Sie die Trends in diesen Datenpunkten verwenden, um Ihre Leistungsanforderungen neu zu bewerten. Möglicherweise müssen Sie Teile Ihrer Anwendungen neu gestalten, um die Leistung zu erhalten oder zu verbessern.
Übersicht über die Prinzipien
Der Prozess der kontinuierlichen Leistungsverbesserung erfordert robuste Monitoring-Tools und -Strategien. Mit Cloud-Beobachtbarkeitstools können Sie Leistungskennzahlen (KPIs) wie Latenz, Durchsatz, Fehlerraten und Ressourcenauslastung erfassen. Cloud-Umgebungen bieten eine Vielzahl von Methoden, um detaillierte Leistungsbewertungen für die Anwendung, das Netzwerk und die Endnutzererfahrung durchzuführen.
Die Verbesserung der Leistung ist ein fortlaufender Prozess, der einen vielschichtigen Ansatz erfordert. Die folgenden wichtigen Mechanismen und Prozesse können Ihnen helfen, die Leistung zu steigern:
- Definieren Sie Leistungsziele, die mit Ihren Geschäftszielen übereinstimmen, um eine klare Richtung vorzugeben und den Fortschritt zu verfolgen. Setzen Sie sich SMART-Ziele: spezifisch, messbar, erreichbar, relevant und terminiert.
- Erfassen Sie KPI-Messwerte, um die Leistung zu messen und Bereiche mit Verbesserungspotenzial zu identifizieren.
- Wenn Sie Ihre Systeme kontinuierlich auf Probleme überwachen möchten, verwenden Sie visualisierte Workflows in Monitoring-Tools. Verwenden Sie Techniken zur Abbildung von Architekturprozessen, um Redundanzen und Ineffizienzen zu identifizieren.
- Wenn Sie eine Kultur der kontinuierlichen Verbesserung schaffen möchten, bieten Sie Schulungen und Programme an, die die Weiterentwicklung Ihrer Mitarbeiter unterstützen.
- Um proaktive und kontinuierliche Verbesserungen zu fördern, sollten Sie Ihre Mitarbeiter und Kunden dazu anregen, laufend Feedback zur Leistung Ihrer Anwendung zu geben.
Empfehlungen
Beachten Sie die Empfehlungen in den folgenden Abschnitten, um modulare Designs zu fördern.
Klare Leistungsziele und Messwerte definieren
Definieren Sie klare Leistungsziele, die mit Ihren Geschäftszielen übereinstimmen. Dazu ist ein tiefes Verständnis der Architektur Ihrer Anwendung und der Leistungsanforderungen der einzelnen Anwendungskomponenten erforderlich.
Optimieren Sie vorrangig die wichtigsten Komponenten, die sich direkt auf Ihre Kerngeschäftsfunktionen und die Nutzerfreundlichkeit auswirken. Damit diese Komponenten weiterhin effizient ausgeführt werden und Ihre geschäftlichen Anforderungen erfüllen, sollten Sie spezifische und messbare Leistungsziele festlegen. Diese Ziele können Antwortzeiten, Fehlerraten und Schwellenwerte für die Ressourcennutzung umfassen.
Mit diesem proaktiven Ansatz können Sie potenzielle Engpässe erkennen und beheben, die Ressourcenzuweisung optimieren und Ihren Nutzern letztendlich eine nahtlose und leistungsstarke Umgebung bieten.
Leistungsbewertung
Überwachen Sie Ihre Cloud-Systeme kontinuierlich auf Leistungsprobleme und richten Sie Benachrichtigungen für potenzielle Probleme ein. Monitoring und Benachrichtigungen können Ihnen helfen, Probleme zu erkennen und zu beheben, bevor sie sich auf Nutzer auswirken. Mithilfe von Anwendungsprofilen können Sie Engpässe identifizieren und die Ressourcennutzung optimieren.
Sie können Tools verwenden, die eine effektive Fehlerbehebung und Netzwerkoptimierung ermöglichen. Verwenden Sie Google Cloud Observability, um Bereiche mit hohem CPU-, Arbeitsspeicher- oder Netzwerkverbrauch zu identifizieren. Diese Funktionen können Entwicklern helfen, die Effizienz zu steigern, die Kosten zu senken und die Nutzerfreundlichkeit zu verbessern. Das Network Intelligence Center zeigt Visualisierungen der Topologie Ihrer Netzwerkinfrastruktur und kann Ihnen helfen, Pfade mit hoher Latenz zu identifizieren.
Anreize für kontinuierliche Verbesserungen schaffen
Schaffen Sie eine Kultur der kontinuierlichen Verbesserung, von der sowohl die Anwendung als auch die Nutzererfahrung profitieren können.
Bieten Sie Ihren Mitarbeitern Schulungs- und Entwicklungsmöglichkeiten, um ihre Fähigkeiten und Kenntnisse im Bereich der Leistungstechniken für Cloud-Dienste zu verbessern. Richten Sie eine Community of Practice (CoP) ein und bieten Sie Mentoring- und Coaching-Programme an, um die Entwicklung der Mitarbeiter zu unterstützen.
Um ein reaktives Leistungsmanagement zu verhindern und ein proaktives Leistungsmanagement zu fördern, sollten Sie fortlaufendes Feedback von Ihren Mitarbeitenden, Ihren Kunden und Ihren Stakeholdern einholen. Sie können den Prozess spielerisch gestalten, indem Sie KPIs zur Leistung erfassen und diese Messwerte den Teams regelmäßig in Form einer Rangliste präsentieren.
Um die Leistung und die Zufriedenheit der Nutzer im Laufe der Zeit zu verstehen, empfehlen wir, das Nutzerfeedback quantitativ und qualitativ zu messen. Das HEART-Framework kann Ihnen helfen, Nutzerfeedback in fünf Kategorien zu erfassen:
- Zufriedenheit
- Engagement
- Akzeptanz
- Kundenbindung
- Erfolg
Mit einem solchen Framework können Sie Entwickler mit datengestütztem Feedback, nutzerorientierten Messwerten, umsetzbaren Informationen und einem klaren Verständnis der Ziele motivieren.