


Ce principe du pilier "Fiabilité" du Google Cloud Well-Architected Framework fournit des recommandations pour vous aider à effectuer des analyses post-mortem efficaces après des défaillances et des incidents.
Ce principe est pertinent pour le domaine d'apprentissage de la fiabilité.
Présentation du principe
Une analyse post-mortem est un compte rendu écrit d'un incident, de son impact, des mesures prises pour l'atténuer ou le résoudre, de ses causes et des actions de suivi permettant d'éviter que le problème ne se reproduise. L'objectif d'une analyse post-mortem est d'apprendre des erreurs, et non de désigner des coupables.
Le schéma suivant illustre le workflow d'un post-mortem :
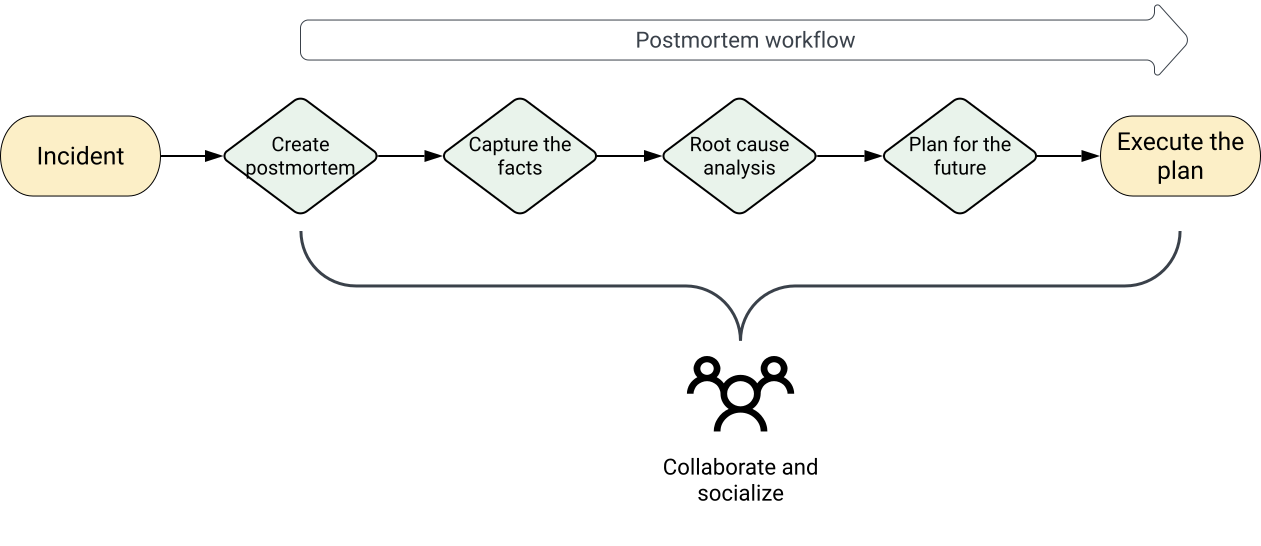
Le workflow d'un post-mortem comprend les étapes suivantes :
- Créer un post-mortem
- Capturer les faits
- Identifier et analyser les causes profondes
- Planifier l'avenir
- Exécuter le plan
Effectuez des analyses post-mortem après des événements majeurs et non majeurs, tels que les suivants :
- Temps d'arrêt ou dégradations visibles par l'utilisateur au-delà d'un certain seuil.
- Pertes de données de quelque nature que ce soit.
- Interventions des ingénieurs d'astreinte, telles qu'un rollback de version ou un réacheminement du trafic.
- Délais de résolution supérieurs à un seuil défini.
- Échecs de surveillance, qui impliquent généralement la découverte manuelle des incidents.
Recommandations
Définissez des critères de post-mortem avant qu'un incident ne se produise afin que tout le monde sache quand un post-mortem est nécessaire.
Pour effectuer des analyses post-mortem efficaces, tenez compte des recommandations des sous-sections suivantes.
Réaliser des analyses post-mortem non accusatoires
Les post-mortems efficaces se concentrent sur les processus, les outils et les technologies, et ne rejettent pas la faute sur des individus ou des équipes. L'objectif d'une analyse post-mortem est d'améliorer votre technologie et votre avenir, et non de trouver un coupable. Tout le monde fait des erreurs. L'objectif doit être d'analyser les erreurs et d'en tirer des enseignements.
Les exemples suivants montrent la différence entre un feedback qui attribue la responsabilité et un feedback sans reproche :
- Commentaire qui rejette la faute : "Nous devons réécrire l'intégralité du système de backend complexe ! Il tombe en panne toutes les semaines depuis trois trimestres, et je suis sûr que nous en avons tous assez de corriger les problèmes au coup par coup. Sérieusement, si je reçois encore un message, je le réécrirai moi-même…"
- Commentaire sans reproche : "Une action visant à réécrire l'ensemble du système de backend pourrait empêcher ces pages de continuer à se produire. Le manuel de maintenance de cette version est assez long et il est vraiment difficile de se former complètement. Je suis sûr que nos futurs ingénieurs d'astreinte nous en remercieront !"
Rendre le rapport post-mortem lisible par tous les publics visés
Pour chaque information que vous prévoyez d'inclure dans le rapport, déterminez si elle est importante et nécessaire pour aider l'audience à comprendre ce qui s'est passé. Vous pouvez déplacer les données et explications supplémentaires dans une annexe du rapport. Les examinateurs qui ont besoin d'informations supplémentaires peuvent les demander.
Éviter les solutions complexes ou surdimensionnées
Avant de commencer à explorer des solutions à un problème, évaluez l'importance du problème et la probabilité qu'il se reproduise. Ajouter de la complexité au système pour résoudre des problèmes qui ne se reproduiront probablement pas peut entraîner une instabilité accrue.
Partager le post-mortem aussi largement que possible
Pour vous assurer que les problèmes ne restent pas sans solution, publiez le résultat du post-mortem auprès d'un large public et obtenez l'assistance de la direction. La valeur d'un post-mortem est proportionnelle à l'apprentissage qui en découle. Plus les personnes tirent des enseignements des incidents, plus la probabilité que des défaillances similaires se reproduisent est réduite.