


Questo principio del pilastro dell'affidabilità del Google Cloud Well-Architected Framework fornisce consigli per aiutarti a condurre post-mortem efficaci dopo errori e incidenti.
Questo principio è pertinente all'area di interesse apprendimento dell'affidabilità.
Panoramica del principio
Un postmortem è un resoconto scritto di un incidente, del suo impatto, delle azioni intraprese per mitigarlo o risolverlo, delle cause principali e delle azioni di follow-up per evitare che si ripeta. L'obiettivo di un postmortem è imparare dagli errori e non attribuire colpe.
Il seguente diagramma mostra il flusso di lavoro di un postmortem:
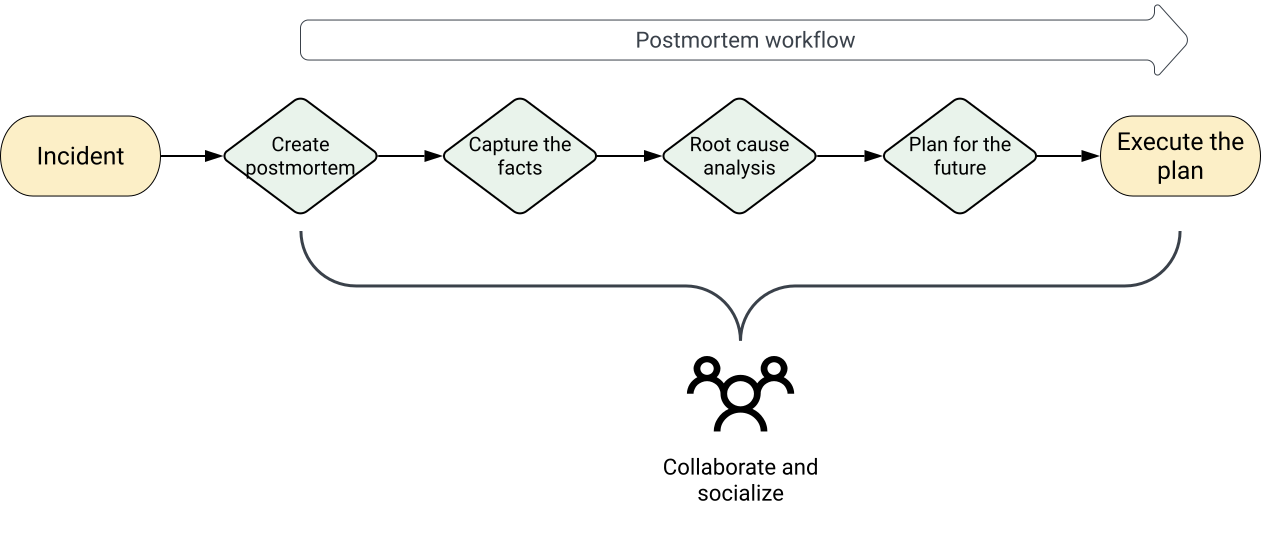
Il flusso di lavoro di un postmortem include i seguenti passaggi:
- Crea postmortem
- Acquisisci i fatti
- Identifica e analizza le cause principali
- Pianifica per il futuro
- Esegui il piano
Esegui analisi post mortem dopo eventi importanti e non importanti, come i seguenti:
- Tempi di inattività o peggioramenti visibili agli utenti oltre una determinata soglia.
- Perdite di dati di qualsiasi tipo.
- Interventi da parte degli on-call engineer, come il rollback di una release o il reindirizzamento del traffico.
- Tempi di risoluzione superiori a una soglia definita.
- Errori di monitoraggio, che di solito implicano il rilevamento manuale degli incidenti.
Consigli
Definisci i criteri per il postmortem prima che si verifichi un incidente, in modo che tutti sappiano quando è necessario.
Per condurre postmortem efficaci, prendi in considerazione i consigli riportati nelle seguenti sottosezioni.
Esegui analisi post mortem senza attribuzione delle colpe
I postmortem efficaci si concentrano su processi, strumenti e tecnologie e non attribuiscono la colpa a singoli individui o team. Lo scopo di un'analisi post-mortem è migliorare la tecnologia e il futuro, non trovare i colpevoli. Tutti commettiamo errori. L'obiettivo deve essere quello di analizzare gli errori e imparare da questi.
I seguenti esempi mostrano la differenza tra un feedback che attribuisce la colpa e un feedback senza colpe:
- Feedback che attribuisce la colpa: "Dobbiamo riscrivere l'intero complicato sistema di backend! Si è rotto ogni settimana negli ultimi tre trimestri e sono sicuro che siamo tutti stanchi di risolvere i problemi un po' alla volta. Seriamente, se ricevo un altro avviso, lo riscrivo io…"
- Feedback senza colpe: "Un'attività per riscrivere l'intero sistema di backend potrebbe effettivamente impedire che queste pagine continuino a verificarsi. Il manuale di manutenzione di questa versione è piuttosto lungo ed è davvero difficile ricevere una formazione completa. Sono sicuro che i nostri futuri on-call engineer ci ringrazieranno!"
Rendi il report postmortem leggibile da tutti i segmenti di pubblico previsti
Per ogni informazione che prevedi di includere nel report, valuta se è importante e necessaria per aiutare il pubblico a capire cosa è successo. Puoi spostare i dati e le spiegazioni supplementari in un'appendice del report. I revisori che hanno bisogno di ulteriori informazioni possono richiederle.
Evita soluzioni complesse o eccessivamente ingegnerizzate
Prima di iniziare a esplorare le soluzioni per un problema, valuta l'importanza del problema e la probabilità che si ripeta. Aggiungere complessità al sistema per risolvere problemi che difficilmente si ripresenteranno può portare a una maggiore instabilità.
Condividi il postmortem nel modo più ampio possibile
Per assicurarti che i problemi non rimangano irrisolti, pubblica il risultato del postmortem per un pubblico ampio e ottieni il supporto della dirigenza. Il valore di un postmortem è proporzionale all'apprendimento che avviene dopo il postmortem. Quando più persone imparano dagli incidenti, la probabilità che si verifichino errori simili si riduce.