


Google Cloud Well-Architected Framework の信頼性の柱におけるこの原則では、障害やインシデントの後に効果的な事後検証を実施するうえで役に立つ推奨事項が示されています。
この原則は、信頼性の学習の重点分野に関連しています。
原則の概要
事後検証は、インシデント、その影響、インシデントを軽減または解決するために講じた措置、根本原因、インシデントの再発を防ぐためのフォローアップ措置に関する書面による記録です。事後検証の目的は、失敗から学ぶことであり、責任を追及することではありません。
次の図は、ポストモーテムのワークフローを示しています。
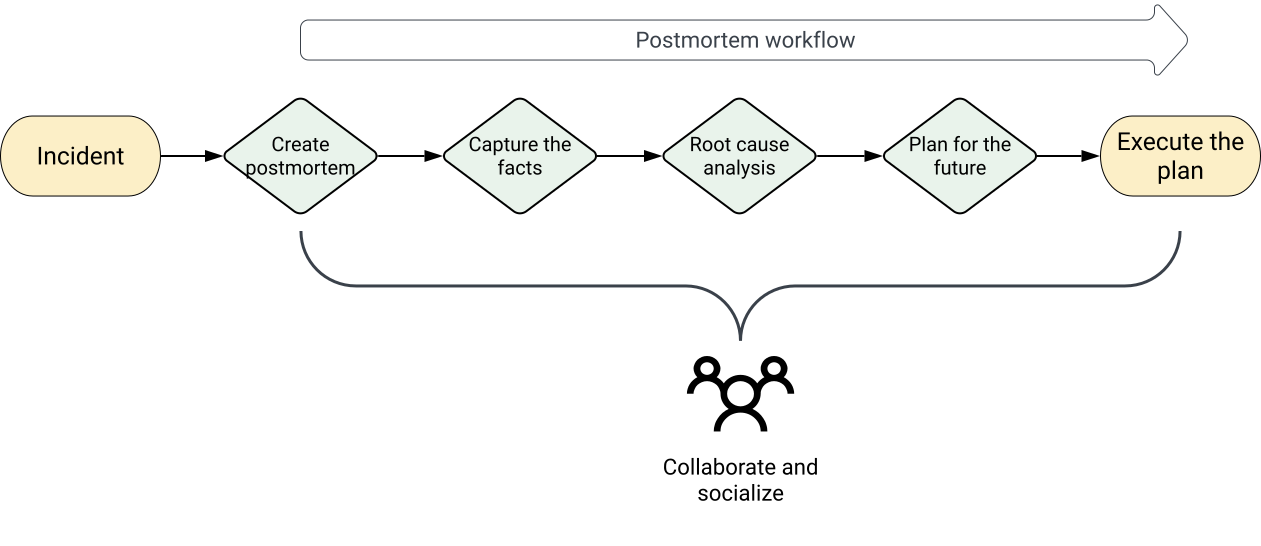
ポストモーテムのワークフローには、次のステップが含まれます。
- ポストモーテムを作成する
- 事実を把握する
- 根本原因を特定して分析する
- 将来を見据えて計画を立てる
- 計画を実行する
次のような重大なイベントと重大でないイベントの後に事後分析を実施します。
- ユーザーが感じるダウンタイムまたはパフォーマンスの低下が特定のしきい値を超えている。
- あらゆる種類のデータ損失。
- リリースのロールバックやトラフィックの再ルーティングなど、オンコール エンジニアによる介入。
- 定義されたしきい値を超える解決時間。
- モニタリングの失敗。通常、インシデントの手動検出を意味します。
推奨事項
インシデントが発生する前に、事後分析の基準を定義して、事後分析が必要なタイミングを全員が把握できるようにします。
効果的な事後検証を行うには、次のサブセクションの推奨事項を検討してください。
過失を責めない事後検証を実施する
効果的なポストモーテムは、プロセス、ツール、テクノロジーに焦点を当て、個人やチームを非難しません。ポストモーテム分析の目的は、技術と将来を改善することであり、誰が有罪かを見つけることではありません。誰にでも間違いはあります。目標は、ミスを分析し、そこから学ぶことです。
次の例は、責任を追及するフィードバックと、責任を追及しないフィードバックの違いを示しています。
- 責任を追及するフィードバック: 「複雑なバックエンド システム全体を書き直す必要があります。過去 3 四半期にわたって毎週のように不具合が発生しており、皆さん、その都度修正することにうんざりしていると思います。本当に、もう一度ページングされたら、自分で書き直します…」
- 非難のないフィードバック: 「バックエンド システム全体を書き換えるアクション アイテムにより、これらのページが引き続き発生するのを防ぐことができます。このバージョンのメンテナンス マニュアルは非常に長く、完全に習得するのは困難です。将来のオンコール エンジニアも、きっと私たちに感謝してくれるでしょう。」
事後検証レポートを対象者全員が読めるようにする
レポートに含める予定の各情報について、その情報が重要であり、何が起こったかをオーディエンスが理解するのに役立つかどうかを評価します。補足データや説明は、レポートの付録に移動できます。審査担当者は、追加情報が必要な場合にリクエストできます。
複雑なソリューションや過剰なエンジニアリングは避ける
問題の解決策を検討する前に、問題の重要性と再発の可能性を評価します。再び発生する可能性が低い問題を解決するためにシステムを複雑にすると、不安定さが増す可能性があります。
事後検証を可能な限り広く共有する
問題が未解決のままにならないように、ポストモーテムの結果を幅広い対象者に公開し、経営陣からサポートを得ます。事後検証の価値は、事後検証後に発生する学習に比例します。インシデントから学ぶ人が増えるほど、同様の障害が再発する可能性は低くなります。