


Questo documento descrive le architetture di deployment, i casi d'uso e le best practice per la gestione di database multi-cloud. È rivolto ad architetti e ingegneri che progettano e implementano applicazioni stateful all'interno e tra più cloud.
Le architetture di applicazioni multi-cloud che accedono ai database dipendono dal caso d'uso. Nessuna singola architettura di applicazioni stateful può supportare tutti i casi d'uso multicloud. Ad esempio, la migliore soluzione di database per un caso d'uso di cloud bursting è diversa dalla migliore soluzione di database per un'applicazione eseguita contemporaneamente in più ambienti cloud.
Per i cloud pubblici come Google Cloud, esistono varie tecnologie di database che si adattano a casi d'uso multi-cloud specifici. Per eseguire il deployment di un'applicazione in più regioni all'interno di un singolo cloud pubblico, un'opzione è utilizzare un database multiregionale gestito dal provider di cloud pubblico, come Spanner. Per eseguire il deployment di un'applicazione in modo che sia portabile tra cloud pubblici, un database indipendente dalla piattaforma potrebbe essere una scelta migliore, ad esempio AlloyDB Omni o PostgreSQL.
Questo documento introduce una definizione di applicazione di database stateful, seguita da un'analisi dei casi d'uso dei database multi-cloud. Poi presenta una categorizzazione dettagliata dei sistemi di database per le architetture di deployment multi-cloud in base ai casi d'uso.
Il documento introduce anche un albero decisionale per la selezione dei database che delinea i punti decisionali chiave per la selezione di una tecnologia di database appropriata. Si conclude con una discussione sulle best practice per la gestione di database multicloud.
Termini e definizioni chiave
Questa sezione fornisce una terminologia e definisce l'applicazione di database stateful generica utilizzata in questo documento.
Terminologia
- Cloud pubblico. Un cloud pubblico fornisce infrastrutture (generalmente globali) e servizi multi-tenant che i clienti possono utilizzare per eseguire i propri workload di produzione. Google Cloud è un cloud pubblico che fornisce molti servizi gestiti, tra cui GKE e database gestiti.
- Cloud ibrido. Un cloud ibrido è una combinazione di un cloud pubblico con uno o più data center on-premise. I clienti del cloud ibrido possono combinare i propri servizi on-premise con servizi aggiuntivi forniti da un cloud pubblico.
- Multi-cloud. Un multi-cloud è una combinazione di diversi cloud pubblici e data center on-premise. Un cloud ibrido è un sottoinsieme del multi-cloud.
- Località di deployment. Una località dell'infrastruttura è una località fisica in cui è possibile eseguire il deployment e l'esecuzione di workload, tra cui applicazioni e database. Ad esempio, in Google Cloud, le località di deployment sono zone e regioni. A livello astratto, una zona o una regione di cloud pubblico e un data center on-premise sono località di deployment.
Applicazioni di database stateful
Per definire i casi d'uso multi-cloud, in questo documento viene utilizzata un'architettura generica di applicazioni di database stateful, come mostrato nel diagramma seguente.

Il diagramma mostra i seguenti componenti:
- Database. Un database può essere un database a istanza singola, multi-istanza o distribuito, di cui è stato eseguito il deployment su nodi di computing o disponibile come servizio gestito nel cloud.
- Servizi per le applicazioni. Questi servizi sono combinati in un'applicazione che implementa la logica di business. I servizi per le applicazioni possono essere:
- Microservizi su Kubernetes.
- Processi a grana grossa in esecuzione su una o più macchine virtuali.
- Un'applicazione monolitica su una macchina virtuale di grandi dimensioni.
- Codice serverless in Cloud Run Functions o Cloud Run. Alcuni servizi dell'applicazione possono accedere al database. È possibile eseguire il deployment di ogni servizio dell'applicazione più volte. Ogni deployment di un servizio dell'applicazione è un'istanza di quel servizio dell'applicazione.
- Client di applicazioni. I client delle applicazioni accedono alle funzionalità fornite dai servizi delle applicazioni. I client dell'applicazione possono essere uno dei seguenti:
- Client di cui è stato eseguito il deployment, in cui il codice viene eseguito su un computer, un laptop o uno smartphone.
- Client non di cui non è stato eseguito il deployment, in cui il codice client viene eseguito in un browser. Le istanze client dell'applicazione accedono sempre a una o più istanze di servizio dell'applicazione.
Nel contesto di una discussione sui database multi-cloud, l'astrazione architetturale di un'applicazione stateful è costituita da un database, servizi dell'applicazione e client dell'applicazione. In un'implementazione di un'applicazione, fattori come l'utilizzo di sistemi operativi o i linguaggi di programmazione utilizzati possono variare. Tuttavia, questi dettagli non influiscono sulla gestione dei database multicloud.
Code e file come servizi di archiviazione dati
Esistono molte risorse persistenti disponibili per i servizi delle applicazioni per rendere persistenti i dati. Queste risorse includono database, code e file. Ogni risorsa persistente fornisce modelli di dati di archiviazione e pattern di accesso specializzati per questi modelli. Sebbene le code, i sistemi di messaggistica e i file system siano utilizzati dalle applicazioni, nella sezione seguente l'attenzione è rivolta specificamente ai database.
Sebbene le stesse considerazioni relative a fattori quali la località di deployment, la condivisione dello stato, la replica sincrona e asincrona per i database multi-cloud siano applicabili a code e file, questa discussione non rientra nell'ambito di questo documento.
Networking
Nell'architettura di un'applicazione stateful generica (mostrata di nuovo nel diagramma seguente), ogni freccia tra i componenti rappresenta una relazione di comunicazione su una connessione di rete, ad esempio un client dell'applicazione che accede a un servizio dell'applicazione.
Una connessione può essere all'interno di una zona o tra zone, regioni o cloud. Le connessioni possono esistere tra qualsiasi combinazione di località di deployment. Negli ambienti multi-cloud, il networking tra cloud è un aspetto importante e sono disponibili diverse opzioni. Per saperne di più sul networking tra cloud, consulta Cross-Cloud Network per applicazioni distribuite e Connessione a Google Cloud: spiegazione delle opzioni di networking.
Nei casi d'uso descritti in questo documento, si presuppone quanto segue:
- Esiste una connessione di rete sicura tra i cloud.
- I database e i relativi componenti possono comunicare tra loro.
Da una prospettiva non funzionale, le dimensioni della rete, ovvero la velocità effettiva e la latenza, potrebbero influire sulla latenza e sulla velocità effettiva del database. Dal punto di vista funzionale, il networking in genere non ha alcun effetto.
Casi d'uso dei database multi-cloud
Questa sezione presenta una selezione dei casi d'uso più comuni per la gestione di database multi-cloud. Per questi casi d'uso, si presuppone che esista una connessione di rete sicura tra i cloud e i nodi del database.
Migrazione di applicazioni
Nel contesto della gestione di database multi-cloud, la migrazione delle applicazioni si riferisce alla migrazione di un'applicazione, di tutti i servizi dell'applicazione e del database dal cloud attuale a un cloud di destinazione. Esistono molti motivi per cui un'azienda potrebbe decidere di eseguire la migrazione di un'applicazione, ad esempio per evitare una situazione di concorrenza con il cloud provider, per modernizzare la tecnologia o per ridurre il costo totale di proprietà (TCO).
Nella migrazione delle applicazioni, l'intento è interrompere la produzione nel cloud attuale e continuare la produzione nel cloud di destinazione al termine della migrazione. I servizi dell'applicazione devono essere eseguiti nel cloud di destinazione. Per implementare i servizi, è possibile utilizzare un approccio lift and shift. In questo approccio, viene eseguito il deployment dello stesso codice nel cloud di destinazione. Per reimplementare il servizio, è possibile utilizzare le moderne tecnologie cloud disponibili nel cloud di destinazione.
Dal punto di vista del database, prendi in considerazione le seguenti opzioni alternative per la migrazione delle applicazioni:
- Lift and shift del database: se nel cloud di destinazione è disponibile lo stesso motore del database, è possibile eseguire il lift and shift del database per creare un deployment identico nel cloud di destinazione.
- Lift and move del database all'equivalente gestito: è possibile eseguire la migrazione di un database autogestito a una versione gestita dello stesso motore del database se il cloud di destinazione lo fornisce.
- Modernizzazione dei database: cloud diversi offrono tecnologie di database diverse. I database gestiti da un cloud provider potrebbero presentare vantaggi come accordi sul livello del servizio (SLA) più rigorosi, scalabilità e ripristino di emergenza automatico.
Indipendentemente dalla strategia di deployment, la migrazione del database è un processo che richiede tempo a causa della necessità di spostare i dati dal cloud attuale a quello di destinazione. Sebbene sia possibile seguire un approccio di esportazione e importazione che comporta tempi di inattività, è preferibile una migrazione con tempi di inattività minimi o nulli. Questo approccio riduce al minimo i tempi di inattività delle applicazioni e ha un impatto minimo su un'azienda e sui suoi clienti. Tuttavia, in genere richiede una configurazione della migrazione più complessa, in quanto prevede un caricamento iniziale, una replica continua, il monitoraggio, una convalida granulare e la sincronizzazione durante il passaggio. Per supportare gli scenari di fallback, devi implementare un meccanismo di replica inversa per sincronizzare le modifiche nel database di origine dopo il passaggio al database di destinazione.
Disaster recovery
Il disaster recovery si riferisce alla capacità di un'applicazione di continuare a fornire servizi ai client dell'applicazione durante un'interruzione della regione. Per garantire il disaster recovery, un'applicazione deve essere distribuita in almeno due regioni ed essere pronta per l'esecuzione in qualsiasi momento. In produzione, l'applicazione viene eseguita nella regione principale. Tuttavia, se si verifica un'interruzione, una regione secondaria diventa la regione principale. Di seguito sono riportati i diversi modelli di idoneità per il ripristino di emergenza:
- Hot standby. Il deployment dell'applicazione viene eseguito in due o più regioni (principale e secondaria) e l'applicazione è completamente funzionante in ogni regione. Se la regione principale non funziona, l'applicazione nella regione secondaria può gestire immediatamente il traffico dei client dell'applicazione.
- Cold standby. L'applicazione è in esecuzione nella regione principale, ma è pronta per l'avvio in una regione secondaria (ma non è in esecuzione). Se la regione principale non funziona correttamente, l'applicazione viene avviata nella regione secondaria. Si verifica un'interruzione dell'applicazione finché l'applicazione non è in grado di essere eseguita e di fornire tutti i servizi ai client.
- Nessuno standby. In questo modello, il deployment del codice dell'applicazione è pronto, ma non è ancora stato eseguito nella regione secondaria (e quindi non utilizza risorse di cui è stato eseguito il deployment). Se si verifica un'interruzione nella regione principale, il primo deployment dell'applicazione deve essere eseguito nella regione secondaria. Questo deployment mette l'applicazione nello stesso stato di un cold standby, il che significa che deve essere avviata. In questo approccio, l'interruzione dell'applicazione è più lunga rispetto al caso di cold standby perché il deployment dell'applicazione deve avvenire per primo, il che include la creazione di risorse cloud.
Dal punto di vista del database, i modelli di idoneità discussi nell'elenco precedente corrispondono ai seguenti approcci al database:
- Database sincronizzato a livello transazionale. Questo database corrisponde al modello hot standby. Ogni transazione nella regione principale viene eseguita in coordinamento sincrono in una regione secondaria. Quando la regione secondaria diventa la regione principale durante un'interruzione, il database è coerente e immediatamente disponibile. In questo modello, il Recovery Point Objective (RPO) e il Recovery Time Objective (RTO) sono entrambi pari a zero.
- Database replicato in modo asincrono. Anche questo database corrisponde al modello hot standby. Poiché la replica del database dalla regione principale alla regione secondaria è asincrona, è possibile che, se la regione principale non funziona, alcune transazioni vengano replicate nella regione secondaria. Anche se il database nella regione secondaria è pronto per il carico di produzione, potrebbe non contenere i dati più aggiornati. Per questo motivo, l'applicazione potrebbe subire una perdita di transazioni non recuperabili. A causa di questo rischio, questo approccio ha un RTO pari a zero, ma l'RPO è maggiore di zero.
- Database inattivo. Questo database corrisponde al modello di cold standby. Il database viene creato senza dati. Quando la regione principale non funziona, i dati devono essere caricati nel database inattivo. Per abilitare questa azione, è necessario eseguire un backup regolare nella regione principale e trasferirlo alla regione secondaria. Il backup può essere completo o incrementale, a seconda di ciò che è supportato dal motore del database. In entrambi i casi, il database viene ripristinato all'ultimo backup e, dal punto di vista dell'applicazione, molte transazioni possono andare perse rispetto alla regione principale. Sebbene questo approccio possa essere conveniente, il valore è mitigato dal rischio che tutte le transazioni dall'ultimo backup disponibile possano andare perse a causa dello stato del database non aggiornato.
- Nessun database. Questo modello è equivalente al caso no standby. Nella regione secondaria non è installato alcun database e, se la regione principale non funziona, è necessario creare un database. Dopo la creazione del database, come nel caso del database inattivo, è necessario caricarlo con i dati prima che sia disponibile per l'applicazione.
Gli approcci di ripristino di emergenza discussi in questo documento si applicano anche se vengono utilizzati un cloud primario e uno secondario anziché una regione primaria e una secondaria. La differenza principale è che, a causa dell'eterogeneità della rete tra i cloud, la latenza tra i cloud potrebbe aumentare rispetto alla distanza di rete tra le regioni all'interno di un cloud. Altre discrepanze possono derivare da funzionalità e impostazioni predefinite diverse dei database gestiti di diversi provider cloud.
La probabilità che un intero cloud non funzioni è inferiore a quella di un errore a livello di regione. Tuttavia, per le aziende potrebbe comunque essere utile eseguire il deployment di un'applicazione in due cloud. Questo approccio potrebbe aiutare a proteggere un'azienda da errori o a rispettare le normative aziendali o di settore.
Un altro approccio al ripristino di emergenza consiste nell'avere una regione principale e una secondaria, nonché un cloud principale e uno secondario. Questo approccio consente alle aziende di scegliere il processo di ripristino di emergenza migliore per affrontare una situazione di errore. Per consentire l'esecuzione di un'applicazione, è possibile utilizzare una regione secondaria o un cloud secondario, a seconda della gravità dell'interruzione.
Cloud bursting
Il termine cloud bursting si riferisce a una configurazione che consente lo scale up del traffico client delle applicazioni in diverse località di deployment. Un'applicazione esegue il bursting quando la domanda di capacità aumenta e una località in standby fornisce capacità aggiuntiva. Una località principale supporta il traffico regolare, mentre una località in standby può fornire capacità aggiuntiva nel caso in cui il traffico dei client dell'applicazione aumenti oltre quello che la località principale può supportare. Sia nella località principale che in quella di standby è stato eseguito il deployment di istanze del servizio dell'applicazione.
Il cloud bursting viene implementato tra cloud in cui un cloud è il cloud principale e un secondo cloud è il cloud in standby. Viene utilizzato in un contesto di cloud ibrido per aumentare un numero limitato di risorse di calcolo nei data center on-premise con risorse di cloud computing elastiche in un cloud pubblico.
Per l'assistenza sui database, sono disponibili le seguenti opzioni:
- Deployment nella località principale. In questo deployment, il database viene eseguito solo nella località principale e non in quella di standby. Quando un'applicazione esegue il bursting, l'applicazione nella località di standby accede al database nella località principale.
- Deployment delle località principale e di standby. Questo deployment supporta sia la località principale sia quella di standby. Viene eseguito il deployment di un'istanza di database in entrambe le località, a cui accedono le istanze del servizio dell'applicazione di quella località, in particolare in caso di bursting. Come in Disaster recovery all'interno e tra cloud, i due database possono essere sincronizzati in modo transazionale o asincrono. Nella sincronizzazione asincrona, può verificarsi un ritardo. Se gli aggiornamenti vengono eseguiti nella località di standby, devono essere propagati alla località principale. Se sono possibili aggiornamenti simultanei in entrambe le località, è necessario implementare la risoluzione dei conflitti.
Il cloud bursting è un caso d'uso comune nei cloud ibridi per aumentare la capacità nei data center on-premise. È anche un approccio che può essere utilizzato nei cloud pubblici quando i dati devono rimanere all'interno di un paese. In situazioni in cui un cloud pubblico ha una sola regione in un paese, è possibile eseguire il bursting in una regione di un cloud pubblico diverso nello stesso paese. Questo approccio garantisce che i dati rimangano all'interno del paese, pur affrontando i vincoli delle risorse nella regione delle regioni cloud pubblico.
Utilizzo di servizi cloud di prim'ordine
Alcune applicazioni richiedono prodotti e servizi cloud specializzati che non sono disponibili in un unico cloud. Ad esempio, un'applicazione potrebbe eseguire l'elaborazione della logica di business dei dati aziendali in un cloud e l'analisi dei dati aziendali in un altro cloud. In questo caso d'uso, il deployment delle parti di elaborazione della logica di business e delle parti di analisi dell'applicazione viene eseguito su cloud diversi.
Dal punto di vista della gestione dei dati, i casi d'uso sono i seguenti:
- Dati partizionati. Ogni parte dell'applicazione ha il proprio database (partizione separata) e nessuno dei database è collegato direttamente agli altri. L'applicazione che gestisce i dati scrive due volte tutti i dati che devono essere disponibili in entrambi i database (partizioni).
- Database replicato in modo asincrono. Se i dati di un cloud devono essere disponibili nell'altro cloud, potrebbe essere appropriata una relazione di replica asincrona. Ad esempio, se un'applicazione di analisi richiede lo stesso set di dati o un sottoinsieme del set di dati per un'applicazione aziendale, quest'ultima può essere replicata tra i cloud.
- Database sincronizzato a livello transazionale. Questi tipi di database ti consentono di rendere i dati disponibili per entrambe le parti dell'applicazione. Ogni aggiornamento di ciascuna applicazione è coerente dal punto di vista delle transazioni e disponibile immediatamente per entrambi i database (partizioni). I database sincronizzati in modo transazionale agiscono di fatto come un unico database distribuito.
Servizi distribuiti
Il deployment e l'esecuzione di un servizio distribuito vengono eseguiti in due o più località di deployment. È possibile eseguire il deployment di tutte le istanze di servizio in tutte le località di deployment. In alternativa, è possibile eseguire il deployment di alcuni servizi in tutte le località e di altri solo in una delle località, in base a fattori quali la disponibilità dell'hardware o il carico limitato previsto.
I dati in un database sincronizzato in modo transazionale sono coerenti in tutte le località. Pertanto, un database di questo tipo è l'opzione migliore per eseguire il deployment delle istanze di servizio in tutte le località di deployment.
Quando utilizzi un database replicato in modo asincrono, esiste il rischio che lo stesso elemento dati venga modificato contemporaneamente in due località di deployment. Per determinare quale delle due modifiche in conflitto rappresenta lo stato finale coerente, è necessario implementare una strategia di risoluzione dei conflitti. Sebbene sia possibile implementare una strategia di risoluzione dei conflitti, non è sempre semplice e in alcuni casi è necessario un intervento manuale per ripristinare i dati in uno stato coerente.
Spostamento e failover dei servizi distribuiti
Se si verifica un errore in un'intera regione cloud, viene avviato il disaster recovery. Se un singolo servizio in un'applicazione di database stateful non funziona (non la regione o l'intera applicazione), il servizio deve essere recuperato e riavviato.
Un approccio iniziale al ripristino di emergenza consiste nel riavviare il servizio non riuscito nella posizione di deployment originale (un approccio di riavvio in loco). Tecnologie come Kubernetes riavviano automaticamente un servizio in base alla sua configurazione.
Tuttavia, se questo approccio di riavvio in loco non va a buon fine, un'alternativa è riavviare il servizio in una località secondaria. Il servizio esegue il failover dalla località principale a una località secondaria. Se l'applicazione viene distribuita come un insieme di servizi distribuiti, il failover di un singolo servizio può avvenire in modo dinamico.
Dal punto di vista del database, il riavvio del servizio nella posizione di deployment originale non richiede un deployment del database specifico. Quando un servizio viene spostato in una località di deployment alternativa e accede al database, si applicano gli stessi modelli di idoneità discussi in Servizi distribuiti in precedenza in questo documento.
Se un servizio viene trasferito temporaneamente e se per un'azienda sono accettabili latenze più elevate durante il trasferimento, il servizio potrebbe accedere al database tra le località di deployment. Anche se il servizio viene trasferito, continua ad accedere al database nello stesso modo in cui lo farebbe dalla posizione di deployment originale.
Deployment dipendente dal contesto
In generale, un singolo deployment di un'applicazione per gestire tutti i client dell'applicazione include tutti i servizi e i database dell'applicazione. Tuttavia, esistono casi d'uso eccezionali. Un singolo deployment dell'applicazione può gestire solo un sottoinsieme di client (in base a criteri specifici), il che significa che è necessario più di un deployment dell'applicazione. Ogni deployment gestisce un sottoinsieme diverso di client e tutti i deployment insieme gestiscono tutti i client.
Di seguito sono riportati alcuni esempi di casi d'uso per un deployment dipendente dal contesto:
- Quando esegui il deployment di un'applicazione multi-tenant per la quale viene eseguito il deployment di un'applicazione per tutti i tenant di piccole dimensioni, viene eseguito il deployment di un'altra applicazione per ogni 10 tenant di medie dimensioni e viene eseguito il deployment di un'applicazione per ogni tenant premium.
- Quando è necessario separare i clienti, ad esempio i clienti aziendali e quelli governativi.
- Quando è necessario separare gli ambienti di sviluppo, gestione temporanea e produzione.
Dal punto di vista del database, è possibile eseguire il deployment di un database per ogni deployment dell'applicazione in una strategia di deployment uno a uno. Come mostrato nel seguente diagramma, questa strategia è un approccio semplice in cui vengono creati dati partizionati perché ogni deployment ha il proprio set di dati.

Il diagramma precedente mostra quanto segue:
- Una configurazione con tre deployment di un'applicazione.
- Ogni set di dati ha il proprio database.
- Nessun dato viene condiviso tra i deployment.
In molte situazioni, un deployment uno a uno è la strategia più appropriata, ma esistono delle alternative.
Nel caso della multitenancy, i tenant potrebbero essere trasferiti. Un tenant di piccole dimensioni potrebbe diventare un tenant di medie dimensioni e dover essere trasferito in un'altra applicazione. In questo caso, i deployment di database separati richiedono la migrazione del database. Se viene eseguito il deployment di un database distribuito che viene utilizzato da tutti i deployment contemporaneamente, tutti i dati dei tenant risiedono in un unico sistema di database. Per questo motivo, lo spostamento di un tenant tra i database non richiede la migrazione del database. Il seguente diagramma mostra un esempio di questo tipo di database:

Il diagramma precedente mostra quanto segue:
- Tre deployment di un'applicazione.
- I deployment condividono tutti un unico database distribuito.
- Le applicazioni possono accedere a tutti i dati di ogni deployment.
- Non è stato implementato il partizionamento dei dati.
Se un'azienda sposta spesso i tenant nell'ambito delle operazioni del ciclo di vita, la replica del database potrebbe essere un'alternativa utile. In questo approccio, i dati del tenant vengono replicati tra i database prima di una migrazione del tenant. In questo caso, vengono utilizzati database indipendenti per i diversi deployment delle applicazioni, configurati per la replica solo immediatamente prima e durante la migrazione dei tenant. Il seguente diagramma mostra una replica temporanea tra due deployment di applicazioni durante una migrazione dei tenant.

Il diagramma precedente mostra tre deployment di un'applicazione con tre database separati che contengono i dati associati a ciascun deployment. Per eseguire la migrazione dei dati da un database a un altro, è possibile configurare la migrazione temporanea del database.
Portabilità delle applicazioni
La portabilità delle applicazioni garantisce che un'applicazione possa essere sottoposta a deployment in diverse località di deployment, in particolare in cloud diversi. Questa portabilità garantisce che un'applicazione possa essere migrata in qualsiasi momento, senza la necessità di reingegnerizzazione specifica per la migrazione o di sviluppo di applicazioni aggiuntive per prepararsi alla migrazione di un'applicazione.
Per garantire la portabilità delle applicazioni, puoi utilizzare uno dei seguenti approcci, descritti più avanti in questa sezione:
- Portabilità basata sul sistema
- Compatibilità API
- Portabilità basata sulla funzionalità
La portabilità basata sul sistema utilizza gli stessi componenti tecnici utilizzati in tutti i possibili deployment. Per garantire la portabilità basata sul sistema, ogni tecnologia deve essere disponibile in tutte le potenziali località di deployment. Ad esempio, se un database come PostgreSQL è un candidato, la sua disponibilità in tutte le potenziali località di deployment deve essere verificata per il periodo di tempo previsto. Lo stesso vale per tutte le altre tecnologie, ad esempio i linguaggi di programmazione e le tecnologie di infrastruttura. Come mostrato nel diagramma seguente, questo approccio stabilisce un insieme di funzionalità comuni in tutte le località di deployment in base alla tecnologia.

Il diagramma precedente mostra un deployment di un'applicazione portatile in cui l'applicazione prevede esattamente lo stesso sistema di database in ogni località in cui viene eseguito il deployment. Poiché in ogni località viene utilizzato lo stesso sistema di database, l'applicazione è portabile. L'applicazione può aspettarsi che venga utilizzato esattamente lo stesso sistema di database nel deployment. Pertanto, è possibile presupporre che l'interfaccia e il comportamento del sistema di database siano esattamente gli stessi.
Nel contesto dei database, nel sistema di compatibilità delle API, il client utilizza una libreria di accesso al database specifica (ad esempio, una libreria client MySQL) per assicurarsi di potersi connettere a qualsiasi implementazione conforme che potrebbe essere disponibile in un ambiente cloud. Il seguente diagramma illustra la compatibilità dell'API.
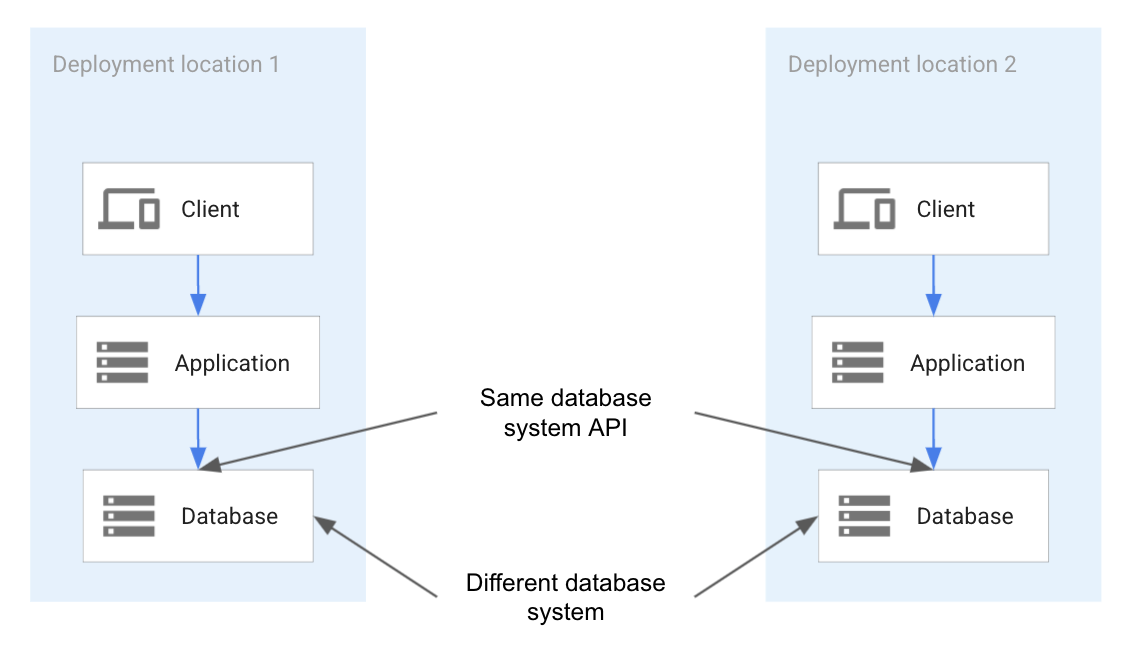
Il diagramma precedente mostra la portabilità delle applicazioni basata sull'API del sistema di database anziché sul sistema di database. Sebbene i sistemi di database possano essere diversi in ciascuna delle località, l'API è la stessa ed espone la stessa funzionalità. L'applicazione è portabile perché può assumere la stessa API in ogni località, anche se il sistema di database sottostante è una tecnologia di database diversa.
Nella portabilità basata sulla funzionalità, è possibile utilizzare tecnologie diverse in cloud diversi che forniscono la stessa funzionalità. Ad esempio, potrebbe essere possibile limitare l'utilizzo dei database al modello relazionale. Poiché qualsiasi sistema di database relazionale può supportare l'applicazione, è possibile utilizzare sistemi di database diversi su versioni diverse in cloud diversi senza influire sulla portabilità dell'applicazione. Uno svantaggio della portabilità basata sulla funzionalità è che può utilizzare solo le parti del modello di database supportate da tutti i sistemi di database relazionali. Anziché un sistema di database compatibile con tutti i cloud, è necessario utilizzare un modello di database. Il seguente diagramma mostra un'architettura di esempio per la portabilità basata sulla funzionalità.
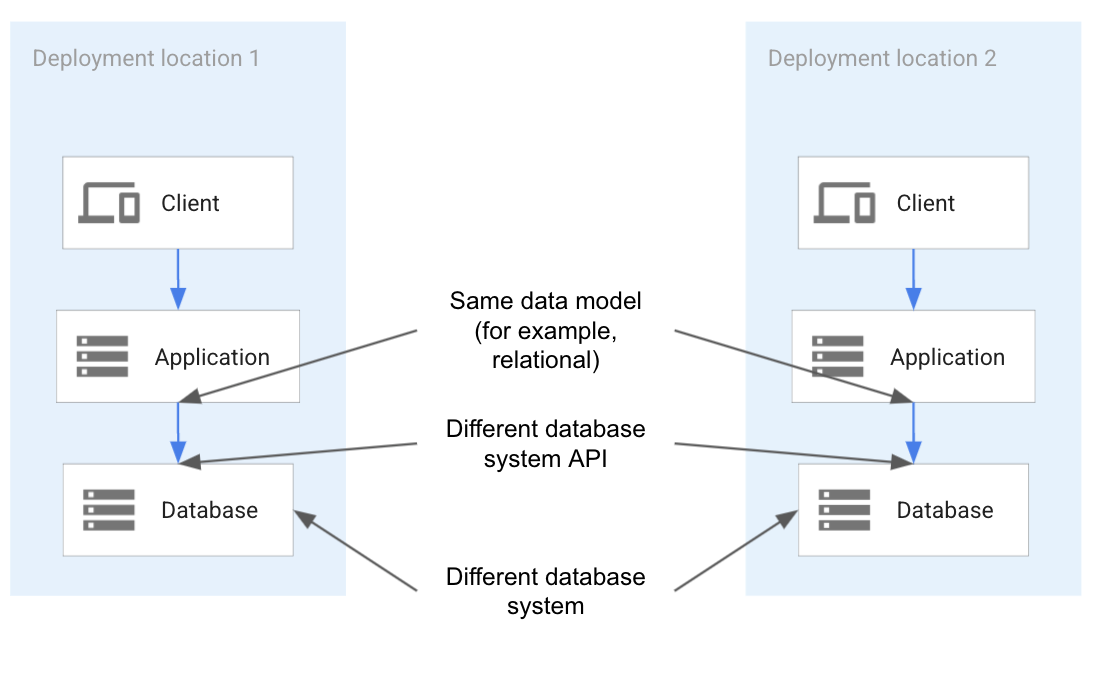
Come mostrato nel diagramma precedente, l'API del sistema di database e il sistema di database potrebbero essere diversi in ogni località. Per garantire la portabilità, l'applicazione deve utilizzare solo le parti di ogni sistema di database e di ogni API disponibili in ogni località. Poiché in genere in ogni località è disponibile solo un sottoinsieme di ogni sistema di database, l'applicazione deve limitare il proprio utilizzo a quel sottoinsieme.
Per garantire la portabilità di tutte le opzioni di questa sezione, l'architettura completa deve essere sottoposta a deployment continuo in tutte le località target. Tutti gli scenari di test delle unità e la verifica del sistema devono essere eseguiti su questi deployment. Si tratta di requisiti essenziali per rilevare e affrontare tempestivamente i cambiamenti nelle infrastrutture e nelle tecnologie.
Prevenzione della dipendenza dai fornitori
La prevenzione della dipendenza da un fornitore (lock-in) aiuta a mitigare il rischio di dipendenza da una tecnologia e un fornitore specifici. È apparentemente simile alla portabilità delle applicazioni. La prevenzione della dipendenza dai fornitori si applica a tutte le tecnologie utilizzate, non solo ai servizi cloud. Ad esempio, se MySQL viene utilizzato come sistema di database e installato su macchine virtuali nel cloud, non esiste alcuna dipendenza dal punto di vista del cloud, ma esiste una dipendenza da MySQL. Un'applicazione trasferibile tra cloud potrebbe comunque dipendere da tecnologie fornite da fornitori diversi dal cloud.
Per evitare la dipendenza dai fornitori, tutte le tecnologie devono essere sostituibili. Per questo motivo, è necessaria un'astrazione approfondita e strutturata di tutte le funzionalità dell'applicazione, in modo che ogni servizio dell'applicazione possa essere implementato nuovamente su una base tecnologica diversa senza influire sulla modalità di implementazione dell'applicazione. Dal punto di vista del database, questa astrazione può essere eseguita separando l'utilizzo di un modello di database da un particolare sistema di gestione di database.
Sistema di gestione di database di produzione esistente
Sebbene molte applicazioni multi-cloud siano sviluppate con sistemi di database come parte del loro design, molte aziende sviluppano applicazioni multi-cloud come parte del loro impegno di modernizzazione delle applicazioni. Queste applicazioni vengono sviluppate partendo dal presupposto che l'applicazione appena progettata e implementata acceda ai database esistenti.
Esistono molti motivi per non incorporare i database esistenti in un progetto di modernizzazione. Potrebbero essere in uso funzionalità specifiche non disponibili in altri sistemi di database. Un'azienda potrebbe avere database con processi di gestione complessi e consolidati, il che rende impraticabile o antieconomico il passaggio a un sistema diverso. In alternativa, un'azienda potrebbe scegliere di modernizzare un'applicazione nella prima fase e il database nella seconda fase.
Quando un'azienda utilizza un sistema di database esistente, il progettista dell'applicazione multicloud deve decidere se sarà l'unico database utilizzato o se è necessario aggiungere un sistema di database diverso per le diverse località di deployment. Ad esempio, se un database viene utilizzato on-premise e l'applicazione deve essere eseguita anche in Google Cloud, devono valutare se i servizi dell'applicazione di cui è stato eseguito il deployment su Google Cloud accedono al database on-premise. In alternativa, se un secondo database deve essere eseguito il deployment sia inGoogle Cloud sia per i servizi delle applicazioni in esecuzione localmente.
Se viene eseguito il deployment di un secondo database in Google Cloud, il caso d'uso potrebbe essere lo stesso di quelli discussi in Cloud bursting o Servizi distribuiti. In entrambi i casi, si applica la stessa discussione sul database di queste sezioni. Tuttavia, è limitata alla funzionalità tra località supportata dal database on-premise esistente, ad esempio la sincronizzazione e la replica.
Pattern di deployment
I casi d'uso discussi in questo documento sollevano una domanda comune dal punto di vista del database: se i database si trovano in più di una località di deployment, qual è la loro relazione?
I principali tipi di relazioni (pattern di deployment), discussi nella sezione successiva, sono i seguenti:
- Partizionato senza dipendenza tra database
- Replica asincrona unidirezionale
- Replica bidirezionale con risoluzione dei conflitti
- Sistema distribuito sincronizzato completamente attivo-attivo
È possibile mappare ogni caso d'uso in questo documento a uno o più dei quattro pattern di deployment.
Nella discussione seguente, si presume che i client accedano direttamente ai servizi dell'applicazione. A seconda del caso d'uso, potrebbe essere necessario un bilanciatore del carico per indirizzare dinamicamente l'accesso dei client alle applicazioni, come mostrato nel seguente diagramma.

Nel diagramma precedente, un bilanciatore del carico cloud indirizza le chiamate client a una delle località disponibili. Il bilanciatore del carico garantisce l'applicazione delle policy di bilanciamento del carico e l'indirizzamento dei client alla posizione corretta dell'applicazione e del relativo database.
Partizionato senza dipendenza tra database
Questo pattern di deployment è il più semplice di tutti quelli discussi in questo documento: ogni località o cloud ha un database e i database contengono set di dati partizionati che non dipendono l'uno dall'altro. Un elemento dati viene archiviato in un solo database. Ogni partizione di dati si trova nel proprio database. Un esempio di questo pattern è un'applicazione multi-tenant in cui un set di dati si trova in un database o nell'altro. Il seguente diagramma mostra due applicazioni completamente partizionate.

Come mostra il diagramma precedente, un'applicazione viene distribuita in due località, ciascuna responsabile di una partizione dell'intero set di dati. Ogni elemento dati si trova in una sola delle località, garantendo un set di dati partizionato senza alcuna replica tra le due.
Un pattern di deployment alternativo per i database partizionati è quello in cui il set di dati è completamente partizionato, ma comunque archiviato nello stesso database. Esiste un solo database contenente tutti i set di dati. Sebbene i set di dati siano archiviati nello stesso database, sono completamente separati (partizionati) e una modifica a uno non causa modifiche in un altro. Il seguente diagramma mostra due applicazioni che condividono un singolo database.

Il diagramma precedente mostra quanto segue:
- Due deployment di applicazioni che condividono un database comune, che si trova nella prima località.
- Ogni applicazione può accedere a tutti i dati nel deployment perché il set di dati non è partizionato.
Replica asincrona unidirezionale
Questo pattern di deployment ha un database primario che viene replicato in uno o più database secondari. Il database secondario può essere utilizzato per l'accesso in lettura, ma l'applicazione deve tenere conto del potenziale ritardo di replica. Un esempio di questo pattern è quando il database migliore per un determinato caso d'uso viene utilizzato come database primario e il database secondario viene utilizzato per l'analisi. Il seguente diagramma mostra due applicazioni che accedono a database replicati in modo unidirezionale.

Come mostra il diagramma precedente, uno dei due database è una replica dell'altro. La freccia nel diagramma indica la direzione della replica: i dati del sistema di database nella località 1 vengono replicati nel sistema di database nella località 2.
Replica bidirezionale con risoluzione dei conflitti
Questo pattern di deployment prevede due database primari che vengono replicati in modo asincrono l'uno nell'altro. Se gli stessi dati vengono scritti contemporaneamente in ogni database (ad esempio, la stessa chiave primaria), può verificarsi un conflitto di scrittura-scrittura. A causa di questo rischio, deve essere presente una risoluzione dei conflitti per determinare quale stato è l'ultimo durante la replica. Questo pattern può essere utilizzato in situazioni in cui la probabilità di un conflitto di scrittura-scrittura è rara. Il seguente diagramma mostra due applicazioni che accedono a database replicati in modo bidirezionale.

Come mostrato nel diagramma precedente, ogni database viene replicato nell'altro database. Le due repliche sono indipendenti l'una dall'altra, come indicato nel diagramma da due frecce blu separate. Poiché le due repliche sono indipendenti, può verificarsi un conflitto se per caso lo stesso elemento dati viene modificato da ciascuna delle applicazioni e replicato contemporaneamente. In questo caso, è necessario risolvere il conflitto.
Sistema distribuito sincronizzato completamente attivo-attivo
Questo pattern di deployment ha un singolo database con una configurazione attiva-attiva (anche principale-principale). In una configurazione attivo-attivo, un aggiornamento dei dati in qualsiasi database primario è coerente a livello transazionale e viene replicato in modo sincrono. Un esempio di caso d'uso per questo pattern è il computing distribuito. Il seguente diagramma mostra due applicazioni che accedono a un database primario-primario completamente sincronizzato.

Come mostra il diagramma precedente, questa disposizione garantisce che ogni applicazione acceda sempre all'ultimo stato coerente, senza ritardi o rischi di conflitto. Una modifica in un database è immediatamente disponibile nell'altro database. Qualsiasi modifica viene applicata a entrambi i database quando viene eseguito il commit di una transazione di modifica.
Categorizzazione dei sistemi di database
Non tutti i sistemi di gestione di database possono essere utilizzati con la stessa efficacia per i pattern di deployment discussi in questo documento. A seconda del caso d'uso, potrebbe essere possibile implementare un solo pattern di deployment o una combinazione di pattern di deployment con un solo sottoinsieme di sistemi di database.
Nella sezione seguente, i diversi sistemi di database sono classificati e mappati ai quattro pattern di deployment.
È possibile classificare i database in base a diverse dimensioni, come modello dei dati, architettura interna, modello di deployment e tipi di transazioni. Nella sezione seguente, ai fini della gestione dei database multi-cloud, vengono utilizzate due dimensioni:
- Architettura di deployment. L'architettura di come viene eseguito il deployment di un sistema di gestione di database sulle risorse dei cloud (ad esempio, motori di computing o gestiti dal cloud).
- Modello di distribuzione. Il modello di distribuzione supportato da un sistema di database (ad esempio, istanza singola o completamente distribuito).
Queste due dimensioni sono le più pertinenti nel contesto dei casi d'uso multi-cloud e possono supportare i quattro pattern di deployment derivati dai casi d'uso dei database multi-cloud. Una categorizzazione molto diffusa si basa sui modelli di dati supportati da un sistema di gestione di database. Alcuni sistemi supportano un solo modello (ad esempio, un modello grafico). Altri sistemi supportano più modelli di dati contemporaneamente (ad esempio, modelli relazionali e di documenti). Tuttavia, nel contesto della gestione di database multi-cloud, questa categorizzazione non è pertinente perché le applicazioni multi-cloud possono utilizzare qualsiasi modello di dati per il deployment multi-cloud.
Sistema di database per architettura di deployment
La gestione di database multicloud include le seguenti quattro classi principali di architettura di deployment per i sistemi di gestione di database:
- Database cloud integrati. I database cloud integrati sono progettati, creati e ottimizzati per funzionare con la tecnologia cloud. Ad esempio, alcuni sistemi di database utilizzano Kubernetes come piattaforma di implementazione e sfruttano le funzionalità di Kubernetes. CockroachDB e YugaByte sono esempi di questo tipo di database. Può essere eseguito il deployment in qualsiasi cloud che supporti Kubernetes.
- Database gestiti dal provider cloud. I database gestiti dal provider cloud sono basati su una tecnologia specifica del provider cloud e sono un servizio di database gestito da un provider cloud specifico. Spanner, Bigtable, Firestore e AlloyDB per PostgreSQL sono esempi di questo tipo di database. I database gestiti dal provider cloud sono disponibili solo nel cloud del provider cloud e non possono essere installati ed eseguiti altrove. Tuttavia, AlloyDB per PostgreSQL è completamente compatibile con PostgreSQL.
- Database pre-cloud. I database pre-cloud esistevano prima dello sviluppo della tecnologia cloud (a volte da molto tempo) e di solito vengono eseguiti su hardware bare metal e macchine virtuali (VM). PostgreSQL, MySQL e SQL Server sono esempi di questo tipo di database. Questi sistemi possono essere eseguiti su qualsiasi cloud che supporti le VM o l'hardware bare metal richiesti.
- Database gestiti dai partner Cloud. Alcuni cloud pubblici hanno partner di database che installano e gestiscono i database dei clienti nel cloud pubblico. Per questo motivo, i clienti non devono gestire questi database in autonomia. MongoDB Atlas, MariaDB e ScyllaDB sono esempi di questo tipo di database.
Esistono alcune varianti di queste categorie principali. Ad esempio, un fornitore di database che implementa un database creato per il cloud potrebbe anche fornire un'installazione su una tecnologia creata per il cloud e un'offerta gestita ai clienti nel proprio cloud fornito dal fornitore. Questo approccio equivale a un fornitore che offre un cloud pubblico che supporta solo il suo database come unico servizio.
I database pre-cloud potrebbero anche trovarsi in container ed essere idonei per il deployment in un cluster Kubernetes. Tuttavia, questi database non utilizzano funzionalità specifiche di Kubernetes come la scalabilità, il deployment multiservizio o multi-pod.
I fornitori di database potrebbero collaborare con più cloud provider pubblici contemporaneamente, offrendo il proprio database come database gestito da un partner cloud in più cloud pubblico.
Sistema di database per modello di distribuzione
I diversi sistemi di gestione di database vengono implementati in base ai modelli di distribuzione nell'architettura di un database. I modelli per i database sono i seguenti:
- Istanza singola. Una singola istanza di database viene eseguita su una VM o un container e funge da sistema centralizzato. Questo sistema gestisce tutti gli accessi al database. Poiché l'istanza singola non può essere connessa ad altre istanze, il sistema di database non supporta la replica.
- Multi-istanza attiva-passiva. In questa architettura comune, diverse istanze di database sono collegate tra loro. Il collegamento più comune è una relazione attiva-passiva in cui un'istanza è l'istanza di database attiva che supporta entrambe le istanze, le scritture e le letture. Uno o più sistemi passivi sono di sola lettura e ricevono tutte le modifiche al database dal database principale in modo sincrono o asincrono. I sistemi passivi possono fornire l'accesso in lettura. La modalità attiva-passiva è anche chiamata principale-secondaria o origine-replica.
- Multi-istanza attivo-attivo. In questa architettura relativamente insolita, ogni istanza è un'istanza attiva. In questo caso, ogni istanza può eseguire transazioni di lettura e scrittura e fornire la coerenza dei dati. Per questo motivo, per evitare incoerenze nei dati, tutte le istanze vengono sempre sincronizzate.
- Multi-istanza attiva-attiva con risoluzione dei conflitti. Anche questo è un impianto relativamente poco comune. Ogni istanza è disponibile per l'accesso in scrittura e lettura, ma i database sono sincronizzati in modalità asincrona. Sono consentiti aggiornamenti simultanei dello stesso elemento dati, il che porta a uno stato incoerente. Una policy di risoluzione dei conflitti deve decidere quale degli stati è l'ultimo stato coerente.
- Sharding multi-istanza. Lo sharding si basa sulla gestione di partizioni di dati (disgiunte). Ogni partizione è gestita da un'istanza di database separata. Questa distribuzione è scalabile perché è possibile aggiungere più shard dinamicamente nel tempo. Tuttavia, le query tra shard potrebbero non essere possibili perché questa funzionalità non è supportata da tutti i sistemi.
Tutti i modelli di distribuzione discussi in questa sezione possono supportare lo sharding e possono essere un sistema con sharding. Tuttavia, non tutti i sistemi sono progettati per fornire un'opzione di sharding. Lo sharding è un concetto di scalabilità e in genere non è rilevante per la selezione del database architetturale in ambienti multi-cloud.
I modelli di distribuzione sono diversi per i database gestiti nel cloud e dai partner. Poiché questi database sono legati all'architettura di un cloud provider, questi sistemi implementano architetture basate sulle seguenti località di deployment:
- Sistema a zone. Un sistema di database gestito a livello di zona è associato a una zona. Quando la zona è disponibile, lo è anche il sistema di database. Tuttavia, se la zona non è più disponibile, non è possibile accedere al database.
- Sistema regionale. Un database gestito a livello di regione è associato a una regione ed è accessibile quando è accessibile almeno una zona. Qualsiasi combinazione di zone può diventare inaccessibile.
- Sistema interregionale. Un sistema interregionale è legato a due o più regioni e funziona correttamente quando è disponibile almeno una regione.
Un sistema interregionale può anche supportare un sistema cross-cloud se il database può essere installato in tutti i cloud che un'azienda intende utilizzare.
Esistono altre possibili alternative alle architetture di database gestiti descritte in questa sezione. Un sistema a livello di regione potrebbe condividere un disco tra due zone. Se una delle due zone diventa inaccessibile, il sistema di database può continuare a funzionare nella zona rimanente. Tuttavia, se un'interruzione interessa entrambe le zone, il sistema di database non è disponibile anche se altre zone potrebbero essere ancora completamente online.
Mappatura dei sistemi di database ai pattern di deployment
La tabella seguente descrive la relazione tra i pattern di deployment e le architetture di deployment discussi in questo documento. I campi indicano le condizioni necessarie affinché una combinazione sia possibile, in base al pattern di deployment e all'architettura di deployment.
| Architettura di deployment | Pattern di deployment | ||||
|---|---|---|---|---|---|
| Partizionato senza dipendenza tra database | Replica asincrona unidirezionale | Replica bidirezionale con risoluzione dei conflitti | Sistema distribuito sincronizzato completamente attivo-attivo | ||
| Database cloud integrati | Possibile per tutti i cloud che forniscono la tecnologia cloud integrata utilizzata dai sistemi di database.
Se lo stesso database non è disponibile, è possibile utilizzare sistemi di database diversi. |
Database cloud che fornisce la replica. | Database cloud che fornisce la replica bidirezionale. | Database cloud che fornisce la sincronizzazione principale-principale. | |
| Database gestiti dal provider cloud | I sistemi di database possono essere diversi in cloud diversi. | La replica non deve essere il database gestito dal provider cloud (consulta Il ruolo della tecnologia di migrazione dei database nei pattern di deployment). | Solo all'interno di un cloud, non tra cloud, se il database fornisce la replica bidirezionale. | Solo all'interno di un cloud, non tra cloud, se il database fornisce la sincronizzazione principale-principale. | |
| Database pre-cloud | I sistemi di database possono essere uguali o diversi in cloud diversi. | La replica è possibile in diversi cloud. | Il sistema di database fornisce la replica bidirezionale e la risoluzione dei conflitti. | Il sistema di database fornisce la sincronizzazione principale-principale. | |
| Database gestiti dai partner cloud | I sistemi di database possono essere diversi in cloud diversi.
Se il fornitore partner fornisce un sistema di database gestito in tutti i cloud richiesti, è possibile utilizzare lo stesso database. |
La replica non deve necessariamente essere il database gestito dal provider cloud. Se il fornitore partner fornisce un sistema di database gestito in tutti i cloud richiesti, è possibile utilizzare lo stesso database. |
Il sistema di database fornisce la replica bidirezionale e la risoluzione dei conflitti. | Il sistema di database fornisce la sincronizzazione principale-principale. | |
Se un sistema di database non fornisce la replica integrata, potrebbe essere possibile utilizzare la tecnologia di replica del database. Per saperne di più, consulta Il ruolo della tecnologia di migrazione dei database nei pattern di deployment.
La tabella seguente mette in relazione i pattern di deployment con i modelli di distribuzione. I campi indicano le condizioni per cui la combinazione è possibile in base a un pattern di deployment e a un modello di distribuzione.
| Modello di distribuzione | Pattern di deployment | ||||
|---|---|---|---|---|---|
| Partizionato senza dipendenza tra database | Replica asincrona unidirezionale | Replica bidirezionale con risoluzione dei conflitti | Sistema distribuito sincronizzato completamente attivo-attivo | ||
| Istanza singola | Possibile con lo stesso sistema di database o con un sistema di database diverso nei cloud coinvolti. | Non applicabile | Non applicabile | Non applicabile | |
| Attiva/passiva multi-istanza | Possibile con lo stesso sistema di database o con un sistema di database diverso nei cloud coinvolti. | La replica è possibile tra cloud. | La replica è possibile tra cloud. | Non applicabile | |
| Multi-istanza attivo-attivo | Possibile con lo stesso sistema di database o con un sistema di database diverso nei cloud coinvolti. | Non applicabile | Non applicabile | La sincronizzazione è possibile tra i cloud. | |
| Multi-istanza attivo-attivo con risoluzione dei conflitti | Possibile con lo stesso sistema di database o con un sistema di database diverso nei cloud coinvolti. | Non applicabile | Non applicabile | Applicabile se è possibile la replica bidirezionale tra cloud. | |
Alcune implementazioni di modelli di distribuzione che aggiungono un'astrazione aggiuntiva basata sulla tecnologia del database sottostante non hanno un modello di distribuzione integrato, ad esempio Postgres-BDR, un sistema attivo-attivo. Questi sistemi sono inclusi nella tabella precedente nella rispettiva categoria. Da una prospettiva multi-cloud, non è importante come viene implementato un modello di distribuzione.
Migrazione e replica dei database
A seconda del caso d'uso, un'azienda potrebbe dover eseguire la migrazione di un database da una località di deployment a un'altra. In alternativa, per l'elaborazione downstream, potrebbe essere necessario replicare i dati di un database in un'altra località. Nella sezione seguente, la migrazione e la replica del database vengono descritte in maggiore dettaglio.
Migrazione del database
La migrazione del database viene utilizzata quando un database viene spostato da una località di deployment a un'altra. Ad esempio, viene eseguita la migrazione di un database in esecuzione in un data center on-premise per l'esecuzione nel cloud. Al termine della migrazione, il database viene arrestato nel data center on-premise.
I principali approcci alla migrazione dei database sono i seguenti:
- Lift and shift. La VM e i dischi che eseguono le istanze del database vengono copiati nell'ambiente di destinazione così come sono. Una volta copiate, vengono avviate e la migrazione è completata.
- Esportazione e importazione e backup e ripristino. Entrambi questi approcci utilizzano la funzionalità del sistema di database per esternalizzare un database e ricrearlo nella località di destinazione. L'esportazione/importazione si basa solitamente su un formato ASCII, mentre il backup e il ripristino si basano su un formato binario.
- Migrazione senza tempi di inattività. In questo approccio, viene eseguita la migrazione di un database mentre i sistemi dell'applicazione accedono al sistema di origine. Dopo un caricamento iniziale, le modifiche vengono trasmesse dal database di origine a quello di destinazione utilizzando tecnologie di Change Data Capture (CDC). L'applicazione subisce un tempo di inattività dal momento in cui viene arrestata nel sistema di database di origine fino al momento in cui viene riavviata nel sistema di database di destinazione al termine della migrazione.
La migrazione del database diventa rilevante nei casi d'uso multicloud quando un database viene spostato da un cloud all'altro o da un tipo di motore del database a un altro.
La migrazione di un database è un processo sfaccettato. Per saperne di più, consulta Migrazione del database: concetti e principi (parte 1) e Migrazione del database: concetti e principi (parte 2).
Per eseguire la migrazione del database, puoi utilizzare le tecnologie di database integrate, ad esempio l'esportazione e l'importazione, il backup e il ripristino o i protocolli di replica integrati. Quando il sistema di origine e quello di destinazione sono sistemi di database diversi, le tecnologie di migrazione sono l'opzione migliore per la migrazione del database. Database Migration Service, Striim e Debezium sono esempi di tecnologie di migrazione dei database.
Replica dei database
La replica del database è simile alla migrazione del database. Tuttavia, durante la replica del database, il sistema del database di origine rimane invariato, mentre ogni modifica viene trasmessa al database di destinazione.
La replica del database è un processo continuo che invia le modifiche dal database di origine al database di destinazione. Quando questo processo è asincrono, le modifiche arrivano al database di destinazione dopo un breve ritardo. Se il processo è sincrono, le modifiche al sistema di origine vengono apportate al sistema di destinazione contemporaneamente e alle stesse transazioni.
Oltre a replicare un database di origine in un database di destinazione, una pratica comune è replicare i dati da un database di origine a un sistema di analisi di destinazione.
Come per la migrazione del database, se sono disponibili protocolli di replica, è possibile utilizzare la tecnologia del database integrata per la replica del database. Se non esistono protocolli di replica integrati, è possibile utilizzare una tecnologia di replica come Datastream, Striim o Debezium.
Il ruolo della tecnologia di migrazione dei database nei pattern di deployment
La tecnologia di database integrata per abilitare la replica non è generalmente disponibile quando vengono utilizzati sistemi di database diversi nei pattern di deployment, ad esempio la replica asincrona (eterogenea). Invece, è possibile implementare la tecnologia di migrazione dei database per abilitare questo tipo di replica. Alcuni di questi sistemi di migrazione implementano anche la replica bidirezionale.
Se la tecnologia di migrazione o replica del database è disponibile per i sistemi di database utilizzati nelle combinazioni contrassegnate come "Non applicabile" nella Tabella 1 o nella Tabella 2 in Mappatura dei sistemi di database ai pattern di deployment, potrebbe essere possibile utilizzarla per la replica del database. Il seguente diagramma mostra un approccio per la replica del database utilizzando una tecnologia di migrazione.

Nel diagramma precedente, il database nella località 1 viene replicato nel database nella località 2. Anziché una replica diretta del sistema di database, viene eseguito il deployment di un server di migrazione per implementare la replica. Questo approccio viene utilizzato per i sistemi di database che non dispongono di funzionalità di replica del database integrate nella loro implementazione e che devono fare affidamento su un sistema separato dal sistema di database per implementare la replica.
Selezione del database multi-cloud
I casi d'uso dei database multi-cloud, combinati con la categorizzazione dei sistemi di database, ti aiutano a decidere quali database sono più adatti per un determinato caso d'uso. Ad esempio, per implementare il caso d'uso in Portabilità delle applicazioni, esistono due opzioni. La prima opzione è assicurarsi che lo stesso motore del database sia disponibile in tutti i cloud. Questo approccio garantisce la portabilità del sistema. La seconda opzione è garantire che lo stesso modello dei dati e la stessa interfaccia di query siano disponibili per tutti i cloud. Sebbene i sistemi di database possano essere diversi, la portabilità è fornita su un'interfaccia funzionale.
Gli alberi decisionali nelle sezioni seguenti mostrano i criteri decisionali per i casi d'uso dei database multi-cloud in questo documento. Gli alberi decisionali suggeriscono il database migliore da considerare per ogni caso d'uso.
Best practice per il sistema di database esistente
Se un sistema di database è in produzione, è necessario decidere se mantenerlo o sostituirlo. Il seguente diagramma mostra le domande da porsi nel processo decisionale:

Le domande e le risposte nell'albero decisionale sono le seguenti:
- È un sistema di database in produzione?
- Se non è presente alcun sistema di database in produzione, seleziona un sistema di database (vai alla sezione Decisione sulla gestione di database multicloud).
- Se un sistema di database è in produzione, valuta se deve essere conservato.
- Se un sistema di database è in produzione, valuta se deve essere conservato.
- Se il sistema di database deve essere conservato, la decisione viene presa e il processo decisionale è completo.
- Se il sistema di database deve essere modificato o se la decisione è ancora in fase di elaborazione, seleziona un sistema di database (vai alla sezione Decisione sulla gestione di database multicloud).
Decisione sulla gestione di database multi-cloud
Il seguente albero decisionale è relativo a un caso d'uso con un requisito di database in più località (incluso un deployment di database multi-cloud). Utilizza il pattern di deployment come base per i criteri decisionali.

Le domande e le risposte nell'albero decisionale sono le seguenti:
- I dati sono partizionati in database diversi senza alcuna dipendenza tra database?
- In caso affermativo, è possibile selezionare sistemi di database uguali o diversi per ogni località.
- In caso contrario, vai alla domanda successiva.
- È richiesta la replica asincrona unidirezionale?
- In caso affermativo, valuta se un sistema di replica del database è accettabile.
- In caso affermativo, seleziona sistemi di database uguali o diversi compatibili con il sistema di replica.
- In caso contrario, seleziona un sistema di database in grado di implementare un modello di distribuzione attivo-passivo.
- In caso contrario, vai alla domanda successiva.
- In caso affermativo, valuta se un sistema di replica del database è accettabile.
- Seleziona un sistema di database con istanze sincronizzate.
- La risoluzione dei conflitti è accettabile?
- In caso affermativo, seleziona un sistema di database con replica bidirezionale o un sistema di database attivo-attivo.
- In caso contrario, seleziona un sistema attivo-attivo.
- La risoluzione dei conflitti è accettabile?
Se viene implementato più di un caso d'uso multi-cloud, un'azienda deve decidere se utilizzare un unico sistema di database per supportare tutti i casi d'uso o più sistemi di database.
Se un'azienda vuole utilizzare un unico sistema di database per supportare tutti i casi d'uso, il sistema con la migliore sincronizzazione è la scelta migliore. Ad esempio, se sono necessarie sia la replica unidirezionale sia le istanze sincronizzate, la scelta migliore sono le istanze sincronizzate.
La gerarchia della qualità della sincronizzazione è (da nessuna alla migliore): partizionata, replica unidirezionale, replica bidirezionale e replica completamente sincronizzata.
Best practice per il deployment
Questa sezione evidenzia le best practice da seguire quando scegli un database per la migrazione o lo sviluppo di applicazioni multi-cloud.
Sistema di gestione di database esistente
Può essere una buona pratica conservare un database e non apportare modifiche al sistema di database, a meno che non sia richiesto da un caso d'uso specifico. Per un'azienda con un sistema di gestione di database consolidato e con processi di sviluppo, operativi e di manutenzione efficaci, potrebbe essere meglio evitare di apportare modifiche.
Un caso d'uso di cloud bursting che non richiede un sistema di database nel cloud potrebbe non richiedere una modifica del database. Un altro caso d'uso è la replica asincrona in una località di deployment diversa all'interno dello stesso cloud o in un altro cloud. Per questi casi d'uso, un buon approccio è implementare un benchmark e verificare che la comunicazione tra località e la latenza tra località soddisfino i requisiti dell'applicazione durante l'accesso al database.
Sistema di database come servizio Kubernetes
Se un'azienda sta valutando la possibilità di eseguire un sistema di database all'interno di Kubernetes come servizio basato su StatefulSets, è necessario considerare i seguenti fattori:
- Se il database fornisce il modello di database richiesto dall'applicazione.
- Fattori non funzionali che determinano il modo in cui l'operatività viene implementata in un sistema di database come servizio Kubernetes, ad esempio come viene eseguito lo scale up e lo scale down, come vengono gestiti il backup e il ripristino e come il monitoraggio viene reso disponibile dal sistema. Per comprendere i requisiti di un sistema di database basato su Kubernetes, le aziende dovrebbero utilizzare le loro esperienze con i database come punto di confronto.
- Alta affidabilità e ripristino di emergenza. Per fornire un'alta affidabilità, il sistema deve continuare a funzionare quando si verifica un errore in una zona all'interno di una regione. Il database deve essere in grado di eseguire rapidamente il failover da una zona all'altra. Nello scenario migliore, il database ha un'istanza in esecuzione in ogni zona completamente sincronizzata per un RTO e un RPO pari a zero.
- Disaster recovery per risolvere l'errore di una regione (o di un cloud). In uno scenario ideale, il database continua a funzionare in una seconda regione con un RPO e un RTO pari a zero. In uno scenario meno ideale, il database nella regione secondaria potrebbe non essere completamente aggiornato su tutte le transazioni del database primario.
Per determinare il modo migliore per eseguire un database all'interno di Kubernetes, un buon approccio è una valutazione completa del database, soprattutto quando il sistema deve essere paragonabile a un sistema in produzione esterno a Kubernetes.
Sistema di database indipendente da Kubernetes
Non è sempre necessario che un'applicazione implementata come servizi in Kubernetes abbia il database in esecuzione in Kubernetes contemporaneamente. Esistono molti motivi per cui un sistema di database deve essere eseguito al di fuori di Kubernetes, ad esempio processi consolidati, conoscenza del prodotto all'interno di un'azienda o indisponibilità. In questa categoria rientrano sia i database gestiti dai provider cloud sia quelli gestiti dai partner cloud.
È altrettanto possibile e fattibile eseguire un database su Compute Engine. Quando selezioni un sistema di database, è buona norma eseguire una valutazione completa del database per assicurarti che tutti i requisiti di un'applicazione siano soddisfatti.
Dal punto di vista della progettazione delle applicazioni, il connection pooling è un'importante considerazione di progettazione. Un servizio di applicazione che accede a un database potrebbe utilizzare un pool di connessioni internamente. L'utilizzo di un pool di connessioni è utile per l'efficienza e la riduzione della latenza. Le richieste vengono invece prelevate dal pool senza che sia necessario avviarle e non è necessario attendere la creazione delle connessioni. Se l'applicazione viene sottoposta a scale up aggiungendo istanze di servizio dell'applicazione, ogni istanza crea un pool di connessioni. Se vengono seguite le best practice, ogni pool pre-crea un insieme minimo di connessioni. Ogni volta che viene creata un'altra istanza di servizio dell'applicazione per la scalabilità dell'applicazione, vengono aggiunte connessioni al database. Dal punto di vista della progettazione, poiché i database non possono supportare connessioni illimitate, l'aggiunta di connessioni deve essere gestita per evitare il sovraccarico.
Miglior sistema di database rispetto alla portabilità del sistema di database
Quando selezionano i sistemi di database, è comune per le aziende scegliere il sistema di database migliore per soddisfare i requisiti di un'applicazione. In un ambiente multi-cloud, è possibile selezionare il database migliore in ogni cloud e collegarli tra loro in base al caso d'uso. Se questi sistemi sono diversi, qualsiasi replica, unidirezionale o bidirezionale, richiede un impegno significativo. Questo approccio potrebbe essere giustificato se il vantaggio di utilizzare il sistema migliore supera lo sforzo richiesto per implementarlo.
Tuttavia, una buona pratica consiste nel considerare e valutare contemporaneamente un approccio per un sistema di database disponibile in tutti i cloud richiesti. Anche se un database di questo tipo potrebbe non essere l'opzione migliore, potrebbe essere molto più semplice implementare, gestire e mantenere un sistema di questo tipo.
Una valutazione simultanea dei sistemi di database dimostra i vantaggi e gli svantaggi di entrambi i sistemi di database, fornendo una base solida per la selezione.
Replica del sistema di database integrata ed esterna
Per i casi d'uso che richiedono un sistema di database in tutte le località di deployment (zone, regioni o cloud), la replica è una funzionalità importante. La replica può essere asincrona, bidirezionale o completamente sincronizzata in modalità attiva-attiva. Non tutti i sistemi di database supportano tutte queste forme di replica.
Per i sistemi che non supportano la replica come parte della loro implementazione, è possibile utilizzare sistemi come Striim per integrare l'architettura (come descritto in Migrazione del database).
Una best practice consiste nel valutare sistemi di gestione di database alternativi per determinare i vantaggi e gli svantaggi di un sistema con replica integrata o di un sistema che richiede una tecnologia di replica.
Anche una terza classe di tecnologia svolge un ruolo in questo caso. Questa classe fornisce componenti aggiuntivi ai sistemi di database esistenti per fornire la replica. Un esempio è MariaDB Galera Cluster. Se il processo di valutazione lo consente, valutare questi sistemi è una buona pratica.
Database multi-modello
I database multi-modello forniscono una gestione dei dati flessibile e scalabile nel cloud e nelle applicazioni in tempo reale. I database multi-modello supportano più modelli di dati, come documenti, grafici, coppie chiave-valore, famiglie di colonne e relazionali, in un'interfaccia di query e un motore di archiviazione unificati. Queste funzionalità offrono vantaggi come:
- Gestione semplificata: gli sviluppatori gestiscono vari tipi di dati all'interno di un unico sistema di database, il che contribuisce a ridurre la complessità operativa e l'overhead.
- Sviluppo più rapido: i database multi-modello offrono la flessibilità di utilizzare il modello dei dati ottimale per esigenze diverse. Questa flessibilità può accelerare lo sviluppo e aiutarti ad adattarti più rapidamente ai requisiti in evoluzione.
- Integrazione più semplice: un'interfaccia di query e un motore di archiviazione unificati riducono al minimo la complessità della connessione e della sincronizzazione di database diversi.
- Query avanzate: gli sviluppatori possono eseguire query e combinare i dati di diversi modelli, ottenendo insight più completi e funzionalità delle applicazioni più sofisticate.
- Risparmio sui costi: un numero inferiore di sistemi di database si traduce in costi inferiori per licenze, hardware e spese operative.
- Prestazioni ottimizzate: scegliendo il modello dei dati più adatto per attività specifiche, puoi potenzialmente migliorare le prestazioni dell'applicazione.
Ad esempio, Spanner offre funzionalità multi-modello con il supporto del dialetto PostgreSQL. Questa funzionalità ti consente di creare app intelligenti basate sull'AI utilizzando dati relazionali e NoSQL, eseguire query su relazioni complesse con Spanner Graph e utilizzare Vector Search per la ricerca semantica.
Passaggi successivi
- Scopri di più sui pattern di architettura ibrida e multi-cloud.
- Scopri i pattern per connettere altri provider di servizi cloud a Google Cloud.
- Scopri di più sulle architetture di monitoraggio e logging per deployment ibridi e multi-cloud su Google Cloud.
- Per ulteriori architetture di riferimento, diagrammi e best practice, esplora Cloud Architecture Center.
Collaboratori
Autore: Alex Cârciu | Solutions Architect