


Présentation de la préparation de données BigQuery
Vous pouvez réduire considérablement le temps et les efforts nécessaires aux tâches manuelles de traitement des données en utilisant la préparation de données augmentée par l'IA dans BigQuery. La préparation des données utilise Gemini dans BigQuery pour analyser vos données et fournir des suggestions intelligentes pour les nettoyer, les transformer et les enrichir. Dataform planifie ces préparations de données.
Avantages
- Vous pouvez réduire le temps consacré au développement de pipelines de données grâce aux suggestions de transformation générées par Gemini et adaptées au contexte.
- Vous pouvez valider les résultats générés dans un aperçu et recevoir des suggestions de nettoyage et d'enrichissement de la qualité des données avec un mappage de schéma automatisé.
- Dataform vous permet d'utiliser un processus d'intégration continue et de développement continu (CI/CD), qui favorise la collaboration entre les équipes pour les revues de code et le contrôle de la source.
Points d'entrée de la préparation des données
Vous pouvez créer et gérer des préparations de données sur la page BigQuery Studio (voir Démarrer une session de préparation de données).
Lorsque vous ouvrez une table dans la préparation des données BigQuery, un job BigQuery s'exécute à l'aide de vos identifiants. L'exécution crée des exemples de lignes à partir de la table choisie et écrit les résultats dans une table temporaire du même projet. Gemini utilise les données échantillonnées et le schéma pour générer des suggestions de préparation des données affichées dans l'éditeur de préparation des données.
Vues dans l'éditeur de préparation des données
Les préparations de données s'affichent sous forme d'onglets sur la page BigQuery. Chaque onglet comporte une série de sous-onglets, ou vues de préparation des données, dans lesquels vous développez et gérez vos préparations de données.
mode Données
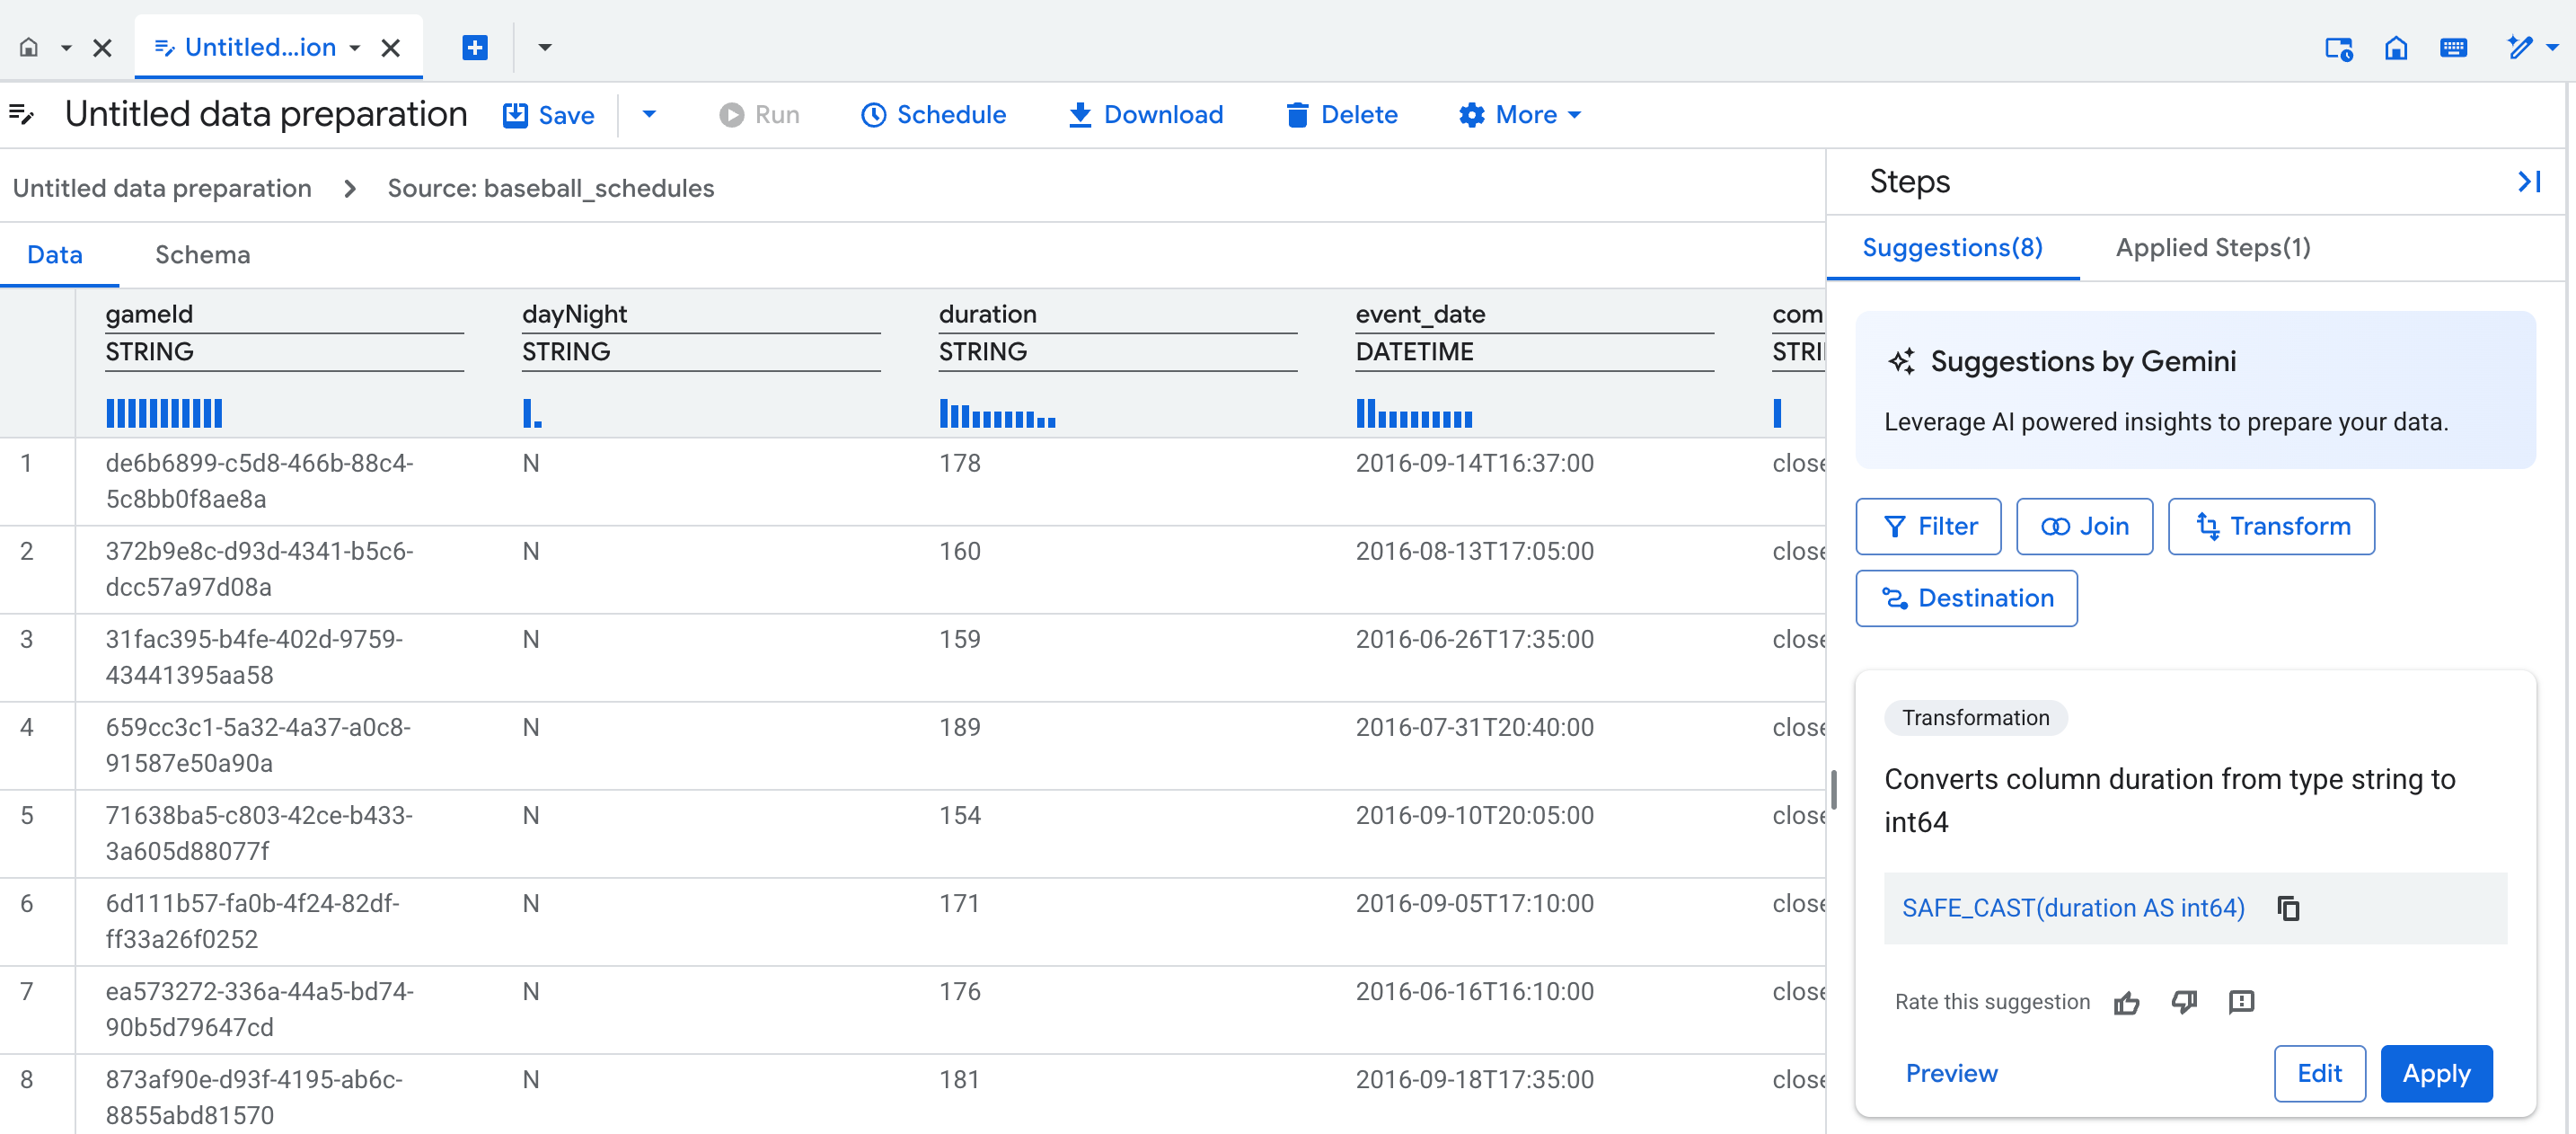
Lorsque vous créez une préparation de données, un onglet d'éditeur de préparation de données s'ouvre et affiche la vue des données, qui contient un échantillon représentatif de la table. Pour les préparations de données existantes, vous pouvez accéder à la vue des données en cliquant sur un nœud dans la vue graphique de votre pipeline de préparation de données.
La vue des données vous permet d'effectuer les opérations suivantes :
- Interagissez avec vos données pour créer des étapes de préparation des données.
- Appliquez les suggestions de Gemini.
- Améliorez la qualité des suggestions de Gemini en saisissant des exemples de valeurs dans les cellules.
Au-dessus de chaque colonne de votre table, un profil statistique (un histogramme) indique le nombre d'occurrences des valeurs les plus fréquentes de chaque colonne dans les lignes d'aperçu.
Vue Graphique
La vue graphique est un aperçu visuel de votre préparation de données. Il s'affiche sous la forme d'un onglet sur la page BigQuery de la console lorsque vous ouvrez une préparation de données. Le graphique affiche des nœuds pour toutes les étapes de votre pipeline de préparation des données. Vous pouvez sélectionner un nœud sur le graphique pour configurer les étapes de préparation des données qu'il représente.

Vue Schéma
La vue du schéma de préparation des données affiche le schéma actuel de l'étape de préparation des données active. Le schéma affiché correspond aux colonnes de la vue de données.
Dans la vue du schéma, vous pouvez effectuer des opérations de schéma dédiées, telles que la suppression de colonnes, qui crée également des étapes dans la liste Étapes appliquées.

Suggestions de Gemini
Gemini fournit des suggestions contextuelles pour vous aider à effectuer les tâches de préparation des données suivantes :
- Appliquer des transformations et des règles de qualité des données
- Standardiser et enrichir les données
- Automatiser le mappage de schéma
Chaque suggestion apparaît dans une fiche de la liste des suggestions de l'éditeur de préparation des données. La fiche contient les informations suivantes :
- Catégorie de haut niveau de l'étape, telle que Conserver les lignes ou Transformation
- Description de l'étape, par exemple Conserver les lignes si
COLUMN_NAMEn'est pasNULL - Expression SQL correspondante utilisée pour exécuter l'étape
Vous pouvez prévisualiser, modifier ou appliquer la fiche de suggestion, ou affiner la suggestion. Vous pouvez également ajouter des étapes manuellement. Pour en savoir plus, consultez Préparer des données avec Gemini.
Pour affiner les suggestions de Gemini, donnez-lui un exemple de ce qu'il doit modifier dans une colonne.
Échantillonnage de données
BigQuery utilise l'échantillonnage de données pour fournir un aperçu de votre préparation de données. Vous pouvez afficher l'échantillon dans la vue des données de chaque nœud.
Lorsque vous ajoutez des tables BigQuery standards en tant que source, les données sont préparées à l'aide d'une fonction BigQuery TABLESAMPLE. Cette fonction crée un échantillon de 10 000 enregistrements.
Lorsque vous ajoutez une vue ou une table externe en tant que source, le système lit le premier million d'enregistrements. À partir de ces enregistrements, le système sélectionne un échantillon représentatif de 10 000 enregistrements.
Les données de l'échantillon ne sont pas actualisées automatiquement. Les exemples de tables sont stockés en tant que résultats de requêtes mis en cache et expirent au bout d'environ 24 heures. Pour actualiser manuellement l'exemple de table, consultez Actualiser les exemples de préparation de données.
Mode d'écriture
Pour optimiser les coûts et le temps de traitement, vous pouvez modifier les paramètres du mode d'écriture afin de traiter de manière incrémentielle les nouvelles données de la source. Par exemple, si vous disposez d'une table dans BigQuery où des enregistrements sont insérés quotidiennement et d'un tableau de bord Looker qui doit refléter les données modifiées, vous pouvez planifier la préparation des données BigQuery pour lire de manière incrémentielle les nouveaux enregistrements de la table source et les propager vers la table de destination.
Pour configurer la façon dont votre préparation de données est écrite dans une table de destination, consultez Optimiser la préparation des données en les traitant de manière incrémentielle.
Les modes d'écriture suivants sont acceptés :
| Option de mode d'écriture | Description |
|---|---|
| Actualisation complète | Effectue les étapes de préparation des données sur toutes les données sources, puis recrée entièrement la table de destination. La table est recréée, et non tronquée. L'actualisation complète est le mode par défaut lors de l'écriture dans une table de destination. |
| Ajouter | Insère toutes les données de la préparation des données sous forme de lignes supplémentaires dans la table de destination. |
| Incrémentielle | Insère uniquement les données nouvelles ou, selon votre choix de colonne incrémentielle, modifiées dans la table de destination. En fonction de votre choix de colonne incrémentielle, la préparation des données sélectionne le mécanisme de détection des enregistrements de modification optimal. Il sélectionne les valeurs maximales pour les types de données numériques et de date/heure, et "Unique" pour les données catégorielles. "Maximum" n'insère que les enregistrements dont la valeur de la colonne spécifiée est supérieure à la valeur maximale de cette même colonne dans la table de destination. "Unique" n'insère que les enregistrements dont les valeurs de colonne spécifiées ne sont pas présentes dans les valeurs existantes de la même colonne dans la table de destination. |
| Faire un upsert | Fusionne les lignes à l'aide des clés de fusion spécifiées. Lorsqu'une ligne existante de la table de destination correspond aux clés de fusion spécifiées pour un enregistrement d'entrée, les valeurs de cette ligne sont mises à jour dans la table de destination. Sinon, une nouvelle ligne est insérée dans la table de destination. |
Étapes de préparation des données compatibles
BigQuery accepte les types d'étapes de préparation de données suivants :
| Type d'étape | Description |
|---|---|
| Source | Ajoute une source lorsque vous sélectionnez une table BigQuery à partir de laquelle lire ou lorsque vous ajoutez une étape de jointure. |
| Transformation | Nettoie et transforme les données à l'aide d'une expression SQL. Vous recevez des fiches de suggestion pour les expressions suivantes :
Vous pouvez également utiliser n'importe quelle expression SQL BigQuery valide dans les étapes de transformation manuelle. Par exemple :
Pour en savoir plus, consultez Ajouter une transformation. |
| Filtre | Supprime des lignes via la syntaxe de la clause WHERE. Lorsque vous ajoutez une étape de filtrage, vous pouvez choisir d'en faire une étape de validation.
Pour en savoir plus, consultez Filtrer les lignes. |
| Deduplicate | Supprime les lignes en double des données en fonction des clés et de l'ordre sélectionnés.
Pour en savoir plus, consultez Dédupliquer des données. |
| Validation | Envoie les lignes qui ne répondent pas aux critères de la règle de validation vers une table d'erreurs. Si les données ne respectent pas la règle de validation et qu'aucune table d'erreurs n'est configurée, la préparation des données échoue lors de l'exécution.
Pour en savoir plus, consultez Configurer la table d'erreurs et ajouter une règle de validation. |
| Rejoindre | Joint les valeurs de deux sources. Les tables doivent se trouver au même emplacement.
Les colonnes de clé de jointure doivent être du même type de données. Les préparations de données sont compatibles avec les opérations de jointure suivantes :
Pour en savoir plus, consultez Ajouter une opération de jointure. |
| Destination | Définit une destination pour la sortie des étapes de préparation des données. Si vous saisissez une table de destination qui n'existe pas, la préparation des données crée une table à l'aide des informations du schéma actuel. Pour en savoir plus, consultez Ajouter ou modifier une table de destination. |
| Supprimer les colonnes | Supprime des colonnes du schéma. Vous effectuez cette étape depuis la vue du schéma.
Pour en savoir plus, consultez Supprimer une colonne. |
Planifier des exécutions de préparation de données
Pour exécuter les étapes de préparation des données et charger les données préparées dans la table de destination, créez une planification. Vous pouvez planifier des préparations de données à partir de l'éditeur de préparation de données et les gérer depuis la page Planification de BigQuery. Pour en savoir plus, consultez Planifier des préparations de données.
Créer des pipelines avec des tâches de préparation de données
Vous pouvez créer des pipelines BigQuery composés de tâches de préparation des données, de requêtes SQL et de notebooks. Vous pouvez ensuite exécuter ces pipelines selon une planification. Pour en savoir plus, consultez Présentation des pipelines BigQuery.
Contrôler les accès
Contrôlez l'accès aux préparations de données à l'aide des rôles Identity and Access Management (IAM), du chiffrement avec les clés Cloud KMS BigQuery et Dataform, et de VPC Service Controls.
Rôles et autorisations IAM
Les utilisateurs qui préparent les données et les comptes de service Dataform qui exécutent les jobs ont besoin d'autorisations IAM. Pour en savoir plus, consultez Rôles requis et Configurer Gemini pour BigQuery.
Chiffrement avec des clés Cloud KMS
Chiffrez les données au niveau de l'ensemble de données ou du projet à l'aide des clés Cloud KMS gérées par le client par défaut dans BigQuery. Pour en savoir plus, consultez Définir une clé par défaut pour un ensemble de données et Définir une clé par défaut pour un projet.
Vous pouvez chiffrer le code du pipeline au niveau du projet par défaut à l'aide d'une clé Cloud KMS Dataform.
Périmètres VPC Service Controls
Si vous utilisez VPC Service Controls, vous devez configurer le périmètre pour protéger Dataform et BigQuery. Pour en savoir plus, consultez les limites de VPC Service Controls pour BigQuery et Dataform.
Rôle attribué lors de la création d'une préparation de données
Lorsque vous créez une préparation de données, BigQuery vous attribue le rôle Administrateur Dataform (roles/dataform.admin) sur cette préparation de données. Tous les utilisateurs disposant du rôle Administrateur Dataform sur le projet Google Cloud ont un accès propriétaire à toutes les préparations de données créées dans le projet. Pour remplacer ce comportement, consultez Attribuer un rôle spécifique lors de la création de la ressource.
Limites
La préparation des données est disponible avec les limites suivantes :
- Tous les ensembles de données source et de destination d'une préparation de données BigQuery donnée doivent se trouver au même emplacement. Pour plus d'informations, consultez la section Emplacements.
- Lors de la modification d'un pipeline, les données et les interactions sont envoyées à un centre de données Gemini pour traitement. Pour plus d'informations, consultez la section Emplacements.
- Gemini dans BigQuery n'est pas compatible avec Assured Workloads.
- Les préparations de données BigQuery ne permettent pas d'afficher, de comparer ni de restaurer des versions de préparation de données.
- Les réponses de Gemini sont basées sur un échantillon de l'ensemble de données que vous fournissez lorsque vous développez votre pipeline de préparation des données. Pour en savoir plus, consultez Utilisation de vos données par Gemini pour Google Cloud et les conditions du programme Testeur de confiance de Gemini pour Google Cloud .
- La préparation de données BigQuery ne dispose pas de sa propre API. Pour connaître les API nécessaires, consultez Configurer Gemini dans BigQuery.
Emplacements
Vos jobs de traitement de données sont exécutés et stockés à l'emplacement de vos ensembles de données sources. Si un emplacement de dépôt est spécifié, il doit être identique à l'emplacement des ensembles de données sources.
La région de stockage du code de préparation des données peut être différente de la région d'exécution du job.
Tous les nouveaux composants de code de votre projet Google Cloud utilisent une région par défaut. Une fois l'asset créé, vous ne pouvez plus modifier sa région.
Pour définir la région par défaut des nouveaux composants de code, procédez comme suit :
Accédez à la page BigQuery.
Dans le volet de gauche, cliquez sur Fichiers pour ouvrir l'explorateur de fichiers :

À côté du nom du projet, cliquez sur Afficher les actions du panneau des fichiers > Changer de région de code.
Sélectionnez la région de code que vous souhaitez utiliser par défaut.
Cliquez sur Enregistrer.
Pour obtenir la liste des régions compatibles, consultez Emplacements BigQuery Studio.
Le traitement des données BigQuery pendant le développement et l'exécution est toujours effectué à l'emplacement de vos ensembles de données sources. Pour savoir où Gemini dans BigQuery traite vos données, consultez Où Gemini dans BigQuery traite vos données.
Tarifs
L'exécution des préparations de données et la création d'échantillons d'aperçu des données utilisent des ressources BigQuery, qui sont facturées aux tarifs indiqués sur la page Tarifs de BigQuery.
La préparation des données est incluse dans la tarification de Gemini dans BigQuery. Pour en savoir plus, consultez Configurer Gemini dans BigQuery.
Étapes suivantes
- Découvrez comment préparer des données avec Gemini dans BigQuery.
- Découvrez comment exécuter des préparations de données manuellement ou selon une planification.