


Ringkasan persiapan data BigQuery
Anda dapat mengurangi waktu dan upaya yang diperlukan untuk tugas data manual secara signifikan dengan menggunakan persiapan data yang didukung AI di BigQuery. Persiapan data menggunakan Gemini in BigQuery untuk menganalisis data Anda dan memberikan saran cerdas untuk membersihkan, mentransformasi, dan memperkaya data. Dataform menjadwalkan persiapan data ini.
Manfaat
- Anda dapat mengurangi waktu yang dihabiskan untuk pengembangan pipeline data dengan saran transformasi yang dihasilkan Gemini dan peka konteks.
- Anda dapat memvalidasi hasil yang dihasilkan dalam pratinjau dan menerima saran pembersihan dan pengayaan kualitas data dengan pemetaan skema otomatis.
- Dataform memungkinkan Anda menggunakan proses continuous integration, continuous development (CI/CD), yang mendukung kolaborasi lintas tim untuk peninjauan kode dan kontrol sumber.
Titik entri persiapan data
Anda dapat membuat dan mengelola persiapan data di halaman BigQuery Studio (lihat Memulai sesi persiapan data).
Saat Anda membuka tabel dalam persiapan data BigQuery, tugas BigQuery akan berjalan menggunakan kredensial Anda. Proses ini akan membuat baris sampel dari tabel yang dipilih dan menulis hasilnya ke dalam tabel sementara di project yang sama. Gemini menggunakan data sampel dan skema untuk membuat saran penyiapan data yang ditampilkan di editor penyiapan data.
Tampilan di editor penyiapan data
Persiapan data muncul sebagai tab di halaman BigQuery. Setiap tab memiliki serangkaian subtab, atau tampilan persiapan data, tempat Anda mengembangkan dan mengelola persiapan data.
Tampilan data
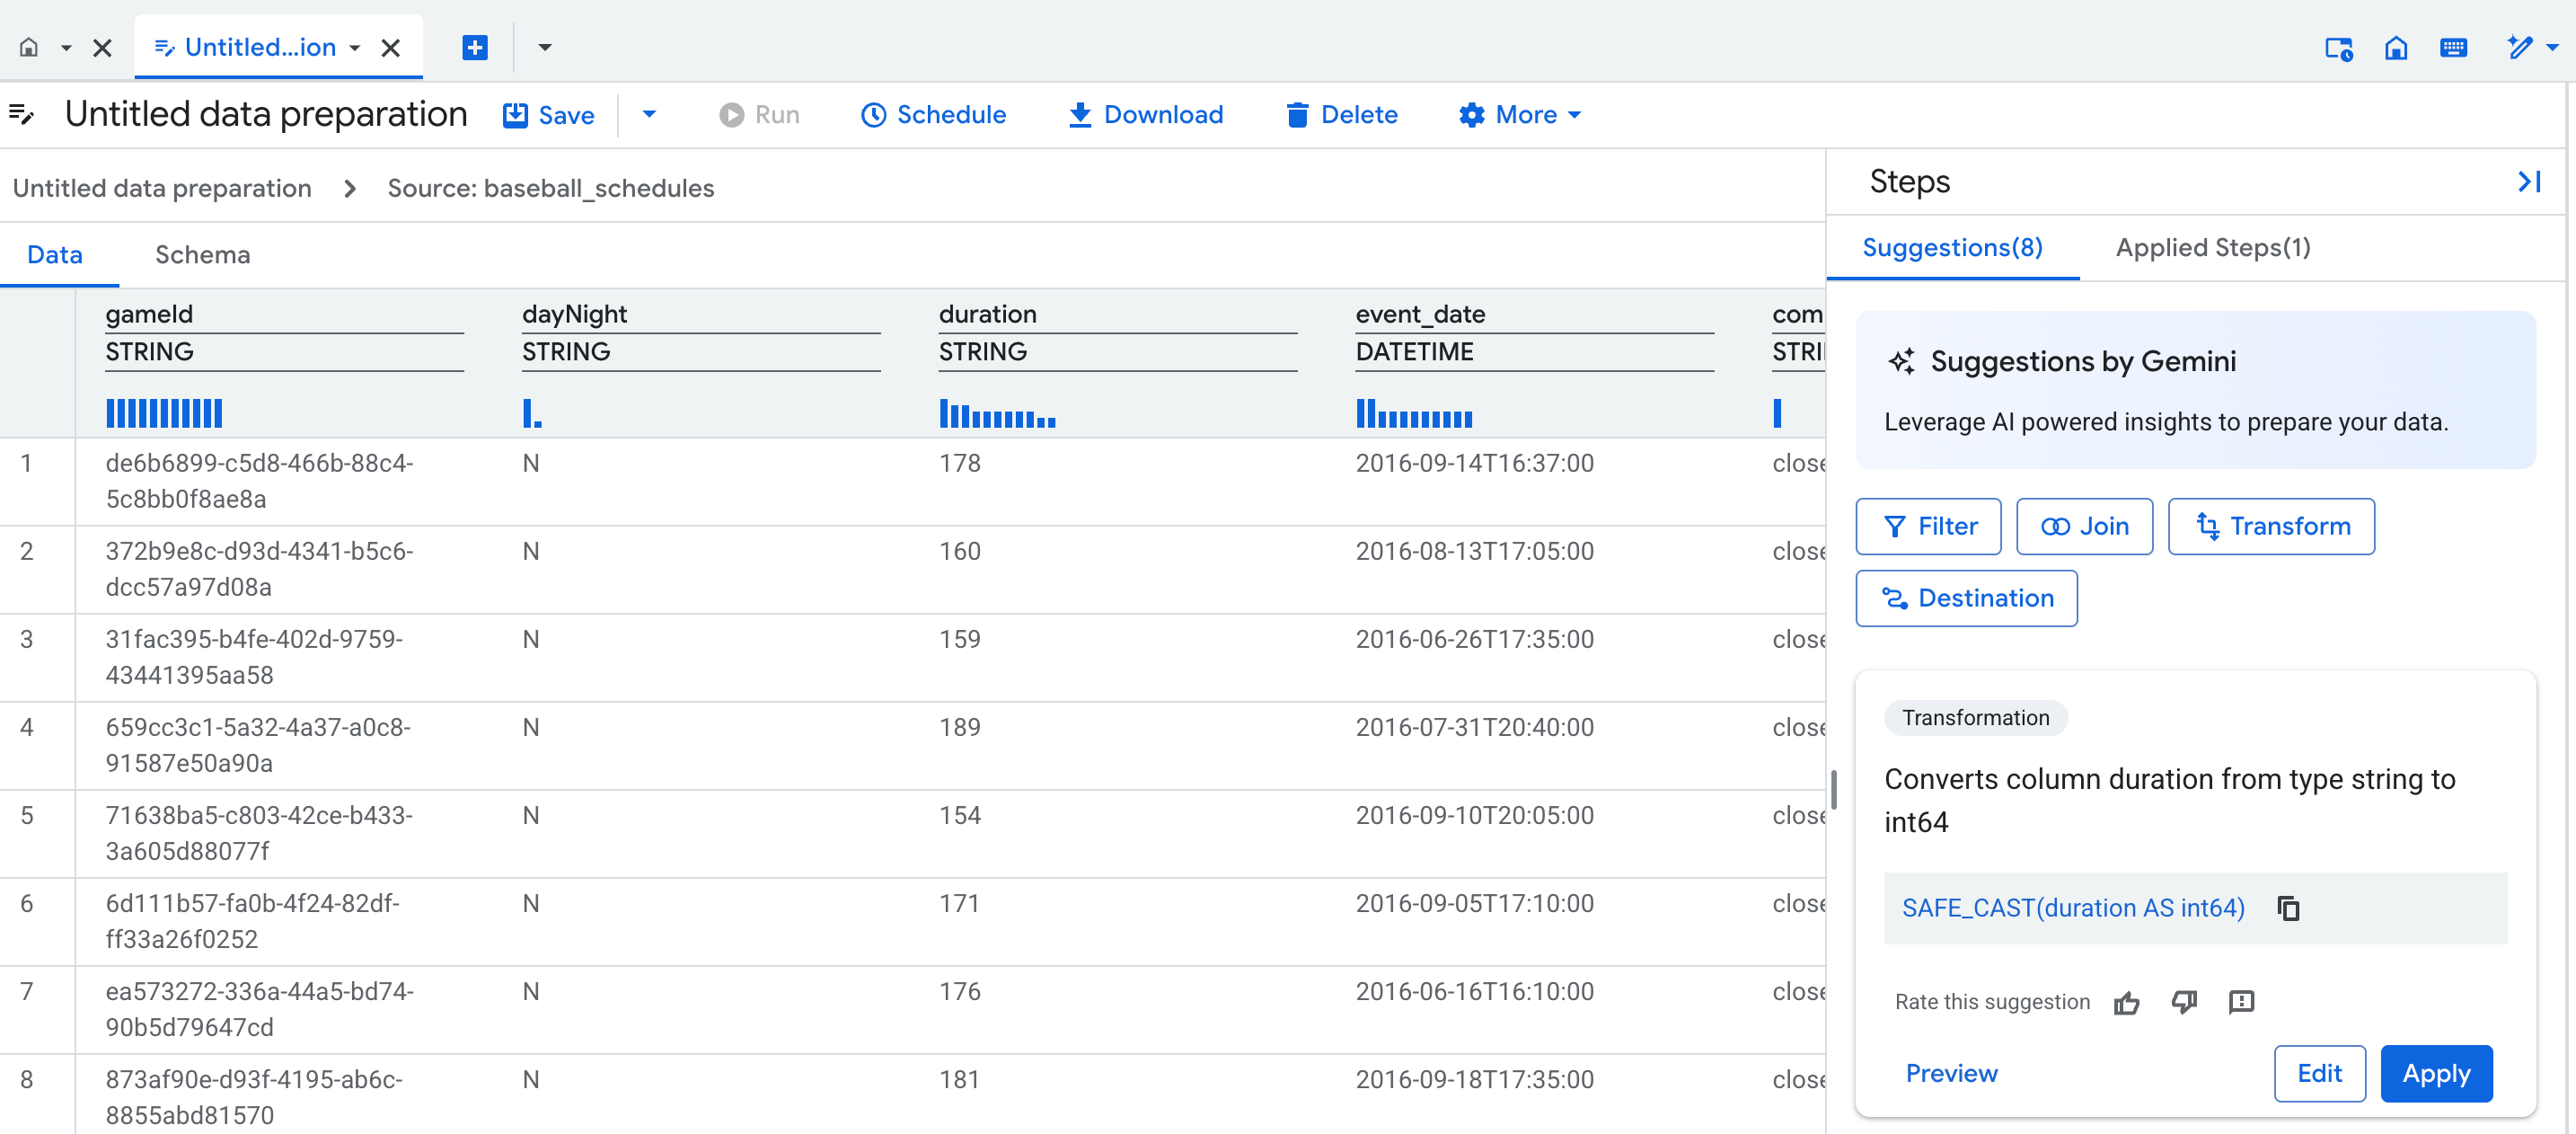
Saat Anda membuat persiapan data baru, tab editor persiapan data akan terbuka, menampilkan tampilan data, yang berisi sampel perwakilan dari tabel. Untuk persiapan data yang ada, Anda dapat membuka tampilan data dengan mengklik node dalam tampilan grafik pipeline persiapan data.
Tampilan data memungkinkan Anda melakukan hal berikut:
- Berinteraksi dengan data Anda untuk membentuk langkah-langkah penyiapan data.
- Menerapkan saran dari Gemini.
- Tingkatkan kualitas saran Gemini dengan memasukkan nilai contoh dalam sel.
Di setiap kolom dalam tabel, profil statistik (histogram) menampilkan jumlah untuk nilai teratas setiap kolom di baris pratinjau.
Tampilan grafik
Tampilan grafik adalah ringkasan visual dari persiapan data Anda. Tab ini muncul sebagai tab di halaman BigQuery di konsol, saat Anda membuka persiapan data. Grafik menampilkan node untuk semua langkah dalam pipeline persiapan data Anda. Anda dapat memilih node pada grafik untuk mengonfigurasi langkah-langkah persiapan data yang diwakilinya.

Tampilan skema
Tampilan skema persiapan data menampilkan skema saat ini dari langkah persiapan data yang aktif. Skema yang ditampilkan cocok dengan kolom dalam tampilan data.
Dalam tampilan skema, Anda dapat melakukan operasi skema khusus, seperti menghapus kolom, yang juga membuat langkah-langkah dalam daftar Applied steps.

Saran dari Gemini
Gemini memberikan saran kontekstual untuk membantu tugas-tugas penyiapan data berikut:
- Menerapkan transformasi dan aturan kualitas data
- Menstandarkan dan memperkaya data
- Mengotomatiskan pemetaan skema
Setiap saran muncul dalam kartu di daftar saran editor penyiapan data. Kartu ini berisi informasi berikut:
- Kategori tingkat tinggi dari langkah, seperti Keep rows atau Transformation
- Deskripsi langkah, seperti Keep rows if
COLUMN_NAMEis notNULL - Ekspresi SQL yang sesuai yang digunakan untuk menjalankan langkah
Anda dapat melihat pratinjau, mengedit, atau menerapkan kartu saran, atau menyesuaikan saran. Anda juga dapat menambahkan langkah secara manual. Untuk mengetahui informasi selengkapnya, lihat Menyiapkan data dengan Gemini.
Untuk menyesuaikan saran dari Gemini, berikan contoh hal yang perlu diubah di kolom.
Sampling data
BigQuery menggunakan pengambilan sampel data untuk memberikan pratinjau persiapan data Anda. Anda dapat melihat sampel di tampilan data untuk setiap node.
Saat Anda menambahkan tabel standar BigQuery sebagai sumber, data akan disiapkan menggunakan fungsi TABLESAMPLE BigQuery. Fungsi ini membuat sampel 10 ribu data.
Saat Anda menambahkan tampilan atau tabel eksternal sebagai sumber, sistem akan membaca 1 juta data pertama. Dari kumpulan data ini, sistem memilih sampel 10 ribu kumpulan data yang representatif.
Data dalam sampel tidak dimuat ulang secara otomatis. Tabel contoh disimpan sebagai hasil kueri yang di-cache dan akan berakhir masa berlakunya dalam waktu sekitar 24 jam. Untuk memuat ulang tabel sampel secara manual, lihat Memuat ulang sampel penyiapan data.
Mode tulis
Untuk mengoptimalkan biaya dan waktu pemrosesan, Anda dapat mengubah setelan mode tulis untuk memproses data baru secara inkremental dari sumber. Misalnya, jika Anda memiliki tabel di BigQuery tempat data disisipkan setiap hari, dan dasbor Looker yang harus mencerminkan data yang diubah, Anda dapat menjadwalkan persiapan data BigQuery untuk membaca data baru secara bertahap dari tabel sumber dan menyebarkannya ke tabel tujuan.
Untuk mengonfigurasi cara penulisan persiapan data ke dalam tabel tujuan, lihat Mengoptimalkan persiapan data dengan memproses data secara inkremental.
Mode tulis berikut didukung:
| Opsi mode tulis | Deskripsi |
|---|---|
| Refresh penuh | Melakukan langkah-langkah persiapan data pada semua data sumber, lalu membangun ulang tabel tujuan secara penuh. Tabel dibuat ulang, bukan dipotong. Refresh penuh adalah mode default saat menulis ke tabel tujuan. |
| Tambahkan | Menyisipkan semua data dari persiapan data sebagai baris tambahan dalam tabel tujuan. |
| Inkremental | Hanya menyisipkan data baru atau, bergantung pada pilihan kolom inkremental Anda, data yang diubah dalam tabel tujuan. Berdasarkan pilihan kolom inkremental Anda, persiapan data akan memilih mekanisme deteksi data perubahan yang optimal. Fitur ini memilih nilai Maksimum untuk jenis data numerik dan datetime, serta Unik untuk data kategoris. Maximum hanya menyisipkan data yang nilai kolomnya lebih besar dari nilai maksimum untuk kolom yang sama di tabel tujuan. Penyisipan unik hanya mencatat data yang nilai kolom yang ditentukan tidak ada dalam nilai yang ada untuk kolom yang sama di tabel tujuan. |
| Upsert | Menggabungkan baris menggunakan kunci penggabungan yang ditentukan. Jika baris yang ada dalam tabel tujuan cocok dengan kunci penggabungan yang ditentukan untuk data input, nilai dalam baris ini akan diperbarui dalam tabel tujuan. Jika tidak, baris baru akan disisipkan ke dalam tabel tujuan. |
Langkah-langkah persiapan data yang didukung
BigQuery mendukung jenis langkah persiapan data berikut:
| Jenis langkah | Deskripsi |
|---|---|
| Sumber | Menambahkan sumber saat Anda memilih tabel BigQuery untuk dibaca atau saat Anda menambahkan langkah gabungan. |
| Transformasi | Membersihkan dan mengubah data menggunakan ekspresi SQL. Anda akan menerima
kartu saran untuk ekspresi berikut:
Anda juga dapat menggunakan ekspresi SQL BigQuery yang valid dalam langkah-langkah transformasi manual. Contoh:
Untuk mengetahui informasi selengkapnya, lihat Menambahkan transformasi. |
| Filter | Menghapus baris melalui sintaksis klausa WHERE. Saat
menambahkan langkah filter, Anda dapat memilih untuk menjadikannya langkah validasi.
Untuk mengetahui informasi selengkapnya, lihat Memfilter baris. |
| Deduplicate | Menghapus baris duplikat dari data berdasarkan kunci dan pengurutan yang dipilih.
Untuk mengetahui informasi selengkapnya, lihat Menghapus duplikat data. |
| Validasi | Mengirim baris yang tidak memenuhi kriteria aturan validasi ke tabel error. Jika data gagal memenuhi aturan validasi dan tidak ada tabel error yang dikonfigurasi, persiapan data akan gagal selama eksekusi.
Untuk mengetahui informasi selengkapnya, lihat Mengonfigurasi tabel error dan menambahkan aturan validasi. |
| Gabung | Menggabungkan nilai dari dua sumber. Tabel harus berada di lokasi yang sama.
Kolom kunci gabungan harus memiliki jenis data yang sama. Persiapan data mendukung operasi gabungan berikut:
Untuk mengetahui informasi selengkapnya, lihat Menambahkan operasi penggabungan. |
| Tujuan | Menentukan tujuan untuk menghasilkan langkah-langkah persiapan data. Jika Anda
memasukkan tabel tujuan yang tidak ada, persiapan data akan
membuat tabel baru menggunakan informasi skema saat ini. Untuk mengetahui informasi selengkapnya, lihat Menambahkan atau mengubah tabel tujuan. |
| Hapus kolom | Menghapus kolom dari skema. Lakukan langkah ini dari tampilan skema.
Untuk mengetahui informasi selengkapnya, lihat Menghapus kolom. |
Menjadwalkan operasi persiapan data
Untuk menjalankan langkah-langkah persiapan data dan memuat data yang telah disiapkan ke dalam tabel tujuan, buat jadwal. Anda dapat menjadwalkan persiapan data dari editor persiapan data, dan mengelolanya dari halaman Penjadwalan BigQuery. Untuk mengetahui informasi selengkapnya, lihat Menjadwalkan persiapan data.
Membangun pipeline dengan tugas persiapan data
Anda dapat membangun pipeline BigQuery yang terdiri dari tugas persiapan data, kueri SQL, dan notebook. Selanjutnya, Anda dapat menjalankan pipeline ini sesuai jadwal. Untuk mengetahui informasi selengkapnya, lihat Pengantar pipeline BigQuery.
Mengontrol akses
Kontrol akses ke persiapan data menggunakan peran Identity and Access Management (IAM), enkripsi dengan kunci Cloud KMS BigQuery dan Dataform, serta Kontrol Layanan VPC.
Peran dan izin IAM
Pengguna yang menyiapkan data dan akun layanan Dataform yang menjalankan tugas memerlukan izin IAM. Untuk mengetahui informasi selengkapnya, lihat Peran yang diperlukan dan Menyiapkan Gemini untuk BigQuery.
Enkripsi dengan kunci Cloud KMS
Enkripsi data di level set data atau level project menggunakan kunci Cloud KMS default yang dikelola pelanggan di BigQuery. Untuk mengetahui informasi selengkapnya, lihat Menetapkan kunci default set data dan Menetapkan kunci default project.
Anda dapat mengenkripsi kode pipeline di level project secara default menggunakan kunci Cloud KMS Dataform.
Perimeter Kontrol Layanan VPC
Jika menggunakan Kontrol Layanan VPC, Anda harus mengonfigurasi perimeter untuk melindungi Dataform dan BigQuery. Untuk mengetahui informasi selengkapnya, lihat batasan Kontrol Layanan VPC untuk BigQuery dan Dataform.
Peran yang diberikan saat membuat persiapan data
Saat Anda membuat persiapan data, BigQuery akan memberi Anda
peran Dataform Admin
(roles/dataform.admin) pada persiapan data tersebut. Semua pengguna dengan
peran Admin Dataform yang diberikan pada project Google Cloud memiliki akses pemilik ke semua
persiapan data yang dibuat dalam project. Untuk mengganti perilaku ini, lihat
Memberikan peran tertentu saat pembuatan resource.
Batasan
Persiapan data tersedia dengan batasan berikut:
- Semua set data sumber dan tujuan persiapan data BigQuery dari persiapan data tertentu harus berada di lokasi yang sama. Untuk mengetahui informasi selengkapnya, lihat Lokasi.
- Selama pengeditan pipeline, data dan interaksi dikirim ke pusat data Gemini untuk diproses. Untuk mengetahui informasi selengkapnya, lihat Lokasi.
- Gemini in BigQuery tidak didukung oleh Assured Workloads.
- Persiapan data BigQuery tidak mendukung melihat, membandingkan, atau memulihkan versi persiapan data.
- Respons dari Gemini didasarkan pada sampel set data yang Anda berikan saat mengembangkan pipeline persiapan data. Untuk mengetahui informasi selengkapnya, lihat cara Gemini untuk Google Cloud menggunakan data Anda dan persyaratan dalam Program Penguji Tepercaya Gemini untuk Google Cloud .
- Persiapan data BigQuery tidak memiliki API sendiri. Untuk API yang diperlukan, lihat Menyiapkan Gemini di BigQuery.
Lokasi
Tugas pemrosesan data Anda dijalankan dan disimpan di lokasi set data sumber Anda. Jika lokasi repositori ditentukan, lokasi tersebut harus sama dengan lokasi set data sumber.
Region penyimpanan kode persiapan data dapat berbeda dengan region eksekusi tugas.
Semua aset kode baru di project Google Cloud Anda menggunakan region default. Setelah aset dibuat, Anda tidak dapat mengubah regionnya.
Untuk menetapkan region default bagi aset kode baru, lakukan hal berikut:
Buka halaman BigQuery.
Di panel kiri, klik Files untuk membuka file browser:

Di samping nama project, klik View files panel actions > Switch code region.
Pilih region kode yang ingin Anda gunakan sebagai default.
Klik Simpan.
Untuk mengetahui daftar region yang didukung, lihat Lokasi BigQuery Studio.
Pemrosesan data BigQuery selama waktu pengembangan dan eksekusi selalu dilakukan di lokasi set data sumber Anda. Untuk mempelajari tempat Gemini di BigQuery memproses data Anda, lihat Tempat Gemini di BigQuery memproses data Anda.
Harga
Menjalankan persiapan data dan membuat sampel pratinjau data menggunakan resource BigQuery, yang dikenai biaya sesuai tarif yang ditampilkan di harga BigQuery.
Persiapan data disertakan dalam harga Gemini di BigQuery. Untuk mengetahui informasi selengkapnya, lihat Menyiapkan Gemini di BigQuery.
Langkah berikutnya
- Pelajari cara menyiapkan data dengan Gemini di BigQuery.
- Pelajari cara menjalankan persiapan data secara manual atau dengan jadwal.