
Visualizza i grafici utilizzando BigQuery DataFrames

Puoi utilizzare la libreria Visualization di BigQuery DataFrames per tracciare vari tipi di grafici per esplorare e comprendere visivamente i tuoi dati. L'API bigframes.pandas ti consente di combinare facilmente operazioni statistiche avanzate con strumenti di rappresentazione grafica Python familiari, tra cui il campionamento integrato per set di dati di grandi dimensioni.

Istogramma

L'esempio seguente legge i dati dalla tabella bigquery-public-data.ml_datasets.penguins per tracciare un istogramma sulla distribuzione della profondità del culmen dei pinguini:

import bigframes.pandas as bpd

penguins = bpd.read_gbq("bigquery-public-data.ml_datasets.penguins")
penguins["culmen_depth_mm"].plot.hist(bins=40)

Esempio di istogramma in BigQuery DataFrames.

Grafico a linee

L'esempio seguente utilizza i dati della tabella bigquery-public-data.noaa_gsod.gsod2021 per tracciare un grafico a linee delle variazioni della temperatura mediana nel corso dell'anno:

import bigframes.pandas as bpd

noaa_surface = bpd.read_gbq("bigquery-public-data.noaa_gsod.gsod2021")

# Calculate median temperature for each day
noaa_surface_median_temps = noaa_surface[["date", "temp"]].groupby("date").median()

noaa_surface_median_temps.plot.line()

Esempio di grafico a linee in BigQuery DataFrames.

Grafico ad area

L'esempio seguente utilizza la tabella bigquery-public-data.usa_names.usa_1910_2013 per monitorare la popolarità dei nomi nella storia degli Stati Uniti e si concentra sui nomi Mary, Emily e Lisa:

import bigframes.pandas as bpd

usa_names = bpd.read_gbq("bigquery-public-data.usa_names.usa_1910_2013")

# Count the occurences of the target names each year. The result is a dataframe with a multi-index.
name_counts = (
    usa_names[usa_names["name"].isin(("Mary", "Emily", "Lisa"))]
    .groupby(("year", "name"))["number"]
    .sum()
)

# Flatten the index of the dataframe so that the counts for each name has their own columns.
name_counts = name_counts.unstack(level=1).fillna(0)

name_counts.plot.area(stacked=False, alpha=0.5)

Esempio di grafico ad area in BigQuery DataFrames.

Grafico a barre

L'esempio seguente utilizza la tabella bigquery-public-data.ml_datasets.penguins per visualizzare la distribuzione dei sessi dei pinguini:

import bigframes.pandas as bpd

penguins = bpd.read_gbq("bigquery-public-data.ml_datasets.penguins")

penguin_count_by_sex = (
    penguins[penguins["sex"].isin(("MALE", "FEMALE"))]
    .groupby("sex")["species"]
    .count()
)
penguin_count_by_sex.plot.bar()

Esempio di grafico a barre in BigQuery DataFrames.

Grafico a dispersione

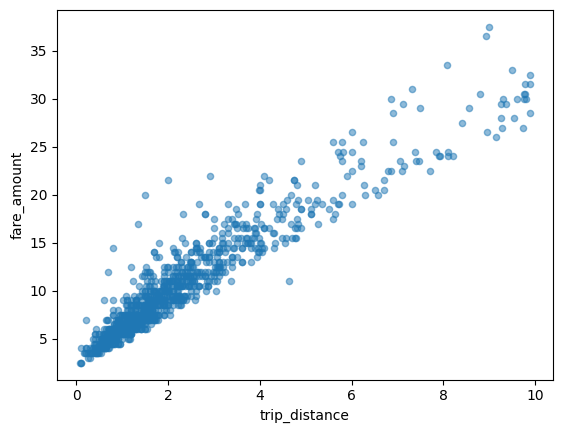
L'esempio seguente utilizza la tabella bigquery-public-data.new_york_taxi_trips.tlc_yellow_trips_2021 per esplorare la relazione tra gli importi delle tariffe dei taxi e le distanze dei viaggi:
import bigframes.pandas as bpd

taxi_trips = bpd.read_gbq(
    "bigquery-public-data.new_york_taxi_trips.tlc_yellow_trips_2021"
).dropna()

# Data Cleaning
taxi_trips = taxi_trips[
    taxi_trips["trip_distance"].between(0, 10, inclusive="right")
]
taxi_trips = taxi_trips[taxi_trips["fare_amount"].between(0, 50, inclusive="right")]

# If you are using partial ordering mode, you will also need to assign an order to your dataset.
# Otherwise, the next line can be skipped.
taxi_trips = taxi_trips.sort_values("pickup_datetime")

taxi_trips.plot.scatter(x="trip_distance", y="fare_amount", alpha=0.5)

Esempio di grafico a dispersione in BigQuery DataFrames.

Visualizzazione di un set di dati di grandi dimensioni

BigQuery DataFrames scarica i dati sulla tua macchina locale per la visualizzazione. Il numero di punti dati da scaricare è limitato a 1000 per impostazione predefinita. Se il numero di punti dati supera il limite, BigQuery DataFrames campiona in modo casuale il numero di punti dati pari al limite.

Puoi eseguire l'override di questo limite impostando il parametro sampling_n quando tracci un grafico, come mostrato nell'esempio seguente:

import bigframes.pandas as bpd

noaa_surface = bpd.read_gbq("bigquery-public-data.noaa_gsod.gsod2021")

# Calculate median temperature for each day
noaa_surface_median_temps = noaa_surface[["date", "temp"]].groupby("date").median()

noaa_surface_median_temps.plot.line(sampling_n=40)

Esempio di grafico a linee che visualizza un set di dati di grandi dimensioni in BigQuery DataFrames.

Tracciamento avanzato con i parametri pandas e Matplotlib

Puoi passare altri parametri per perfezionare il grafico, come faresti con pandas, perché la libreria di tracciamento di BigQuery DataFrames è basata su pandas e Matplotlib. Le sezioni seguenti descrivono alcuni esempi.

Tendenza della popolarità dei nomi con sottografici

Utilizzando i dati della cronologia dei nomi dell'esempio di grafico ad area, l'esempio seguente crea grafici singoli per ogni nome impostando subplots=True nella chiamata di funzione plot.area():

import bigframes.pandas as bpd

usa_names = bpd.read_gbq("bigquery-public-data.usa_names.usa_1910_2013")

# Count the occurences of the target names each year. The result is a dataframe with a multi-index.
name_counts = (
    usa_names[usa_names["name"].isin(("Mary", "Emily", "Lisa"))]
    .groupby(("year", "name"))["number"]
    .sum()
)

# Flatten the index of the dataframe so that the counts for each name has their own columns.
name_counts = name_counts.unstack(level=1).fillna(0)

name_counts.plot.area(subplots=True, alpha=0.5)

Esempio di grafici singoli con subplot in BigQuery DataFrames.

Grafico a dispersione delle corse in taxi con più dimensioni

Utilizzando i dati dell'esempio di grafico a dispersione, l'esempio seguente rinomina le etichette per l'asse x e l'asse y, utilizza il parametro passenger_count per le dimensioni dei punti, utilizza i punti colorati con il parametro tip_amount e ridimensiona la figura:

import bigframes.pandas as bpd

taxi_trips = bpd.read_gbq(
    "bigquery-public-data.new_york_taxi_trips.tlc_yellow_trips_2021"
).dropna()

# Data Cleaning
taxi_trips = taxi_trips[
    taxi_trips["trip_distance"].between(0, 10, inclusive="right")
]
taxi_trips = taxi_trips[taxi_trips["fare_amount"].between(0, 50, inclusive="right")]

# If you are using partial ordering mode, you also need to assign an order to your dataset.
# Otherwise, the next line can be skipped.
taxi_trips = taxi_trips.sort_values("pickup_datetime")

taxi_trips["passenger_count_scaled"] = taxi_trips["passenger_count"] * 30

taxi_trips.plot.scatter(
    x="trip_distance",
    xlabel="trip distance (miles)",
    y="fare_amount",
    ylabel="fare amount (usd)",
    alpha=0.5,
    s="passenger_count_scaled",
    label="passenger_count",
    c="tip_amount",
    cmap="jet",
    colorbar=True,
    legend=True,
    figsize=(15, 7),
    sampling_n=1000,
)

Esempio di grafico a dispersione con più dimensioni in BigQuery DataFrames.

Passaggi successivi