


レイテンシのトラブルシューティング
他のデータベース システムと同様に、Bigtable でもレイテンシの問題が発生することがあります。このドキュメントでは、Bigtable のレイテンシの問題の一般的な原因と、そのトラブルシューティング方法について説明します。
次のセクションのトラブルシューティングの手順に沿って、Bigtable のレイテンシの問題を診断して解決します。
高レイテンシの原因を理解する
Bigtable のレイテンシの問題には、次の要因が影響します。
- サーバーのレイテンシ。サーバー レイテンシの測定は、Bigtable がリクエストを受信すると開始され、Bigtable がデータの最後のバイトをクライアントに送信すると終了します。大量のデータのリクエストの場合、クライアントがレスポンスを使用できるかどうかによってサーバーのレイテンシが影響を受ける可能性があります。
- オペレーションのレイテンシは、すべての再試行を含む、Bigtable オペレーションのエンドツーエンドの合計時間を測定します。この指標は、クライアントから Bigtable への往復を追跡します。アプリケーションのレイテンシ、ネットワーク接続、Bigtable クライアント ライブラリのレイテンシ、サーバーのレイテンシはすべて、オペレーションのレイテンシに影響します。
- ワークロードとリクエストのパターンは、インフラストラクチャの問題だけでなく、アプリケーションがリクエストする作業パターンの変化によってもレイテンシを増加させる可能性があります。たとえば、以前は 100 行をスキャンしていた動的に生成されたスキャンクエリが、最近のデータ インポートやアプリケーション ロジックの変更により、100 万行をスキャンするようになります。システムは効率的に動作している可能性がありますが、1 回のオペレーションの作業量が大幅に増加すると、実行時間が長くなり、Bigtable はレイテンシが高くなると認識します。
始める前に
高レイテンシの問題をトラブルシューティングするには、次の操作を行います。
- クライアント ライブラリのクライアントサイドの指標を有効にして、パフォーマンスを最適化し、問題を解決します。
- ネットワーク レイテンシを最小限に抑えるには、アプリケーションが Bigtable クラスタと同じゾーンに存在することを確認します。これにより、アプリケーションとクラスタ間のネットワーク距離が短縮され、リクエストのレスポンス時間が短縮されます。
- Bigtable 環境に関する次の情報を収集します。
- クライアントサイド環境に関する次の情報を収集します。
- 問題に関する次の情報を収集します。
レイテンシの問題をトラブルシューティングする
Bigtable でレイテンシの問題が発生した場合は、次の手順でトラブルシューティングを行います。
- サーバーのレイテンシを確認する:Google Cloud コンソールの [Monitoring] ページを使用して、サーバーのレイテンシを表示します。詳細については、Cloud Monitoring でモニタリングするをご覧ください。インスタンスのレイテンシを確認します。インスタンスに複数のクラスタが含まれている場合は、クラスタごとに指標をスライスします。読み取りレイテンシまたは書き込みレイテンシのグラフ、またはクライアントサイドの指標でレイテンシの増加が確認された場合は、このドキュメントのサーバー レイテンシのトラブルシューティング セクションにあるサーバー レイテンシのトラブルシューティングの手順に沿って操作します。
- クライアントのレイテンシを確認する: クライアントサイドの指標を有効にした後、Cloud Monitoring Metrics Explorer で
bigtable.googleapis.com/clientを検索します。利用可能なクライアントサイドの指標を確認します。クライアントサイドの指標でレイテンシが増加しているものの、サーバーでは増加していない場合は、アプリケーションとネットワーク接続を調べます。詳細については、このドキュメントのクライアント レイテンシのトラブルシューティングをご覧ください。
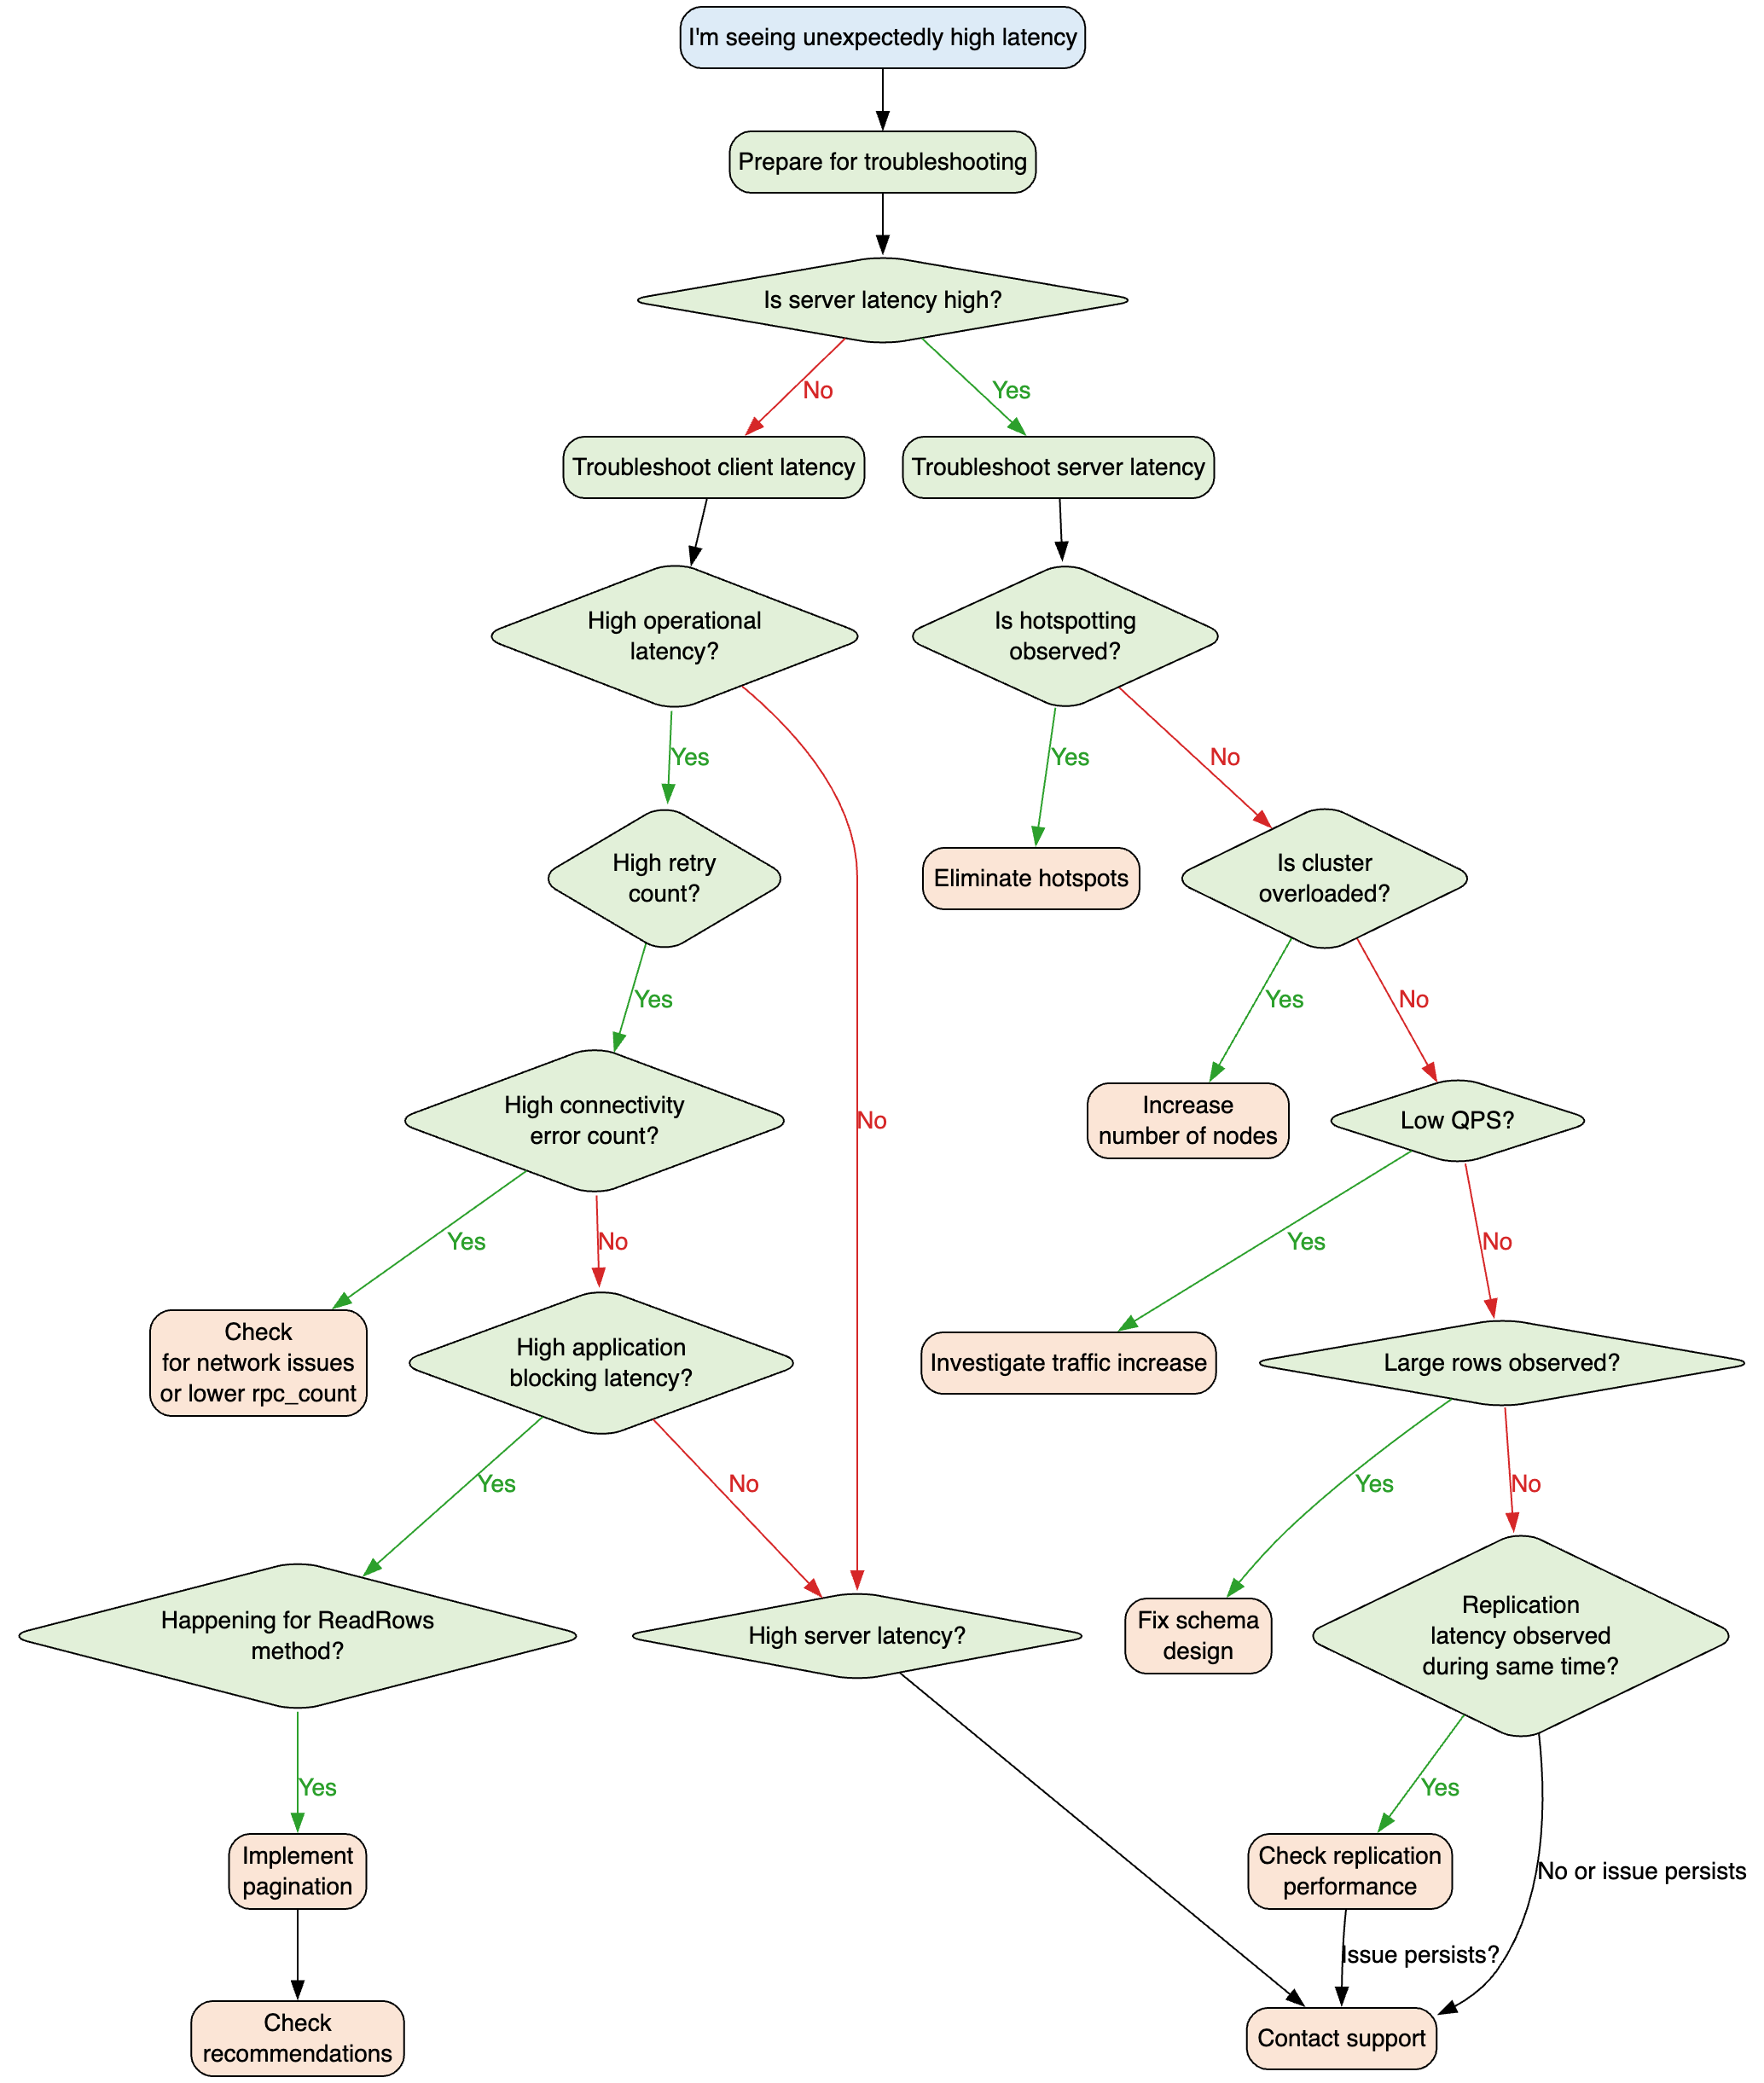
次の図は、Bigtable でレイテンシが増加した場合のトラブルシューティングのプロセスを示しています。
クライアント レイテンシのトラブルシューティング
クライアントサイドのレイテンシの問題をトラブルシューティングする手順は次のとおりです。
始める前に
クライアントサイドのレイテンシのトラブルシューティングを開始する前に、次のタスクを完了します。
- Bigtable でクライアントサイドの指標を有効にする。
- Java クライアント バージョン 2.17.1 以前を使用している場合は、チャネル プライミングを有効にします。チャネルの更新は、バージョン 2.18.0 以降ではデフォルトで有効になっています。
- ワークロードに最適な接続プールサイズを決定するために、このプロセスを繰り返します。チャネルが不十分または過剰な場合、試行レイテンシが高くなる可能性があります。
アプリケーション ブロックのレイテンシを確認する
Google Cloud コンソールで Application Blocking Latencies 指標を確認し、次のいずれかの操作を行います。
- アプリケーション ブロッキングのレイテンシが高く、報告されたレイテンシの増加に対応している場合は、クライアントサイドの問題のトラブルシューティングに重点を置きます。
- アプリケーションをブロックするレイテンシが高く、クライアントがGoogle Cloud インフラストラクチャ(GKE や Compute Engine など)でホストされている場合は、適切な Google Cloud サポートチームにエスカレーションします。
- アプリケーション ブロッキング レイテンシが低く、Bigtable のサービス レイテンシも低い場合、レイテンシのボトルネックは、ネットワークや Google フロントエンドなど、ネットワークまたはトラフィック パスの中間コンポーネントにある可能性があります。 Google Cloudネットワーキング チームにエスカレーションして、完全なパケット キャプチャを行い、レイテンシのボトルネックを特定することを検討してください。
オペレーション レイテンシが高い場合に対処する
connectivity_error_countが高い場合、アプリケーションが Google フロントエンドにアクセスする際に問題が発生しています。リクエストが別のチャネルで再試行できるように、RPC タイムアウトを低く設定します。- RPC タイムアウトが低すぎると、オペレーション レイテンシが高くなることもあります。通常のオペレーション中に一般的な P99 RPC タイムアウトを特定します。RPC タイムアウト値をこのベンチマークに近い値に設定すると、パフォーマンスを最適化できます。
retry_countが高い場合は、attempt_latenciesステータス タグを確認します。試行がDEADLINE_EXCEEDEDエラーで失敗した場合、リクエストの期限は平均attempt_latenciesと比較して短すぎます。
gRPC スレッドでキューに入れられたアドレス リクエスト
どの指標も標準を超えていない場合、リクエストは gRPC スレッドでキューに格納される可能性があります。これには、次の理由が考えられます。
- チャネルプールのサイズが小さすぎるため、リクエストが gRPC チャネルでキューに登録されます。詳細については、バッファリングされたリクエストをご覧ください。
- クライアント VM の CPU 使用率が高い。CPU 使用率が高いと、クライアントでリクエストのキューイングが発生します。
サーバーのレイテンシのトラブルシューティング
サーバーサイドのレイテンシの問題をトラブルシューティングする手順は次のとおりです。
クラスタが過負荷状態かどうかを判断する
Read requestsグラフとWrite requestsグラフで QPS の変化を確認します。Node countグラフでノード数の変化を確認します。Read throughputグラフとWrite throughputグラフで、帯域幅の増加を確認します。詳細については、パフォーマンスについてをご覧ください。- アプリ プロファイル、メソッド、テーブルで CPU がどのように使用されているかを特定してパフォーマンスの問題をトラブルシューティングするには、Cloud Bigtable クラスタの CPU 使用についてのブログ投稿をご覧ください。
- 影響を受けるクラスタのノード数を増やします。詳細については、ノードを手動で追加または削除すると自動スケーリングをご覧ください。平均 CPU 使用率が推奨しきい値を下回っていることを確認します。
ホットスポットを確認する
ホット タブレットは、同じノードに関連付けられている他のタブレットと比べて、ノードの CPU を過剰に使っているタブレットです。このような使用量の偏りは、行範囲へのリクエスト量が当初の予想以上に多い場合や、スキーマ設計の不備が原因で発生します。このノード使用量の偏りによって、レイテンシやレプリケーションの遅延が発生する可能性があります。これはホットスポットと呼ばれます。
CPU utilization (hottest node) high granularityグラフでホットスポットを確認します。- ホット タブレットを特定するには、ホット タブレットまたは Key Visualizer ツールを使用します。
- クラスタレベルの CPU の過剰使用は、ノードを追加する(水平スケーリング)ことで軽減できることがよくありますが、ホットスポットでは、他の軽減手法が必要になる場合があります。これらの手法には、行キーの作成方法の変更やスキーマの変更などがあります。詳細については、ブログ投稿「Cloud Bigtable のホットスポットを取り除く」をご覧ください。
QPS が低い場合のレイテンシに対処する
Bigtable は、頻繁にアクセスする大きなテーブルで優れたパフォーマンスを発揮します。一定期間使用されていない状態でリクエストを送信すると、Bigtable が接続を再確立するまでにレイテンシが高くなる可能性があります。
Read requestsグラフとWrite requestsグラフに低い QPS が表示されている場合は、レスポンス時間が長くなることが予想されます。- コールド スタートと低 QPS のベスト プラクティスに沿って、コールド スタートの問題を軽減します。
リクエストの効率を評価する
[アクセス パターン] ページとクエリ統計情報を使用して、リクエストの効率を評価します。
- Google Cloud コンソールの [アクセス パターン] ページを使用して、読み取りクエリと書き込みクエリのタイプ(ポイント読み取り、短いスキャン、リバース スキャン、スパース読み取り、一括読み取りなど)の内訳を時系列でモニタリングし、テーブルとアプリ プロファイルの [スキャンされた行] と [表示されたセル] を [返された行] と [送信されたセル] と比較します。詳細については、アクセス パターンを分析するをご覧ください。
- クエリ統計情報を使用して、個々の読み取りリクエストについて、クエリ対象となった行数と返された行数の比率、クエリ対象となったセル数と返されたセル数の比率を調べます。クエリパターン、フィルタ、スキーマ設計を見直して、リクエストの効率を向上させます。詳細については、クエリの統計情報を取得するをご覧ください。
構成またはアプリ プロファイルの変更を確認する
ノード数とスループットは変わらないものの、平均 CPU 使用率が増加している場合は、レプリケーションまたはガベージ コレクション戦略の変更が原因である可能性があります。詳細については、レプリケーションとパフォーマンスをご覧ください。レプリケーションまたはガベージ コレクションの構成変更を元に戻します。
Bigtable サポートにエスカレーションする
上記の手順で問題が解決しない場合は、Bigtable サポートにエスカレーションしてください。
次のステップ
- Bigtable のパフォーマンスの詳細を確認する。
- Bigtable の指標をご覧ください。
- Key Visualizer で利用できる指標を確認する。