


지연 시간 문제 해결
다른 데이터베이스 시스템과 마찬가지로 Bigtable에서도 지연 시간 문제가 발생할 수 있습니다. 이 문서에서는 Bigtable의 지연 시간 문제의 일반적인 원인을 설명하고 문제 해결 방법을 설명합니다.
다음 섹션의 문제 해결 단계를 사용하여 Bigtable 지연 시간 문제를 진단하고 해결합니다.
지연 시간이 긴 원인 파악
다음 요소는 Bigtable의 지연 시간 문제에 영향을 미칩니다.
- 서버 지연 시간. 서버 지연 시간의 측정은 Bigtable에서 요청을 수신할 때 시작되고 Bigtable에서 데이터의 마지막 바이트를 클라이언트에 전송할 때 종료됩니다. 대용량 데이터 요청의 경우 클라이언트의 응답 사용 능력은 서버 지연 시간에 영향을 줄 수 있습니다.
- 작업 지연 시간은 모든 재시도를 포함하여 Bigtable 작업의 총 엔드 투 엔드 시간을 측정합니다. 이 측정항목은 클라이언트에서 Bigtable로, 다시 클라이언트로의 왕복을 추적합니다. 애플리케이션의 지연 시간, 네트워크 연결, Bigtable 클라이언트 라이브러리 지연 시간, 서버 지연 시간은 모두 작업 지연 시간에 영향을 미칩니다.
- 워크로드 및 요청 패턴은 인프라 문제뿐만 아니라 애플리케이션이 요청하는 작업 패턴의 변경으로 인해 지연 시간을 늘릴 수 있습니다. 예를 들어 최근 데이터 가져오기 또는 애플리케이션 로직 변경으로 인해 이전에 100개의 행을 스캔한 동적으로 생성된 스캔 쿼리가 이제 100만 개의 행을 스캔합니다. 시스템이 효율적으로 작동할 수 있지만 단일 작업의 작업량이 크게 증가하면 실행 시간이 길어지고 Bigtable은 이를 지연 시간이 긴 것으로 인식합니다.
시작하기 전에
지연 시간이 긴 문제를 해결하려면 다음 작업을 수행합니다.
- 클라이언트 라이브러리에 클라이언트 측 측정항목을 사용 설정하여 성능을 최적화하고 문제를 해결합니다.
- 네트워크 지연 시간을 최소화하려면 애플리케이션이 Bigtable 클러스터와 동일한 영역에 있는지 확인합니다. 이렇게 하면 애플리케이션과 클러스터 간의 네트워크 거리가 줄어들어 요청 응답 시간이 개선됩니다.
- Bigtable 환경에 대한 다음 정보를 수집합니다.
- 클라이언트 측 환경에 관한 다음 정보를 수집합니다.
- 문제에 관해 다음 정보를 수집합니다.
지연 시간 문제 해결
Bigtable에서 지연 시간 문제가 발생하면 다음 단계에 따라 문제를 해결하세요.
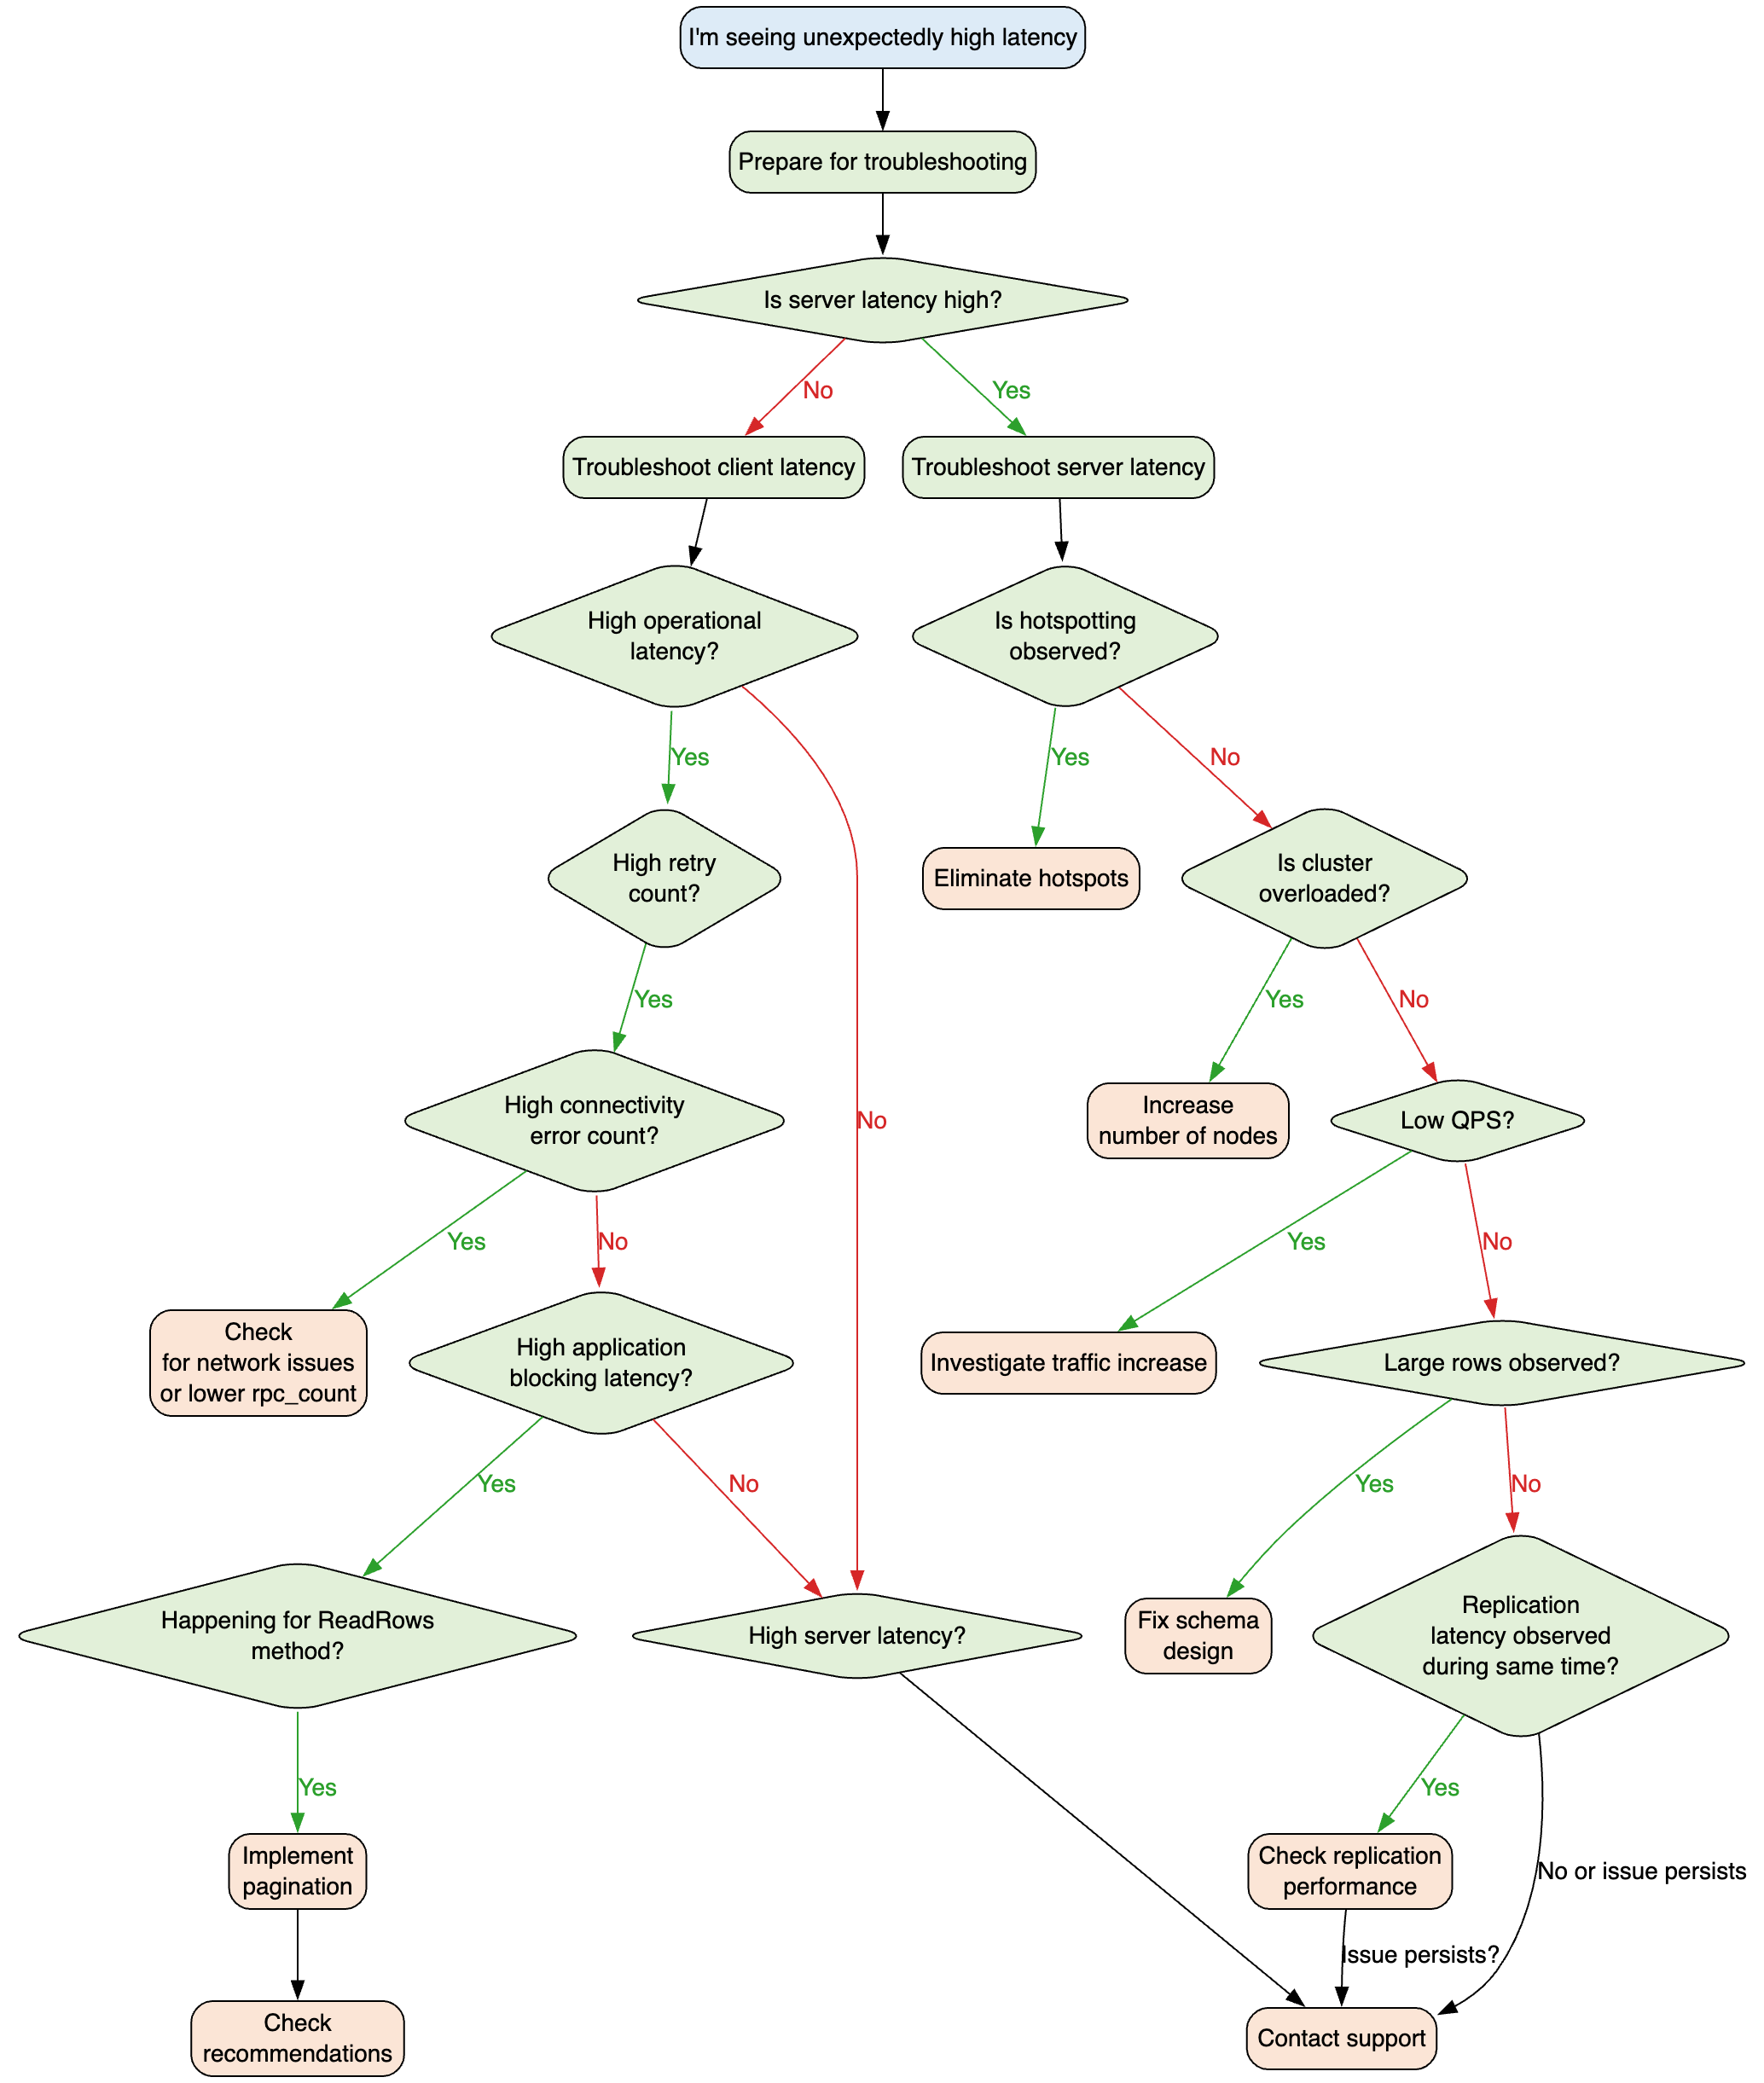
- 서버 지연 시간 확인:Google Cloud 콘솔의 모니터링 페이지를 사용하여 서버 지연 시간을 확인합니다. 자세한 내용은 Cloud Monitoring으로 모니터링을 참조하세요. 인스턴스의 지연 시간을 확인합니다. 인스턴스에 여러 클러스터가 포함된 경우 클러스터별로 측정항목을 슬라이스합니다. 읽기 지연 시간 또는 쓰기 지연 시간 그래프 또는 클라이언트 측 측정항목에서 지연 시간 증가가 관찰되면 이 문서의 서버 지연 시간 문제 해결 섹션에 있는 서버 지연 시간 문제 해결 단계를 따르세요.
- 클라이언트 지연 시간 확인: 클라이언트 측 측정항목을 사용 설정한 후 Cloud Monitoring 측정항목 탐색기에서
bigtable.googleapis.com/client를 검색합니다. 사용 가능한 클라이언트 측 측정항목을 검토합니다. 클라이언트 측 측정항목에서 지연 시간이 증가하지만 서버에서는 지연 시간이 증가하지 않는 경우 애플리케이션과 네트워크 연결을 검사합니다. 자세한 내용은 이 문서의 클라이언트 지연 시간 문제 해결 섹션을 참조하세요.
다음 다이어그램은 Bigtable에서 지연 시간 증가 문제를 해결하는 프로세스를 보여줍니다.
클라이언트 지연 시간 문제 해결
클라이언트 측 지연 시간 문제를 해결하려면 다음 단계를 따르세요.
시작하기 전에
클라이언트 측 지연 시간 문제 해결을 시작하기 전에 다음 태스크를 완료하세요.
- Bigtable에서 클라이언트 측 측정항목을 사용 설정합니다.
- Java 클라이언트 버전 2.17.1 이하를 사용하는 경우 채널 프라이밍을 사용 설정합니다. 채널 새로고침은 버전 2.18.0부터 기본적으로 사용 설정됩니다.
- 워크로드에 최적의 연결 풀 크기를 결정하기 위해 반복합니다. 채널이 부족하거나 과도하면 시도 지연 시간이 길어질 수 있습니다.
애플리케이션 차단 지연 시간 확인
Google Cloud 콘솔에서 Application Blocking Latencies 측정항목을 확인하고 다음 작업 중 하나를 수행합니다.
- 애플리케이션 차단 지연 시간이 길고 보고된 지연 시간 증가에 해당하는 경우 클라이언트 측 문제 해결에 집중합니다.
- 애플리케이션 차단 지연 시간이 길고 클라이언트가 GKE 또는 Compute Engine과 같은Google Cloud 인프라에서 호스팅되는 경우 적절한 Google Cloud 지원팀에 에스컬레이션합니다.
- 애플리케이션 차단 지연 시간이 짧고 Bigtable 서빙 지연 시간도 짧은 경우 지연 시간 병목 현상은 네트워크 또는 Google 프런트엔드와 같은 네트워킹 또는 트래픽 경로의 중간 구성요소에 있을 수 있습니다. Google Cloud네트워킹팀에 에스컬레이션하여 지연 시간 병목 현상을 식별하기 위한 전체 패킷 캡처를 지원받는 것이 좋습니다.
높은 작업 지연 시간 해결
connectivity_error_count가 높으면 애플리케이션이 Google 프런트엔드에 도달하는 데 문제가 있습니다. 요청이 다른 채널에서 재시도할 수 있도록 RPC 제한 시간을 낮게 설정합니다.- RPC 제한 시간이 너무 낮으면 작업 지연 시간이 길어질 수도 있습니다. 정상 작업 중 일반적인 P99 RPC 제한 시간을 확인합니다. RPC 제한 시간 값을 이 벤치마크에 가깝게 설정하면 성능을 최적화하는 데 도움이 됩니다.
retry_count가 높으면attempt_latencies상태 태그를 확인합니다.DEADLINE_EXCEEDED오류와 함께 시도가 실패하면 요청 기한이 평균attempt_latencies에 비해 너무 짧은 것입니다.
gRPC 스레드에서 대기 중인 주소 요청
측정항목이 기준을 초과하지 않으면 요청이 gRPC 스레드에서 큐에 추가될 수 있습니다. 이는 다음과 같은 이유로 발생할 수 있습니다.
- 채널 풀 크기가 너무 작고 요청이 gRPC 채널에서 큐에 추가됩니다. 자세한 내용은 버퍼링된 요청을 참조하세요.
- 클라이언트 VM의 CPU 사용량이 높습니다. CPU 사용량이 많으면 클라이언트에서 요청 큐가 발생합니다.
서버 지연 시간 문제 해결
다음 단계에 따라 서버 측 지연 시간 문제를 해결하세요.
클러스터가 과부하되었는지 확인
Read requests및Write requests그래프에서 QPS 변경사항을 확인합니다.Node count그래프에서 노드 수의 변화를 확인합니다.Read throughput및Write throughput그래프에서 대역폭이 증가하는지 확인합니다. 자세한 내용은 성능 이해를 참조하세요.- 앱 프로필, 메서드, 테이블에서 CPU를 사용하여 성능 문제를 해결하는 방법을 확인하려면 Cloud Bigtable 클러스터에서 CPU를 사용하는 위치 블로그 게시물을 참조하세요.
- 영향을 받는 클러스터의 노드 수를 늘립니다. 자세한 내용은 수동으로 노드 추가 또는 삭제 및 자동 확장을 참조하세요. 평균 CPU 사용률이 권장 기준 미만으로 유지되는지 확인합니다.
핫스팟 확인
핫 태블릿은 해당 노드와 연결된 다른 태블릿에 비해 노드 CPU의 지나치게 많은 비율을 사용합니다. 이러한 불균형한 사용은 행 범위에 대한 예상치 못한 대량의 요청이나 스키마 설계의 결함으로 인해 발생할 수 있습니다. 노드 사용량이 균형이 맞지 않으면 지연 시간이 길어지고 복제 지연이 발생할 수 있으며, 이를 핫스팟이라고 합니다.
CPU utilization (hottest node) high granularity그래프에서 핫스팟을 관찰합니다.- 핫 태블릿을 식별하려면 핫 태블릿 또는 Key Visualizer 도구를 사용합니다.
- 노드를 더 추가하여 완화할 수 있는 클러스터 수준 CPU 과다 사용(수평 확장)과 달리 핫스팟에는 다른 완화 기술이 필요할 수 있습니다. 이러한 기법에는 row key를 구성하는 방법이나 스키마를 변경하는 것이 포함됩니다. 자세한 내용은 Cloud Bigtable에서 핫스팟 제거 블로그 게시물을 참조하세요.
낮은 QPS로 지연 시간 해결
Bigtable은 자주 액세스하는 큰 테이블에서 가장 효과적입니다. 일정 기간 사용하지 않은 후 요청을 보내면 Bigtable이 연결을 다시 설정하는 동안 지연 시간이 길어질 수 있습니다.
Read requests및Write requests그래프에 낮은 QPS가 표시되면 응답 시간이 느려질 수 있습니다.- 콜드 스타트 및 낮은 QPS의 권장사항에 따라 콜드 스타트 문제를 완화합니다.
요청 효율성 평가
액세스 패턴 페이지 및 쿼리 통계를 사용하여 요청 효율성을 평가합니다.
- Google Cloud 콘솔의 액세스 패턴 페이지를 사용하여 시간 경과에 따른 읽기 및 쓰기 쿼리 유형의 분석(예: 포인트 읽기, 짧은 스캔, 역방향 스캔, 희소 읽기, 일괄 읽기)을 모니터링하고 테이블 및 앱 프로필의 스캔한 행 및 표시된 셀을 반환된 행 및 전송된 셀과 비교합니다. 자세한 내용은 액세스 패턴 분석을 참조하세요.
- 쿼리 통계를 사용하여 개별 읽기 요청에 대해 반환된 행에 표시된 행 비율과 반환된 셀에 표시된 셀 비율을 검사합니다. 쿼리 패턴, 필터 또는 스키마 설계를 다시 검토하여 요청 효율성을 개선합니다. 자세한 내용은 쿼리 통계 가져오기를 참조하세요.
구성 또는 앱 프로필 변경사항 확인
노드 수와 처리량은 변경되지 않지만 평균 CPU 사용률이 증가하는 경우 복제 또는 가비지 컬렉션 전략의 변경으로 인해 발생할 수 있습니다. 자세한 내용은 복제 및 성능을 참조하세요. 복제 또는 가비지 컬렉션의 구성 변경사항을 되돌립니다.
Bigtable 지원팀으로 에스컬레이션
이전 단계로 문제가 해결되지 않으면 Bigtable 지원팀에 에스컬레이션합니다.
다음 단계
- Bigtable 성능 자세히 알아보기
- Bigtable 측정항목을 참조하세요.
- Key Visualizer에서 사용할 수 있는 측정항목 살펴보기