


(Eingestellt) Data Mesh-Nutzerhandbuch
Data Mesh für Cortex Framework erweitert die Datengrundlage, um Data Governance, Auffindbarkeit und Zugriffssteuerung über BigQuery-Metadaten und Knowledge Catalog zu ermöglichen. Dazu wird ein Basissatz von Metadatenressourcen und BigQuery-Asset-Annotationen bereitgestellt, die angepasst und optional zusammen mit der Datengrundlage bereitgestellt werden können. Diese Basisspezifikationen bieten eine benutzerdefinierte Konfiguration, die die Metadatengrundlage für die Cortex Framework Data Foundation bildet. Lesen Sie die Data Mesh-Konzepte, bevor Sie mit diesem Leitfaden fortfahren.
Die auf dieser Seite beschriebenen Schritte sind speziell für die Konfiguration von Data Mesh für das Cortex Framework vorgesehen. Die Data Mesh-Konfigurationsdateien finden Sie in den Ordnern für die einzelnen Arbeitslasten im Abschnitt „Data Mesh-Verzeichnisse“.
Design
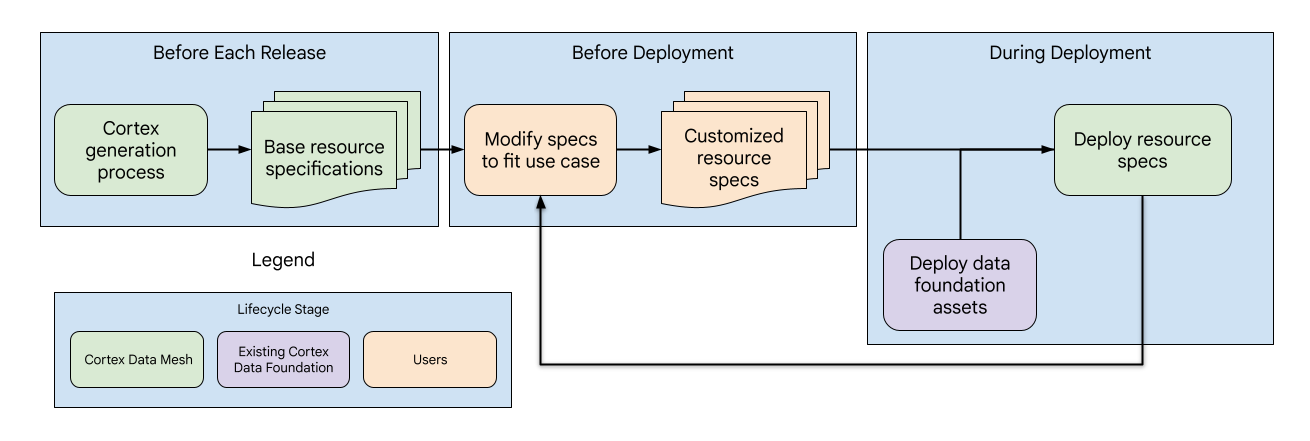
Das Data Mesh von Cortex ist ähnlich wie die allgemeine Datengrundlage aufgebaut und besteht aus drei Phasen mit verschiedenen Unterkomponenten, die von Cortex oder Nutzern verwaltet werden:
- Aktualisierung der Basisressourcenspezifikationen: Mit jedem Release aktualisiert Cortex die Basisressourcenspezifikationen und bietet so eine standardisierte Metadatengrundlage für das Data Mesh.
- Anpassung der Ressourcenspezifikationen: Vor der Bereitstellung können Nutzer die Ressourcenspezifikationen an ihre spezifischen Anwendungsfälle und Anforderungen anpassen.
- Data Mesh-Bereitstellung und -Updates: Nutzer können das Data Mesh in der Cortex-Konfigurationsdatei aktivieren. Sie wird nach den Daten-Assets während der Cortex-Bereitstellung bereitgestellt. Darüber hinaus können Nutzer das Data Mesh für weitere Updates unabhängig bereitstellen.
Data Mesh-Verzeichnisse
Die Basis-Konfigurationsdateien für Data Mesh für jede Arbeitslast und Datenquelle finden Sie an den folgenden Speicherorten. Beachten Sie, dass Verzeichnisse unterschiedliche Dateistrukturen enthalten, aber alle Spezifikationen sich im Ordner config befinden.
| Arbeitslast | Datenquelle | Verzeichnispfad |
| Operativ | SAP ECC | src/SAP/SAP_REPORTING/config/ecc |
| SAP S/4 HANA | src/SAP/SAP_REPORTING/config/s4 |
|
| Salesforce Sales Cloud (SFDC) | src/SFDC/config
|
|
| Oracle EBS | src/OracleEBS/config
|
|
| Marketing | CM360 | src/marketing/src/CM360/config |
| Google Ads | src/marketing/src/GoogleAds/config
|
|
| Meta | src/marketing/src/Meta/config
|
|
| Salesforce Marketing Cloud (SFMC) | src/marketing/src/SFMC/config
|
|
| TikTok | src/marketing/src/TikTok/config
|
|
| YouTube (mit DV360) | src/marketing/src/DV360/config
|
|
| Google Analytics 4 | src/marketing/src/GA4/config
|
Metadatenressourcen werden auf Datenquellenebene mit einer einzelnen YAML-Datei pro Google Cloud -Projekt definiert und enthalten eine Liste aller Ressourcen. Nutzer können die vorhandene Datei erweitern oder bei Bedarf zusätzliche YAML-Dateien mit zusätzlichen Ressourcenspezifikationen in diesem Verzeichnis erstellen.
Asset-Annotationen werden auf Asset-Ebene definiert und enthalten viele YAML-Dateien im Verzeichnis mit einer einzelnen Annotation pro Datei.
APIs aktivieren und Berechtigungen prüfen
Wenn Sie die Standardwerte für Data Mesh ändern, können Sie Funktionen implementieren, die über Beschreibungen hinausgehen. Wenn Sie die Standardwerte für Data Mesh in config.json ändern müssen, um Funktionen über Beschreibungen hinaus zu implementieren, müssen die erforderlichen APIs und Berechtigungen wie in der folgenden Tabelle beschrieben festgelegt sein.
Wenn Sie Data Mesh mit der Datengrundlage bereitstellen, müssen Sie dem bereitstellenden Nutzer oder dem Cloud Build-Konto Berechtigungen gewähren. Wenn die Bereitstellung unterschiedliche Quell- und Zielprojekte umfasst, müssen diese APIs und Berechtigungen in beiden Projekten aktiviert sein, wo immer diese Funktionen verwendet werden.
| Feature | Berechtigungsrollen | Dokumentation |
| Zugriff auf BigQuery-Assets und -Zeilen | BigQuery-Dateninhaber | Weitere Informationen finden Sie unter Erforderliche Rollen für die Asset-Rollen und unter Erforderliche Berechtigungen für Zeilenrollen. |
| BigQuery-Spaltenzugriff | Richtlinien-Tag-Administrator | Weitere Informationen finden Sie in der Dokumentation zu Rollen, die mit Zugriffssteuerung auf Spaltenebene verwendet werden und Zugriff mit Zugriffssteuerung auf Spaltenebene beschränken. |
| Katalog-Tags | Data Catalog-Tag-Vorlagen-Inhaber | Weitere Informationen finden Sie in der Dokumentation unter BigQuery-Tabelle mithilfe von Data Catalog taggen und Data Catalog-IAM. |
| Knowledge Catalog-Lakes | Dataplex-Bearbeiter | Weitere Informationen finden Sie in der Dokumentation unter Lake erstellen. |
Spezifikationen der Basisressource
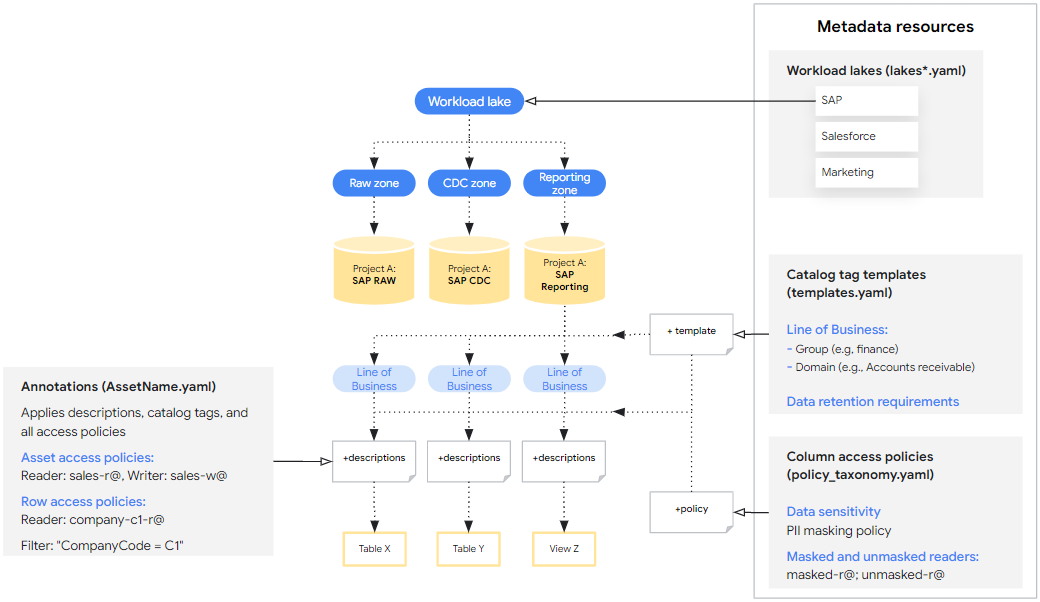
Die primäre Schnittstelle zum Konfigurieren des Data Mesh für Cortex sind die Basisressourcenspezifikationen. Dies sind eine Reihe von standardmäßig bereitgestellten YAML-Dateien, die die bereitgestellten Metadatenressourcen und Annotationen definieren. Die Basisspezifikationen enthalten erste Empfehlungen und Syntaxbeispiele, sind aber so konzipiert, dass sie an die Anforderungen der Nutzer angepasst werden können. Diese Spezifikationen fallen in zwei Kategorien:
- Metadatenressourcen, die auf verschiedene Daten-Assets angewendet werden können. Beispiel: Katalog-Tag-Vorlagen, die definieren, wie Assets mit Geschäftsdomains getaggt werden können.
- Annotationen, die angeben, wie die Metadatenressourcen auf ein bestimmtes Daten-Asset angewendet werden. Beispiel: Ein Katalog-Tag, das eine bestimmte Tabelle mit der Domain „Sales“ verknüpft.
In den folgenden Abschnitten finden Sie einfache Beispiele für die einzelnen Spezifikationstypen und Erläuterungen dazu, wie Sie sie anpassen können. Die Basisspezifikationen sind mit ## CORTEX-CUSTOMER gekennzeichnet, wenn sie für eine Bereitstellung geändert werden müssen, wenn die zugehörige Bereitstellungsoption aktiviert ist.
Informationen zu erweiterten Anwendungen finden Sie in der kanonischen Definition dieser Spezifikationsschemas in src/common/data_mesh/src/data_mesh_types.py.
Metadaten-Ressourcen
Die Metadatenressourcen sind freigegebene Entitäten, die in einem Projekt vorhanden sind und auf viele Daten-Assets angewendet werden können. Die meisten Spezifikationen enthalten ein display_name-Feld, das den folgenden Kriterien unterliegt:
- Darf nur Unicode-Buchstaben, Ziffern (0–9), Unterstriche (_), Bindestriche (-) und Leerzeichen ( ) enthalten.
- Darf nicht mit Leerzeichen beginnen oder enden.
- Maximale Länge: 200 Zeichen.
In einigen Fällen wird die display_name auch als ID verwendet, was zusätzliche Anforderungen mit sich bringen kann. In diesen Fällen sind Links zur kanonischen Dokumentation enthalten.
Wenn die Bereitstellung auf Metadatenressourcen in verschiedenen Quell- und Zielprojekten verweist, muss für jedes Projekt eine Spezifikation definiert werden. Cortex Salesforce (SFDC) enthält beispielsweise zwei Lake-Spezifikationen. Eines für die Roh- und CDC-Zonen und eines für die Berichterstellung.
Knowledge Catalog-Lakes
Knowledge Catalog-Lakes, ‑Zonen und ‑Assets werden verwendet, um die Daten aus technischer Sicht zu organisieren. Lakes haben einen region und Zonen einen location_type. Beide hängen mit dem Cortex-Standort (config.json > location) zusammen. Der Cortex-Standort definiert, wo die BigQuery-Datasets gespeichert werden, und kann eine einzelne Region oder eine Multiregion sein. Die Zone location_type sollte auf SINGLE_REGION | MULTI_REGION festgelegt werden, damit sie übereinstimmt.
Lake-Regionen müssen jedoch immer eine einzelne Region sein. Wenn der Cortex-Standort und die Zone location_type multiregional sind, wählen Sie eine einzelne Region innerhalb dieser Gruppe für die Lake-Region aus.
- Anforderungen
- Der Lake
display_namewird alslake_idverwendet und muss den offiziellen Anforderungen entsprechen. Das gilt auch für die Zone und das Assetdisplay_name. Zonen-IDs müssen für alle Lakes im Projekt eindeutig sein. - Lake-Spezifikationen müssen mit einer einzelnen Region verknüpft sein.
- Die
asset_namesollte mit der ID des BigQuery-Datasets übereinstimmen, aber diedisplay_namekann ein nutzerfreundlicheres Label sein.
- Der Lake
- Einschränkungen
- Knowledge Catalog unterstützt nur die Registrierung von BigQuery-Datasets als Knowledge Catalog-Assets, nicht von einzelnen Tabellen.
- Ein Asset kann nur in einer einzigen Zone registriert werden.
- Knowledge Catalog wird nur an bestimmten Standorten unterstützt. Weitere Informationen finden Sie unter Knowledge Catalog-Standorte.
Sehen Sie sich das folgende Beispiel in lakes.yaml an.
Diese Ressourcen werden in YAML-Dateien definiert, die data_mesh_types.Lakes angeben.
Katalog-Tag-Vorlagen
Mit Data Catalog-Tag-Vorlagen können Sie BigQuery-Tabellen oder einzelnen Spalten Kontext hinzufügen. Sie helfen Ihnen, Ihre Daten sowohl aus technischer als auch aus geschäftlicher Sicht zu kategorisieren und zu verstehen, und sind in die Suchtools von Knowledge Catalog eingebunden. Sie definieren die spezifischen Felder, die Sie zum Labeln Ihrer Daten verwenden können, und den Typ der Informationen, die jedes Feld enthalten kann (z. B. Text, Zahl, Datum). Katalog-Tags sind Instanzen der Vorlagen mit tatsächlichen Feldwerten.
Das Vorlagenfeld display_name wird als Feld-ID verwendet und muss die Anforderungen für TagTemplate.fields erfüllen, die in Klasse TagTemplate angegeben sind.
Weitere Informationen zu unterstützten Feldtypen finden Sie unter Data Catalog-Feldtypen.
Cortex Data Mesh erstellt alle Tag-Vorlagen als öffentlich lesbar. Außerdem wird ein zusätzliches level-Konzept für Tag-Vorlagenspezifikationen eingeführt, das definiert, ob ein Tag auf ein gesamtes Asset, einzelne Felder innerhalb eines Assets oder beides angewendet werden soll. Mögliche Werte: ASSET | FIELD | ANY. Dies wird derzeit nicht strikt erzwungen, aber zukünftige Validierungsprüfungen könnten sicherstellen, dass Tags während der Bereitstellung auf der entsprechenden Ebene angewendet werden.
Sehen Sie sich das folgende Beispiel an.
Vorlagen werden in YAML-Dateien definiert, die data_mesh_types.CatalogTagTemplates angeben.
Katalog-Tags sind Instanzen der Vorlagen und werden unten im Abschnitt „Asset-Annotationen“ erläutert.
Zugriffssteuerung auf Asset- und Spaltenebene mit Tag-Vorlagen
Mit Cortex Framework können Sie die Zugriffssteuerung auf Asset- oder Spaltenebene für alle Artefakte aktivieren, die mit einer Katalog-Tag-Vorlage verknüpft sind.
Wenn Nutzer beispielsweise Zugriff auf Assets basierend auf dem Geschäftsbereich gewähren möchten, können sie asset_policies für die Katalog-Tag-Vorlage line_of_business erstellen, wobei für jede Geschäftsdomain unterschiedliche Hauptkonten angegeben sind.
Jede Richtlinie akzeptiert filters, mit denen nur Tags mit bestimmten Werten abgeglichen werden können. In diesem Fall könnten wir die domain-Werte abgleichen. Beachten Sie, dass diese filters nur den Abgleich auf Gleichheit und keine anderen Operatoren unterstützen. Wenn mehrere Filter aufgeführt sind, müssen die Ergebnisse alle Filter erfüllen (z. B. filter_a AND filter_b). Die endgültigen Asset-Richtlinien sind die Vereinigung der Richtlinien, die direkt in den Annotationen definiert sind, und der Richtlinien aus den Vorlagenrichtlinien.
Die Zugriffssteuerung auf Spaltenebene mit Katalog-Tags verhält sich ähnlich, da Richtlinien-Tags auf übereinstimmende Felder angewendet werden. Da jedoch nur ein Richtlinien-Tag auf eine Spalte angewendet werden kann, gilt folgende Rangfolge:
- Direktes Richtlinien-Tag: Wenn ein Richtlinien-Tag direkt in der Spaltenannotation definiert ist, hat es Priorität.
- Abgleichsrichtlinie für Tag-Vorlagen: Andernfalls wird der Zugriff durch die erste übereinstimmende Richtlinie bestimmt, die für ein Feld in der zugehörigen Katalog-Tag-Vorlage definiert ist.
Wenn Sie diese Funktion verwenden, empfehlen wir dringend, die Bereitstellung von Katalog-Tags und Access Control Lists (ACLs) gemeinsam zu aktivieren oder zu deaktivieren. So wird sichergestellt, dass die ACLs ordnungsgemäß bereitgestellt werden.
Informationen zu den Spezifikationen für diese erweiterte Funktion finden Sie in den Definitionen der Parameter asset_policies und field_policies in data_mesh_types.CatalogTagTemplate.
Katalogglossar
Das Glossar ist ein Tool, mit dem Sie ein Wörterbuch mit Begriffen bereitstellen können, die in bestimmten Spalten in Daten-Assets verwendet werden und möglicherweise nicht allgemein verständlich sind. Nutzer können Begriffe manuell in der Console hinzufügen, aber es gibt keine Unterstützung durch die Ressourcenspezifikationen.
Richtlinientaxonomien und ‑tags
Richtlinientaxonomien und ‑tags ermöglichen eine standardisierte Zugriffssteuerung auf Spaltenebene für vertrauliche Datenressourcen. Beispielsweise könnte es eine Taxonomie für Tags geben, die personenidentifizierbare Informationen in einer bestimmten Line of Business steuern, wobei nur bestimmte Gruppen maskierte Daten, unmaskierte Daten oder gar keinen Lesezugriff haben.
Weitere Informationen zu Richtlinientaxonomien und Tags finden Sie in der Dokumentation Einführung in die Datenmaskierung für Spalten. Die folgenden Abschnitte sind besonders relevant:
- Rollen interagieren
- Übernahme von Autorisierungen
- Maskierungsregeln und Hierarchie
- Best Practices für Richtlinien-Tags
Cortex Framework bietet Beispiel-Richtlinien-Tags, um zu zeigen, wie sie angegeben werden, und potenzielle Verwendungsmöglichkeiten. Ressourcen, die sich auf die Zugriffssteuerung auswirken, sind jedoch in der Data Mesh-Bereitstellung standardmäßig nicht aktiviert.
Sehen Sie sich das folgende Beispiel an.
Richtlinientaxonomien werden in YAML-Dateien definiert, die data_mesh_types.PolicyTaxonomies angeben.
Asset-Annotationen
Mit Annotationen werden Metadaten für ein bestimmtes Asset angegeben. Sie können auf die definierten freigegebenen Metadatenressourcen verweisen. Anmerkungen umfassen:
- Asset-Beschreibungen
- Feldbeschreibungen
- Katalog-Tags
- Zugriffssteuerung auf Asset-, Zeilen- und Spaltenebene
Die Cortex Framework Data Foundation bietet vorkonfigurierte Annotationen (Beschreibungen) für die folgenden Arbeitslasten.
- SAP ECC (Rohdaten, CDC und Berichterstellung)
- SAP S4 HANA (Rohdaten, CDC und Berichterstellung)
- SFDC (nur Berichterstellung)
- Oracle EBS (nur Berichterstellung)
- CM360 (nur Berichterstellung)
- Google Ads (nur Berichterstellung)
- Meta (nur Berichterstellung)
- SFMC (nur Berichterstellung)
- TikTok (nur Berichterstellung)
- YouTube (mit DV360) (nur Berichterstellung)
- Google Analytics 4 (nur Berichterstellung)
Sehen Sie sich das folgende Beispiel an.
Annotationen werden in YAML-Dateien definiert, die data_mesh_types.BqAssetAnnotation angeben.
Katalog-Tags
Katalog-Tags sind Instanzen der definierten Vorlagen, denen Feldwerte zugewiesen sind, die für das jeweilige Asset gelten. Achten Sie darauf, dass Sie Werte zuweisen, die den in der zugehörigen Vorlage deklarierten Feldtypen entsprechen.
TIMESTAMP-Werte müssen in einem der folgenden Formate vorliegen:
  "%Y-%m-%d %H:%M:%S%z"
  "%Y-%m-%d %H:%M:%S"
  "%Y-%m-%d"
Sehen Sie sich das folgende Beispiel an.
Siehe Spezifikationsdefinition in data_mesh_types.CatalogTag.
Leser und Hauptkonten für Zugriffsrichtlinien angeben
Zugriff auf Ihre BigQuery-Daten im Cortex Framework mithilfe von Zugriffsrichtlinien steuern Diese Richtlinien legen fest, wer (Hauptkonten) auf bestimmte Daten-Assets, Zeilen innerhalb eines Assets oder sogar einzelne Spalten zugreifen kann. Hauptkonten müssen einem bestimmten Format entsprechen, das durch das Mitglied der IAM-Richtlinienbindung definiert wird.
Zugriff auf Asset-Ebene
Sie können Zugriff auf gesamte BigQuery-Assets mit verschiedenen Berechtigungen gewähren:
READER: Daten im Asset ansehen.WRITER: Daten im Asset ändern und hinzufügen.OWNER: Vollständige Kontrolle über das Asset, einschließlich der Zugriffsverwaltung.
Diese Berechtigungen entsprechen der GRANT DCL-Anweisung in SQL.
Im Gegensatz zum Verhalten bei den meisten Ressourcen und Annotationen werden vorhandene Hauptkonten mit der Rolle OWNERS durch das Überschreibungs-Flag nicht entfernt.
Wenn Sie neue Inhaber hinzufügen und das Überschreiben aktiviert ist, werden sie nur an die vorhandenen Inhaber angehängt. Dies ist eine Sicherheitsmaßnahme, um einen unbeabsichtigten Verlust des Zugriffs zu verhindern.
Verwenden Sie die Console, um Asset-Inhaber zu entfernen. Durch das Überschreiben werden vorhandene Hauptkonten mit der Rolle READER oder WRITER entfernt.
Sehen Sie sich das folgende Beispiel an.
Siehe Spezifikationsdefinition in data_mesh_types.BqAssetPolicy.
Zugriff auf Zeilenebene
Sie können Zugriff auf Zeilensätze basierend auf bestimmten Spaltenwertfiltern gewähren.
Wenn Sie die Zugriffsrichtlinie für Zeilen angeben, wird der angegebene Filterstring in eine CREATE DDL statement eingefügt. Wenn das Flag overwrite aktiviert ist, werden alle vorhandenen Zeilenzugriffsrichtlinien gelöscht, bevor neue angewendet werden.
Beachten Sie Folgendes beim Zugriff auf Zeilenebene:
- Wenn Sie Zeilenzugriffsrichtlinien hinzufügen, haben Nutzer, die nicht in diesen Richtlinien angegeben sind, keinen Zugriff auf Zeilen.
- Zeilenrichtlinien funktionieren nur mit Tabellen, nicht mit Ansichten.
- Vermeiden Sie die Verwendung von partitionierten Spalten in den Filtern Ihrer Zeilenzugriffsrichtlinien. Informationen zum Asset-Typ und zu den partitionierten Spalten finden Sie in der zugehörigen YAML-Datei mit den Berichtseinstellungen.
Weitere Informationen zu Zugriffsrichtlinien auf Zeilenebene finden Sie unter Best Practices für die Sicherheit auf Zeilenebene.
Sehen Sie sich das folgende Beispiel an.
Siehe Spezifikationsdefinition in data_mesh_types.BqRowPolicy.
Zugriff auf Spaltenebene
Wenn Sie den Zugriff auf Spaltenebene aktivieren möchten, versehen Sie einzelne Felder mit einem Richtlinien-Tag, das durch den Namen des Richtlinien-Tags und den Taxonomienamen identifiziert wird. Aktualisieren Sie die Metadatenressource des Richtlinien-Tags, um die Zugriffssteuerung zu konfigurieren.
Sehen Sie sich das folgende Beispiel an.
Siehe Spezifikationsdefinition in data_mesh_types.PolicyTagId.
Data Mesh bereitstellen
Das Data Mesh kann entweder als Teil der Data Foundation-Bereitstellung oder eigenständig bereitgestellt werden. In beiden Fällen wird die Cortex-Datei config.json verwendet, um relevante Variablen wie BigQuery-Dataset-Namen und Bereitstellungsoptionen zu bestimmen. Standardmäßig werden beim Bereitstellen des Data Mesh keine vorhandenen Ressourcen oder Annotationen entfernt oder überschrieben, um unbeabsichtigte Verluste zu vermeiden. Es besteht jedoch auch die Möglichkeit, vorhandene Ressourcen zu überschreiben, wenn sie eigenständig bereitgestellt werden.
Bereitstellungsoptionen
Die folgenden Bereitstellungsoptionen können je nach den Anforderungen und Ausgabenbeschränkungen des Nutzers unter config.json > DataMesh aktiviert oder deaktiviert werden.
| Option | Hinweise |
deployDescriptions
|
Dies ist die einzige standardmäßig aktivierte Option. Sie stellt BigQuery-Annotationen mit Asset- und Spaltenbeschreibungen bereit. Es ist nicht erforderlich, zusätzliche APIs oder Berechtigungen zu aktivieren. |
deployLakes
|
Stellt Lakes und Zonen bereit. |
deployCatalog
|
Stellt Katalogvorlagenressourcen und die zugehörigen Tags in Asset-Annotationen bereit. |
deployACLs
|
Stellt Richtlinien-Taxonomieressourcen und Zugriffssteuerungsrichtlinien auf Asset-, Zeilen- und Spaltenebene über Asset-Annotationen bereit. Die Logs enthalten Meldungen, die angeben, wie sich die Zugriffsrichtlinien geändert haben. |
Mit der Data Foundation bereitstellen
Standardmäßig wird mit config.json > deployDataMesh die Bereitstellung der Data Mesh-Asset-Beschreibungen am Ende jedes Arbeitslast-Build-Schritts aktiviert. Für diese Standardkonfiguration müssen keine zusätzlichen APIs oder Rollen aktiviert werden.
Zusätzliche Funktionen des Data Mesh können mit der Datengrundlage bereitgestellt werden. Dazu müssen Sie die Bereitstellungsoptionen, die erforderlichen APIs und Rollen aktivieren und die zugehörigen Ressourcenspezifikationen ändern.
Alleinige Bereitstellung
Wenn Nutzer nur das Data Mesh bereitstellen möchten, können sie die Datei common/data_mesh/deploy_data_mesh.py verwenden. Dieses Dienstprogramm wird während der Build-Prozesse verwendet, um das Data Mesh für jeweils eine Arbeitslast bereitzustellen. Wenn es direkt aufgerufen wird, kann es aber auch verwendet werden, um mehrere Arbeitslasten gleichzeitig bereitzustellen. Die Arbeitslasten für die zu implementierenden Spezifikationen sollten in der Datei config.json aktiviert sein. Achten Sie beispielsweise darauf, dass deploySAP=true, wenn Sie das Data Mesh für SAP bereitstellen.
Damit Sie die erforderlichen Pakete und Versionen bereitstellen, können Sie das Dienstprogramm mit den folgenden Befehlen über dasselbe Image ausführen, das auch vom Cortex-Bereitstellungsprozess verwendet wird:
  # Run container interactively
  docker container run -it gcr.io/kittycorn-public/deploy-kittycorn:v2.0

  # Clone the repo
  git clone https://github.com/GoogleCloudPlatform/cortex-data-foundation

  # Navigate into the repo
  cd cortex-data-foundation
Wenn Sie Hilfe zu den verfügbaren Parametern und ihrer Verwendung benötigen, führen Sie den folgenden Befehl aus:
python src/common/data_mesh/deploy_data_mesh.py -h
Hier ein Beispiel für den Aufruf für SAP ECC:
  python src/common/data_mesh/deploy_data_mesh.py \
    --config-file config/config.json \
    --lake-directories \
        src/SAP/SAP_REPORTING/config/ecc/lakes \
    --tag-template-directories \
        src/SAP/SAP_REPORTING/config/ecc/tag_templates \
    --policy-directories \
        src/SAP/SAP_REPORTING/config/ecc/policy_taxonomies \
    --annotation-directories \
        src/SAP/SAP_REPORTING/config/ecc/annotations
Informationen zu Verzeichnisspeicherorten finden Sie im Abschnitt Data Mesh-Verzeichnisse.
Überschreiben
Standardmäßig werden durch die Bereitstellung von Data Mesh keine vorhandenen Ressourcen oder Annotationen überschrieben. Das Flag --overwrite kann jedoch aktiviert werden, wenn nur das Data Mesh bereitgestellt wird, um die Bereitstellung folgendermaßen zu ändern.
Beim Überschreiben von Metadatenressourcen wie Lakes, Katalog-Tag-Vorlagen und Richtlinien-Tags werden alle vorhandenen Ressourcen mit denselben Namen gelöscht. Vorhandene Ressourcen mit anderen Namen werden jedoch nicht geändert. Wenn eine Ressourcenspezifikation vollständig aus der YAML-Datei entfernt und das Data Mesh dann mit aktivierter Überschreibung neu bereitgestellt wird, wird diese Ressourcenspezifikation nicht gelöscht, da es keine Namenskollision gibt. So wird verhindert, dass sich die Cortex Data Mesh-Bereitstellung auf vorhandene Ressourcen auswirkt, die möglicherweise verwendet werden.
Bei verschachtelten Ressourcen wie Lakes und Zonen werden durch das Überschreiben einer Ressource alle untergeordneten Ressourcen entfernt. Wenn Sie beispielsweise einen Lake überschreiben, werden auch die vorhandenen Zonen und Asset-Referenzen entfernt. Bei Katalog-Tag-Vorlagen und Richtlinien-Tags, die überschrieben werden, werden die vorhandenen zugehörigen Annotationsverweise ebenfalls aus den Assets entfernt. Wenn Sie Katalog-Tags in einer Asset-Annotation überschreiben, werden nur vorhandene Instanzen von Katalog-Tags überschrieben, die dieselbe Vorlage verwenden.
Überschreibungen von Asset- und Feldbeschreibungen werden nur wirksam, wenn eine gültige, nicht leere neue Beschreibung angegeben wird, die mit der vorhandenen Beschreibung in Konflikt steht.
ACLs verhalten sich dagegen anders. Beim Überschreiben von ACLs werden alle vorhandenen Hauptkonten entfernt (mit Ausnahme der Inhaber auf Asset-Ebene). Das liegt daran, dass die Hauptkonten, die von Zugriffsrichtlinien ausgeschlossen werden, genauso wichtig sind wie die Hauptkonten, denen Zugriff gewährt wird.
Data Mesh kennenlernen
Nach der Bereitstellung des Data Mesh können Nutzer mit Data Catalog nach den Datenassets suchen und sie ansehen. Dazu gehört die Möglichkeit, Assets anhand der angewendeten Katalog-Tag-Werte zu finden. Nutzer können bei Bedarf auch manuell Katalogglossarbegriffe erstellen und anwenden.
Bereitgestellte Zugriffsrichtlinien können auf der BigQuery-Schemaseite aufgerufen werden, um die Richtlinien zu sehen, die auf ein bestimmtes Asset auf jeder Ebene angewendet werden.
Data Lineage
Nutzer können die Herkunft zwischen BigQuery-Assets aktivieren und visualisieren. Auf die Herkunft kann auch programmatisch über die API zugegriffen werden. Die Datenherkunft unterstützt nur die Herkunft auf Asset-Ebene. Die Datenherkunft ist nicht mit dem Cortex Data Mesh verknüpft. In Zukunft werden jedoch möglicherweise neue Funktionen eingeführt, die die Datenherkunft nutzen.
Anfragen zu Cortex Data Mesh oder Cortex Framework können Sie im Abschnitt Support stellen.