


(יצא משימוש) מדריך למשתמש ב-Data Mesh
רשת הנתונים של Cortex Framework מרחיבה את בסיס הנתונים כדי לאפשר משילות מידע (data governance), יכולת גילוי ובקרת גישה באמצעות המטא-נתונים של BigQuery ו-Knowledge Catalog. כדי לעשות את זה, צריך לספק קבוצה בסיסית של משאבי מטא-נתונים והערות לנכסים ב-BigQuery, שאפשר להתאים אישית ואולי גם לפרוס לצד בסיס הנתונים. המפרטים הבסיסיים האלה מספקים הגדרה מותאמת אישית, שהיא הבסיס למטא-נתונים שמשלימים את Cortex Framework Data Foundation. לפני שתמשיכו במדריך הזה, כדאי לעיין במושגים של רשת נתונים.
השלבים שמפורטים בדף הזה מיועדים במיוחד להגדרת Data Mesh ל-Cortex Framework. מאתרים את קובצי התצורה של הנתונים המבוזרים בתיקיות הספציפיות לכל עומס עבודה בקטע של ספריות הנתונים המבוזרים.

עיצוב
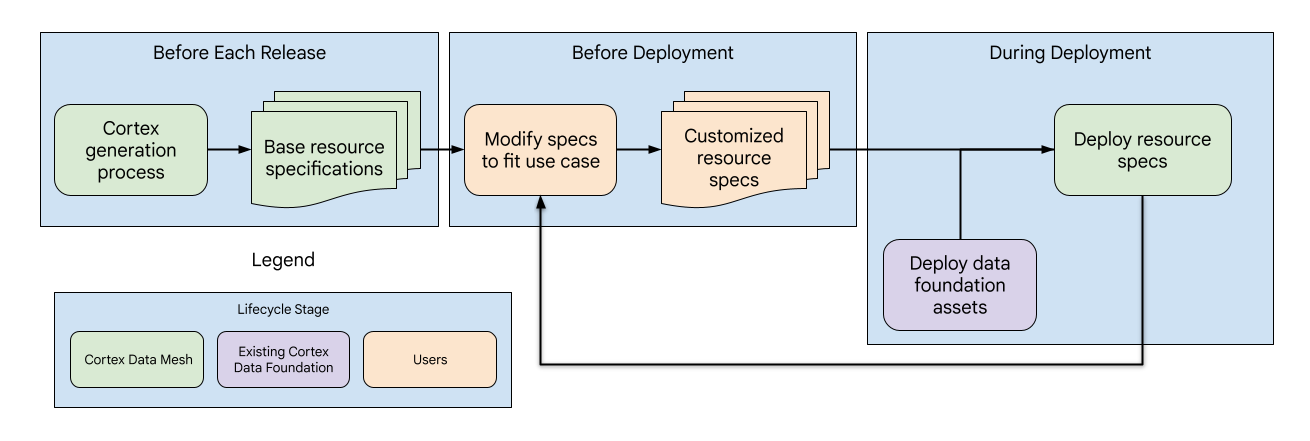
Data Mesh של Cortex מתוכנן באופן דומה לתשתית הנתונים הכוללת, והוא מורכב משלושה שלבים עם רכיבי משנה שונים שמנוהלים על ידי Cortex או על ידי המשתמשים:
- עדכון מפרטי המשאבים הבסיסיים: בכל גרסה, Cortex מעדכן את מפרטי המשאבים הבסיסיים, ומספק בסיס מטא-נתונים סטנדרטי ל-Data Mesh.
- התאמה אישית של מפרטי המשאבים: לפני הפריסה, המשתמשים יכולים להתאים את מפרטי המשאבים לתרחישי השימוש ולדרישות הספציפיים שלהם.
- פריסה ועדכונים של רשת הנתונים: המשתמשים יכולים להפעיל את רשת הנתונים בקובץ התצורה של Cortex. הוא נפרס אחרי נכסי הנתונים במהלך הפריסה של Cortex. בנוסף, המשתמשים יכולים לפרוס את הנתונים המבוזרים באופן עצמאי כדי לבצע עדכונים נוספים.
ספריות של נתונים מבוזרים
קובצי התצורה הבסיסיים של Data Mesh לכל עומס עבודה ומקור נתונים נמצאים במיקומים הבאים. שימו לב שהספריות מכילות מבנה קבצים שונה, אבל כל המפרטים נמצאים במיקום דומה בתיקייה config.
| עומס עבודה | מקור נתונים | נתיב הספרייה |
| תפעולי | SAP ECC | src/SAP/SAP_REPORTING/config/ecc |
| SAP S/4 HANA | src/SAP/SAP_REPORTING/config/s4 |
|
| Salesforce Sales Cloud (SFDC) | src/SFDC/config
|
|
| Oracle EBS | src/OracleEBS/config
|
|
| שיווק | CM360 | src/marketing/src/CM360/config |
| Google Ads | src/marketing/src/GoogleAds/config
|
|
| Meta | src/marketing/src/Meta/config
|
|
| Salesforce Marketing Cloud (SFMC) | src/marketing/src/SFMC/config
|
|
| טיקטוק | src/marketing/src/TikTok/config
|
|
| YouTube (עם DV360) | src/marketing/src/DV360/config
|
|
| Google Analytics 4 | src/marketing/src/GA4/config
|
משאבי מטא-נתונים מוגדרים ברמת מקור הנתונים באמצעות קובץ YAML אחד לכל פרויקט ב- Google Cloud , והם מכילים רשימה של כל המשאבים. המשתמשים יכולים להרחיב את הקובץ הקיים או ליצור קובצי YAML נוספים שמכילים מפרטי משאבים נוספים בספרייה הזו, לפי הצורך.
הערות לנכסים מוגדרות ברמת הנכס ומכילות הרבה קובצי YAML בספרייה, עם הערה אחת לכל קובץ.
הפעלת ממשקי API ואימות הרשאות
שינוי ערכי ברירת המחדל של נתונים מבוזרים מאפשר להטמיע תכונות מעבר לתיאורים. אם אתם צריכים לשנות את ערכי ברירת המחדל של רשת הנתונים ב-config.json כדי להטמיע תכונות מעבר לתיאורים, ודאו שממשקי ה-API הנדרשים מופעלים ושההרשאות מוגדרות כמו שמתואר בטבלה הבאה.
כשפורסים את נתונים מבוזרים עם בסיס הנתונים, צריך לתת הרשאות למשתמש שפורס או לחשבון Cloud Build. אם הפריסה כוללת פרויקטים שונים של מקור ויעד, ודאו שממשקי ה-API וההרשאות האלה מופעלים בשני הפרויקטים בכל מקום שבו נעשה שימוש בתכונות האלה.
| התכונה | תפקידים עם הרשאות | מסמכי תיעוד |
| גישה לנכסים ולשורות ב-BigQuery | בעלי הנתונים ב-BigQuery | למידע נוסף, קראו על התפקידים הנדרשים לתפקידי נכסים ועל ההרשאות הנדרשות לתפקידי שורות. |
| גישה לעמודות ב-BigQuery | אדמין של תגי מדיניות | מידע נוסף זמין במאמרים תפקידים שמשמשים לבקרת גישה ברמת העמודה והגבלת הגישה באמצעות בקרת גישה ברמת העמודה. |
| תגי קטלוג | הבעלים של TagTemplate ב-Data Catalog | למידע נוסף, קראו את המאמרים תיוג טבלה ב-BigQuery באמצעות Data Catalog וIAM ב-Data Catalog. |
| Knowledge Catalog Lakes | עריכה ב-Dataplex | מידע נוסף זמין במאמר יצירת אגם. |
הסבר על המפרטים של משאבי הבסיס
הממשק הראשי להגדרת רשת הנתונים של Cortex הוא באמצעות מפרטי המשאבים הבסיסיים, שהם קבוצה של קובצי YAML שמוגדרים מראש ומגדירים את משאבי המטא-נתונים וההערות שנפרסו. המפרטים הבסיסיים מספקים המלצות ראשוניות ודוגמאות לתחביר, אבל הם מיועדים להתאמה אישית נוספת בהתאם לצורכי המשתמשים. המפרטים האלה מתחלקים לשתי קטגוריות:
- משאבי מטא-נתונים שאפשר להחיל על נכסי נתונים שונים. לדוגמה, תבניות של תגי קטלוג שמגדירות איך אפשר לתייג נכסים באמצעות דומיינים עסקיים.
- הערות שמציינות איך משאבי המטא-נתונים חלים על נכס נתונים מסוים. לדוגמה, תג קטלוג שמשייך טבלה ספציפית לדומיין Sales.
בקטעים הבאים מופיעות דוגמאות בסיסיות לכל סוג של מפרט, ומוסבר איך להתאים אותם אישית. המפרטים הבסיסיים מתויגים ב-## CORTEX-CUSTOMER, וצריך לשנות אותם כך שיתאימו לפריסה אם אפשרות הפריסה המשויכת מופעלת.
לשימושים מתקדמים, עיינו בהגדרה הקנונית של הסכימות האלה ב-src/common/data_mesh/src/data_mesh_types.py.
משאבי מטא-נתונים
משאבי המטא-נתונים הם ישויות משותפות שקיימות בתוך פרויקט, ואפשר להחיל אותם על נכסי נתונים רבים. רוב המפרטים כוללים את השדה display_name, בכפוף לקריטריונים הבאים:
- מכיל רק אותיות, מספרים (0-9), קווים תחתונים (_), מקפים (-) ורווחים ( ) בתקן Unicode.
- לא יכול להתחיל או להסתיים ברווחים.
- האורך המקסימלי הוא 200 תווים.
במקרים מסוימים, display_name משמש גם כמזהה, מה שעשוי להוסיף דרישות. במקרים כאלה, כללנו קישורים למסמכי התיעוד הקנוניים.
אם הפריסה מפנה למשאבי מטא-נתונים בפרויקטים שונים של מקור ויעד, צריך להגדיר מפרט לכל פרויקט. לדוגמה, Cortex Salesforce (SFDC) מכיל שני מפרטי Lake. אחד לאזורי הנתונים הגולמיים ו-CDC, ואחד לדיווח.
Knowledge Catalog Lakes
האגמים, האזורים והנכסים של Knowledge Catalog משמשים לארגון הנתונים מנקודת מבט הנדסית. לאגמים יש region ולאזורים יש location_type, שניהם קשורים למיקום של Cortex (config.json > location). המיקום של Cortex מגדיר איפה מאוחסנים מערכי הנתונים של BigQuery, והוא יכול להיות אזור יחיד או כמה אזורים. כדי להתאים לאזור, צריך להגדיר את האזור location_type ל-SINGLE_REGION | MULTI_REGION.
עם זאת, אזורי Lake חייבים תמיד להיות אזור יחיד. אם המיקום והאזור location_type של Cortex הם בכמה אזורים, בוחרים אזור אחד בתוך הקבוצה הזו לאזור של Lake.
- דרישות
- האגם
display_nameמשמש כ-lake_idוחייב לעמוד בדרישות הרשמיות. זה נכון גם לגבי האזור והנכסdisplay_name. מזהי האזורים חייבים להיות ייחודיים בכל ה-Lakes בפרויקט. - המפרטים של Lake חייבים להיות משויכים לאזור אחד.
- הערך
asset_nameצריך להתאים למזהה של מערך הנתונים ב-BigQuery, אבל הערךdisplay_nameיכול להיות תווית ידידותית יותר למשתמש.
- האגם
- מגבלות
- ב-Knowledge Catalog אפשר לרשום רק מערכי נתונים של BigQuery, ולא טבלאות נפרדות, כנכסים של Knowledge Catalog.
- אפשר לרשום נכס רק באזור אחד.
- Knowledge Catalog נתמך רק במיקומים מסוימים. מידע נוסף זמין במאמר מיקומי Knowledge Catalog.
דוגמה לכך מופיעה ב-lakes.yaml.
המשאבים האלה מוגדרים בקובצי YAML שמציינים את data_mesh_types.Lakes.
תבניות תגים בקטלוג
אפשר להשתמש בתבניות תגים של Data Catalog כדי להוסיף הקשר לטבלאות ב-BigQuery או לעמודות ספציפיות. הם עוזרים לכם לסווג את הנתונים ולהבין אותם מנקודת מבט טכנית ועסקית, באופן שמשולב עם כלי החיפוש של Knowledge Catalog. הם מגדירים את השדות הספציפיים שבהם אפשר להשתמש כדי לתייג את הנתונים, ואת סוג המידע שכל שדה יכול להכיל (לדוגמה, טקסט, מספר, תאריך). תגי קטלוג הם מופעים של התבניות עם ערכי שדות בפועל.
השדה display_name בתבנית משמש כמזהה השדה, והוא צריך לעמוד בדרישות של TagTemplate.fields שמפורטות ב-Class TagTemplate.
למידע נוסף על סוגי השדות הנתמכים, ראו סוגי השדות של Data Catalog.
ב-Cortex Data Mesh, כל תבניות התגים נוצרות כניתנות לקריאה באופן ציבורי. בנוסף, הוא מציג קונספט נוסף של level למפרטים של תבניות תגים, שמגדיר אם צריך להחיל תג על נכס שלם, על שדות ספציפיים בתוך נכס או על שניהם, עם הערכים האפשריים: ASSET | FIELD | ANY. למרות שזה לא נאכף באופן קפדני כרגע, בדיקות אימות עתידיות עשויות להבטיח שהתגים יוחלו ברמה המתאימה במהלך הפריסה.
התבניות מוגדרות בקובצי YAML שמציינים את data_mesh_types.CatalogTagTemplates.
תגי קטלוג הם מופעים של התבניות, והם מפורטים בהמשך בקטע "הערות לנכסים".
בקרת גישה ברמת הנכס והעמודה באמצעות תבניות תגים
ב-Cortex Framework אפשר להפעיל בקרת גישה ברמת הנכס או העמודה בכל פריטי המידע שמשויכים לתבנית תג קטלוג.
לדוגמה, אם המשתמשים רוצים לתת גישה לנכסים על סמך הענף הכלכלי (LOB), הם יכולים ליצור asset_policies לתבנית התג line_of_business Catalog, עם חשבונות משתמשים שונים שצוינו לכל דומיין עסקי.
כל מדיניות מקבלת filters שאפשר להשתמש בהם כדי להתאים רק תגים עם ערכים ספציפיים. במקרה הזה, אנחנו יכולים להתאים את הערכים של domain. שימו לב שהערכים של filters תומכים רק בהתאמה לשוויון ולא באופרטורים אחרים. אם מצוינים כמה מסננים, התוצאות צריכות לעמוד בכל המסננים (לדוגמה, filter_a AND filter_b). קבוצת כללי המדיניות הסופית של הנכס היא שילוב של כללי המדיניות שמוגדרים ישירות בהערות ושל כללי המדיניות מתבניות המדיניות.
בקרת גישה ברמת העמודה עם תגי קטלוג פועלת באופן דומה, על ידי החלת תגי מדיניות על שדות תואמים. עם זאת, מכיוון שאפשר להחיל רק תג מדיניות אחד על עמודה, סדר הקדימויות הוא:
- תג מדיניות ישיר: אם תג מדיניות מוגדר ישירות בהערה של העמודה, הוא מקבל עדיפות.
- מדיניות תבנית התגים התואמת: אחרת, הגישה נקבעת לפי המדיניות התואמת הראשונה שמוגדרת בשדה בתוך תבנית התגים המשויכת של Catalog.
כשמשתמשים בתכונה הזו, מומלץ מאוד להפעיל או להשבית את הפריסה של תגי קטלוג ורשימות של בקרת גישה (ACL) ביחד. כך אפשר לוודא שרשימות ה-ACL נפרסות בצורה תקינה.
כדי להבין את המפרט של התכונה המתקדמת הזו, עיינו בהגדרות של הפרמטרים asset_policies ו-field_policies במאמר data_mesh_types.CatalogTagTemplate.
מילון מונחים בנושא קטלוגים
מילון המונחים הוא כלי שמאפשר לספק מילון של מונחים שנעשה בהם שימוש בעמודות ספציפיות בנכסי נתונים, שאולי לא מובנים לכולם. המשתמשים יכולים להוסיף תנאים באופן ידני במסוף, אבל אין תמיכה דרך מפרטי המשאבים.
טקסונומיות ותגים של מדיניות
טקסונומיות ותגי מדיניות מאפשרים בקרת גישה ברמת העמודה לנכסים של מידע אישי רגיש, באופן סטנדרטי. לדוגמה, יכולה להיות טקסונומיה לתגים ששולטים בפרטים אישיים מזהים (PII) בענף כלכלי מסוים, שבה רק לקבוצות מסוימות יש גישת קריאה לנתונים מוסתרים, לנתונים לא מוסתרים או שאין להן גישת קריאה בכלל.
לפרטים נוספים על הטקסונומיות והתגים של המדיניות, קראו את ההסבר על הסתרת נתונים בעמודות. הקטעים הבאים רלוונטיים במיוחד:
ב-Cortex Framework יש תגי מדיניות לדוגמה שמראים איך מגדירים אותם ומה השימושים האפשריים, אבל משאבים שמשפיעים על בקרת הגישה לא מופעלים כברירת מחדל בפריסה של הנתונים המבוזרים.
טקסונומיות של מדיניות מוגדרות בקובצי YAML שמציינים את data_mesh_types.PolicyTaxonomies.
הערות לנכסים
הערות מציינות מטא-נתונים שרלוונטיים לנכס מסוים, ויכולות להפנות למשאבי המטא-נתונים המשותפים שהוגדרו. ההערות כוללות:
- תיאורי נכסים
- תיאורי השדות
- תגי קטלוג
- בקרת גישה ברמת הנכס, השורה והעמודה
Cortex Framework Data foundation מציע הערות (תיאורים) שהוגדרו מראש לעומסי העבודה הבאים.
- SAP ECC (נתונים גולמיים, CDC ודיווח)
- SAP S4 HANA (נתונים גולמיים, CDC ודיווח)
- SFDC (דוחות בלבד)
- Oracle EBS (דוחות בלבד)
- CM360 (דיווח בלבד)
- Google Ads (דיווח בלבד)
- Meta (דוחות בלבד)
- SFMC (דוחות בלבד)
- TikTok (דיווח בלבד)
- YouTube (עם DV360) (דיווח בלבד)
- Google Analytics 4 (דיווח בלבד)
ההערות מוגדרות בקובצי YAML שמציינים את data_mesh_types.BqAssetAnnotation.
תגי קטלוג
תגי קטלוג הם מופעים של התבניות שהוגדרו, שבהם מוקצים ערכי שדות שחלים על הנכס הספציפי. חשוב להקצות ערכים שתואמים לסוגי השדות שהוגדרו בתבנית המשויכת.
הערכים של TIMESTAMP צריכים להיות באחד מהפורמטים הבאים:
  "%Y-%m-%d %H:%M:%S%z"
  "%Y-%m-%d %H:%M:%S"
  "%Y-%m-%d"
הגדרת המפרט מופיעה במאמר data_mesh_types.CatalogTag.
הגדרת קוראים וחשבונות משתמשים במדיניות הגישה
לשלוט בגישה לנתוני BigQuery ב-Cortex Framework באמצעות כללי מדיניות גישה. כללי המדיניות האלה מגדירים מי (חשבונות משתמשים) יכול לגשת לנכסי נתונים ספציפיים, לשורות בתוך נכס או אפילו לעמודות ספציפיות. חשבונות משתמשים צריכים להיות בפורמט ספציפי שמוגדר על ידי חבר בקישור למדיניות IAM.
גישה ברמת הנכס
אתם יכולים לתת גישה לנכסים שלמים ב-BigQuery עם הרשאות שונות:
-
READER: צפייה בנתונים בנכס. WRITER: שינוי והוספה של נתונים לנכס.OWNER: שליטה מלאה בנכס, כולל ניהול הגישה.
ההרשאות האלה מקבילות להצהרה GRANT DCL ב-SQL.
בניגוד להתנהגות של רוב המשאבים וההערות, דגל ההחלפה לא מסיר חשבונות משתמשים קיימים עם התפקיד OWNERS.
כשמוסיפים בעלים חדשים עם האפשרות overwrite, הם רק מתווספים לבעלים הקיימים. זהו אמצעי הגנה שנועד למנוע אובדן גישה לא מכוון.
כדי להסיר בעלי נכסים, צריך להשתמש במסוף. החלפה מסירה חשבונות משתמשים קיימים עם התפקיד READER או WRITER.
הגדרת המפרט מופיעה במאמר data_mesh_types.BqAssetPolicy.
גישה ברמת השורה
אתם יכולים לתת גישה לקבוצות של שורות על סמך מסננים מסוימים של ערכי עמודות.
כשמציינים את מדיניות הגישה ברמת השורה, מחרוזת הסינון שסופקה תוכנס לתוך CREATE DDL statement. אם הדגל overwrite מופעל, הוא מבטל את כל כללי מדיניות הגישה הקיימים לשורות לפני החלת כללי מדיניות חדשים.
כמה דברים שכדאי לדעת על גישה ברמת השורה:
- אם מוסיפים כללי מדיניות גישה לשורות, משתמשים שלא צוינו בכללי המדיניות האלה לא יוכלו לראות אף שורה.
- כללי מדיניות ברמת השורה פועלים רק עם טבלאות, לא עם תצוגות.
- הימנעו משימוש בעמודות מחולקות למחיצות במסננים של מדיניות הגישה לשורות. כדי לקבל מידע על סוג הנכס ועל העמודות המפוצלות, אפשר לעיין בקובץ ה-YAML של הגדרות הדיווח המשויכות.
למידע נוסף על כללי מדיניות גישה ברמת השורה, קראו את השיטות המומלצות לאבטחה ברמת השורה.
להגדרת המפרט, ראו: data_mesh_types.BqRowPolicy.
גישה ברמת העמודה
כדי להפעיל גישה ברמת העמודה, מוסיפים הערות לשדות ספציפיים באמצעות תג מדיניות שמזוהה לפי שם תג המדיניות ושם הטקסונומיה. כדי להגדיר בקרת גישה, מעדכנים את משאב המטא-נתונים של תג המדיניות.
הגדרת המפרט מופיעה במאמר data_mesh_types.PolicyTagId.
פריסת הנתונים המבוזרים
אפשר לפרוס את הנתונים המבוזרים כחלק מהפריסה של תשתית הנתונים, או בנפרד. בשני המקרים, הוא משתמש בקובץ config.json של Cortex כדי לקבוע משתנים רלוונטיים, כמו שמות של מערכי נתונים ב-BigQuery ואפשרויות פריסה. כברירת מחדל, פריסת הנתונים המבוזרים לא תסיר או תחליף משאבים או הערות קיימים, כדי למנוע אובדן לא מכוון. עם זאת, אפשר גם להחליף משאבים קיימים כשפורסים אותם בנפרד.
אפשרויות פריסה
אפשר להפעיל או להשבית את אפשרויות הפריסה הבאות בהתאם לצרכים של המשתמשים ולאילוצי ההוצאות ב-config.json > DataMesh.
| אפשרות | הערות |
deployDescriptions
|
זו האפשרות היחידה שמופעלת כברירת מחדל, והיא פורסת הערות ב-BigQuery עם תיאורים של נכסים ועמודות. לא צריך להפעיל ממשקי API או הרשאות נוספים. |
deployLakes
|
פריסת אגמי נתונים ואזורים. |
deployCatalog
|
פריסה של משאבי Catalog Template והתגים המשויכים אליהם בהערות של הנכסים. |
deployACLs
|
פריסת משאבים של טקסונומיית מדיניות וכללי מדיניות של בקרת גישה ברמת הנכס, השורה והעמודה באמצעות הערות לנכסים. היומנים מכילים הודעות שמציינות איך כללי מדיניות הגישה השתנו. |
פריסה באמצעות Data Foundation
כברירת מחדל, config.json > deployDataMesh מאפשר לפרוס את תיאורי הנכסים של הנתונים המבוזרים בסוף כל שלב של פיתוח עומס העבודה. בהגדרת ברירת המחדל הזו לא צריך להפעיל ממשקי API או תפקידים נוספים.
אפשר לפרוס תכונות נוספות של רשת הנתונים עם תשתית הנתונים על ידי הפעלת אפשרויות הפריסה, ממשקי ה-API והתפקידים הנדרשים, ושינוי המפרטים של המשאבים המשויכים.
פריסה לבד
כדי לפרוס רק את הנתונים המבוזרים, המשתמשים יכולים להשתמש בקובץ common/data_mesh/deploy_data_mesh.py. הכלי הזה משמש במהלך תהליכי ה-build לפריסת הנתונים המבוזרים, עומס עבודה אחד בכל פעם, אבל כשקוראים לו ישירות אפשר להשתמש בו גם כדי לפרוס כמה עומסי עבודה בבת אחת. צריך להפעיל בקובץ config.json את עומסי העבודה של המפרטים שרוצים לפרוס. לדוגמה, ודאו שdeploySAP=true אם אתם פורסים את רשת הנתונים ל-SAP.
כדי לוודא שאתם פורסים עם החבילות והגרסאות הנדרשות, אתם יכולים להריץ את כלי השירות מאותו קובץ אימג' שמשמש את תהליך הפריסה של Cortex, באמצעות הפקודות הבאות:
  # Run container interactively
  docker container run -it gcr.io/kittycorn-public/deploy-kittycorn:v2.0

  # Clone the repo
  git clone https://github.com/GoogleCloudPlatform/cortex-data-foundation

  # Navigate into the repo
  cd cortex-data-foundation
כדי לקבל עזרה לגבי הפרמטרים הזמינים והשימוש בהם, מריצים את הפקודה הבאה:
python src/common/data_mesh/deploy_data_mesh.py -h
הדוגמה הבאה היא להפעלה של SAP ECC:
  python src/common/data_mesh/deploy_data_mesh.py \
    --config-file config/config.json \
    --lake-directories \
        src/SAP/SAP_REPORTING/config/ecc/lakes \
    --tag-template-directories \
        src/SAP/SAP_REPORTING/config/ecc/tag_templates \
    --policy-directories \
        src/SAP/SAP_REPORTING/config/ecc/policy_taxonomies \
    --annotation-directories \
        src/SAP/SAP_REPORTING/config/ecc/annotations
בקטע ספריות של נתונים מבוזרים מוסבר איפה נמצאות הספריות.
החלפה
כברירת מחדל, פריסת נתונים מבוזרים לא מחליפה משאבים או אנוטציות קיימים. עם זאת, אפשר להפעיל את הדגל --overwrite כשפורסים את הנתונים המבוזרים בלבד כדי לשנות את הפריסה בדרכים הבאות.
כשמחליפים משאבי מטא-נתונים כמו אגמים, תבניות של תגי קטלוג ותגי מדיניות, כל המשאבים הקיימים עם אותם שמות נמחקים, אבל משאבים קיימים עם שמות אחרים לא משתנים. כלומר, אם מפרט של משאב יוסר לגמרי מקובץ ה-YAML ואז תפרסו מחדש את הנתונים המבוזרים כשהאפשרות "החלפה" מופעלת, המפרט של המשאב לא יימחק כי לא תהיה התנגשות בין שמות. כך הפריסה של Cortex Data Mesh לא תשפיע על משאבים קיימים שאולי נמצאים בשימוש.
במשאבים בתצוגת עץ כמו אגמים ואזורים, החלפת משאב מסירה את כל הצאצאים שלו. לדוגמה, החלפה של אגם נתונים גם מסירה את האזורים הקיימים ואת ההפניות לנכסים. אם מחליפים תבניות של תגי קטלוג ותגי מדיניות, גם ההפניות המשויכות הקיימות להערות מוסרות מהנכסים. כשמחליפים תגי קטלוג בהערה של נכס, רק המופעים הקיימים של תגי הקטלוג שמשתמשים באותה תבנית מוחלפים.
החלפת התיאורים של הנכסים והשדות מתבצעת רק אם מספקים תיאור חדש, חוקי ולא ריק, שמתנגש עם התיאור הקיים.
לעומת זאת, רשימות ACL פועלות בצורה שונה. כשמחליפים רשימות ACL, כל המשתמשים הקיימים מוסרים (חוץ מהבעלים ברמת הנכס). הסיבה לכך היא שחשבונות המשתמשים שמושמטים ממדיניות הגישה חשובים באותה מידה כמו חשבונות המשתמשים שמקבלים גישה.
הסבר על רשת הנתונים
אחרי פריסת הנתונים המבוזרים, המשתמשים יכולים לחפש את נכסי הנתונים ולצפות בהם באמצעות Data Catalog. זה כולל את היכולת לגלות נכסים על סמך ערכי התגים של Catalog שהוחלו. המשתמשים יכולים גם ליצור ולהחיל באופן ידני מונחים במילון המונחים של הקטלוג, לפי הצורך.
אפשר לראות את כללי מדיניות הגישה שנפרסו בדף הסכימה של BigQuery, כדי לראות את כללי המדיניות שחלים על נכס מסוים בכל רמה.
שושלת נתונים
למשתמשים יכול להיות שימושי להפעיל את שושלת היוחסין בין נכסי BigQuery ולהציג אותה באופן חזותי. אפשר גם לגשת לשושלת היוחסין באופן פרוגרמטי דרך ה-API. התכונה "היסטוריית נתונים" תומכת רק בהיסטוריה ברמת הנכס. התכונה "מעקב אחר שושלת נתונים" לא משולבת ב-Cortex Data Mesh, אבל יכול להיות שבעתיד יתווספו תכונות חדשות שמשתמשות במעקב אחר שושלת נתונים.
בקטע תמיכה מוסבר איך שולחים בקשות שקשורות ל-Cortex Data Mesh או ל-Cortex Framework.