


(Deprecato) Guida dell'utente di Data Mesh
Mesh di dati per Cortex Framework estende la base di dati per consentire la governance dei dati, la rilevabilità e controllo dell'accesso tramite i metadati di BigQuery e Knowledge Catalog. Questo viene implementato fornendo un insieme di base di risorse di metadati e annotazioni degli asset BigQuery che possono essere personalizzate e, facoltativamente, di cui è possibile eseguire il deployment insieme alla base di dati. Queste specifiche di base forniscono una configurazione personalizzata che costituisce la base dei metadati per integrare Cortex Framework Data Foundation. Consulta i concetti di mesh di dati prima di procedere con questa guida.
I passaggi descritti in questa pagina sono progettati specificamente per la configurazione di mesh di dati per Cortex Framework. Trova i file di configurazione di mesh di dati all'interno delle cartelle specifiche per ogni workload nella sezione Directory di mesh di dati.
Design
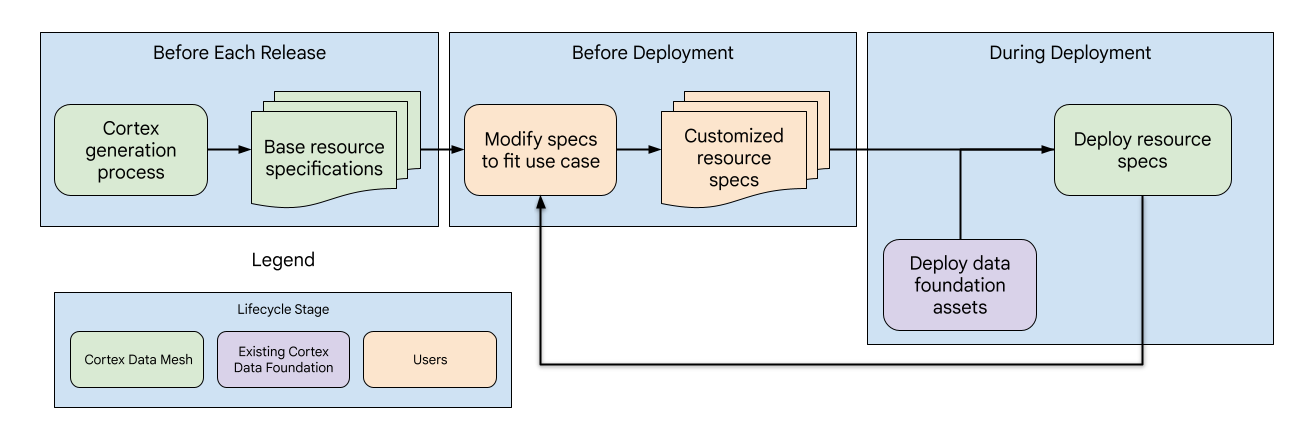
Il mesh di dati di Cortex è progettato in modo simile alla base di dati complessiva ed è composto da tre fasi con diversi componenti secondari gestiti da Cortex o dagli utenti:
- Aggiornamento delle specifiche delle risorse di base: con ogni release, Cortex aggiorna le specifiche delle risorse di base, fornendo una base di metadati standardizzata per il mesh di dati.
- Personalizzazione delle specifiche delle risorse: prima del deployment, gli utenti possono personalizzare le specifiche delle risorse in base ai loro casi d'uso e requisiti specifici.
- Deployment e aggiornamenti di mesh di dati: gli utenti possono attivare il mesh di dati nel file di configurazione di Cortex. Viene eseguito il deployment dopo gli asset di dati durante il deployment di Cortex. Inoltre, gli utenti hanno la flessibilità di eseguire il deployment del mesh di dati in modo indipendente per ulteriori aggiornamenti.
Directory mesh di dati
Trova i file di configurazione di base di mesh di dati per ogni workload e origine dati nelle seguenti posizioni. Tieni presente che le directory contengono una struttura di file diversa, ma tutte le specifiche si trovano in modo simile nella cartella config.
| Workload | Origine dati | Percorso directory |
| Operativo | SAP ECC | src/SAP/SAP_REPORTING/config/ecc |
| SAP S/4 HANA | src/SAP/SAP_REPORTING/config/s4 |
|
| Salesforce Sales Cloud (SFDC) | src/SFDC/config
|
|
| Oracle EBS | src/OracleEBS/config
|
|
| Marketing | CM360 | src/marketing/src/CM360/config |
| Google Ads | src/marketing/src/GoogleAds/config
|
|
| Meta | src/marketing/src/Meta/config
|
|
| Salesforce Marketing Cloud (SFMC) | src/marketing/src/SFMC/config
|
|
| TikTok | src/marketing/src/TikTok/config
|
|
| YouTube (con DV360) | src/marketing/src/DV360/config
|
|
| Google Analytics 4 | src/marketing/src/GA4/config
|
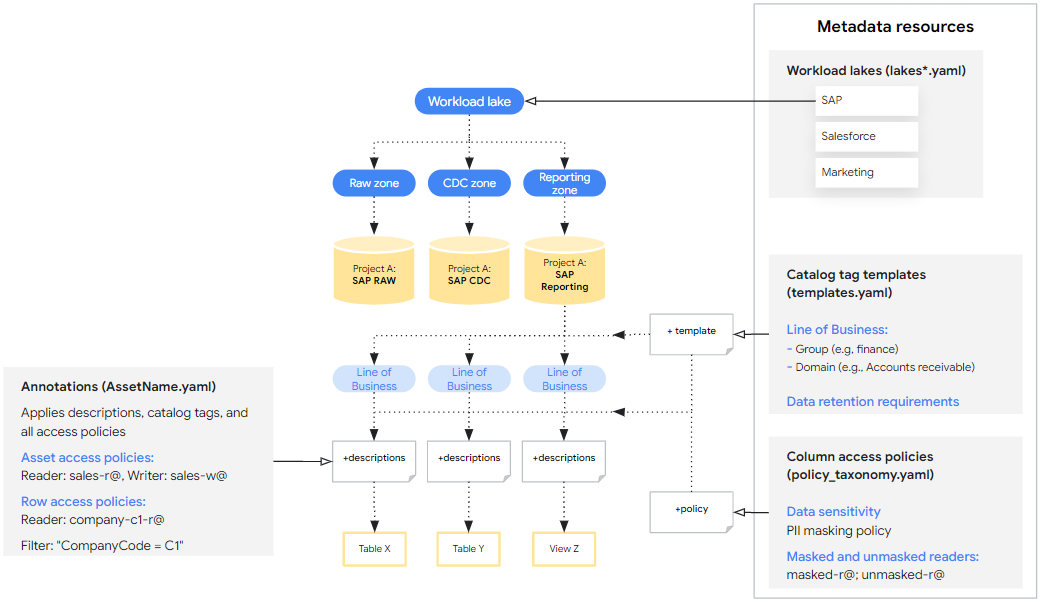
Le risorse dei metadati vengono definite a livello di origine dati con un singolo file YAML per progetto Google Cloud e contengono un elenco di tutte le risorse. Se necessario, gli utenti possono estendere il file esistente o creare file YAML aggiuntivi contenenti specifiche delle risorse aggiuntive all'interno della directory.
Le annotazioni degli asset sono definite a livello di asset e contengono molti file YAML nella directory con una singola annotazione per file.
Abilita le API e verifica le autorizzazioni
La modifica dei valori predefiniti per mesh di dati ti consente di implementare funzionalità che vanno oltre le descrizioni. Se devi modificare i valori predefiniti per mesh di dati in
config.json
per implementare funzionalità oltre alle descrizioni, assicurati che le
API necessarie e le autorizzazioni di conferma siano impostate come descritto nella tabella seguente.
Quando esegui il deployment di mesh di dati con la base dei dati, concedi le autorizzazioni all'utente che esegue il deployment o all'account Cloud Build. Se il deployment coinvolge progetti di origine e di destinazione diversi, assicurati che queste API e autorizzazioni siano abilitate in entrambi i progetti ovunque vengano utilizzate queste funzionalità.
| Funzionalità | Ruoli di autorizzazione | Documentazione |
| Accesso agli asset e alle righe di BigQuery | Proprietario dati BigQuery | Per saperne di più, consulta Ruoli richiesti per i ruoli degli asset e Autorizzazioni richieste per i ruoli delle righe. |
| Accesso alle colonne BigQuery | Policy Tag Admin | Per saperne di più, consulta la documentazione Ruoli utilizzati con il controllo dell'accesso a livello di colonna e Limita l'accesso con il controllo dell'accesso a livello di colonna. |
| Tag catalogo | Data Catalog TagTemplate Owner | Per saperne di più, consulta la documentazione relativa a Tagga una tabella BigQuery utilizzando Data Catalog e IAM di Data Catalog. |
| Lake di Knowledge Catalog | Dataplex Editor | Per saperne di più, consulta la documentazione Crea un lake. |
Informazioni sulle specifiche delle risorse di base
L'interfaccia principale per la configurazione del mesh di dati per Cortex è costituita dalle specifiche delle risorse di base, ovvero un insieme di file YAML forniti pronti all'uso che definiscono le risorse dei metadati e le annotazioni di cui viene eseguito il deployment. Le specifiche di base forniscono consigli iniziali ed esempi di sintassi, ma sono destinate a essere personalizzate ulteriormente per soddisfare le esigenze degli utenti. Queste specifiche rientrano in due categorie:
- Risorse di metadati che possono essere applicate a vari asset di dati. Ad esempio, i modelli di tag del catalogo che definiscono il modo in cui gli asset possono essere taggati con i domini aziendali.
- Annotazioni che specificano come le risorse dei metadati vengono applicate a un asset di dati specifico. Ad esempio, un tag del catalogo che associa una tabella specifica al dominio Vendite.
Le sezioni seguenti illustrano esempi di base di ogni tipo di specifica e spiegano come personalizzarli. Le specifiche di base sono contrassegnate con ## CORTEX-CUSTOMER dove devono essere modificate per adattarsi a un deployment se l'opzione di deployment associata è abilitata.
Per utilizzi avanzati, consulta la definizione canonica di questi schemi di specifica in src/common/data_mesh/src/data_mesh_types.py.
Risorse dei metadati
Le risorse di metadati sono entità condivise che esistono all'interno di un progetto e che possono essere applicate a molti asset di dati. La maggior parte delle specifiche include un campo display_name soggetto ai seguenti criteri:
- Contiene solo lettere Unicode, numeri (0-9), trattini bassi (_), trattini (-) e spazi ( ).
- Non può iniziare o terminare con spazi.
- La lunghezza massima è di 200 caratteri.
In alcuni casi, il display_name viene utilizzato anche come ID, il che potrebbe introdurre requisiti aggiuntivi. In questi casi, sono inclusi i link alla documentazione canonica.
Se il deployment fa riferimento a risorse di metadati in progetti di origine e di destinazione diversi, deve essere definita una specifica per ogni progetto. Ad esempio, Cortex Salesforce (SFDC) contiene due specifiche di lake. Uno per le zone raw e CDC e un altro per i report.
Lake di Knowledge Catalog
I lake, le zone e gli asset di Knowledge Catalog vengono utilizzati per organizzare i dati dal punto di vista dell'engineering. I lake hanno un region e le zone hanno un location_type, entrambi correlati alla località Cortex (config.json > location). La località Cortex definisce dove vengono archiviati i set di dati BigQuery e può essere una singola regione o multiregione. La zona location_type deve essere impostata su SINGLE_REGION | MULTI_REGION per corrispondere.
Tuttavia, le regioni del lake devono essere sempre singole. Se la località e la zona Cortex location_type sono multiregionali, seleziona una singola regione all'interno di quel gruppo per la regione del lake.
- Requisiti
- Il lago
display_nameviene utilizzato comelake_ide deve essere conforme ai requisiti ufficiali. Questo vale anche per la zona e l'assetdisplay_name. Gli ID zona devono essere univoci in tutti i lake del progetto. - Le specifiche del lake devono essere associate a una singola regione.
asset_namedeve corrispondere all'ID del set di dati BigQuery, madisplay_namepuò essere un'etichetta più facile da usare.
- Il lago
- Limitazioni
- Knowledge Catalog supporta solo la registrazione di set di dati BigQuery anziché di singole tabelle come asset Knowledge Catalog.
- Un asset potrebbe essere registrato in una sola zona.
- Knowledge Catalog è supportato solo in determinate località. Per saperne di più, consulta Località di Knowledge Catalog.
Vedi l'esempio seguente in lakes.yaml.
Queste risorse sono definite nei file YAML che specificano data_mesh_types.Lakes.
Modelli di tag del catalogo
I modelli di tag di Data Catalog possono essere utilizzati per aggiungere contesto alle tabelle BigQuery o alle singole colonne. Ti aiutano a categorizzare e comprendere i tuoi dati sia dal punto di vista tecnico che aziendale, in modo integrato con gli strumenti di ricerca di Knowledge Catalog. Definiscono i campi specifici che puoi utilizzare per etichettare i dati e il tipo di informazioni che ogni campo può contenere (ad esempio testo, numero, data). I tag del catalogo sono istanze dei template con valori di campo effettivi.
Il campo del modello display_name viene utilizzato come ID campo e deve soddisfare i requisiti per TagTemplate.fields specificati in Classe TagTemplate.
Per saperne di più sui tipi di campi supportati, consulta Tipi di campi di Data Catalog.
Cortex mesh di dati crea tutti i modelli di tag come leggibili pubblicamente. Introduce anche un concetto level aggiuntivo alle specifiche del modello di tag, che definisce se un tag deve essere applicato a un intero asset, a singoli campi all'interno di un asset o a entrambi, con i valori possibili: ASSET | FIELD | ANY. Anche se al momento questa regola non viene applicata rigorosamente, i controlli di convalida futuri potrebbero garantire che i tag vengano applicati al livello appropriato durante il deployment.
Vedi l'esempio seguente.
I template sono definiti in file YAML che specificano data_mesh_types.CatalogTagTemplates.
I tag del catalogo sono istanze dei modelli e vengono discussi di seguito nelle annotazioni degli asset.
Controllo degli accessi a livello di asset e colonna con i modelli di tag
Cortex Framework offre la possibilità di attivare controllo dell'accesso a livello di asset o colonna su tutti gli artefatti associati a un modello di tag del catalogo.
Ad esempio, se gli utenti vogliono concedere l'accesso agli asset in base alla linea di business, possono creare asset_policies per il modello di tag del catalogo line_of_business con entità diverse specificate per ogni dominio aziendale.
Ogni policy accetta filters che può essere utilizzato per trovare corrispondenze solo con tag con valori specifici. In questo caso, potremmo trovare una corrispondenza per i valori domain. Tieni presente che questi filters supportano solo la corrispondenza per l'uguaglianza e nessun altro operatore. Se sono elencati più filtri, i risultati devono soddisfare tutti i filtri (ad esempio, filter_a AND filter_b). L'insieme finale di policy degli asset è l'unione di quelle definite direttamente nelle annotazioni e di quelle delle policy dei template.
Controllo dell'accesso a livello di colonna con i tag del catalogo si comporta in modo simile applicando i tag di policy ai campi corrispondenti. Tuttavia, poiché a una colonna può essere applicato un solo tag di policy, la precedenza è:
- Tag di policy diretto:se un tag di policy è definito direttamente nell'annotazione della colonna, ha la priorità.
- Norma di corrispondenza del modello di tag: in caso contrario, l'accesso è determinato dalla prima norma di corrispondenza definita su un campo all'interno del modello di tag del catalogo associato.
Quando utilizzi questa funzionalità, ti consigliamo vivamente di attivare o disattivare il deployment dei tag del catalogo e degli elenchi di controllo dell'accesso (ACL) insieme. In questo modo, gli ACL vengono implementati correttamente.
Per comprendere le specifiche di questa funzionalità avanzata, consulta le definizioni dei parametri asset_policies e field_policies in data_mesh_types.CatalogTagTemplate.
Glossario del catalogo
Il glossario è uno strumento che può essere utilizzato per fornire un dizionario dei termini utilizzati da colonne specifiche all'interno di asset di dati che potrebbero non essere universalmente compresi. Gli utenti possono aggiungere i termini manualmente nella console, ma non è previsto il supporto tramite le specifiche delle risorse.
Tassonomie e tag di policy
Le tassonomie e i tag delle policy consentono il controllo dell'accesso a livello di colonna sugli asset di dati sensibili in modo standardizzato. Ad esempio, potrebbe esistere una tassonomia per i tag che controllano i dati PII su una particolare linea di business, in cui solo determinati gruppi possono leggere i dati mascherati, i dati non mascherati o non avere alcun accesso in lettura.
Per maggiori dettagli sulle tassonomie e sui tag delle policy, consulta la documentazione Introduzione al mascheramento dei dati delle colonne. Le seguenti sezioni sono particolarmente pertinenti:
- Interazione tra i ruoli
- Ereditarietà delle autorizzazioni
- Regole di mascheramento e gerarchia
- Best practice per i tag di policy
Cortex Framework fornisce tag di policy di esempio per dimostrare come vengono specificati e i potenziali utilizzi, ma le risorse che influiscono sul controllo dell'accesso non sono abilitate per impostazione predefinita nel deployment del mesh di dati.
Vedi l'esempio seguente.
Le tassonomie delle policy sono definite in file YAML che specificano data_mesh_types.PolicyTaxonomies.
Annotazioni degli asset
Le annotazioni specificano i metadati applicabili a un determinato asset e possono fare riferimento alle risorse di metadati condivise che sono state definite. Le annotazioni includono:
- Descrizioni degli asset
- Descrizioni dei campi
- Tag catalogo
- Controllo dell'accesso a livello di asset, riga e colonna
La base di dati di Cortex Framework offre annotazioni (descrizioni) preconfigurate per i seguenti workload.
- SAP ECC (raw, CDC e reporting)
- SAP S4 HANA (non elaborati, CDC e report)
- SFDC (solo generazione di report)
- Oracle EBS (solo generazione di report)
- CM360 (solo generazione di report)
- Google Ads (solo generazione di report)
- Meta (solo generazione di report)
- SFMC (solo generazione di report)
- TikTok (solo generazione di report)
- YouTube (con DV360) (solo generazione di report)
- Google Analytics 4 (solo generazione di report)
Vedi l'esempio seguente.
Le annotazioni sono definite in file YAML che specificano data_mesh_types.BqAssetAnnotation.
Tag catalogo
I tag del catalogo sono istanze dei modelli definiti in cui vengono assegnati i valori dei campi che si applicano alla risorsa specifica. Assicurati di assegnare valori che corrispondano ai tipi di campo dichiarati nel modello associato.
I valori TIMESTAMP devono essere in uno dei seguenti formati:
  "%Y-%m-%d %H:%M:%S%z"
  "%Y-%m-%d %H:%M:%S"
  "%Y-%m-%d"
Vedi l'esempio seguente.
Consulta la definizione della specifica in data_mesh_types.CatalogTag.
Specifica dei lettori e delle entità delle policy di accesso
Controlla l'accesso ai dati BigQuery in Cortex Framework utilizzando le policy di accesso. Queste policy definiscono chi (entità) può accedere a risorse di dati specifiche, a righe all'interno di una risorsa o persino a singole colonne. Le entità devono seguire un formato specifico definito dal membro dell'associazione delle policy IAM.
Accesso a livello di asset
Puoi concedere l'accesso a interi asset BigQuery con varie autorizzazioni:
READER: visualizza i dati nell'asset.WRITER: modifica e aggiungi dati all'asset.OWNER: controllo completo dell'asset, inclusa la gestione dell'accesso.
Queste autorizzazioni sono equivalenti all'istruzione GRANT DCL in SQL.
A differenza del comportamento per la maggior parte delle risorse e delle annotazioni, il flag di sovrascrittura non rimuove le entità esistenti con il ruolo OWNERS.
Quando aggiungi nuovi proprietari con la sovrascrittura abilitata, questi vengono solo aggiunti ai proprietari esistenti. Si tratta di una misura di sicurezza per evitare la perdita involontaria dell'accesso.
Per rimuovere i proprietari degli asset, utilizza la console. La sovrascrittura rimuove le entità esistenti con il ruolo READER o WRITER.
Vedi l'esempio seguente.
Consulta la definizione della specifica in data_mesh_types.BqAssetPolicy.
Accesso a livello di riga
Puoi concedere l'accesso a insiemi di righe in base a determinati filtri dei valori delle colonne.
Quando specifichi la policy di accesso alle righe, la stringa di filtro fornita verrà inserita in un'istruzione CREATE DDL statement. Se il flag overwrite è abilitato, elimina tutte le policy di accesso alle righe esistenti prima di applicarne di nuove.
Tieni presente quanto segue sull'accesso a livello di riga:
- L'aggiunta di policy di accesso alle righe significa che gli utenti non specificati in queste policy non avranno accesso per visualizzare le righe.
- Le policy di riga funzionano solo con le tabelle, non con le viste.
- Evita di utilizzare colonne partizionate nei filtri delle policy di accesso alle righe. Per informazioni sul tipo di asset e sulle colonne partizionate, consulta il file YAML delle impostazioni dei report associato.
Per saperne di più sulle policy di accesso a livello di riga, consulta le best practice per la sicurezza a livello di riga.
Vedi l'esempio seguente.
Consulta la definizione della specifica in data_mesh_types.BqRowPolicy.
Accesso a livello di colonna
Per abilitare l'accesso a livello di colonna, annota i singoli campi con un tag di policy identificato dal nome del tag di policy e dal nome della tassonomia. Aggiorna la risorsa dei metadati tag di criteri per configurare controllo dell'accesso.
Vedi l'esempio seguente.
Consulta la definizione della specifica in data_mesh_types.PolicyTagId.
Deployment del mesh di dati
Il deployment del mesh di dati può essere eseguito nell'ambito del deployment della base dei dati o in modo indipendente. In entrambi i casi, utilizza il file Cortex config.json per determinare le variabili pertinenti, come i nomi dei set di dati BigQuery e le opzioni di deployment. Per impostazione predefinita, il deployment del mesh di dati non rimuove né sovrascrive le risorse o le annotazioni esistenti per evitare perdite involontarie. Tuttavia, è anche possibile sovrascrivere le risorse esistenti quando viene eseguito il deployment in modo indipendente.
Opzioni di deployment
Le seguenti opzioni di deployment possono essere attivate o disattivate in base alle esigenze dell'utente e ai vincoli di spesa in config.json > DataMesh.
| Opzione | Note |
deployDescriptions
|
Questa è l'unica opzione abilitata per impostazione predefinita ed esegue il deployment delle annotazioni BigQuery con le descrizioni degli asset e delle colonne. Non richiede l'abilitazione di API o autorizzazioni aggiuntive. |
deployLakes
|
Esegue il deployment di lake e zone. |
deployCatalog
|
Esegue il deployment delle risorse del modello di catalogo e dei tag associati nelle annotazioni degli asset. |
deployACLs
|
Esegue il deployment delle risorse di tassonomia delle policy e delle policy di controllo dell'accesso a livello di asset, riga e colonna tramite annotazioni degli asset. I log contengono messaggi che indicano come sono cambiate le policy di accesso. |
Deployment con Data Foundation
Per impostazione predefinita, config.json > deployDataMesh consente di eseguire il deployment delle descrizioni degli asset del mesh di dati alla fine di ogni passaggio di creazione del workload. Questa configurazione predefinita non richiede l'abilitazione di API o ruoli aggiuntivi.
È possibile eseguire il deployment di funzionalità aggiuntive del mesh di dati con la base di dati abilitando le opzioni di deployment, le API e i ruoli richiesti e modificando le specifiche delle risorse associate.
Deployment autonomo
Per eseguire il deployment della mesh di dati da sola, gli utenti possono utilizzare il file common/data_mesh/deploy_data_mesh.py. Questa utilità viene utilizzata durante i processi di build per eseguire il deployment del mesh di dati un workload alla volta, ma se chiamata direttamente potrebbe essere utilizzata anche per eseguire il deployment di più workload contemporaneamente. I workload per il deployment delle specifiche devono essere abilitati nel file config.json. Ad esempio, assicurati che
deploySAP=true se esegui il deployment di Mesh di dati per SAP.
Per assicurarti di eseguire il deployment con i pacchetti e le versioni richiesti, puoi eseguire l'utilità dalla stessa immagine utilizzata dal processo di deployment di Cortex con i seguenti comandi:
  # Run container interactively
  docker container run -it gcr.io/kittycorn-public/deploy-kittycorn:v2.0

  # Clone the repo
  git clone https://github.com/GoogleCloudPlatform/cortex-data-foundation

  # Navigate into the repo
  cd cortex-data-foundation
Per assistenza sui parametri disponibili e sul loro utilizzo, esegui questo comando:
python src/common/data_mesh/deploy_data_mesh.py -h
Di seguito è riportato un esempio di chiamata per SAP ECC:
  python src/common/data_mesh/deploy_data_mesh.py \
    --config-file config/config.json \
    --lake-directories \
        src/SAP/SAP_REPORTING/config/ecc/lakes \
    --tag-template-directories \
        src/SAP/SAP_REPORTING/config/ecc/tag_templates \
    --policy-directories \
        src/SAP/SAP_REPORTING/config/ecc/policy_taxonomies \
    --annotation-directories \
        src/SAP/SAP_REPORTING/config/ecc/annotations
Per informazioni sulle posizioni delle directory, consulta la sezione Directory di Data Mesh.
Sovrascrivi
Per impostazione predefinita, il deployment di mesh di dati non sovrascrive le risorse o le annotazioni esistenti. Tuttavia, il flag --overwrite può essere abilitato quando esegui il deployment della mesh di dati da sola per modificare il deployment nei seguenti modi.
La sovrascrittura delle risorse di metadati come lake, modelli di tag del catalogo e tag di policy elimina tutte le risorse esistenti che condividono gli stessi nomi, ma non modifica le risorse esistenti con nomi diversi. Ciò significa che se una specifica della risorsa viene rimossa completamente dal file YAML e poi viene eseguito nuovamente il deployment del mesh di dati con l'opzione di sovrascrittura abilitata, la specifica della risorsa non verrà eliminata perché non si verificherà una collisione dei nomi. In questo modo, il deployment di Cortex Data Mesh non influisce sulle risorse esistenti che potrebbero essere in uso.
Per le risorse nidificate come lake e zone, la sovrascrittura di una risorsa rimuove tutti i relativi elementi secondari. Ad esempio, la sovrascrittura di un lake rimuove anche le zone e i riferimenti agli asset esistenti. Per i modelli di tag del catalogo e i tag di policy sovrascritti, anche i riferimenti alle annotazioni associati esistenti vengono rimossi dagli asset. La sovrascrittura dei tag di catalogo su un'annotazione di asset sovrascrive solo le istanze esistenti dei tag di catalogo che condividono lo stesso modello.
Le sovrascritture delle descrizioni di asset e campi hanno effetto solo se viene fornita una nuova descrizione valida e non vuota che è in conflitto con la descrizione esistente.
Le ACL, invece, si comportano in modo diverso. La sovrascrittura delle ACL rimuove tutte le entità esistenti (ad eccezione dei proprietari a livello di asset). Questo perché le entità omesse dalle policy di accesso sono importanti quanto quelle a cui viene concesso l'accesso.
Esplorazione del mesh di dati
Dopo aver eseguito il deployment del mesh di dati, gli utenti possono cercare e visualizzare gli asset di dati con Data Catalog. Ciò include la possibilità di scoprire gli asset in base ai valori dei tag del catalogo applicati. Se necessario, gli utenti possono anche creare e applicare manualmente i termini del glossario del catalogo.
I criteri di accesso di cui è stato eseguito il deployment possono essere visualizzati nella pagina Schema BigQuery per vedere i criteri applicati a un asset specifico a ogni livello.
Derivazione dei dati
Gli utenti potrebbero trovare utile abilitare e visualizzare la derivazione tra gli asset BigQuery. È possibile accedere alla derivazione anche in modo programmatico tramite l'API. La derivazione dei dati supporta solo la derivazione a livello di asset. La derivazione dei dati non è intrecciata con Cortex Data Mesh, tuttavia in futuro potrebbero essere introdotte nuove funzionalità che utilizzano la derivazione.
Per qualsiasi richiesta relativa a Cortex mesh di dati o Cortex Framework, vai alla sezione Assistenza.