


Mit Konvertierungsarbeitsbereichen können Sie das Schema und die Objekte aus der Quelldatenbank leichter in die mit der Zieldatenbank kompatible SQL-Syntax konvertieren. Diese Seite bietet eine Übersicht über die Konvertierungsarbeitsbereiche von Database Migration Service:
Unter Optionen für die Initialisierung des Quellschemas wird erläutert, wie Sie Ihren Arbeitsbereich füllen, indem Sie eine direkte Verbindung zu Ihrer Datenbank herstellen oder Schemadateien in Cloud Storage hochladen.
Conversion-Übersichten bieten einen Querschnitt des Fortschritts Ihrer Schemakonvertierung.
Unter Objekte, die von der deterministischen Code- und Schemakonvertierung unterstützt werden werden Oracle-Objekte aufgeführt, die für die deterministische Schemakonvertierung unterstützt werden.
Unter Interaktiver SQL-Editor wird beschrieben, welche Objekte Sie direkt im Editor für den Konvertierungsarbeitsbereich ändern können.
Gemini-gestützte Konvertierungsfunktionen: Hier erfahren Sie, wie Sie generative KI einbinden können, um den Schemakonvertierungsprozess zu beschleunigen.
Im Abschnitt Conversion-Zuordnungsdateien finden Sie eine Übersicht über Anpassungsanweisungen, mit denen Sie die Regeln der deterministischen Schemakonvertierung überschreiben können.
Bestimmte Datentypen werden für Oracle-Migrationen nicht unterstützt. Weitere Informationen finden Sie unter Bekannte Einschränkungen für Datentypen.
Optionen für die Initialisierung des Quellschemas
Zum Konvertieren des Datenbankschemas benötigt Database Migration Service einen ersten Snapshot der Quelldatenbankobjekte. Sie können diesen Snapshot auf zwei Arten bereitstellen:
- Direkte Datenbankverbindung: Database Migration Service stellt über ein Verbindungsprofil eine direkte Verbindung zu Ihrer laufenden Quelldatenbank her und ruft das Schema über eine Netzwerkverbindung ab.
- Schemadateien in Cloud Storage: Sie können Ihre Schemametadaten lokal mit von Google bereitgestellten Extraktionsskripts extrahieren, die resultierenden Dateien in einen Cloud Storage-Bucket hochladen und Ihren Arbeitsbereich vorbereiten, ohne eine Verbindung zur Quelldatenbank herzustellen.
Informationen zum Erstellen des Konvertierungsarbeitsbereichs mit einer direkten Datenbankverbindung oder mit Schemadateien in Cloud Storage finden Sie unter Konvertierungsarbeitsbereich erstellen.
Übersichten zum Conversion-Fortschritt
Konvertierungsarbeitsbereiche bieten umfassende Übersichtsinformationen, mit denen Sie Einblicke in die Gesamtzahl der ausstehenden oder gelösten Konvertierungsprobleme, die von Gemini unterstützten Erweiterungen und den allgemeinen Zustand Ihres Konvertierungsprozesses erhalten.
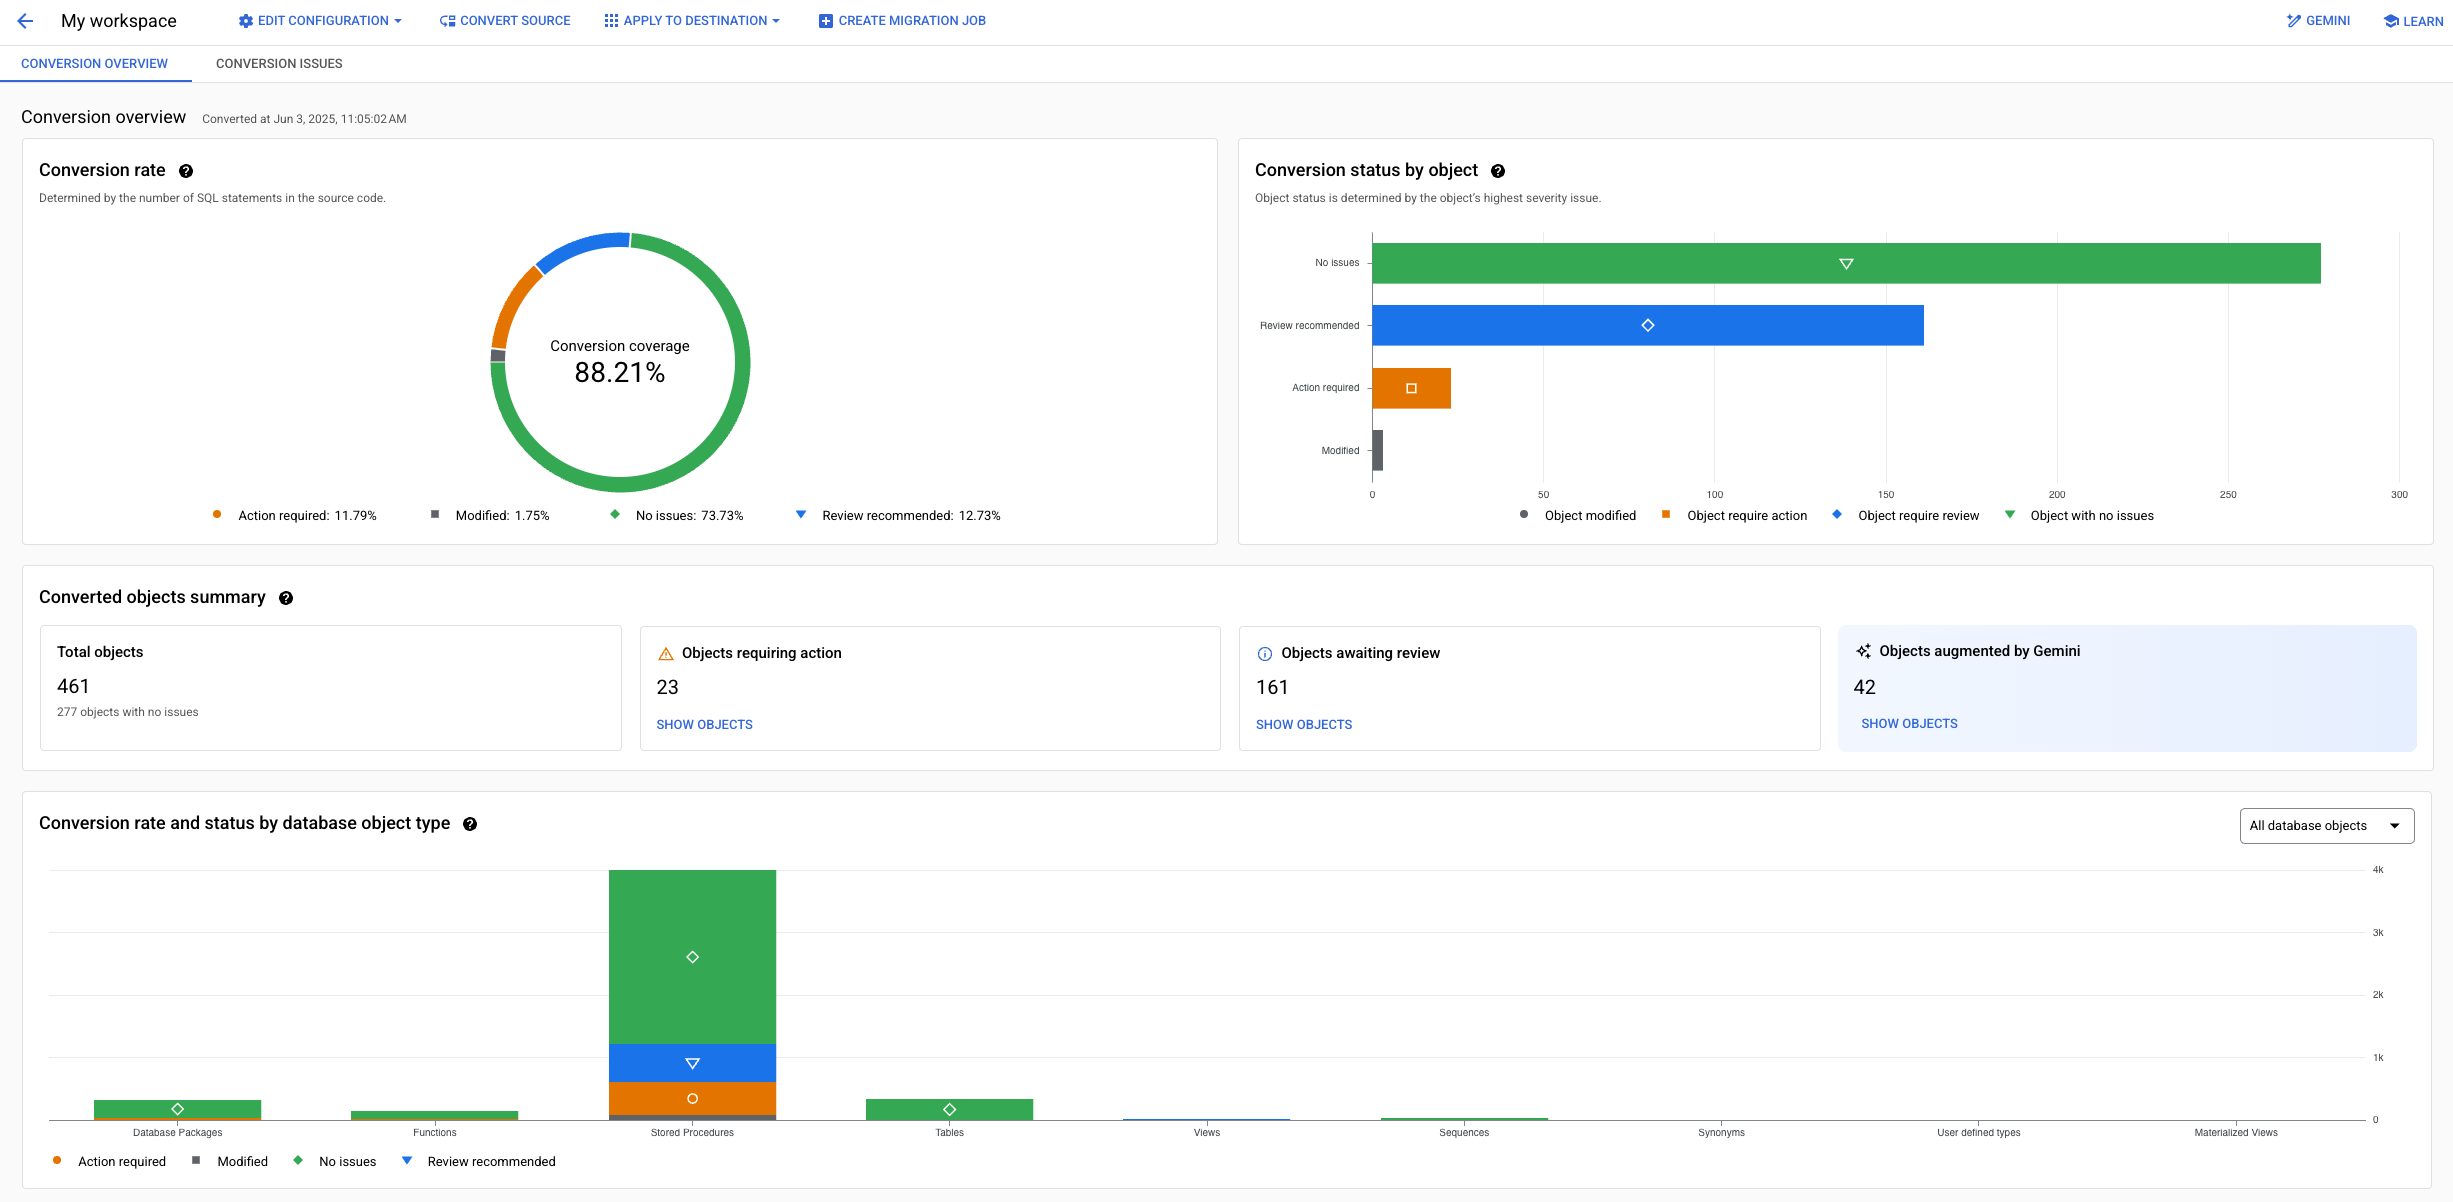
In dieser Ansicht können Sie Objekte in Ihrem Schema nach Typ, Schweregrad des Problems, erforderlichen Aktionen oder Konvertierungsstatus filtern.

Weitere Informationen zur Verwendung von Conversion-Übersichten zum Prüfen von Conversion-Ergebnissen finden Sie unter Mit Konvertierungsarbeitsbereichen arbeiten.
Deterministische Code- und Schemakonvertierung
Wenn Sie einen Konvertierungsarbeitsbereich erstellen, führt Database Migration Service sofort die erste Schemakonvertierung durch. Dabei wird eine Reihe deterministischer Konvertierungsregeln verwendet, bei denen bestimmte Oracle-Datentypen und -Objekte bestimmten PostgreSQL-Datentypen und -Objekten zugeordnet werden. Dieser Prozess unterstützt eine sehr spezifische Teilmenge der verfügbaren Oracle-Datenbankobjekte.
Die deterministische Codekonvertierung unterstützt die folgenden Oracle-Datenbankobjekte:
Unterstützte Oracle-Schemaelemente
- Einschränkungen
- Indexe (nur Indexe, die im selben Schema wie ihre Tabelle erstellt wurden)
- Materialisierte Ansichten
- Objekttypen (teilweise unterstützt)
- Sequenzen
- Synonyme
- Tabellen
- Aufrufe
Unterstützte Oracle-Codeelemente
- Trigger (nur Tabellenebene)
- Pakete
- Funktionen
- Gespeicherte Prozeduren
Interaktiver SQL-Editor
Mit dem interaktiven SQL-Editor können Sie die konvertierte PostgreSQL-Syntax direkt in Database Migration Service ändern. Sie können damit Conversion-Probleme beheben oder das Schema an Ihre Anforderungen anpassen. Einige Objekte können im integrierten Editor nicht geändert werden.
Bearbeitbare Oracle-Objekte
Nachdem Sie den Code und das Schema der Quelldatenbank konvertiert haben, können Sie den interaktiven Editor verwenden, um das generierte SQL für bestimmte Objekttypen zu ändern. Die folgenden Oracle-Objekte werden vom Editor unterstützt:
- Tabellen-Trigger (Berechtigung erforderlich)
- Materialisierte Ansichten
- Pakete
- Funktionen, gespeicherte Prozeduren
- Synonyme
- Aufrufe
- Einschränkungen
- Indexe
- Sequenzen
Darüber hinaus werden einige Objekte konvertiert, können aber nicht direkt in Database Migration Service bearbeitet werden. Wenn Sie solche Objekte ändern möchten, müssen Sie die Aktualisierungen direkt in der Zieldatenbank vornehmen, nachdem Sie das konvertierte Schema und den konvertierten Code angewendet haben.
Objekte, deren Bearbeitung nicht unterstützt wird:
- Benutzerdefinierte Objekttypen
- Tabellen
- Schemas
Code- und Schemakonvertierung mit Gemini beschleunigen
Database Migration Service bindet Gemini für Google Cloud in Konvertierungsarbeitsbereiche ein, um den Konvertierungsprozess in den folgenden Bereichen zu beschleunigen und zu verbessern:
Verbessern Sie die deterministischen Konvertierungsergebnisse mit der Gemini-basierten automatischen Konvertierung, um die Anzahl der manuellen Anpassungen in Ihrem PostgreSQL-Code mithilfe von KI erheblich zu reduzieren.
Mit Gemini-basierten Qualitätsbewertungen können Sie die Qualität und funktionale Äquivalenz Ihres konvertierten Codes sicherstellen. Bei diesen Bewertungen wird der konvertierte Code analysiert und Feedback zu seiner Richtigkeit und Funktionalität im Vergleich zum Quellcode gegeben.
Funktionen zur Erklärbarkeit von Code mit dem Konvertierungsassistenten: Eine Reihe von speziellen Prompts, die Ihnen helfen können, die Konvertierungslogik besser zu verstehen, Korrekturen für Konvertierungsprobleme vorzuschlagen oder konvertierten Code zu optimieren.
Mit Gemini-Codekonvertierungsvorschlägen können Sie Korrekturen für Konvertierungsprobleme schneller anwenden. Dabei handelt es sich um einen Mechanismus, mit dem das Gemini-Modell lernen kann, während Sie Konvertierungsprobleme beheben, und Änderungen an anderen fehlerhaften Objekten im Arbeitsbereich vorschlagen kann.
Weitere Informationen zur Gemini-basierten Konvertierung finden Sie auf den folgenden Seiten:
Oracle-Code und ‑Schema mit Gemini-Unterstützung konvertieren
Beispielworkflow zum Beheben von Codeobjekten mit Konvertierungsproblemen
Dateien für die Conversion-Zuordnung
Sie können die Konvertierungslogik mit einer Konvertierungszuordnungsdatei anpassen. Die Konvertierungszuordnungsdatei ist eine Textdatei, die genaue Anweisungen (Konvertierungsanweisungen) dazu enthält, wie Ihre Oracle-Objekte in PostgreSQL-Objekte konvertiert werden sollen.
Unterstützte Konvertierungsanweisungen
Database Migration Service unterstützt die folgenden Konvertierungsanweisungen für Konvertierungszuordnungsdateien:
EXPORT_SCHEMA
EXPORT_SCHEMA ist eine obligatorische Anweisung für alle Konvertierungszuordnungsdateien. Database Migration Service benötigt diese Anweisung, damit Ihre Quellschemas in die richtigen Zielschemas konvertiert werden.
Die Conversion-Zuordnungsdateien müssen die folgende Zeile enthalten:
EXPORT_SCHEMA 1
SCHEMA
Database Migration Service muss ermitteln können, welches Schema die Objekte enthält, die mit Ihren Konvertierungsanweisungen geändert werden sollen.
Die Anweisung SCHEMA bewirkt, dass alle anderen Anpassungsanweisungen in Ihrer Datei auf Objekte in diesem bestimmten Schema angewendet werden.
- Wenn Sie diese Anweisung verwenden, werden auch andere Schemas in Ihrer Datenbank konvertiert, aber ihre Objekte werden nicht geändert.
- Wenn Sie diese Anweisung in die Konvertierungszuordnungsdatei aufnehmen, werden alle Anpassungen nur auf Objekte in diesem spezifischen Schema angewendet.
- Wenn Sie diese Anweisung überspringen, müssen Sie vollständig qualifizierte Objektnamen angeben, die den Schemanamen für Objekte enthalten, die durch andere Konvertierungsanweisungen geändert wurden.
Beispielsweise müssten Sie für die Anweisung
REPLACE_TABLES"SCHEMA_NAME.SOURCE_TABLE_NAME"anstelle vonSOURCE_TABLE_NAMEverwenden. - So passen Sie Objekte in verschiedenen Schemas an:
- Erstellen Sie separate Dateien für die Conversion-Zuordnung für andere Schemas und laden Sie sie in den Konvertierungsarbeitsbereich hoch.
- Verwenden Sie vollständig qualifizierte Objektnamen, die den Schemanamen für Objekte enthalten, die sich in anderen Schemas als dem befinden, das Sie für die Anweisung
SCHEMAangeben.
Verwenden Sie das folgende Format:
SCHEMA SCHEMA_NAME
Dabei ist SCHEMA_NAME der Name Ihres Schemas in der Quelldatenbank.
CASE_HANDLING
Standardmäßig werden alle Objektnamen von Database Migration Service in Kleinbuchstaben umgewandelt.
Sie können die Anweisung CASE_HANDLING verwenden, um dieses Verhalten zu ändern.
- Diese Anweisung ist von der Anweisung
SCHEMAnicht betroffen. Sie funktioniert global und wirkt sich auf alle Objekte im Konvertierungsarbeitsbereich aus. - Die Anweisungen
RENAME_*,MOVE_*undREPLACE_*haben Vorrang vor der AnweisungCASE_HANDLINGund benennen Ihre Objekte unabhängig vom AttributCASE_HANDLINGgenau um. - Wenn diese Anweisung in mehreren Konfigurationsdateien mit widersprüchlichen Werten vorhanden ist, gibt Database Migration Service beim Schemaimport einen Fehler aus.
Verwenden Sie das folgende Format:
CASE_HANDLING OPTION
Der Wert für OPTION kann einer der folgenden sein:
UPPERCASE: Konvertiert alle Objektnamen in Großbuchstaben.LOWERCASE: Konvertiert alle Objektnamen in Kleinbuchstaben (Standardverhalten).PRESERVE_ORIGINAL: Behält die ursprüngliche Groß-/Kleinschreibung aus dem Quellschema bei. Das ist nützlich, wenn Ihre Anwendungen Kennungen mit Berücksichtigung der Groß-/Kleinschreibung verwenden.
Beispiel:
CASE_HANDLING PRESERVE_ORIGINAL
GENERATE_MISSING_PK
Bei Tabellen ohne Primärschlüssel ist keine konsistente Replikation gewährleistet. Database Migration Service migriert nur Tabellen mit Primärschlüsseln. Standardmäßig werden in Konvertierungsarbeitsbereichen von Database Migration Service automatisch alle fehlenden Primärschlüssel in den Zieltabellen erstellt, wenn Sie Quellcode und Schema konvertieren.
Sie können die automatische Primärschlüsselgenerierung mit der Anweisung GENERATE_MISSING_PK steuern. Wenn Sie die automatische Schlüsselgenerierung deaktivieren möchten, setzen Sie diese Anweisung auf 0.
Beispiel:
GENERATE_MISSING_PK 0
Diese Anweisung wirkt sich auf alle Objekte in einem bestimmten Konvertierungsarbeitsbereich aus. Es ist nicht möglich, die automatische Primärschlüsselgenerierung nur für eine bestimmte Tabelle zu deaktivieren.
Database Migration Service kann nur Tabellen migrieren, die in ihren konvertierten PostgreSQL-Versionen Primärschlüsseleinschränkungen haben. Wenn Sie die automatische Primärschlüsselgenerierung deaktivieren, müssen Sie nach dem Anwenden des konvertierten Schemas manuell Primärschlüssel oder eindeutige Einschränkungen in den konvertierten Tabellen in der Zieldatenbank erstellen. Maximieren Sie die folgenden Abschnitte, um SQL-Beispielbefehle zu sehen.
Primärschlüssel mit vorhandenen Spalten erstellen
Ihre Tabelle hat möglicherweise bereits einen logischen Primärschlüssel, der auf einer Spalte oder einer Kombination von Spalten basiert. Beispielsweise kann es Spalten mit einer eindeutigen Einschränkung oder einem eindeutigen Index geben. Verwenden Sie diese Spalten, um einen neuen Primärschlüssel für Tabellen in Ihrer Quelldatenbank zu generieren. Beispiel:
ALTER TABLE TABLE_NAME
ADD PRIMARY KEY (COLUMN_NAME);
Primärschlüssel mit allen Spalten erstellen
Wenn Sie keine bereits vorhandene Einschränkung haben, die als Primärschlüssel dienen könnte, erstellen Sie Primärschlüssel mit allen Spalten der Tabelle. Achten Sie darauf, dass Sie die maximale Länge des Primärschlüssels, die von Ihrem PostgreSQL-Cluster zulässig ist, nicht überschreiten. Beispiel:
ALTER TABLE TABLE_NAME
ADD PRIMARY KEY (COLUMN_NAME_1, COLUMN_NAME_2, COLUMN_NAME_3, ...);
Wenn Sie einen solchen zusammengesetzten Primärschlüssel erstellen, müssen Sie alle Spaltennamen, die Sie verwenden möchten, explizit auflisten. Es ist nicht möglich, eine Anweisung zu verwenden, um alle Spaltennamen für diesen Zweck abzurufen.
Eindeutige Einschränkung mit der Pseudospalte ROWID erstellen
Oracle-Datenbanken verwenden die Pseudospalte ROWID, um den Speicherort jeder Zeile in einer Tabelle zu speichern. Wenn Sie Oracle-Tabellen ohne Primärschlüssel migrieren möchten, können Sie in der PostgreSQL-Zieldatenbank eine ROWID-Spalte hinzufügen. Database Migration Service füllt die Spalte mit den entsprechenden numerischen Werten aus der Oracle-Pseudospalte ROWID der Quelle.
Führen Sie den folgenden Befehl aus, um die Spalte hinzuzufügen und als Primärschlüssel festzulegen:
ALTER TABLE TABLE_NAME ADD COLUMN rowid numeric(33,0) NOT NULL;
CREATE SEQUENCE TABLE_NAME_rowid_seq INCREMENT BY -1 START WITH -1 OWNED BY TABLE_NAME.rowid;
ALTER TABLE TABLE_NAME ALTER COLUMN rowid SET DEFAULT nextval('TABLE_NAME_rowid_seq');
ALTER TABLE TABLE_NAME ADD CONSTRAINT CONSTRAINT_DISPLAY_NAME PRIMARY KEY (rowid);
Objekte umbenennen (RENAME_*)
Sie können verschiedene Datenbankobjekte während der Konvertierung umbenennen. Database Migration Service aktualisiert automatisch alle Codereferenzen (in Ansichten, gespeicherten Prozeduren, Funktionen usw.), um die neuen Namen zu verwenden.
Allgemeine Syntax
RENAME_OBJECT_TYPE SOURCE_NAME1:DESTINATION_NAME1 SOURCE_NAME2:DESTINATION_NAME2 ...
Was Sie bedenken sollten
-
Bei den
RENAME_*-Anweisungen wird für den Namen des Zielobjekts die Groß-/Kleinschreibung beachtet und sie haben Vorrang vor derCASE_HANDLING-Anweisung. Wenn Sie beispielsweise beide Anweisungen verwenden:SCHEMA MySchema CASE_HANDLING PRESERVE_ORIGINAL # Destination objects are renamed exactly # to 'SoMe_tAbLe' and 'RenamedView', respecting the case # despite the CASE_HANDLING directive RENAME_TABLES some_table:SoMe_tAbLe RENAME_VIEWS MyView:RenamedView
-
Verwenden Sie für
SOURCE_NAMEimmer den ursprünglichen Objektnamen, auch wenn Sie andere Anweisungen wieMOVE_*verwenden. Wenn Sie beispielsweise eines Ihrer Ansichtsobjekte umbenennen und in ein neues Schema verschieben möchten, verweisen Sie für beide Anweisungen auf den ursprünglichen Ansichtsnamen:RENAME_VIEWS MyView:MyRenamedView MOVE_VIEWS MyView:MyOtherSchema
- Die Anweisung
RENAME_TABLESüberschreibt die AnweisungREPLACE_TABLESin einer einzelnen Datei. Wenn Sie eine Tabelle sowohl umbenennen als auch verschieben möchten, empfehlen wir stattdessen die Verwendung der AnweisungMOVE_*. -
Das vollständige Format der Variablen
SOURCE_NAMEhängt davon ab, ob Sie auch die AnweisungSCHEMAverwenden:- Mit der Anweisung
SCHEMA: Verwenden Sie nicht qualifizierte Namen, z. B.MyTable. - Ohne
SCHEMA-Anweisung: Verwenden Sie voll qualifizierte Namen, z. B.MySchema.MyTable.
- Mit der Anweisung
Unterstützte RENAME_*-Anweisungen
RENAME_SCHEMA: Benennt ein Schema um.
Eine einzelne Konfigurationsdatei kann nur eineRENAME_SCHEMA-Anweisung enthalten. Wenn die AnweisungSCHEMAangegeben ist, kannRENAME_SCHEMAnur dieses bestimmte Schema umbenennen.RENAME_TABLES: Benennt Tabellen um. Überschreibt dasREPLACE_TABLESin derselben Datei.RENAME_COLUMNS: Benennt Spalten in Tabellen um. Überschreibt dieREPLACE_COLS-Anweisung in derselben Datei. Verwenden Sie das folgende Format:RENAME_COLUMNS TABLE1.SRC_COL:DEST_COL TABLE2.SRC_COL:DEST_COL
Wenn Sie die Anweisung
SCHEMAverwenden, müssen Sie nicht qualifizierte Tabellennamen verwenden. Wenn Sie die AnweisungSCHEMAnicht verwenden, geben Sie die vollständig qualifizierten Tabellennamen an, z. B. SCHEMA.TABLE1.RENAME_VIEWSRENAME_MATERIALIZED_VIEWSRENAME_SEQUENCESRENAME_FUNCTIONSRENAME_STORED_PROCEDURESRENAME_TRIGGERS-
RENAME_PACKAGES: Database Migration Service konvertiert Oracle-Pakete in PostgreSQL-Schemas. Wenn Ihr Schema Pakete mit identischen Namen enthält, kann es im PostgreSQL-Code zu Namenskonflikten kommen, wenn versucht wird, zwei Schemas mit demselben Namen zu erstellen. Mit dieser Anweisung können Sie solche Konflikte vermeiden.Wenn Sie beispielsweise Pakete wie
SALES.REPORTING_PKGundHR.REPORTING_PKGhaben, können Sie sie in eindeutige Namen umbenennen:RENAME_PACKAGES SALES.UTILS:SALES_UTILS RENAME_PACKAGES HR.UTILS:HR_UTILS
RENAME_USER_DEFINED_TYPESVerfügbarer Alias:
RENAME_UDTS.
Objekte werden verschoben (MOVE_*)
Sie können Objekte in verschiedene Schemas in der Zieldatenbank verschieben. Das ist nützlich, um die Datenbankstruktur während der Migration neu zu organisieren. Database Migration Service aktualisiert automatisch alle Codereferenzen in Ansichten, gespeicherten Prozeduren, Funktionen usw.
Allgemeine Syntax
MOVE_OBJECT_TYPE SOURCE_NAME1:DESTINATION_SCHEMA1 SOURCE_NAME2:DESTINATION_SCHEMA2 ...
Was Sie bedenken sollten
-
Verwenden Sie für
SOURCE_NAMEimmer den ursprünglichen Objektnamen, auch wenn Sie andere Anweisungen wieRENAME_*verwenden. Wenn Sie beispielsweise eines Ihrer Ansichtsobjekte umbenennen und in ein neues Schema verschieben möchten, verweisen Sie für beide Anweisungen auf den ursprünglichen Ansichtsnamen:RENAME_VIEWS MyView:MyRenamedView MOVE_VIEWS MyView:MyOtherSchema
- Die Anweisung erwartet nur den
DESTINATION_SCHEMA-Namen, nicht den vollständigen Objektnamen. -
Das vollständige Format der Variablen
SOURCE_NAMEhängt davon ab, ob Sie auch die AnweisungSCHEMAverwenden:- Mit der Anweisung
SCHEMA: Verwenden Sie nicht qualifizierte Namen, z. B.MyTable. - Ohne
SCHEMA-Anweisung: Verwenden Sie voll qualifizierte Namen, z. B.MySchema.MyTable.
- Mit der Anweisung
Unterstützte MOVE_*-Anweisungen
MOVE_TABLES: Verschiebt Tabellen in ein anderes Schema. Hat Vorrang vorREPLACE_TABLESfür Schemaänderungen in einer einzelnen Konfigurationsdatei.MOVE_VIEWSMOVE_MATERIALIZED_VIEWSMOVE_SEQUENCESMOVE_FUNCTIONSMOVE_STORED_PROCEDURESMOVE_USER_DEFINED_TYPESVerfügbarer Alias:
MOVE_UDTS.
Beispiel: Schemas neu organisieren
SCHEMA LegacyApp

# Moves the 'LegacyApp.Users' and 'LegacyApp.Orders' tables
# to the 'data' schema.
MOVE_TABLES Users:data Orders:data

# Moves the 'LegacyApp.CreateUser' and 'LegacyApp.ProcessOrder'
# stored procedures to the 'api' schema
MOVE_STORED_PROCEDURES CreateUser:api ProcessOrder:api

# Moves the 'LegacyApp.SalesSummary' views to the 'reporting' schema
MOVE_VIEWS SalesSummary:reporting
DATA_TYPE
Mit dieser Anweisung können Sie jeden unterstützten Datentyp explizit zwischen der Oracle- und der PostgreSQL-Syntax zuordnen. Diese Anweisung erwartet eine Liste von Zuordnungen, die durch Kommas getrennt sind. Die gesamte Definition muss in einer einzigen Zeile angegeben werden. Sie können jedoch mehrere DATA_TYPE-Anweisungen in Ihre Konfigurationsdatei aufnehmen. Verwenden Sie das folgende Format:
DATA_TYPE ORACLE_DATA_TYPE1:PGSQL_DATA_TYPE1
DATA_TYPE ORACLE_DATA_TYPE2:PGSQL_DATA_TYPE2...
Dabei sind ORACLE_DATA_TYPE und PGSQL_DATA_TYPE Datentypen, die von den jeweiligen Oracle- und PostgreSQL-Versionen unterstützt werden, die Sie bei der Migration verwenden. Informationen zu unterstützten Versionen finden Sie unter Szenarioübersicht.
Beispiel:
DATA_TYPE REAL:double precision,SMALLINT:integer
Weitere Informationen zu Oracle- und PostgreSQL-Datentypen finden Sie hier:
- Oracle-Datentypen in der Oracle-Dokumentation.
- PostgreSQL-Datentypen in der PostgreSQL-Dokumentation.
MODIFY_TYPE
Mit der Anweisung MODIFY_TYPE können Sie steuern, in welchen Datentyp Database Migration Service eine bestimmte Spalte in der Quelltabelle konvertiert.
Diese Anweisung erwartet eine Liste von Zuordnungen, die durch Kommas getrennt sind.
Die gesamte Definition muss in einer einzigen Zeile angegeben werden. Sie können jedoch mehrere MODIFY_TYPE-Anweisungen in Ihre Konfigurationsdatei aufnehmen.
Verwenden Sie das folgende Format:
MODIFY_TYPE SOURCE_TABLE_NAME1:COLUMN_NAME:EXPECTED_END_RESULT_DATA_TYPE
MODIFY_TYPE SOURCE_TABLE_NAME2:COLUMN_NAME:EXPECTED_END_RESULT_DATA_TYPE...
Wobei:
- SOURCE_TABLE_NAME ist der Name der Tabelle, die die Spalte enthält, in der Sie den Datentyp ändern möchten.
- COLUMN_NAME ist der Name der Spalte, für die Sie die Konvertierungszuordnung anpassen möchten.
- EXPECTED_END_RESULT_DATA_TYPE ist der PostgreSQL-Datentyp, den die konvertierte Spalte verwenden soll.
Beispiel:
MODIFY_TYPE events:dates_and_times:DATETIME,users:pseudonym:TEXT
PG_INTEGER_TYPE
Standardmäßig konvertiert Database Migration Service die NUMBER(p,s)-Typen in den PostgreSQL-Typ DECIMAL(p,s).
Sie können dieses Verhalten mit der Anweisung PG_INTEGER_TYPE ändern. Legen Sie den Wert auf 1 fest und erzwingen Sie, dass alle NUMBER-Typen mit Genauigkeit und Skalierung (NUMBER(p,s)) basierend auf der Anzahl der Genauigkeitsziffern in PostgreSQL-Typen smallint, integer oder bigint konvertiert werden.
Fügen Sie die folgende Einstellung in die Datei für die Conversion-Zuordnung ein:
PG_INTEGER_TYPE 1
PG_NUMERIC_TYPE
Legen Sie diese Anweisung auf 1 fest, wenn Sie alle NUMBER-Typen mit Genauigkeit und Skalierung (NUMBER(p,s)) in PostgreSQL-real- oder float-Typen konvertieren möchten (basierend auf der Anzahl der Genauigkeitsziffern).
Wenn Sie diese Anweisung auf 0 setzen, behalten Ihre NUMBER(p,s)-Werte ihren genauen ursprünglichen Wert bei und verwenden den internen PostgreSQL-Datentyp.
Fügen Sie die folgende Einstellung in die Datei für die Conversion-Zuordnung ein:
PG_NUMERIC_TYPE 1
DEFAULT_NUMERIC
Die Standardkonvertierung für NUMBERs ohne Genauigkeit ändert sich, wenn Sie auch die PG_INTEGER_TYPE-Anweisung verwenden:
- Wenn Sie die Anweisung
PG_INTEGERverwenden, werdenNUMBER-Werte ohne Genauigkeit inDECIMAL-Werte konvertiert. - Wenn Sie die Anweisung
PG_INTEGERnicht verwenden, werdenNUMBER-Werte ohne Genauigkeit inBIGINT-Werte konvertiert.
Sie können dieses Verhalten ändern und mit der Anweisung DEFAULT_NUMERIC angeben, welcher Datentyp für NUMBER-Typen ohne angegebene Genauigkeitspunkte verwendet werden soll.
Verwenden Sie das folgende Format:
DEFAULT_NUMERIC POSTGRESQL_NUMERIC_DATA_TYPE
Dabei ist POSTGRESQL_NUMERIC_DATA_TYPE einer der folgenden Werte: integer, smallint, bigint.
Beispiel:
DEFAULT_NUMERIC integer
REPLACE_COLS
Mit der Anweisung REPLACE_COLS können Sie Spalten im konvertierten Schema umbenennen. Diese Anweisung erwartet eine Liste von Zuordnungen, die durch Kommas getrennt sind.
Verwenden Sie das folgende Format:
REPLACE_COLS SOURCE_TABLE_NAME1(SOURCE1_TABLE1_COLUMN_NAME1:DESTINATION_TABLE1_COLUMN_NAME1,SOURCE_TABLE1_COLUMN_NAME2:DESTINATION_TABLE1_COLUMN_NAME2),SOURCE_TABLE_NAME2(SOURCE_TABLE2_COLUMN_NAME1:DESTINATION_TABLE2_COLUMN_NAME1,SOURCE_TABLE2_COLUMN_NAME2:DESTINATION_TABLE2_COLUMN_NAME2)...
Wobei:
- SOURCE_TABLE_NAME ist der Name der Tabelle, die die Spalte enthält, deren Name Sie ändern möchten. Wenn Sie die Anweisung SCHEMA nicht verwenden, müssen Sie den vollständig qualifizierten Tabellennamen verwenden:
SCHEMA_NAME.SOURCE_TABLE_NAME - SOURCE_COLUMN_NAME ist der Name der Spalte in Ihrer Quelle, deren Name Sie ändern möchten.
- DESTINATION_COLUMN_NAME ist der neue Name für die Spalte, die Sie im konvertierten Schema verwenden möchten.
Beispiel:
REPLACE_COLS events(dates_and_times:event_dates),users(pseudonym:nickname)
REPLACE_TABLES
Mit der Anweisung REPLACE_TABLES können Sie Tabellen umbenennen oder in ein neues Schema verschieben. Diese Anweisung erwartet eine Liste von Zuordnungen, die durch Leerzeichen getrennt sind. Weitere Informationen zur Syntax für die einzelnen Anwendungsfälle finden Sie in den folgenden Abschnitten.
Wenn Sie die Anweisung SCHEMA nicht verwenden, müssen Sie die voll qualifizierten Tabellennamen in Anführungszeichen für die Quell- und Zielvariablen verwenden:
"SCHEMA_NAME.SOURCE_TABLE_NAME""SCHEMA_NAME.DESTINATION_TABLE_NAME"
Tabellen umbenennen
Verwenden Sie das folgende Format, um Tabellen in Ihrem konvertierten Schema umzubenennen:
REPLACE_TABLES SOURCE_TABLE_NAME1:DESTINATION_TABLE_NAME1 SOURCE_TABLE_NAME2:DESTINATION_TABLE_NAME2
Wobei:
- SOURCE_TABLE_NAME ist der Name der Quelltabelle, die Sie im konvertierten Schema umbenennen möchten.
- DESTINATION_TABLE_NAME ist der neue Name für die Tabelle, die Sie im konvertierten Schema verwenden möchten.
Beispiel:
REPLACE_TABLES "events:login_events" "users:platform_users"
Tabellen zwischen Schemas verschieben
Sie können diese Anweisung verwenden, um Tabellen zwischen Schemas zu verschieben, indem Sie dem neuen Tabellennamen das Schemapräfix hinzufügen. Dieser Mechanismus kann unabhängig davon verwendet werden, wie Sie die Anweisung SCHEMA für die gesamte Konvertierungsdatei verwenden. Beispiel:
REPLACE_TABLES "events:NEW_SCHEMA_NAME.login_events"
Aliasse zum Anpassen von Datentypen
Wenn Sie Konvertierungsanweisungen verwenden, um die Konvertierung verschiedener Datentypen durch den Database Migration Service zu ändern (z. B. mit den Anweisungen DATA_TYPE, MODIFY_TYPE oder PG_NUMERIC_TYPE), können Sie Aliase anstelle Ihrer SQL-Quelldatentypen verwenden.
Erweitern Sie den folgenden Abschnitt, um die Liste der von Database Migration Service unterstützten Datentyp-Aliasse aufzurufen.
Datentyp-Aliasse
| Alias | In PostgreSQL-Typ konvertiert |
|---|---|
bigint, int8 |
BIGINT |
bool, boolean |
BOOLEAN |
bytea |
BYTEA |
char, character |
CHAR |
character varying, varchar |
VARCHAR |
date |
DATE |
decimal, numeric |
DECIMAL |
double precision, float8 |
DOUBLE PRECISION |
real, float4 |
REAL |
int, integer, int4 |
INTEGER |
int2 |
SMALLINT |
interval |
INTERVAL |
json |
JSON |
smallint |
SMALLINT |
text |
TEXT |
time |
TIME |
timestamp |
TIMESTAMP |
timestamptz |
TIMESTAMPTZ |
timetz |
TIMETZ |
uuid |
UUID |
XML |
XML |
Beispieldatei für die Conversion-Zuordnung
Hier sehen Sie eine Beispiel-Conversion-Zuordnungsdatei, in der einige der unterstützten Schemakonvertierungsanweisungen verwendet werden:
EXPORT_SCHEMA 1
SCHEMA root

# Preserve original casing for all objects
CASE_HANDLING PRESERVE_ORIGINAL

# Data type conversions
PG_NUMERIC_TYPE 0
PG_INTEGER_TYPE 1
DEFAULT_NUMERIC integer
DATA_TYPE NUMBER(4\,0):integer
MODIFY_TYPE events:dates_and_times:TIMESTAMP

# Renaming objects using the RENAME_* directives
# These allow case-sensitive destination names
RENAME_TABLES events:LoginEvents users:PlatformUsers
RENAME_COLUMNS events.dates_and_times:EventDates users.pseudonym:Nickname
RENAME_VIEWS InternalReport:FinInternalReport

# Moving objects to new schemas using the MOVE_* directives
MOVE_TABLES audit_log:archive
MOVE_VIEWS InternalReport:reporting
Die Verwendung dieser Datei hat folgende Auswirkungen:
EXPORT_SCHEMA 1ist eine erforderliche Anweisung.SCHEMA rootbewirkt, dass die anderen Anweisungen auf Objekte im Schemarootangewendet werden, sofern keine vollständig qualifizierten Namen verwendet werden.CASE_HANDLING PRESERVE_ORIGINALsorgt dafür, dass alle Objektnamen aus dem Quellschemarootim Ziel ihre ursprüngliche Groß-/Kleinschreibung beibehalten (sofern sie nicht durch eineRENAME_*-Anweisung überschrieben werden).PG_INTEGER_TYPE 1sorgt dafür, dass Database Migration Service alle numerischen Oracle-Datentypen, die in Tabellen im Schemarootgefunden werden, in PostgreSQL-spezifische Typen anstatt in portable numerische ANSI-Typen konvertiert.DEFAULT_NUMERIC integerbewirkt, dass Database Migration ServiceNUMBER-Werte ohne angegebenen Genauigkeitspunkt in den PostgreSQL-TypINTEGERkonvertiert.DATA_TYPE NUMBER(4\,0):integerbewirkt, dass Database Migration Service bestimmteNUMBER(4,0)-Werte in PostgreSQL-INTEGERkonvertiert.- Die Anweisung
MODIFY_TYPE events:dates_and_times:TIMESTAMPbewirkt, dass Database Migration Service die Daten in der Spaltedates_and_timesin der Quelltabelleeventsspeziell in den PostgreSQL-TypTIMESTAMPkonvertiert. RENAME_TABLES events:LoginEvents users:PlatformUsersbenennt Tabellen um und behält die angegebene Groß-/Kleinschreibung bei:- Die Tabelle
eventswird inLoginEventsumbenannt. - Die Tabelle
userswird inPlatformUsersumbenannt.
- Die Tabelle
RENAME_COLUMNS events.dates_and_times:EventDates user.pseudonym:Nicknamebenennt Spalten um und behält die angegebene Groß-/Kleinschreibung im Ziel bei:- In der Tabelle
LoginEvents(ursprünglicher Nameevents) wird die Spaltedates_and_timesinEventDatesumbenannt. - In
PlatformUsers(ursprünglicher Nameusers) wird die SpaltepseudonyminNicknameumbenannt.
- In der Tabelle
RENAME_VIEWS InternalReport:FinInternalReportbenennt die AnsichtInternalReportinFinInternalReportum.MOVE_TABLES audit_log:archiveverschiebt die Tabelleaudit_logvom Schemarootin das Schemaarchive.MOVE_VIEWS InternalReport:reportingverschiebt die AnsichtInternalReportin das Schemareporting. Diese Ansicht wird aufgrund der AnweisungRENAME_VIEWSauch inFinInternalReportumbenannt. Database Migration Service verarbeitet die Abhängigkeit: Das Objekt wird zuerst umbenannt und dann verschoben.
Nächste Schritte
Weitere Informationen zur Verwendung von Konvertierungsarbeitsbereichen finden Sie hier: