


コンバージョン ワークスペースでは、移行元のデータベースのスキーマとオブジェクトを、移行先のデータベースが対応している SQL 構文に変換できます。このページでは、Database Migration Service のコンバージョン ワークスペースの概要について説明します。
ソーススキーマの初期化オプションでは、データベースに直接接続するか、スキーマ ファイルを Cloud Storage にアップロードして、ワークスペースにデータを入力する方法について説明します。
コンバージョンの概要には、スキーマ変換の進行状況の断面が表示されます。
決定論的なコードとスキーマ変換でサポートされているオブジェクトには、決定論的なスキーマ変換でサポートされている Oracle オブジェクトが一覧表示されます。
インタラクティブ SQL エディタでは、コンバージョン ワークスペース エディタで直接変更できるオブジェクトについて説明します。
Gemini を活用した変換機能では、生成 AI のサポートを統合してスキーマ変換プロセスを迅速化する方法について説明します。
コンバージョン マッピング ファイルのセクションでは、決定論的スキーマ変換のルールをオーバーライドするために使用できるカスタマイズ ディレクティブの概要について説明します。
レガシー コンバージョン ワークスペースでは、インタラクティブ SQL エディタをサポートしていないレガシー ワークスペースについて説明します。
Oracle の移行でサポートされていないデータ型があります。詳細については、 データ型の既知の制限事項をご覧ください。
ソーススキーマの初期化オプション
データベース スキーマを変換するには、Database Migration Service でソース データベース オブジェクトの初期スナップショットが必要です。このスナップショットは、次の 2 つの方法で指定できます。
- 直接データベース接続: Database Migration Service は、接続プロファイルを介して実行中のソース データベースに直接接続し、ネットワーク接続を介してスキーマを取得します。
- Cloud Storage のスキーマ ファイル: Google 提供の抽出スクリプトを使用してスキーマ メタデータをローカルに抽出し、生成されたファイルを Cloud Storage バケットにアップロードして、ソース データベースに接続せずにワークスペースを準備できます。
直接データベース接続または Cloud Storage のスキーマ ファイルを使用してコンバージョン ワークスペースを作成する方法については、コンバージョン ワークスペースを作成するをご覧ください。
コンバージョンの進捗状況の概要
コンバージョン ワークスペースの概要情報。未解決または解決済みのコンバージョンに関する問題の総数、Gemini による拡張、コンバージョン プロセスの一般的な健全性に関する分析情報を確認できます。
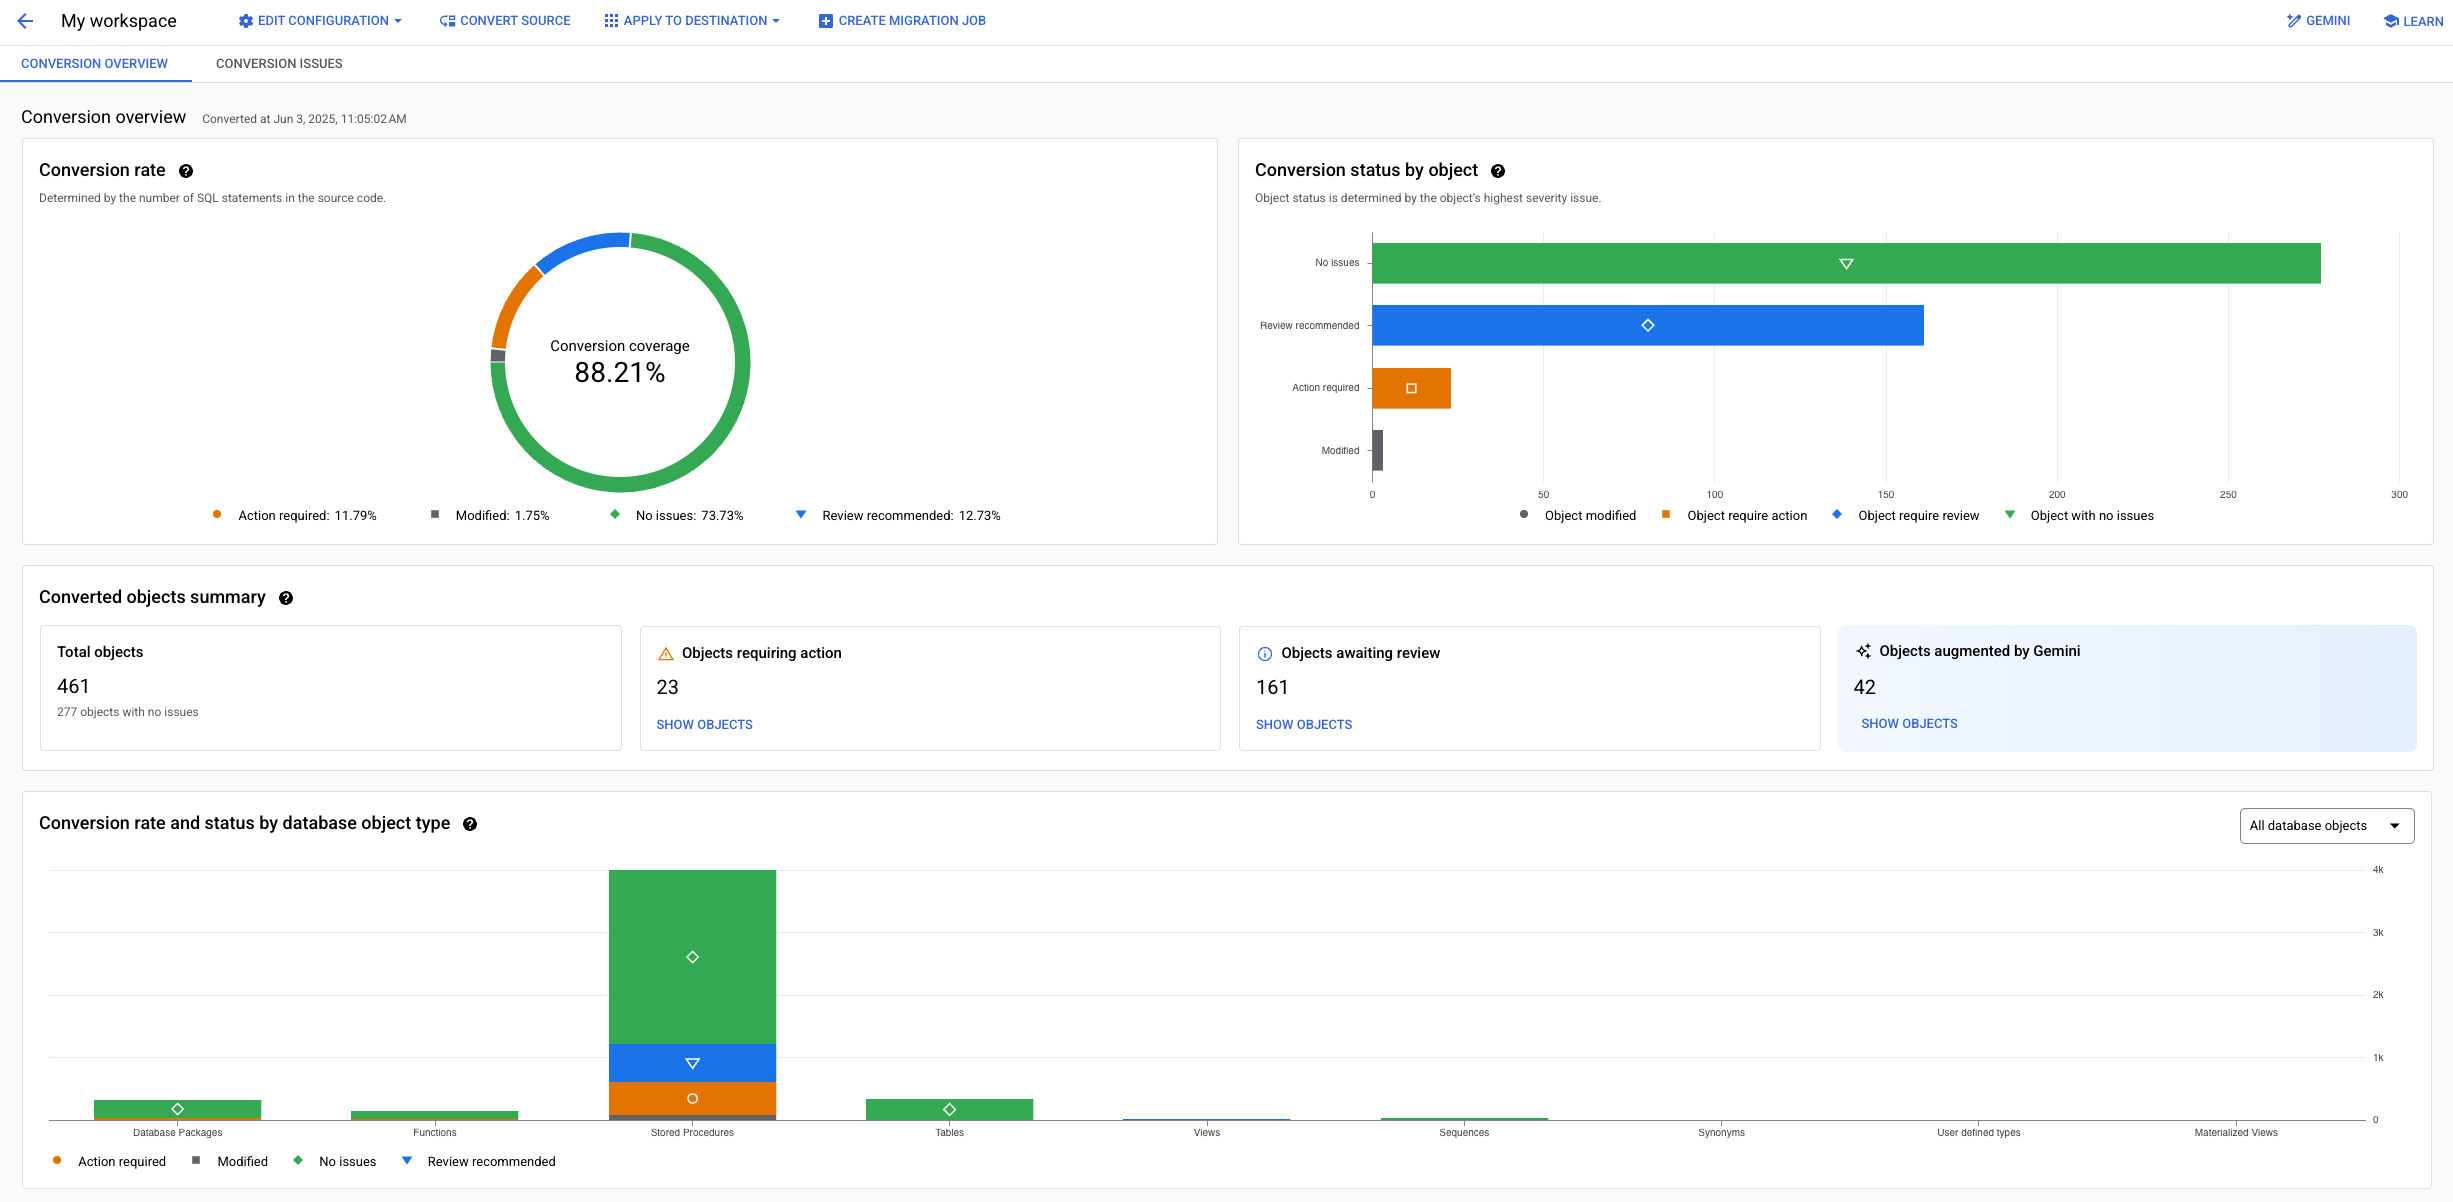
このビューを使用すると、スキーマ内のオブジェクトをタイプ、問題の重大度、対応が必要なアクション、変換ステータスでフィルタできます。

コンバージョンの概要を使用してコンバージョン結果を検査する方法については、 コンバージョン ワークスペースを操作するをご覧ください。
決定的コードとスキーマの変換
変換ワークスペースを作成すると、Database Migration Service は、特定の Oracle データ型とオブジェクトが特定の PostgreSQL データ型とオブジェクトにマッピングされる一連の決定論的な変換ルールを使用して、初期スキーマ変換をすぐに実行します。このプロセスは、使用可能な Oracle データベース オブジェクトの非常に特定のサブセットをサポートします。
決定的コード変換では、次の Oracle データベース オブジェクトがサポートされています。
サポートされている Oracle スキーマ要素
- 制約
- インデックス(テーブルと同じスキーマで作成されたインデックスのみ)
- マテリアライズド ビュー
- オブジェクト タイプ(部分的なサポート)
- シーケンス
- 類義語
- テーブル
- ビュー
サポートされている Oracle コード要素
- トリガー(テーブルレベルのみ)
- パッケージ
- 関数
- ストアド プロシージャ
インタラクティブ SQL エディタ
インタラクティブな SQL エディタを使用すると、変換された PostgreSQL 構文を Database Migration Service で直接変更できます。これを使用して、変換の問題を修正したり、ニーズに合わせてスキーマを調整したりできます。一部のオブジェクトは、組み込みエディタで変更できません。
編集可能な Oracle オブジェクト
ソース データベースのコードとスキーマを変換したら、インタラクティブ エディタを使用して、特定のタイプのオブジェクトに対して生成された SQL を変更できます。エディタでは、次の Oracle オブジェクトがサポートされています。
- テーブル トリガー(権限が必要)
- マテリアライズド ビュー
- パッケージ
- 関数、ストアド プロシージャ
- 類義語
- ビュー
- 制約
- インデックス
- シーケンス
また、一部のオブジェクトは変換されますが、Database Migration Service 内で直接編集することはできません。このようなオブジェクトを変更するには、 変換されたスキーマとコードを適用した後に、移行先データベースで直接更新を行う必要があります。
編集がサポートされていないオブジェクト:
- ユーザー定義のオブジェクト タイプ
- テーブル
- スキーマ
Gemini でコードとスキーマの変換を加速
Database Migration Service は、Gemini for Google Cloud をコンバージョン ワークスペースに統合し、次の領域でコンバージョン プロセスの高速化と改善を支援します。
Gemini を活用した自動変換で決定的変換の結果を強化し、AI の力を活用して、PostgreSQL コードで必要な手動調整の数を大幅に削減します。
Gemini を活用した品質評価により、変換されたコードの品質と機能の同等性を確保します。これらの評価では、変換されたコードを分析し、ソースコードと比較してその正確性と機能性に関するフィードバックを提供します。
変換アシスタントでコードの説明機能を提供します。これは、変換ロジックの理解、変換に関する問題の修正の提案、変換されたコードの最適化に役立つ一連の専用プロンプトです。
Gemini のコード変換の提案を使用して、コンバージョンの問題の修正を迅速に適用します。これは、コンバージョンの問題を修正する際に Gemini モデルが学習し、ワークスペース内の他の問題のあるオブジェクトに変更を提案するメカニズムです。
Gemini を活用した変換の詳細については、以下のページをご覧ください。
コンバージョン マッピング ファイル
変換ロジックは、変換マッピング ファイルを使用してカスタマイズできます。変換マッピング ファイルは、Oracle オブジェクトを PostgreSQL オブジェクトに変換する方法に関する正確な指示(変換ディレクティブ)を含むテキスト ファイルです。
サポートされている変換ディレクティブ
Database Migration Service は、変換マッピング ファイルに対して次の変換ディレクティブをサポートしています。
EXPORT_SCHEMA
EXPORT_SCHEMA は、すべての変換マッピング ファイルに必須のディレクティブです。Database Migration Service では、移行元スキーマが正しい移行先スキーマに変換されるように、この指示が必要です。コンバージョン マッピング ファイルに次の行が含まれていることを確認します。
EXPORT_SCHEMA 1
SCHEMA
Database Migration Service は、変換ディレクティブで変更する必要があるオブジェクトを含むスキーマを特定できる必要があります。SCHEMA ディレクティブを使用すると、ファイルで指定された他のすべてのカスタマイズ ディレクティブが、この特定のスキーマのオブジェクトに適用されます。
- このディレクティブを使用すると、データベースに含まれる他のスキーマも変換されますが、そのオブジェクトは変更されません。
- このディレクティブを変換マッピング ファイルに含めると、すべてのカスタマイズがこの特定のスキーマに含まれるオブジェクトにのみ適用されます。
- このディレクティブをスキップする場合は、他の変換ディレクティブによって変更されたオブジェクトのスキーマ名を含む完全修飾オブジェクト名を指定する必要があります。たとえば、
REPLACE_TABLESディレクティブにSOURCE_TABLE_NAMEを使用する代わりに、"SCHEMA_NAME.SOURCE_TABLE_NAME"を使用する必要があります。 - 異なるスキーマのオブジェクトをカスタマイズするには、次の操作を行います。
- 他のスキーマ用に個別の変換マッピング ファイルを作成し、コンバージョン ワークスペースにアップロードします。
SCHEMAディレクティブに指定したスキーマとは異なるスキーマに存在するオブジェクトには、スキーマ名を含む完全修飾オブジェクト名を使用します。
形式は次のようにします。
SCHEMA SCHEMA_NAME
ここで、SCHEMA_NAME はソース データベースのスキーマの名前です。
CASE_HANDLING
デフォルトでは、Database Migration Service はすべてのオブジェクト名を小文字に変換します。この動作は、CASE_HANDLING ディレクティブを使用して変更できます。
- このディレクティブは、
SCHEMAディレクティブの影響を受けません。これはグローバルに機能し、コンバージョン ワークスペース内のすべてのオブジェクトに影響します。 RENAME_*、MOVE_*、REPLACE_*ディレクティブはCASE_HANDLINGディレクティブよりも優先され、CASE_HANDLINGプロパティに関係なく、オブジェクトの名前を正確に変更します。- このディレクティブが複数の構成ファイルに存在し、値が競合している場合、Database Migration Service はスキーマのインポート中にエラーを発生させます。
形式は次のようにします。
CASE_HANDLING OPTION
ここで、OPTION には次のいずれか 1 つを指定できます。
UPPERCASE: すべてのオブジェクト名を大文字に変換します。LOWERCASE: すべてのオブジェクト名を小文字に変換します(デフォルトの動作)。PRESERVE_ORIGINAL: ソーススキーマの元の大文字と小文字を保持します。これは、アプリケーションで大文字と小文字を区別する識別子を使用する場合に便利です。
例:
CASE_HANDLING PRESERVE_ORIGINAL
GENERATE_MISSING_PK
主キーのないテーブルでは、一貫したレプリケーションが保証されません。Database Migration Service は、主キーを持つテーブルのみを移行します。デフォルトでは、Database Migration Service コンバージョン ワークスペースは、 ソースコードとスキーマを変換するときに、宛先テーブルに欠落している主キーを自動的に作成します。
主キーの自動生成は、GENERATE_MISSING_PK ディレクティブで制御できます。鍵の自動生成を無効にするには、このディレクティブを 0 に設定します。
例:
GENERATE_MISSING_PK 0
このディレクティブは、特定のコンバージョン ワークスペース内のすべてのオブジェクトに影響します。特定のテーブルに対してのみ主キーの自動生成を無効にすることはできません。
Database Migration Service で移行できるのは、変換後の PostgreSQL バージョンで主キー制約があるテーブルのみです。主キーの自動生成を無効にした場合は、変換されたスキーマを適用した後、移行先データベースの変換されたテーブルに主キーまたは一意制約を手動で作成する必要があります。SQL コマンドのサンプルについては、次のセクションを開いてください。
既存の列を使用して主キーを作成する
テーブルには、列または列の組み合わせに基づく論理主キーがすでに存在する場合があります。たとえば、一意の制約またはインデックスが構成された列が存在する場合があります。これらの列を使用して、ソース データベースのテーブルに新しい主キーを生成します。次に例を示します。
ALTER TABLE TABLE_NAME
ADD PRIMARY KEY (COLUMN_NAME);
すべての列を使用して主キーを作成する
主キーとして機能する既存の制約がない場合は、テーブルのすべての列を使用して主キーを作成します。PostgreSQL クラスタで許可されている主キーの最大長を超えないようにしてください。次に例を示します。
ALTER TABLE TABLE_NAME
ADD PRIMARY KEY (COLUMN_NAME_1, COLUMN_NAME_2, COLUMN_NAME_3, ...);
このような複合主キーを作成する場合は、使用するすべての列名を明示的にリストする必要があります。この目的のために、ステートメントを使用してすべての列名を取得することはできません。
ROWID 疑似列を使用して一意の制約を作成する
Oracle データベースでは、
ROWID 疑似列を使用して、テーブル内の各行の場所を保存します。主キーのない Oracle テーブルを移行するには、移行先の PostgreSQL データベースに ROWID 列を追加します。Database Migration Service は、ソース Oracle ROWID 疑似列の対応する数値で列に値を入力します。
列を追加して主キーとして設定するには、次のコマンドを実行します。
ALTER TABLE TABLE_NAME ADD COLUMN rowid numeric(33,0) NOT NULL;
CREATE SEQUENCE TABLE_NAME_rowid_seq INCREMENT BY -1 START WITH -1 OWNED BY TABLE_NAME.rowid;
ALTER TABLE TABLE_NAME ALTER COLUMN rowid SET DEFAULT nextval('TABLE_NAME_rowid_seq');
ALTER TABLE TABLE_NAME ADD CONSTRAINT CONSTRAINT_DISPLAY_NAME PRIMARY KEY (rowid);
オブジェクトの名前を変更する(RENAME_*)
変換中に、さまざまなデータベース オブジェクトの名前を変更できます。Database Migration Service は、新しい名前を使用するように、すべてのコード参照(ビュー、ストアド プロシージャ、関数など)を自動的に更新します。
一般的な構文
RENAME_OBJECT_TYPE SOURCE_NAME1:DESTINATION_NAME1 SOURCE_NAME2:DESTINATION_NAME2 ...
重要な考慮事項
-
RENAME_*ディレクティブでは、宛先オブジェクト名の大文字と小文字が区別され、CASE_HANDLINGディレクティブよりも優先されます。たとえば、両方のディレクティブを使用する場合、次のようになります。SCHEMA MySchema CASE_HANDLING PRESERVE_ORIGINAL # Destination objects are renamed exactly # to 'SoMe_tAbLe' and 'RenamedView', respecting the case # despite the CASE_HANDLING directive RENAME_TABLES some_table:SoMe_tAbLe RENAME_VIEWS MyView:RenamedView
-
SOURCE_NAMEの場合は、MOVE_*などの他のディレクティブを使用する場合でも、常に元のオブジェクト名を参照してください。たとえば、ビュー オブジェクトの名前を変更して新しいスキーマに移動する場合は、両方のディレクティブで元のビュー名を参照します。RENAME_VIEWS MyView:MyRenamedView MOVE_VIEWS MyView:MyOtherSchema
RENAME_TABLESディレクティブは、1 つのファイルのREPLACE_TABLESディレクティブをオーバーライドします。テーブルの名前変更と移動の両方を行う場合は、代わりにMOVE_*ディレクティブを使用することをおすすめします。-
SOURCE_NAME変数の完全な形式は、SCHEMAディレクティブも使用するかどうかによって異なります。SCHEMAディレクティブを使用する場合: 非修飾名(MyTableなど)を使用します。SCHEMAディレクティブなし: 完全修飾名(MySchema.MyTableなど)を使用します。
サポートされている RENAME_* ディレクティブ
RENAME_SCHEMA: スキーマの名前を変更します。
1 つの構成ファイルに含めることができるRENAME_SCHEMAディレクティブは 1 つだけです。SCHEMAディレクティブが指定されている場合、RENAME_SCHEMAはその特定のスキーマの名前のみを変更できます。RENAME_TABLES: テーブルの名前を変更します。同じファイルのREPLACE_TABLESをオーバーライドします。RENAME_COLUMNS: テーブル内の列の名前を変更します。同じファイルのREPLACE_COLSディレクティブをオーバーライドします。 形式は次のようにします。RENAME_COLUMNS TABLE1.SRC_COL:DEST_COL TABLE2.SRC_COL:DEST_COL
SCHEMAディレクティブを使用する場合は、非修飾テーブル名を使用します。SCHEMAディレクティブを使用しない場合は、SCHEMA.TABLE1 などの完全修飾テーブル名を含めます。RENAME_VIEWSRENAME_MATERIALIZED_VIEWSRENAME_SEQUENCESRENAME_FUNCTIONSRENAME_STORED_PROCEDURESRENAME_TRIGGERS-
RENAME_PACKAGES: Database Migration Service は、Oracle パッケージを PostgreSQL スキーマに変換します。スキーマに名前を共有するパッケージが含まれている場合、PostgreSQL コードが同じ名前の 2 つのスキーマを作成しようとすると、名前の競合が発生する可能性があります。このディレクティブを使用すると、このような競合を回避できます。たとえば、
SALES.REPORTING_PKGやHR.REPORTING_PKGなどのパッケージがある場合は、次のように別の名前に変更できます。RENAME_PACKAGES SALES.UTILS:SALES_UTILS RENAME_PACKAGES HR.UTILS:HR_UTILS
RENAME_USER_DEFINED_TYPES使用可能なエイリアス:
RENAME_UDTS。
オブジェクトの移動(MOVE_*)
オブジェクトを移行先データベースの別のスキーマに移動できます。これは、移行中にデータベース構造を再編成する場合に便利です。Database Migration Service は、ビュー、ストアド プロシージャ、関数などのすべてのコード参照を自動的に更新します。
一般的な構文
MOVE_OBJECT_TYPE SOURCE_NAME1:DESTINATION_SCHEMA1 SOURCE_NAME2:DESTINATION_SCHEMA2 ...
重要な考慮事項
-
SOURCE_NAMEの場合は、RENAME_*などの他のディレクティブを使用する場合でも、常に元のオブジェクト名を参照してください。たとえば、ビュー オブジェクトの名前を変更して新しいスキーマに移動する場合は、両方のディレクティブで元のビュー名を参照します。RENAME_VIEWS MyView:MyRenamedView MOVE_VIEWS MyView:MyOtherSchema
- このディレクティブには、完全なオブジェクト名ではなく、
DESTINATION_SCHEMA名のみを指定します。 -
SOURCE_NAME変数の完全な形式は、SCHEMAディレクティブも使用するかどうかによって異なります。SCHEMAディレクティブを使用する場合: 非修飾名(MyTableなど)を使用します。SCHEMAディレクティブなし: 完全修飾名(MySchema.MyTableなど)を使用します。
サポートされている MOVE_* ディレクティブ
MOVE_TABLES: テーブルを別のスキーマに移動します。単一の構成ファイルでのスキーマ変更では、REPLACE_TABLESよりも優先されます。MOVE_VIEWSMOVE_MATERIALIZED_VIEWSMOVE_SEQUENCESMOVE_FUNCTIONSMOVE_STORED_PROCEDURESMOVE_USER_DEFINED_TYPES使用可能なエイリアス:
MOVE_UDTS。
例: スキーマの再編成
SCHEMA LegacyApp

# Moves the 'LegacyApp.Users' and 'LegacyApp.Orders' tables
# to the 'data' schema.
MOVE_TABLES Users:data Orders:data

# Moves the 'LegacyApp.CreateUser' and 'LegacyApp.ProcessOrder'
# stored procedures to the 'api' schema
MOVE_STORED_PROCEDURES CreateUser:api ProcessOrder:api

# Moves the 'LegacyApp.SalesSummary' views to the 'reporting' schema
MOVE_VIEWS SalesSummary:reporting
DATA_TYPE
このディレクティブを使用すると、Oracle 構文と PostgreSQL 構文の間でサポートされているデータ型を明示的にマッピングできます。このディレクティブには、カンマ区切りのマッピングのリストを指定します。定義全体を 1 行で指定する必要がありますが、構成ファイルに複数の DATA_TYPE ディレクティブを含めることができます。形式は次のようにします。
DATA_TYPE ORACLE_DATA_TYPE1:PGSQL_DATA_TYPE1
DATA_TYPE ORACLE_DATA_TYPE2:PGSQL_DATA_TYPE2...
ここで、ORACLE_DATA_TYPE と PGSQL_DATA_TYPE は、移行で使用するそれぞれの Oracle バージョンと PostgreSQL バージョンでサポートされているデータ型です。サポートされているバージョンについては、 シナリオの概要をご覧ください。
例:
DATA_TYPE REAL:double precision,SMALLINT:integer
Oracle と PostgreSQL のデータ型の詳細については、以下をご覧ください。
- Oracle ドキュメントの Oracle のデータ型。
- PostgreSQL ドキュメントの PostgreSQL のデータ型。
MODIFY_TYPE
MODIFY_TYPE ディレクティブを使用すると、Database Migration Service がソーステーブルの特定の列を変換するデータ型を制御できます。このディレクティブには、カンマ区切りのマッピングのリストが必要です。定義全体を 1 行で指定する必要がありますが、構成ファイルに複数の MODIFY_TYPE ディレクティブを含めることができます。形式は次のようにします。
MODIFY_TYPE SOURCE_TABLE_NAME1:COLUMN_NAME:EXPECTED_END_RESULT_DATA_TYPE
MODIFY_TYPE SOURCE_TABLE_NAME2:COLUMN_NAME:EXPECTED_END_RESULT_DATA_TYPE...
ここで
- SOURCE_TABLE_NAME は、データ型を変更する列を含むテーブルの名前です。
- COLUMN_NAME は、変換マッピングをカスタマイズする列の名前です。
- EXPECTED_END_RESULT_DATA_TYPE は、変換された列で使用する PostgreSQL データ型です。
例:
MODIFY_TYPE events:dates_and_times:DATETIME,users:pseudonym:TEXT
PG_INTEGER_TYPE
デフォルトでは、Database Migration Service は NUMBER(p,s) 型を PostgreSQL の DECIMAL(p,s) 型に変換します。
この動作は、PG_INTEGER_TYPE ディレクティブを使用して変更できます。値を 1 に設定し、精度とスケール(NUMBER(p,s))型を持つすべての NUMBER を、精度の桁数に基づいて PostgreSQL の smallint、integer、bigint 型に強制的に変換します。
コンバージョン マッピング ファイルに次の設定を含めます。
PG_INTEGER_TYPE 1
PG_NUMERIC_TYPE
精度とスケール(NUMBER(p,s))を持つすべての NUMBER 型を PostgreSQL の real 型または float 型(精度桁数に基づく)に変換する場合は、このディレクティブを 1 に設定します。
このディレクティブを 0 に設定すると、NUMBER(p,s) 値は元の値を正確に保持し、内部の PostgreSQL データ型を使用します。
コンバージョン マッピング ファイルに次の設定を含めます。
PG_NUMERIC_TYPE 1
DEFAULT_NUMERIC
精度を指定しない NUMBER のデフォルトの変換は、
PG_INTEGER_TYPE ディレクティブも使用するかどうかによって異なります。
PG_INTEGERディレクティブを使用すると、精度のないNUMBERがDECIMAL値に変換されます。PG_INTEGERディレクティブを使用しない場合、精度のないNUMBERはBIGINT値に変換されます。
この動作を変更し、DEFAULT_NUMERIC ディレクティブを使用して、精度ポイントが指定されていない NUMBER 型に使用するデータ型を指定できます。形式は次のようにします。
DEFAULT_NUMERIC POSTGRESQL_NUMERIC_DATA_TYPE
ここで、POSTGRESQL_NUMERIC_DATA_TYPE は integer、smallint、bigint のいずれかです。
例:
DEFAULT_NUMERIC integer
REPLACE_COLS
REPLACE_COLS ディレクティブを使用すると、変換されたスキーマの列の名前を変更できます。このディレクティブには、カンマ区切りのマッピングのリストを指定します。
形式は次のようにします。
REPLACE_COLS SOURCE_TABLE_NAME1(SOURCE1_TABLE1_COLUMN_NAME1:DESTINATION_TABLE1_COLUMN_NAME1,SOURCE_TABLE1_COLUMN_NAME2:DESTINATION_TABLE1_COLUMN_NAME2),SOURCE_TABLE_NAME2(SOURCE_TABLE2_COLUMN_NAME1:DESTINATION_TABLE2_COLUMN_NAME1,SOURCE_TABLE2_COLUMN_NAME2:DESTINATION_TABLE2_COLUMN_NAME2)...
ここで
- SOURCE_TABLE_NAME は、名前を変更する列を含むテーブルの名前です。SCHEMA ディレクティブを使用しない場合は、完全修飾テーブル名
SCHEMA_NAME.SOURCE_TABLE_NAMEを使用してください。 - SOURCE_COLUMN_NAME は、名前を変更するソースの列の名前です。
- DESTINATION_COLUMN_NAME は、変換後のスキーマで使用する列の新しい名前です。
例:
REPLACE_COLS events(dates_and_times:event_dates),users(pseudonym:nickname)
REPLACE_TABLES
REPLACE_TABLES ディレクティブを使用して、テーブルの名前を変更したり、新しいスキーマに移動したりできます。このディレクティブには、スペースで区切られたマッピングのリストが必要です。各ユースケースの構文の詳細については、次のセクションを開いてください。
SCHEMA ディレクティブを使用しない場合は、ソース変数と宛先変数の両方に、引用符で囲まれた完全修飾テーブル名を使用してください。
"SCHEMA_NAME.SOURCE_TABLE_NAME""SCHEMA_NAME.DESTINATION_TABLE_NAME"
テーブルの名前変更
変換されたスキーマでテーブルの名前を変更するには、次の形式を使用します。
REPLACE_TABLES SOURCE_TABLE_NAME1:DESTINATION_TABLE_NAME1 SOURCE_TABLE_NAME2:DESTINATION_TABLE_NAME2
ここで
- SOURCE_TABLE_NAME は、変換されたスキーマで名前を変更するソーステーブルの名前です。
- DESTINATION_TABLE_NAME は、変換されたスキーマで使用するテーブルの新しい名前です。
例:
REPLACE_TABLES "events:login_events" "users:platform_users"
スキーマ間でテーブルを移動する
このディレクティブを使用すると、新しいテーブル名にスキーマ接頭辞を追加して、スキーマ間でテーブルを移動できます。このメカニズムは、変換ファイル全体で SCHEMA ディレクティブをどのように使用するかに関係なく使用できます。次に例を示します。
REPLACE_TABLES "events:NEW_SCHEMA_NAME.login_events"
データ型をカスタマイズするためのエイリアス
変換ディレクティブを使用して、Database Migration Service がさまざまなデータ型を変換する方法を変更する場合(
DATA_TYPE、
MODIFY_TYPE、
PG_NUMERIC_TYPE ディレクティブなど)、ソース SQL データ型の代わりにエイリアスを使用できます。
次のセクションを開くと、Database Migration Service でサポートされているデータ型エイリアスの一覧が表示されます。
データ型のエイリアス
| エイリアス | PostgreSQL タイプに変換 |
|---|---|
bigint、int8 |
BIGINT |
bool、boolean |
BOOLEAN |
bytea |
BYTEA |
char、character |
CHAR |
character varying、varchar |
VARCHAR |
date |
DATE |
decimal、numeric |
DECIMAL |
double precision、float8 |
DOUBLE PRECISION |
real、float4 |
REAL |
int、integer、int4 |
INTEGER |
int2 |
SMALLINT |
interval |
INTERVAL |
json |
JSON |
smallint |
SMALLINT |
text |
TEXT |
time |
TIME |
timestamp |
TIMESTAMP |
timestamptz |
TIMESTAMPTZ |
timetz |
TIMETZ |
uuid |
UUID |
XML |
XML |
コンバージョン マッピング ファイルの例
サポートされているスキーマ変換ディレクティブの一部を使用する次のサンプル変換マッピング ファイルをご覧ください。
EXPORT_SCHEMA 1
SCHEMA root

# Preserve original casing for all objects
CASE_HANDLING PRESERVE_ORIGINAL

# Data type conversions
PG_NUMERIC_TYPE 0
PG_INTEGER_TYPE 1
DEFAULT_NUMERIC integer
DATA_TYPE NUMBER(4\,0):integer
MODIFY_TYPE events:dates_and_times:TIMESTAMP

# Renaming objects using the RENAME_* directives
# These allow case-sensitive destination names
RENAME_TABLES events:LoginEvents users:PlatformUsers
RENAME_COLUMNS events.dates_and_times:EventDates users.pseudonym:Nickname
RENAME_VIEWS InternalReport:FinInternalReport

# Moving objects to new schemas using the MOVE_* directives
MOVE_TABLES audit_log:archive
MOVE_VIEWS InternalReport:reporting
このファイルを使用した場合の結果は次のとおりです。
EXPORT_SCHEMA 1は必須のディレクティブです。SCHEMA rootを指定すると、完全修飾名が使用されていない限り、他のディレクティブがrootスキーマ内のオブジェクトに適用されます。CASE_HANDLING PRESERVE_ORIGINALを使用すると、ソースrootスキーマのすべてのオブジェクト名が、宛先で元のケースを保持します(RENAME_*ディレクティブによってオーバーライドされない限り)。PG_INTEGER_TYPE 1を指定すると、Database Migration Service は、rootスキーマのテーブルにあるすべての Oracle 数値データ型を、ANSI ポータブル数値型ではなく PostgreSQL 固有の型に変換します。DEFAULT_NUMERIC integerを指定すると、Database Migration Service は、指定された精度ポイントを持たないNUMBER値を PostgreSQL のINTEGER型に変換します。DATA_TYPE NUMBER(4\,0):integerを指定すると、Database Migration Service は特定のNUMBER(4,0)値を PostgreSQL のINTEGERに変換します。MODIFY_TYPE events:dates_and_times:TIMESTAMPディレクティブを使用すると、Database Migration Service はeventsソーステーブルのdates_and_times列のデータを PostgreSQL のTIMESTAMP型に変換します。RENAME_TABLES events:LoginEvents users:PlatformUsersは、指定された大文字と小文字を保持してテーブルの名前を変更します。eventsテーブルの名前がLoginEventsに変更されました。usersテーブルの名前がPlatformUsersに変更されました。
RENAME_COLUMNS events.dates_and_times:EventDates user.pseudonym:Nicknameは、宛先で指定された大文字と小文字を保持して、列の名前を変更します。LoginEventsテーブル(元の名前はevents)で、列dates_and_timesの名前がEventDatesに変更されました。PlatformUsers(元の名前users)で、列pseudonymの名前がNicknameに変更されます。
RENAME_VIEWS InternalReport:FinInternalReportは、ビューInternalReportの名前をFinInternalReportに変更します。MOVE_TABLES audit_log:archiveは、audit_logテーブルをrootスキーマからarchiveスキーマに移動します。MOVE_VIEWS InternalReport:reportingは、InternalReportビューをreportingスキーマに移動します。このビューは、RENAME_VIEWSディレクティブによりFinInternalReportに名前が変更されます。Database Migration Service は依存関係を処理します。オブジェクトの名前が変更されてから移動されます。
以前のコンバージョン ワークスペース
以前のコンバージョン ワークスペースは、より制限の多い古いタイプのコンバージョン ワークスペースです。以前のコンバージョン ワークスペースは、Gemini 拡張コンバージョン機能やインタラクティブ SQL エディタをサポートしていません。これらは、Ora2Pg 移行ツールを使用してソーススキーマを変換する場合にのみ使用できます。
移行に以前のタイプのコンバージョン ワークスペースを使用することはおすすめしません。シナリオで以前のコンバージョン ワークスペースを使用する必要がある場合は、 以前のコンバージョン ワークスペースを操作するをご覧ください。
次のステップ
コンバージョン ワークスペースの使用方法については、以下をご覧ください。