


PCollections, או אוספים שמתעדכנים תמיד, מייצגים נתונים בפייפליינים זורמים. אוסף לא מוגבל מכיל נתונים ממקור נתונים שמתעדכן כל הזמן, כמו Pub/Sub.
אי אפשר להשתמש רק במפתח כדי לקבץ רכיבים באוסף לא מוגבל. יכול להיות שיהיו אינסוף רכיבים למפתח נתון בנתונים בסטרימינג, כי מקור הנתונים מוסיף כל הזמן רכיבים חדשים. אפשר להשתמש בחלונות, בסימני מים ובטריגרים כדי לצבור רכיבים באוספים לא מוגבלים.
הקונספט של חלונות חל גם על מערכי נתונים מורכבים (PCollection) שאינם משתנים, שמייצגים נתונים בצינורות עיבוד נתונים באצווה. למידע על חלונות בצינורות עיבוד נתונים באצווה, קראו את המאמר Windowing with bounded PCollections במסמכי התיעוד של Apache Beam.
אם לצינור עיבוד נתונים ב-Dataflow יש מקור נתונים מוגבל, כלומר מקור שלא מכיל נתונים שמתעדכנים באופן רציף, וצינור עיבוד הנתונים מועבר למצב סטרימינג באמצעות הדגל --streaming, כשמקור הנתונים המוגבל נצרך במלואו, צינור עיבוד הנתונים מפסיק לפעול.
שימוש במצב סטרימינג
כדי להריץ צינור עיבוד נתונים במצב סטרימינג, מגדירים את הדגל --streaming בשורת הפקודה כשמריצים את צינור עיבוד הנתונים. אפשר גם להגדיר את מצב הסטרימינג באופן פרוגרמטי כשיוצרים את צינור עיבוד הנתונים.
מקורות באצווה לא נתמכים במצב סטרימינג.
כשמעדכנים את צינור עיבוד הנתונים עם מאגר גדול יותר של Worker, יכול להיות שה-upscaling של משימת הסטרימינג לא יתבצע כמצופה. במשימות סטרימינג שלא משתמשות ב-Streaming Engine, אי אפשר להגדיל את מספר ה-workers המקורי ואת משאבי Persistent Disk שהוקצו בתחילת המשימה המקורית. כשמעדכנים משימת Dataflow ומציינים מספר גדול יותר של worker-ים במשימה החדשה, אפשר לציין רק מספר worker-ים ששווה למספר המקסימלי של ה-worker-ים שציינתם במשימה המקורית.
מציינים את המספר המקסימלי של ה-workers באמצעות הדגלים הבאים:
Java
--maxNumWorkers
Python
--max_num_workers
המשך
--max_num_workers
חלונות ופונקציות חלון (windowing functions)
פונקציות חלון מחלקות אוספים לא מוגבלים לרכיבים לוגיים, או חלונות. פונקציות חלון מקבצות אוספים לא מוגבלים לפי חותמות הזמן של הרכיבים הנפרדים. כל חלון מכיל מספר סופי של רכיבים.
מגדירים את החלונות הבאים באמצעות Apache Beam SDK:
- חלונות עוקבים (tumbling windows) (נקראים חלונות קבועים ב-Apache Beam)
- חלונות קצובים (hopping windows) (נקראים חלונות הזזה ב-Apache Beam)
- חלונות סשן (session window)
חלונות עוקבים (tumbling window)
חלון עוקב מייצג מרווח זמן עקבי ונפרד בזרם הנתונים.
לדוגמה, אם מגדירים חלון עוקב של 30 שניות, הרכיבים עם ערכי חותמות הזמן [0:00:00-0:00:30) נמצאים בחלון הראשון. רכיבים עם ערכי חותמת זמן [0:00:30-0:01:00) נמצאים בחלון השני.
בתמונה הבאה אפשר לראות איך האלמנטים מחולקים לחלונות עוקבים של 30 שניות.

חלונות קצובים (hopping windows)
חלון קצוב (hopping window) מייצג מרווח זמן עקבי בזרם הנתונים. חלונות קצובים יכולים לחפוף, ואילו חלונות עוקבים הם נפרדים.
לדוגמה, חלון קצוב יכול להתחיל כל 30 שניות ולתעד נתונים של דקה אחת. התדירות שבה מתחילים חלונות קצובים נקראת תקופה. בדוגמה הזו יש חלון של דקה אחת ותקופה של שלושים שניות.
התמונה הבאה ממחישה איך האלמנטים מחולקים לחלונות קצובים של דקה עם תקופה של 30 שניות.

כדי לחשב ממוצעים נעים של נתונים, משתמשים בחלונות קצובים (hopping window). אפשר להשתמש בחלונות קצובים של דקה עם תקופה של שלושים שניות כדי לחשב ממוצע נע של דקה כל שלושים שניות.
חלונות סשן (session windows)
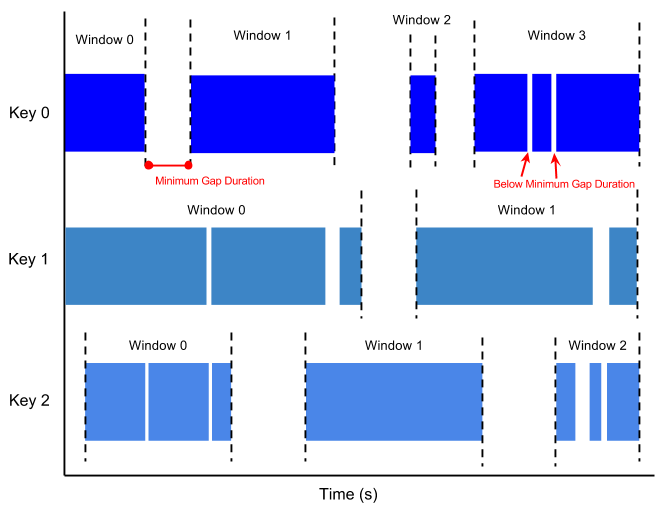
חלון סשן מכיל רכיבים בתוך משך פער של רכיב אחר. משך הפער הוא מרווח הזמן בין נתונים חדשים במקור נתונים. אם הנתונים מגיעים אחרי משך הפער, הם מוקצים לחלון חדש.
לדוגמה, חלונות סשן יכולים לחלק זרם נתונים שמייצג את פעילות העכבר של המשתמש. יכול להיות שבמקור הנתונים הזה יהיו תקופות ארוכות של חוסר פעילות, וביניהן הרבה קליקים. חלון סשן יכול להכיל את הנתונים שנוצרו על ידי הקליקים.
בחלונות סשן (session windowing), לכל מפתח נתונים מוקצים חלונות שונים. חלונות קבועים וחלונות קצובים מכילים את כל הרכיבים במרווח הזמן שצוין, בלי קשר למפתחות הנתונים.
התמונה הבאה ממחישה איך האלמנטים מחולקים לחלונות סשן.
סימני מים
סימן מים הוא סף שמציין מתי כל הנתונים בחלון אמורים להגיע ל-Dataflow. אם סימן המים עבר את סוף החלון ומגיעים נתונים חדשים עם חותמת זמן בתוך החלון, הנתונים נחשבים לנתונים מאוחרים. למידע נוסף, קראו על סימני מים ונתונים מאוחרים במסמכי התיעוד של Apache Beam.
Dataflow עוקב אחרי סימני מים מהסיבות הבאות:
- אין ערובה לכך שהנתונים יגיעו לפי סדר כרונולוגי או במרווחי זמן צפויים.
- אין התחייבות שאירועי הנתונים יופיעו בצינורות עיבוד הנתונים באותו סדר שבו הם נוצרו.
מקור הנתונים קובע את סימן המים. אפשר לאפשר נתונים מאוחרים באמצעות Apache Beam SDK.
טריגרים
טריגרים קובעים מתי להפיק תוצאות נצברות כשהנתונים מגיעים. כברירת מחדל, התוצאות מופקות כשסימן המים עובר את סוף החלון.
אתם יכולים להשתמש ב-Apache Beam SDK כדי ליצור או לשנות טריגרים לכל אוסף בפייפליין זורם.
ערכת ה-SDK של Apache Beam יכולה להגדיר טריגרים שפועלים בכל שילוב של התנאים הבאים:
- זמן האירוע, כפי שמצוין בחותמת הזמן של כל רכיב נתונים.
- זמן העיבוד, שהוא הזמן שבו רכיב הנתונים מעובד בכל שלב נתון בצינור עיבוד הנתונים.
- מספר רכיבי הנתונים באוסף.