


Le PCollections illimitate, o raccolte illimitate, rappresentano i dati nelle pipeline di streaming. Una raccolta non limitata contiene dati provenienti da un'origine dati in continuo aggiornamento, ad esempio Pub/Sub.
Non puoi utilizzare solo una chiave per raggruppare gli elementi in una raccolta illimitata. Potrebbero esserci infiniti elementi per una determinata chiave nei dati in streaming, perché l'origine dati aggiunge costantemente nuovi elementi. Puoi utilizzare finestre, watermark e trigger per aggregare gli elementi in raccolte non limitate.
Il concetto di finestre si applica anche ai PCollection limitati che rappresentano i dati nelle pipeline batch. Per informazioni sul windowing nelle pipeline batch, consulta la documentazione di Apache Beam relativa al windowing con PCollection limitati.
Se una pipeline Dataflow ha un'origine dati limitata, ovvero un'origine che non contiene dati in continuo aggiornamento, e la pipeline viene impostata sulla modalità di streaming utilizzando il flag --streaming, quando l'origine limitata viene consumata completamente, la pipeline smette di funzionare.
Utilizza la modalità flusso di dati
Per eseguire una pipeline in modalità flusso, imposta il flag --streaming nella riga di comando quando esegui la pipeline. Puoi anche impostare la modalità di streaming in modo programmatico quando crei la pipeline.
Le origini batch non sono supportate in modalità flusso di dati.
Quando aggiorni la pipeline con un pool di worker più grande, lo scale up del job di flussi di dati potrebbe non essere eseguito come previsto. Per i job di flussi di dati che non utilizzano Streaming Engine, non puoi eseguire lo scale up oltre il numero originale di worker e risorse Persistent Disk allocate all'inizio del job originale. Quando aggiorni un job Dataflow e specifichi un numero maggiore di worker nel nuovo job, puoi specificare solo un numero di worker pari al numero massimo di worker specificato per il job originale.
Specifica il numero massimo di worker utilizzando i seguenti flag:
Java
--maxNumWorkers
Python
--max_num_workers
Vai
--max_num_workers
Finestre e funzioni finestra
Le funzioni di windowing dividono le raccolte non limitate in componenti logici o finestre. Le funzioni di windowing raggruppano le raccolte non limitate in base ai timestamp dei singoli elementi. Ogni finestra contiene un numero finito di elementi.
Imposta le seguenti finestre con l'SDK Apache Beam:
- Finestre a cascata (chiamate finestre fisse in Apache Beam)
- Finestre di hopping (chiamate finestre scorrevoli in Apache Beam)
- Finestre di sessione
Finestre a cascata
Una finestra a cascata rappresenta un intervallo di tempo coerente e disgiunto nel flusso di dati.
Ad esempio, se imposti una finestra a cascata di 30 secondi, gli elementi con valori di timestamp [0:00:00-0:00:30) si trovano nella prima finestra. Gli elementi con valori di timestamp [0:00:30-0:01:00) si trovano nella seconda finestra.
L'immagine seguente illustra come gli elementi sono suddivisi in finestre a cascata di 30 secondi.

Finestre di hopping
Una finestra di hopping rappresenta un intervallo di tempo coerente nel stream di dati. Le finestre di hopping possono sovrapporsi, mentre le finestre a cascata sono disgiunte.
Ad esempio, una finestra di hopping può iniziare ogni 30 secondi e acquisire un minuto di dati. La frequenza con cui iniziano le finestre di hopping è chiamata periodo. Questo esempio ha una finestra di un minuto e un periodo di 30 secondi.
La seguente immagine illustra come gli elementi vengono suddivisi in finestre di hopping di un minuto con un periodo di trenta secondi.

Per calcolare le medie mobili dei dati, utilizza le finestre di hopping. Puoi utilizzare finestre di hopping di un minuto con un periodo di trenta secondi per calcolare una media mobile di un minuto ogni trenta secondi.
Finestre di sessione
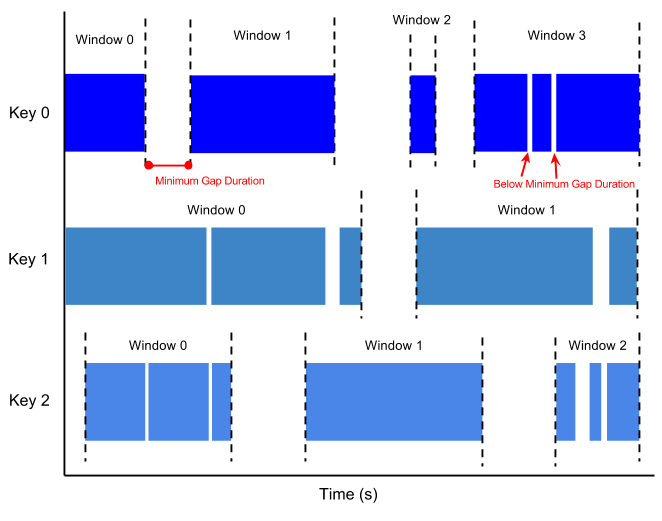
Una finestra di sessione contiene elementi entro un intervallo di tempo di un altro elemento. La durata dell'intervallo è un intervallo tra i nuovi dati in uno stream di dati. Se i dati arrivano dopo la durata dell'intervallo, vengono assegnati a una nuova finestra.
Ad esempio, le finestre di sessione possono dividere un stream di dati che rappresenta l'attività del mouse dell'utente. Questo stream di dati potrebbe avere lunghi periodi di inattività intervallati da molti clic. Una finestra di sessione può contenere i dati generati dai clic.
La windowing delle sessioni assegna finestre diverse a ogni chiave di dati. Le finestre di tumbling e di hopping contengono tutti gli elementi nell'intervallo di tempo specificato, indipendentemente dalle chiavi dei dati.
La seguente immagine mostra come gli elementi vengono suddivisi in finestre di sessione.
Filigrane
Una filigrana è una soglia che indica quando Dataflow prevede che tutti i dati in una finestra siano arrivati. Se il watermark ha superato la fine della finestra e arrivano nuovi dati con un timestamp all'interno della finestra, i dati vengono considerati dati in ritardo. Per saperne di più, consulta Watermark e dati in ritardo nella documentazione di Apache Beam.
Dataflow monitora i watermark per i seguenti motivi:
- Non è garantito che i dati arrivino in ordine cronologico o a intervalli prevedibili.
- Non è garantito che gli eventi di dati vengano visualizzati nelle pipeline nello stesso ordine in cui sono stati generati.
L'origine dati determina il watermark. Puoi consentire i dati in ritardo con l'SDK Apache Beam.
Trigger
I trigger determinano quando emettere i risultati aggregati man mano che arrivano i dati. Per impostazione predefinita, i risultati vengono emessi quando il watermark supera la fine della finestra.
Puoi utilizzare l'SDK Apache Beam per creare o modificare i trigger per ogni raccolta in una pipeline di streaming.
L'SDK Apache Beam può impostare trigger che operano su qualsiasi combinazione delle seguenti condizioni:
- Ora dell'evento, come indicato dal timestamp su ogni elemento di dati.
- Tempo di elaborazione, ovvero il tempo in cui l'elemento di dati viene elaborato in una determinata fase della pipeline.
- Il numero di elementi di dati in una raccolta.