


בדיקת צינורות עיבוד הנתונים של Apache Beam באופן מקומי ובסביבות Staging מאפשרת לאמת את הלוגיקה של טרנספורמציית הנתונים ולזהות פגמים לפני שפורסים משימות ב-Dataflow. מחזור החיים הזה של הפיתוח עוזר לקצר את תהליך ניפוי הבאגים, להגן על מערכות במורד הזרם מפני נתונים פגומים ולשפר את האמינות של צינור עיבוד הנתונים בסביבת הייצור.
סקירה כללית
האופן שבו הקוד של צינור עיבוד הנתונים מוטמע משפיע באופן משמעותי על הביצועים של צינור עיבוד הנתונים בסביבת הייצור. כדי לעזור לכם ליצור קוד צינור עיבוד נתונים שפועל בצורה נכונה ויעילה, במאמר הזה מוסברים הנושאים הבאים:
- מריצי צינורות עיבוד נתונים שתומכים בהרצת קוד בשלבים השונים של הפיתוח והפריסה.
- סביבות פריסה שמאפשרות להריץ צינורות עיבוד נתונים במהלך הפיתוח, הבדיקה, טרום-הייצור והייצור.
- תבניות וקוד פתוח של צינורות עיבוד נתונים שאפשר להשתמש בהם כמו שהם, או כבסיס לצינורות עיבוד נתונים חדשים כדי להאיץ את פיתוח הקוד.
- שיטות מומלצות לבדיקת קוד של צינור עיבוד נתונים. בחלק הראשון של המאמר מופיעה סקירה כללית שכוללת את ההיקף והקשר בין סוגי הבדיקות השונים, כמו בדיקות יחידה, בדיקות שילוב ובדיקות מקצה לקצה. בחלק השני נסביר בפירוט על כל סוג של בדיקה, כולל שיטות ליצירת נתוני בדיקה ושילוב שלהם, ובאילו מריצי צינורות עיבוד נתונים להשתמש בכל בדיקה.
מריצי צינורות עיבוד נתונים
במהלך הפיתוח והבדיקה, משתמשים ב-runners שונים של Apache Beam כדי להריץ את קוד הצינור. ערכת ה-SDK של Apache Beam מספקת Direct Runner לפיתוח ולבדיקה מקומיים. כלי האוטומציה של הגרסה יכולים גם להשתמש ב-Direct Runner לבדיקות יחידה ולבדיקות שילוב. לדוגמה, אפשר להשתמש ב-Direct Runner בצינור עיבוד הנתונים של האינטגרציה הרציפה (CI).
צינורות עיבוד נתונים שנפרסים ב-Dataflow משתמשים ב-Dataflow Runner, שמריץ את צינור עיבוד הנתונים בסביבות שדומות לסביבות ייצור. בנוסף, אתם יכולים להשתמש ב-Dataflow Runner לבדיקות פיתוח אד-הוק ולבדיקות מקצה לקצה של צינור עיבוד הנתונים.
למרות שהדף הזה מתמקד בהרצת צינורות עיבוד נתונים שנוצרו באמצעות Apache Beam Java SDK, Dataflow תומך גם בצינורות עיבוד נתונים של Apache Beam שפותחו באמצעות Python ו-Go. ערכות ה-SDK של Apache Beam ל-Java, ל-Python ול-Go זמינות לכלל המשתמשים ב-Dataflow. מפתחי SQL יכולים גם להשתמש ב-Apache Beam SQL כדי ליצור צינורות עיבוד נתונים שמשתמשים בניבים מוכרים של SQL.
הגדרת סביבת פריסה
כדי להפריד בין משתמשים, נתונים, קוד ומשאבים אחרים בשלבי פיתוח שונים, צריך ליצור סביבות פריסה. כדי לספק סביבות מבודדות לשלבים השונים של פיתוח צינור עיבוד הנתונים, מומלץ להשתמש בפרויקטיםGoogle Cloud נפרדים.
בקטעים הבאים מתוארת קבוצה אופיינית של סביבות פריסה.
הסביבה המקומית
הסביבה המקומית היא תחנת העבודה של המפתח. למטרות פיתוח ובדיקה מהירה, משתמשים ב-Direct Runner כדי להריץ קוד צינור עיבוד נתונים באופן מקומי.
צינורות עיבוד נתונים שמופעלים באופן מקומי באמצעות Direct Runner יכולים לקיים אינטראקציה עם משאבים מרוחקים של Google Cloud , כמו נושאים ב-Pub/Sub או טבלאות ב-BigQuery. לתת למפתחים פרויקטים נפרדים ב-Google Cloud כדי שיהיה להם ארגז חול לבדיקות אד-הוק עם שירותיGoogle Cloud .
בחלק מהשירותים של Google Cloud , כמו Pub/Sub ו-Bigtable, יש אמולטורים לפיתוח מקומי. אתם יכולים להשתמש באמולטורים האלה עם Direct Runner כדי לאפשר פיתוח ובדיקה מקומיים מקצה לקצה.
סביבת ארגז חול (sandbox)
סביבת ארגז החול היא פרויקט ב- Google Cloud שמאפשר למפתחים לגשת לשירותי Google Cloud במהלך פיתוח הקוד. מפתחי צינורות עיבוד נתונים יכולים לשתף פרויקט עם מפתחים אחרים, או להשתמש בפרויקטים אישיים משלהם. Google Cloud שימוש בפרויקטים נפרדים מפחית את מורכבות התכנון שקשורה לשימוש במשאבים משותפים ולניהול מכסות.
המפתחים משתמשים בסביבת ארגז החול כדי להריץ צינורות עיבוד נתונים אד-הוק באמצעות Dataflow Runner. סביבת ארגז החול שימושית לניפוי באגים ולבדיקת קוד מול סביבת ייצור במהלך שלב פיתוח הקוד. לדוגמה, הפעלה אד-הוק של צינור עיבוד נתונים מאפשרת למפתחים:
- בודקים את ההשפעה של שינויים בקוד על התנהגות ההתאמה לעומס.
- להבין את ההבדלים הפוטנציאליים בין ההתנהגות של Direct Runner לבין ההתנהגות של Dataflow Runner.
- איך Dataflow מבצע אופטימיזציות של תרשימים.
לצורך בדיקות אד-הוק, המפתחים יכולים לפרוס קוד מהסביבה המקומית שלהם כדי להריץ את Dataflow בסביבת ארגז החול שלהם.
סביבת טרום-ייצור
סביבת טרום-הייצור מיועדת לשלבי פיתוח שצריך להריץ בתנאים שדומים לייצור, כמו בדיקות מקצה לקצה. השתמשו בפרויקט נפרד לסביבת טרום-הייצור, והגדירו אותו כך שיהיה דומה ככל האפשר לסביבת הייצור. באופן דומה, כדי לאפשר בדיקות מקצה לקצה בקנה מידה שדומה לסביבת הייצור, ודאו ש Google Cloud המכסות של הפרויקט ב-Dataflow ובשירותים אחרים דומות ככל האפשר לסביבת הייצור.
בהתאם לדרישות שלכם, תוכלו להפריד את סביבת טרום-הייצור לכמה סביבות. לדוגמה, סביבת בקרת איכות יכולה לתמוך בעבודה של מנתחי איכות כדי לבדוק יעדים ברמת השירות (SLO), כמו נכונות הנתונים, עדכניות וביצועים בתנאי עומס עבודה שונים.
בדיקות מקצה לקצה כוללות שילוב עם מקורות נתונים וכיורי נתונים במסגרת הבדיקה. חשבו איך להפוך אותם לזמינים בסביבת טרום-הייצור. אתם יכולים לאחסן נתוני בדיקה בסביבת טרום-הייצור עצמה. לדוגמה, נתוני הבדיקה מאוחסנים בקטגוריה של Cloud Storage עם נתוני הקלט. במקרים אחרים, נתוני הבדיקה יכולים להגיע מחוץ לסביבת טרום-הייצור, כמו נושא Pub/Sub דרך מינוי נפרד שנמצא בסביבת הייצור. בפייפליינים זורמים, אפשר גם להריץ בדיקות מקצה לקצה באמצעות נתונים שנוצרו, למשל באמצעות מחולל הנתונים בסטרימינג של Dataflow, כדי לדמות מאפיינים ונפחים של נתונים שדומים לאלה שבסביבת הייצור.
עבור פייפליינים זורמים, השתמשו בסביבת טרום-הייצור כדי לבדוק עדכונים בפייפליין לפני שמבצעים שינויים בסביבת הייצור. חשוב לבדוק ולאמת את תהליכי העדכון של פייפליינים זורמים, במיוחד אם צריך לתאם כמה שלבים, למשל כשמריצים פייפליינים במקביל כדי למנוע זמן השבתה.
סביבת ייצור
סביבת הייצור היא פרויקט Google Cloud ייעודי. במסגרת הפיתוח הרציף, פריטי המידע שנוצרו בתהליך הפיתוח מועתקים לסביבת הייצור אחרי שכל בדיקות הקצה-לקצה (end-to-end) עברו בהצלחה.
שיטות מומלצות לפיתוח
שיטות מומלצות לשימוש בפייפליין ב-Dataflow
בדיקת הצינור (pipeline)
בפיתוח תוכנה, בדיקות יחידה (unit testing), בדיקות שילוב (integration testing) ובדיקות מקצה לקצה (end-to-end testing) הן סוגים נפוצים של בדיקות תוכנה. סוגי הבדיקות האלה רלוונטיים גם ל-Data pipelines.
ה-SDK של Apache Beam מספק פונקציונליות שמאפשרת את הבדיקות האלה. באופן אידיאלי, כל סוג של בדיקה מטרגט סביבת פריסה אחרת. הדיאגרמה הבאה ממחישה איך בדיקות יחידה, בדיקות שילוב ובדיקות מקצה לקצה חלות על חלקים שונים של הפייפליין והנתונים.
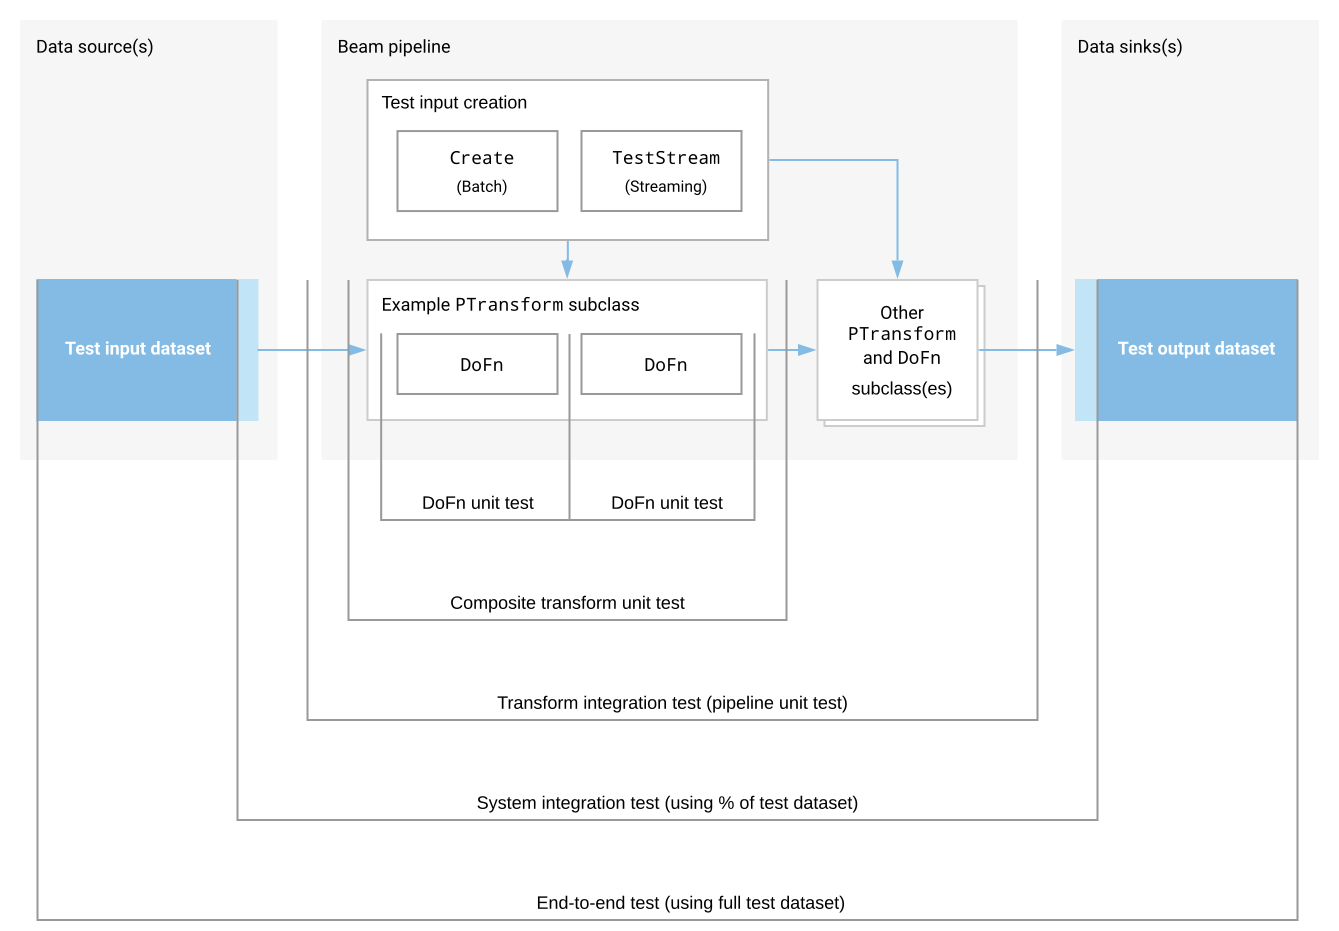
הדיאגרמה מציגה את ההיקף של בדיקות שונות ואת הקשר שלהן לטרנספורמציות (מחלקות משנה של DoFn ו-PTransform), פייפליינים, מקורות נתונים ו-data sinks.
בקטעים הבאים מוסבר איך בדיקות תוכנה רשמיות שונות חלות על צינורות עיבוד נתונים באמצעות Dataflow. בזמן שאתם קוראים את הקטע הזה, חזרו לתרשים כדי להבין איך סוגי הבדיקות השונים קשורים זה לזה.
דגימת נתונים
כדי לצפות בנתונים בכל שלב בצינור עיבוד הנתונים של Dataflow, צריך להפעיל את דגימת הנתונים במהלך הבדיקה. כך תוכלו לראות את הפלט של הטרנספורמציות ולוודא שהוא תקין.
בדיקות יחידה (unit tests)
בדיקות יחידה בודקות את התפקוד התקין של מחלקות משנה של DoFn וטרנספורמציות מורכבות (מחלקות משנה של PTransform), על ידי השוואה בין הפלט של הטרנספורמציות האלה לבין קבוצה מאומתת של קלט ופלט של נתונים. בדרך כלל, המפתחים יכולים להריץ את הבדיקות האלה בסביבה המקומית. אפשר גם להריץ את הבדיקות באופן אוטומטי באמצעות אוטומציה של בדיקות יחידה, בעזרת אינטגרציה רציפה (CI) בסביבת ה-build.
ה-Direct Runner מריץ בדיקות יחידה באמצעות קבוצת משנה קטנה יותר של נתוני בדיקה, שמתמקדת בבדיקת הלוגיקה העסקית של הטרנספורמציות. נתוני הבדיקה צריכים להיות קטנים מספיק כדי להתאים לזיכרון המקומי במכונה שמריצה את הבדיקה.
ערכת ה-SDK של Apache Beam מספקת כלל JUnit שנקרא TestPipeline לבדיקת יחידה של טרנספורמציות נפרדות (מחלקות משנה של DoFn), טרנספורמציות מורכבות (מחלקות משנה של PTransform) וצינורות עיבוד נתונים שלמים. אפשר להשתמש ב-TestPipeline ב-Apache Beam pipeline runner, כמו Direct Runner או Dataflow Runner, כדי להחיל טענות נכונות (assertions) על התוכן של אובייקטים מסוג PCollection באמצעות PAssert, כפי שמוצג בקטע הקוד הבא של JUnit test class:
@Rule
public final transient TestPipeline p = TestPipeline.create();

@Test
@Category(NeedsRunner.class)
public void myPipelineTest() throws Exception {
  final PCollection<String> pcol = p.apply(...)
  PAssert.that(pcol).containsInAnyOrder(...);
  p.run();
}
בדיקות יחידה לטרנספורמציות ספציפיות
אם תפרקו את הקוד לטרנספורמציות שניתן לעשות בהן שימוש חוזר, למשל כמחלקות מקוננות סטטיות או ברמה העליונה, תוכלו ליצור בדיקות ממוקדות לחלקים שונים של צינור עיבוד הנתונים. בנוסף ליתרונות של הבדיקה, טרנספורמציות לשימוש חוזר משפרות את יכולת התחזוקה של הקוד ואת האפשרות למינוף מחדש, על ידי הכללה טבעית של הלוגיקה העסקית של הפייפליין בחלקים של הרכיבים. לעומת זאת, יכול להיות שיהיה קשה לבדוק חלקים נפרדים של צינור עיבוד הנתונים אם הוא משתמש במחלקות פנימיות אנונימיות כדי להטמיע טרנספורמציות.
בקטע הקוד הבא ב-Java מוצגת הטמעה של טרנספורמציות כמחלקות פנימיות אנונימיות, מה שמקשה על הבדיקה.
PipelineOptions options = PipelineOptionsFactory.create();

Pipeline p = Pipeline.create(options)

PCollection<Integer> output =
    p.apply("Read from text", TextIO.Read.from(...))
        .apply("Split words", ParDo.of(new DoFn() {
          // Untestable anonymous transform 1
        }))
        .apply("Generate anagrams", ParDo.of(new DoFn() {
          // Untestable anonymous transform 2
        }))
        .apply("Count words", Count.perElement());
השוו בין הדוגמה הקודמת לדוגמה הבאה, שבה המחלקות הפנימיות האנונימיות עוברות רה-פקטורינג למחלקות משנה קונקרטיות בעלות שם של DoFn. אפשר ליצור בדיקות יחידה נפרדות לכל מחלקת משנה קונקרטית של DoFn שמרכיבה את הצינור מקצה לקצה.
PipelineOptions options = PipelineOptionsFactory.create();

Pipeline p = Pipeline.create(options)

PCollection<Integer> output =
    p.apply("Read from text", TextIO.Read.from(...))
        .apply("Split words", ParDo.of(new SplitIntoWordsFn()))
        .apply("Generate anagrams", ParDo.of(new GenerateAnagramsFn()))
        .apply("Count words", Count.perElement());
בדיקה של כל מחלקת משנה של DoFn דומה לבדיקת יחידה של צינור עיבוד נתונים באצווה שמכיל טרנספורמציה אחת. משתמשים בטרנספורמציה Create כדי ליצור אובייקט PCollection של נתוני בדיקה, ואז מעבירים אותו לאובייקט DoFn. משתמשים ב-PAssert כדי לוודא שהתוכן של האובייקט PCollection נכון. בדוגמה הבאה של קוד Java, נעשה שימוש במחלקה PAssert כדי לבדוק אם הפלט בפורמט הנכון.
@Rule
public final transient TestPipeline p = TestPipeline.create();

@Test
@Category(NeedsRunner.class)
public void testGenerateAnagramsFn() {
    // Create the test input
    PCollection<String> words = p.apply(Create.of("friend"));

    // Test a single DoFn using the test input
    PCollection<String> anagrams =
        words.apply("Generate anagrams", ParDo.of(new GenerateAnagramsFn()));

    // Assert correct output from
    PAssert.that(anagrams).containsInAnyOrder(
        "finder", "friend", "redfin", "refind");

    p.run();
}
בדיקות אינטגרציה
בדיקות שילוב מוודאות שכל הצינור פועל בצורה תקינה. כדאי להביא בחשבון את הסוגים הבאים של בדיקות שילוב:
- בדיקת אינטגרציה של טרנספורמציה שמעריכה את הפונקציונליות המשולבת של כל הטרנספורמציות הנפרדות שמרכיבות את פייפליין הנתונים. אפשר לחשוב על בדיקות אינטגרציה של טרנספורמציה כבדיקת יחידה של כל צינור עיבוד הנתונים, לא כולל אינטגרציה עם מקורות נתונים חיצוניים וכיורים. ערכת ה-SDK של Apache Beam מספקת שיטות להזנת נתוני בדיקה לפייפליין ולאימות תוצאות העיבוד. ה-Direct Runner משמש להרצת בדיקות שילוב של טרנספורמציות.
בדיקת שילוב מערכת שמעריכה את השילוב של פייפליין הנתונים עם מקורות נתונים ו-sinks פעילים. כדי שהצינורות יוכלו לתקשר עם מערכות חיצוניות, צריך להגדיר את הבדיקות עם פרטי הכניסה המתאימים לגישה לשירותים חיצוניים. פייפליינים זורמים פועלים ללא הגבלת זמן, לכן צריך להחליט מתי ואיך לעצור את הפייפליין שפועל. כשמשתמשים ב-Direct Runner כדי להריץ בדיקות של שילוב מערכות, אפשר לאמת במהירות את השילוב בין צינור עיבוד הנתונים למערכות אחרות, בלי לשלוח משימת Dataflow ולהמתין עד שהיא תסתיים.
תכננו בדיקות טרנספורמציה ושילוב מערכות כדי לספק זיהוי פגמים ומשוב מהירים בלי לפגוע בפרודוקטיביות של המפתחים. לבדיקות ארוכות יותר, כמו אלה שפועלות כמשימות Dataflow, כדאי להשתמש בבדיקה מקצה לקצה שפועלת בתדירות נמוכה יותר.
אפשר לחשוב על פייפליין כטרנספורמציה אחת או יותר שקשורות זו לזו. אפשר ליצור טרנספורמציה מורכבת שמכילה את צינור עיבוד הנתונים, ולהשתמש ב-TestPipeline כדי לבצע בדיקת שילוב של כל צינור עיבוד הנתונים. בהתאם למצב שבו רוצים לבדוק את צינור עיבוד הנתונים (אצווה או סטרימינג), מספקים נתוני בדיקה באמצעות הטרנספורמציות Create או TestStream.
שימוש בנתוני בדיקה לבדיקות שילוב
בסביבת הייצור, סביר להניח שהצינור משתלב עם מקורות נתונים וכיורים שונים. עם זאת, בבדיקות יחידה ובבדיקות של שילוב טרנספורמציות, התמקדו באימות הלוגיקה העסקית של קוד הצינור על ידי מתן קלט לבדיקה ואימות הפלט באופן ישיר. בנוסף לפישוט הבדיקות, הגישה הזו מאפשרת לבודד בעיות ספציפיות לצינור עיבוד הנתונים מבעיות שעלולות להיגרם על ידי מקורות נתונים וכיורים.
בדיקת צינורות עיבוד נתונים של מקבצים
בצינורות עיבוד נתונים באצווה, משתמשים בטרנספורמציה Create כדי ליצור אובייקט PCollection של נתוני הבדיקה של הקלט מתוך אוסף רגיל בזיכרון, כמו אובייקט List של Java. הטרנספורמציה Create מתאימה אם נתוני הבדיקה קטנים מספיק כדי לכלול אותם בקוד. אחר כך אפשר להשתמש ב-PAssert באובייקטים של הפלט PCollection כדי לבדוק את התקינות של קוד הצינור.
הגישה הזו נתמכת על ידי Direct Runner ועל ידי Dataflow Runner.
קטע הקוד הבא ב-Java מציג טענות נכוֹנוּת (assertions) לגבי אובייקטים של פלט PCollection מטרנספורמציה מורכבת, שכוללת חלק מהטרנספורמציות הנפרדות שמרכיבות צינור עיבוד נתונים (WeatherStatsPipeline) או את כולן. הגישה דומה לבדיקת יחידה של טרנספורמציות נפרדות בצינור עיבוד נתונים.
private class WeatherStatsPipeline extends
    PTransform<PCollection<Integer>, PCollection<WeatherSummary>> {
  @Override
  public PCollection<WeatherSummary> expand(PCollection<Integer> input) {
    // Pipeline transforms …
  }
}

@Rule
public final transient TestPipeline p = TestPipeline.create();

@Test
@Category(NeedsRunner.class)
public void testWeatherPipeline() {
  // Create test input consisting of temperature readings
  PCollection<Integer> tempCelsius =
      p.apply(Create.of(24, 22, 20, 22, 21, 21, 20));

  // CalculateWeatherStats calculates the min, max, and average temperature
  PCollection<WeatherSummary> result =
      tempCelsius.apply("Calculate weather statistics", new WeatherStatsPipeline());

   // Assert correct output from CalculateWeatherStats
   PAssert.thatSingleton(result).isEqualTo(new WeatherSummary.Builder()
       .withAverageTemp(21)
       .withMaxTemp(24)
       .withMinTemp(20)
       .build());

   p.run();
}
כדי לבדוק את התנהגות החלונות, אפשר גם להשתמש בטרנספורמציה Create כדי ליצור רכיבים עם חותמות זמן, כמו שמוצג בקטע הקוד הבא:
private static final Duration WINDOW_DURATION = Duration.standardMinutes(3);

@Rule
public final transient TestPipeline p = TestPipeline.create();

@Test
@Category(NeedsRunner.class)
public void testWindowedData() {
    PCollection<String> input =
        p.apply(
            Create.timestamped(
                    TimestampedValue.of("a", new Instant(0L)),
                    TimestampedValue.of("a", new Instant(0L)),
                    TimestampedValue.of("b", new Instant(0L)),
                    TimestampedValue.of("c", new Instant(0L)),
                    TimestampedValue.of("c", new Instant(0L).plus(WINDOW_DURATION)))
                .withCoder(StringUtf8Coder.of()));

   PCollection<KV<String, Long>> windowedCount =
       input
           .apply(Window.into(FixedWindows.of(WINDOW_DURATION)))
           .apply(Count.perElement());

    PAssert.that(windowedCount)
        .containsInAnyOrder(
            // Output from first window
            KV.of("a", 2L),
            KV.of("b", 1L),
            KV.of("c", 1L),
            // Output from second window
            KV.of("c", 1L));

   p.run();
}
בדיקת פייפליינים זורמים
פייפליינים זורמים מכילים הנחות שמגדירות איך לטפל בנתונים לא מוגבלים. ההנחות האלה קשורות בדרך כלל לזמינות הנתונים בתנאים בעולם האמיתי, ולכן הן משפיעות על הנכונות בהתאם לשאלה אם ההנחות מתבררות כנכונות או כשגויות. בדיקות אינטגרציה של פייפליינים זורמים צריכות לכלול בדיקות שמדמות את האופי הלא דטרמיניסטי של הגעת נתונים בסטרימינג.
כדי להפעיל בדיקות כאלה, ערכת ה-SDK של Apache Beam מספקת את המחלקה TestStream, שמאפשרת ליצור מודל של ההשפעות של תזמוני הרכיבים (נתונים מוקדמים, בזמן או מאוחרים) על התוצאות של צינור עיבוד הנתונים. אתם יכולים להשתמש בבדיקות האלה יחד עם המחלקה PAssert כדי לאמת את התוצאות הצפויות.
TestStream נתמך על ידי Direct Runner ו-Dataflow Runner. דוגמת הקוד הבאה יוצרת טרנספורמציה של TestStream:
final Duration WINDOW_DURATION = Duration.standardMinutes(3);

@Rule
public final transient TestPipeline p = TestPipeline.create();

@Test
@Category(NeedsRunner.class)
public void testDroppedLateData() {
   TestStream<String> input = TestStream.create(StringUtf8Coder.of())
      // Add elements arriving before the watermark
      .addElements(
         TimestampedValue.of("a", new Instant(0L)),
         TimestampedValue.of("a", new Instant(0L)),
         TimestampedValue.of("b", new Instant(0L)),
         TimestampedValue.of("c", new Instant(0L).plus(Duration.standardMinutes(3))))
         // Advance the watermark past the end of the window
      .advanceWatermarkTo(new Instant(0L).plus(WINDOW_DURATION).plus(Duration.standardMinutes(1)))
      // Add elements which will be dropped due to lateness
      .addElements(
         TimestampedValue.of("c", new Instant(0L)))
      // Advance the watermark to infinity which will close all windows
      .advanceWatermarkToInfinity();

      PCollection<KV<String, Long>> windowedCount =
          p.apply(input)
             .apply(Window.into(FixedWindows.of(WINDOW_DURATION)))
             .apply(Count.perElement());

   PAssert.that(windowedCount)
      .containsInAnyOrder(
          // Output from first window
          KV.of("a", 2L),
          KV.of("b", 1L),
          KV.of("c", 1L));

   p.run();
}
מידע נוסף על TestStream זמין במאמר בדיקת צינורות עיבוד נתונים לא מוגבלים ב-Apache Beam.
למידע נוסף על השימוש ב-Apache Beam SDK לבדיקת יחידה, קראו את המסמכים של Apache Beam.
שימוש בשירותי Google Cloud בבדיקות שילוב
אפשר לשלב את Direct Runner עם שירותי Google Cloud , כך שבבדיקות אד-הוק בסביבה המקומית ובבדיקות שילוב מערכות אפשר להשתמש ב-Pub/Sub, ב-BigQuery ובשירותים אחרים לפי הצורך. כשמשתמשים ב-Direct Runner, צינור עיבוד הנתונים משתמש ב-Application Default Credentials (ADC) כדי לקבל את פרטי הכניסה. הגדרת ADC משתנה בהתאם למקום שבו מריצים את צינור עיבוד הנתונים. מידע נוסף זמין במאמר הגדרת Application Default Credentials.
לפני שמריצים את צינור עיבוד הנתונים, צריך לתת לחשבון שבו משתמשים בצינור עיבוד הנתונים את ההרשאות הנדרשות לכל המשאבים. למידע נוסף, קראו את המאמר אבטחה והרשאות ב-Dataflow.
כדי לבצע בדיקות שילוב מקומיות לחלוטין, אתם יכולים להשתמש באמולטורים מקומיים לחלק משירותיGoogle Cloud . אמולטורים מקומיים זמינים ל-Pub/Sub ול-Bigtable.
כדי לבצע בדיקות שילוב מערכת של פייפליינים זורמים, אתם יכולים להשתמש ב-method setBlockOnRun (שמוגדרת בממשק DirectOptions) כדי שה-Direct Runner יריץ את הפייפליין באופן אסינכרוני.
אחרת, הפעלת צינור עיבוד הנתונים חוסמת את תהליך ההורה שקורא לו (לדוגמה, סקריפט בצינור עיבוד הנתונים של ה-build) עד שצינור עיבוד הנתונים נעצר באופן ידני. אם מריצים את צינור עיבוד הנתונים באופן אסינכרוני, אפשר להשתמש במכונה PipelineResult שמוחזרת כדי לבטל את ההרצה של צינור עיבוד הנתונים, כמו שמוצג בדוגמת הקוד הבאה:
public interface StreamingIntegrationTestOptions extends
   DirectOptions, StreamingOptions, MyOtherPipelineOptions {
   ...
}

@Rule
public final transient TestPipeline p = TestPipeline.create();

@Test
@Category(NeedsRunner.class)
public void testNonBlockingPipeline() {
    StreamingIntegrationTestOptions options =
        p.getOptions().as(StreamingIntegrationOptions.class);

    options.setBlockOnRun(false); // Set non-blocking pipeline execution
    options.setStreaming(true); // Set streaming mode

    p.apply(...); // Apply pipeline transformations

    PipelineResult result = p.run(); // Run the pipeline

    // Generate input, verify output, etc
    ...

    // Later on, cancel the pipeline using the previously returned
    result.cancel();
}
בדיקות מקצה לקצה
בדיקות מקצה לקצה מאמתות את הפעולה התקינה של צינור עיבוד הנתונים מקצה לקצה, על ידי הפעלתו ב-Dataflow Runner בתנאים שדומים מאוד לייצור. הבדיקות מאמתות שהלוגיקה העסקית פועלת בצורה נכונה באמצעות Dataflow Runner, ובודקות אם צינור עיבוד הנתונים פועל כצפוי בעומסים דמויי ייצור. בדרך כלל מריצים בדיקות מקצה לקצה בפרויקט Google Cloud ייעודי שמוגדר כסביבת טרום-ייצור.
כדי לבדוק את צינור עיבוד הנתונים בקני מידה שונים, אפשר להשתמש בסוגים שונים של בדיקות מקצה לקצה, לדוגמה:
- כדי לאמת במהירות את הפונקציונליות של צינור עיבוד הנתונים בסביבת טרום-הייצור, כדאי להריץ בדיקות מקצה לקצה בקנה מידה קטן, באמצעות חלק קטן (למשל אחוז אחד) ממערך הנתונים לבדיקה.
- מריצים בדיקות מקצה לקצה בקנה מידה גדול באמצעות מערך נתונים מלא לבדיקה, כדי לאמת את הפונקציונליות של צינור עיבוד הנתונים בתנאים ובנפחי נתונים שדומים לאלה שבסביבת הייצור.
בפייפליינים זורמים, מומלץ להריץ פייפליינים לבדיקה במקביל לפייפליין בסביבת הייצור, אם הם יכולים להשתמש באותם נתונים. התהליך הזה מאפשר להשוות בין התוצאות וההתנהגות התפעולית, כמו התאמה אוטומטית לעומס (scaling) וביצועים.
בדיקות מקצה לקצה עוזרות לחזות עד כמה צינור עיבוד הנתונים יעמוד ביעדי ה-SLO בסביבת הייצור. בסביבת טרום-הייצור, צינור עיבוד הנתונים נבדק בתנאים שדומים לתנאי הייצור. בבדיקות מקצה לקצה, צינורות עיבוד הנתונים פועלים באמצעות Dataflow Runner כדי לעבד קבוצות נתונים מלאות של קובצי עזר שתואמות או דומות מאוד לקבוצות נתונים בסביבת הייצור.
יכול להיות שלא תצליחו ליצור נתונים סינתטיים לבדיקה שמדמים במדויק נתונים אמיתיים. כדי לפתור את הבעיה, אפשר להשתמש בתמציות נקיות ממקורות נתונים בסביבת הייצור כדי ליצור מערכי נתונים להפניה, שבהם כל המידע הרגיש עובר הסרת פרטי זיהוי באמצעות טרנספורמציות מתאימות. למטרה הזו, מומלץ להשתמש ב-Sensitive Data Protection. Sensitive Data Protection יכול לזהות מידע אישי רגיש במגוון סוגי תוכן ומקורות נתונים, ולהחיל מגוון שיטות להסרת פרטים מזהים, כולל צנזור, התממת מידע, הצפנה תוך שמירה על הפורמט ושינוי תאריכים.
ההבדלים בבדיקות מקצה לקצה של צינורות עיבוד נתונים באצווה ובפייפליין זורם
לפני שמריצים בדיקה מלאה מקצה לקצה על מערך נתונים גדול, כדאי להריץ בדיקה על אחוז קטן יותר של נתוני הבדיקה (למשל אחוז אחד) ולוודא שההתנהגות הצפויה מתרחשת תוך זמן קצר יותר. כמו בבדיקות אינטגרציה באמצעות Direct Runner, אתם יכולים להשתמש ב-PAssert באובייקטים של PCollection כשאתם מריצים צינורות עיבוד נתונים באמצעות Dataflow Runner. מידע נוסף על PAssert זמין בקטע בדיקות יחידה בדף הזה.
בהתאם לתרחיש לדוגמה, יכול להיות שאימות של פלט גדול מאוד מבדיקות מקצה לקצה לא יהיה מעשי, יהיה יקר או מאתגר בדרך אחרת. במקרה כזה, אפשר לאמת דגימות מייצגות מקבוצת התוצאות של הפלט. לדוגמה, אתם יכולים להשתמש ב-BigQuery כדי לדגום ולהשוות שורות פלט עם קבוצת נתונים של תוצאות צפויות.
בפייפליינים זורמים, יכול להיות שיהיה קשה לדמות תנאי סטרימינג מציאותיים באמצעות נתונים סינתטיים. דרך נפוצה לספק נתונים בסטרימינג לבדיקות מקצה לקצה היא לשלב את הבדיקות עם מקורות נתונים בסביבת הייצור. אם אתם משתמשים ב-Pub/Sub כמקור נתונים, אתם יכולים להפעיל זרם נתונים נפרד לבדיקות מקצה לקצה באמצעות מינויים נוספים לנושאים קיימים. לאחר מכן תוכלו להשוות בין התוצאות של צינורות עיבוד נתונים שונים שצורכים את אותם נתונים, וזה שימושי לאימות של צינורות עיבוד נתונים מועמדים מול צינורות עיבוד נתונים אחרים של טרום-ייצור וייצור.
בתרשים הבא מוצג איך השיטה הזו מאפשרת להריץ במקביל צינור עיבוד נתונים בסביבת ייצור וצינור עיבוד נתונים בסביבת בדיקה, בסביבות פריסה שונות.

בתרשים, שני צינורות עיבוד הנתונים קוראים מאותו נושא Pub/Sub, אבל הם משתמשים במינויים נפרדים. ההגדרה הזו מאפשרת לשני הצינורות לעבד את אותם הנתונים באופן עצמאי, ולהשוות בין התוצאות. צינור עיבוד הנתונים לבדיקה משתמש בחשבון שירות נפרד מפרויקט הייצור, ולכן לא משתמש במכסת המנויים של Pub/Sub בפרויקט הייצור.
בניגוד לפייפליינים של אצווה, פייפליינים של סטרימינג ממשיכים לפעול עד שמבטלים אותם באופן מפורש. בבדיקות מקצה לקצה, צריך להחליט אם להשאיר את צינור עיבוד הנתונים פועל, אולי עד להרצת הבדיקה הבאה מקצה לקצה, או לבטל את צינור עיבוד הנתונים בנקודה שמייצגת את השלמת הבדיקה כדי שתוכלו לבדוק את התוצאות.
סוג נתוני הבדיקה שבהם אתם משתמשים משפיע על ההחלטה הזו. לדוגמה, אם אתם משתמשים בקבוצה מוגבלת של נתוני בדיקה שסופקו לפייפליין הזורם, אתם יכולים לבטל את הפייפליין כשכל הרכיבים סיימו את העיבוד. לחלופין, אם אתם משתמשים במקור נתונים אמיתי, כמו נושא קיים של Pub/Sub שמשמש בסביבת הייצור, או אם אתם יוצרים נתוני בדיקה באופן רציף, יכול להיות שתרצו להמשיך להריץ צינורות עיבוד נתונים לבדיקה לאורך תקופה ארוכה יותר. האפשרות השנייה מאפשרת להשוות את ההתנהגות לסביבת הייצור, או אפילו לצינורות עיבוד נתונים אחרים לבדיקה.