


Menguji pipeline Apache Beam secara lokal dan di seluruh lingkungan staging memungkinkan Anda memvalidasi logika transformasi data dan menemukan cacat sebelum men-deploy tugas ke Dataflow. Siklus proses pengembangan ini membantu Anda mempersingkat proses proses debug, melindungi sistem downstream dari data yang rusak, dan meningkatkan keandalan pipeline dalam produksi.
Ringkasan
Cara kode untuk pipeline Anda diimplementasikan memiliki pengaruh yang signifikan terhadap seberapa baik performa pipeline dalam produksi. Untuk membantu Anda membuat kode pipeline yang berfungsi dengan benar dan efisien, dokumen ini menjelaskan hal berikut:
- Runner pipeline untuk mendukung eksekusi kode dalam berbagai tahap pengembangan dan deployment.
- Lingkungan deployment yang memungkinkan Anda menjalankan pipeline selama pengembangan, pengujian, praproduksi, dan produksi.
- Kode dan template pipeline open source yang dapat Anda gunakan apa adanya, atau sebagai dasar untuk pipeline baru guna mempercepat pengembangan kode.
- Pendekatan praktik terbaik untuk menguji kode pipeline. Pertama, dokumen ini memberikan ringkasan yang mencakup cakupan dan hubungan berbagai jenis pengujian, seperti pengujian unit, pengujian integrasi, dan pengujian menyeluruh. Kedua, setiap jenis pengujian dieksplorasi secara mendetail, termasuk metode untuk membuat dan mengintegrasikan dengan data pengujian, serta runner pipeline yang akan digunakan untuk setiap pengujian.
Runner pipeline
Selama pengembangan dan pengujian, Anda menggunakan runner Apache Beam yang berbeda untuk menjalankan kode pipeline. Apache Beam SDK menyediakan Direct Runner untuk pengembangan dan pengujian lokal. Alat otomatisasi rilis Anda juga dapat menggunakan Direct Runner untuk pengujian unit dan pengujian integrasi. Misalnya, Anda dapat menggunakan Direct Runner dalam pipeline continuous integration (CI).
Pipeline yang di-deploy ke Dataflow menggunakan Dataflow Runner, yang menjalankan pipeline Anda di lingkungan yang mirip dengan lingkungan produksi. Selain itu, Anda dapat menggunakan Dataflow Runner untuk pengujian pengembangan ad hoc dan untuk pengujian pipeline menyeluruh.
Meskipun halaman ini berfokus pada menjalankan pipeline yang dibuat menggunakan Apache Beam Java SDK, Dataflow juga mendukung pipeline Apache Beam yang dikembangkan menggunakan Python dan Go. Apache Beam Java, Python, dan Go SDK tersedia secara umum untuk Dataflow. Developer SQL juga dapat menggunakan Apache Beam SQL untuk membuat pipeline yang menggunakan dialek SQL yang sudah dikenal.
Menyiapkan lingkungan deployment
Untuk memisahkan pengguna, data, kode, dan resource lainnya di berbagai tahap pengembangan, buat lingkungan deployment. Jika memungkinkan, untuk menyediakan lingkungan yang terisolasi untuk berbagai tahap pengembangan pipeline, gunakan projectGoogle Cloud yang terpisah.
Bagian berikut menjelaskan kumpulan lingkungan deployment yang umum.
Lingkungan lokal
Lingkungan lokal adalah workstation developer. Untuk pengembangan dan pengujian cepat, gunakan Direct Runner untuk menjalankan kode pipeline secara lokal.
Pipeline yang dijalankan secara lokal menggunakan Direct Runner dapat berinteraksi dengan resource Google Cloud jarak jauh, seperti topik Pub/Sub atau tabel BigQuery. Beri setiap developer project Google Cloud terpisah sehingga mereka memiliki sandbox untuk pengujian ad hoc dengan layananGoogle Cloud .
Beberapa layanan Google Cloud , seperti Pub/Sub dan Bigtable, menyediakan emulator untuk pengembangan lokal. Anda dapat menggunakan emulator ini dengan Direct Runner untuk mengaktifkan pengembangan dan pengujian lokal secara menyeluruh.
Lingkungan sandbox
Lingkungan sandbox adalah project Google Cloud yang memberi developer akses ke layanan Google Cloud selama pengembangan kode. Developer pipeline dapat berbagi project Google Cloud dengan developer lain, atau menggunakan project masing-masing. Penggunaan project individual mengurangi kompleksitas perencanaan terkait penggunaan resource bersama dan pengelolaan kuota.
Developer menggunakan lingkungan sandbox untuk menjalankan pipeline ad hoc dengan Dataflow Runner. Lingkungan sandbox berguna untuk men-debug dan menguji kode terhadap runner produksi selama fase pengembangan kode. Misalnya, eksekusi pipeline ad hoc memungkinkan developer melakukan hal berikut:
- Mengamati efek perubahan kode pada perilaku penskalaan.
- Memahami potensi perbedaan antara perilaku Direct Runner dan Dataflow Runner.
- Pahami cara Dataflow menerapkan pengoptimalan grafik.
Untuk pengujian ad hoc, developer dapat men-deploy kode dari lingkungan lokal mereka untuk menjalankan Dataflow dalam lingkungan sandbox mereka.
Lingkungan praproduksi
Lingkungan praproduksi ditujukan untuk fase pengembangan yang perlu dijalankan dalam kondisi seperti produksi, seperti pengujian menyeluruh. Gunakan project terpisah untuk lingkungan praproduksi dan konfigurasikan agar semirip mungkin dengan produksi. Demikian pula, untuk memungkinkan pengujian menyeluruh dengan skala seperti produksi, buat kuota project Google Cloud untuk Dataflow dan layanan lainnya semirip mungkin dengan lingkungan produksi.
Bergantung pada persyaratan, Anda dapat memisahkan praproduksi lebih lanjut ke dalam beberapa lingkungan. Misalnya, lingkungan kontrol kualitas dapat mendukung pekerjaan analis kualitas untuk menguji tujuan tingkat layanan (SLO) seperti kebenaran, keaktualan, dan performa data dalam berbagai kondisi workload.
Pengujian menyeluruh mencakup integrasi dengan sumber data dan sink dalam cakupan pengujian. Pertimbangkan cara menyediakannya dalam lingkungan praproduksi. Anda dapat menyimpan data pengujian di lingkungan praproduksi itu sendiri. Misalnya, data pengujian disimpan di bucket Cloud Storage bersama data input Anda. Dalam kasus lain, data pengujian mungkin berasal dari luar lingkungan praproduksi, seperti topik Pub/Sub melalui langganan terpisah yang ada di lingkungan produksi. Untuk pipeline streaming, Anda juga dapat menjalankan pengujian menyeluruh menggunakan data yang dihasilkan, misalnya, menggunakan Streaming Data Generator Dataflow untuk mengemulasi karakteristik dan volume data seperti produksi.
Untuk pipeline streaming, gunakan lingkungan praproduksi untuk menguji update pipeline sebelum perubahan apa pun dilakukan pada produksi. Penting untuk menguji dan memverifikasi prosedur update untuk pipeline streaming, terutama jika Anda perlu mengoordinasikan beberapa langkah, seperti saat menjalankan pipeline paralel untuk menghindari periode nonaktif.
Lingkungan produksi
Lingkungan produksi adalah project Google Cloud khusus. Continuous delivery menyalin artefak deployment ke lingkungan produksi setelah semua pengujian menyeluruh lulus.
Praktik terbaik pengembangan
Lihat Praktik terbaik pipeline Dataflow.
Menguji pipeline Anda
Dalam pengembangan software, pengujian unit, pengujian integrasi, dan pengujian menyeluruh adalah jenis pengujian software yang umum. Jenis pengujian ini juga berlaku untuk pipeline data.
Apache Beam SDK menyediakan fungsi untuk mengaktifkan pengujian ini. Idealnya, setiap jenis pengujian menargetkan lingkungan deployment yang berbeda. Diagram berikut mengilustrasikan cara pengujian unit, pengujian integrasi, dan pengujian menyeluruh diterapkan ke berbagai bagian pipeline dan data Anda.
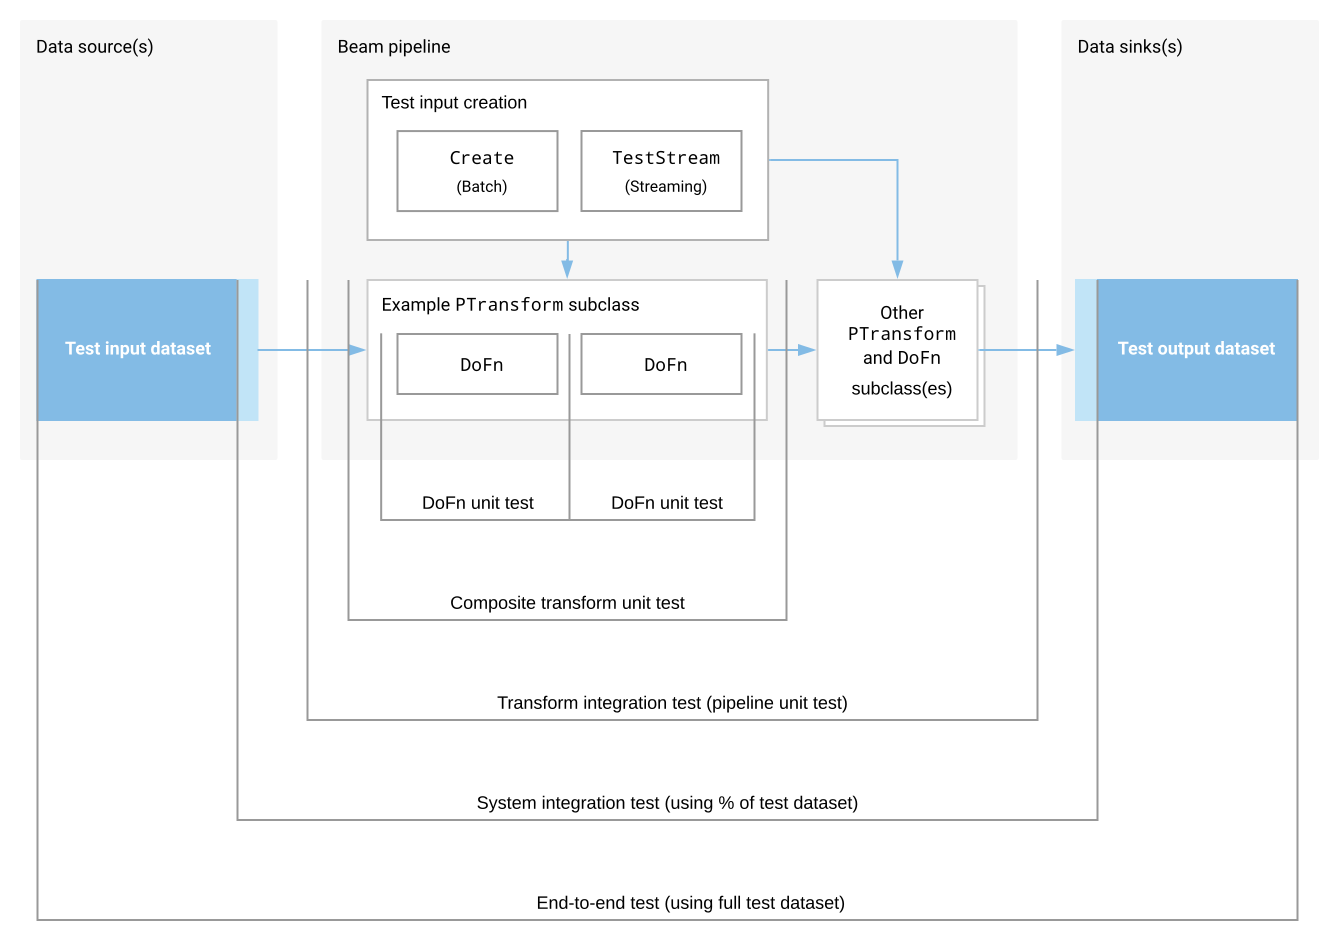
Diagram ini menunjukkan cakupan berbagai pengujian dan hubungannya dengan
transformasi (subclass DoFn dan PTransform), pipeline, sumber data, dan
sink data.
Bagian berikut menjelaskan cara berbagai pengujian software formal diterapkan ke pipeline data menggunakan Dataflow. Saat Anda membaca bagian ini, lihat kembali diagram untuk memahami hubungan berbagai jenis pengujian.
Sampling data
Untuk mengamati data di setiap langkah pipeline Dataflow, aktifkan sampling data selama pengujian. Dengan begitu, Anda dapat melihat output transformasi untuk memastikan outputnya benar.
Pengujian unit
Pengujian unit menilai fungsi yang benar dari subclass DoFn dan
transformasi gabungan
(subclass PTransform) dengan membandingkan output transformasi tersebut dengan
set input dan output data yang diverifikasi. Biasanya, developer dapat menjalankan pengujian ini di lingkungan lokal. Pengujian juga dapat berjalan secara otomatis melalui
otomatisasi pengujian unit menggunakan continuous integration (CI) di lingkungan
build.
Direct Runner menjalankan pengujian unit menggunakan subset data pengujian referensi yang lebih kecil yang berfokus pada pengujian logika bisnis transformasi Anda. Data pengujian harus cukup kecil agar muat dalam memori lokal pada mesin yang menjalankan pengujian.
Apache Beam SDK menyediakan aturan JUnit yang disebut
TestPipeline
untuk pengujian unit setiap transformasi (subclass DoFn), transformasi gabungan
(subclass PTransform), dan seluruh pipeline. Anda dapat menggunakan TestPipeline pada
runner pipeline Apache Beam seperti Direct Runner atau
Dataflow Runner untuk menerapkan pernyataan pada konten
objek PCollection menggunakan
PAssert,
seperti yang ditunjukkan dalam cuplikan kode
class pengujian JUnit berikut:
@Rule
public final transient TestPipeline p = TestPipeline.create();

@Test
@Category(NeedsRunner.class)
public void myPipelineTest() throws Exception {
  final PCollection<String> pcol = p.apply(...)
  PAssert.that(pcol).containsInAnyOrder(...);
  p.run();
}
Pengujian unit untuk setiap transformasi
Dengan memfaktorkan kode menjadi transformasi yang dapat digunakan kembali, misalnya, sebagai class bertingkat statis atau tingkat atas, Anda dapat membuat pengujian yang ditargetkan untuk berbagai bagian pipeline. Selain manfaat pengujian, transformasi yang dapat digunakan kembali meningkatkan kemudahan pemeliharaan dan kemampuan untuk digunakan kembali kode dengan mengenkapsulasi logika bisnis pipeline Anda secara alami ke dalam bagian-bagian komponen. Sebaliknya, menguji setiap bagian pipeline mungkin sulit jika pipeline menggunakan class dalam anonim untuk mengimplementasikan transformasi.
Cuplikan Java berikut menunjukkan implementasi transformasi sebagai class dalam anonim, yang membuat pengujian menjadi lebih sulit.
PipelineOptions options = PipelineOptionsFactory.create();

Pipeline p = Pipeline.create(options)

PCollection<Integer> output =
    p.apply("Read from text", TextIO.Read.from(...))
        .apply("Split words", ParDo.of(new DoFn() {
          // Untestable anonymous transform 1
        }))
        .apply("Generate anagrams", ParDo.of(new DoFn() {
          // Untestable anonymous transform 2
        }))
        .apply("Count words", Count.perElement());
Bandingkan contoh sebelumnya dengan contoh berikut, tempat class dalam anonim
direfaktorisasi menjadi subclass DoFn konkret bernama. Anda dapat membuat pengujian unit individual untuk setiap subclass DoFn konkret yang membentuk pipeline end-to-end.
PipelineOptions options = PipelineOptionsFactory.create();

Pipeline p = Pipeline.create(options)

PCollection<Integer> output =
    p.apply("Read from text", TextIO.Read.from(...))
        .apply("Split words", ParDo.of(new SplitIntoWordsFn()))
        .apply("Generate anagrams", ParDo.of(new GenerateAnagramsFn()))
        .apply("Count words", Count.perElement());
Menguji setiap subclass DoFn mirip dengan pengujian unit pipeline batch yang berisi satu transformasi. Gunakan transformasi Create untuk
membuat objek PCollection dari data pengujian, lalu teruskan ke objek
DoFn. Gunakan PAssert untuk menyatakan bahwa konten objek PCollection sudah benar. Contoh kode Java berikut menggunakan class PAssert untuk
memeriksa bentuk output yang benar.
@Rule
public final transient TestPipeline p = TestPipeline.create();

@Test
@Category(NeedsRunner.class)
public void testGenerateAnagramsFn() {
    // Create the test input
    PCollection<String> words = p.apply(Create.of("friend"));

    // Test a single DoFn using the test input
    PCollection<String> anagrams =
        words.apply("Generate anagrams", ParDo.of(new GenerateAnagramsFn()));

    // Assert correct output from
    PAssert.that(anagrams).containsInAnyOrder(
        "finder", "friend", "redfin", "refind");

    p.run();
}
Pengujian integrasi
Pengujian integrasi memverifikasi fungsi yang benar dari seluruh pipeline Anda. Pertimbangkan jenis pengujian integrasi berikut:
- Pengujian integrasi transformasi yang menilai fungsi terintegrasi dari semua transformasi individual yang membentuk pipeline data Anda. Anggap pengujian integrasi transformasi sebagai pengujian unit untuk seluruh pipeline Anda, tidak termasuk integrasi dengan sumber dan sink data eksternal. Apache Beam SDK menyediakan metode untuk menyediakan data pengujian ke pipeline data Anda dan untuk memverifikasi hasil pemrosesan. Direct Runner digunakan untuk menjalankan pengujian integrasi transformasi.
Pengujian integrasi sistem yang menilai integrasi pipeline data Anda dengan sumber dan sink data langsung. Agar pipeline Anda dapat berkomunikasi dengan sistem eksternal, Anda perlu mengonfigurasi pengujian dengan kredensial yang sesuai untuk mengakses layanan eksternal. Pipeline streaming berjalan tanpa batas waktu, jadi Anda harus memutuskan kapan dan cara menghentikan pipeline yang sedang berjalan. Dengan menggunakan Direct Runner untuk menjalankan pengujian integrasi sistem, Anda dapat dengan cepat memverifikasi integrasi antara pipeline dan sistem lain tanpa perlu mengirimkan tugas Dataflow dan menunggu hingga selesai.
Rancang pengujian transformasi dan integrasi sistem untuk memberikan deteksi dan masukan cacat yang cepat tanpa memperlambat produktivitas developer. Untuk pengujian yang berjalan lebih lama, seperti yang berjalan sebagai tugas Dataflow, Anda mungkin ingin menggunakan pengujian menyeluruh yang jarang dijalankan.
Anggap pipeline data sebagai satu atau beberapa transformasi terkait. Anda
dapat membuat transformasi gabungan yang mengenkapsulasi untuk pipeline dan
menggunakan
TestPipeline
untuk melakukan pengujian integrasi seluruh pipeline. Bergantung pada apakah Anda ingin menguji pipeline dalam mode batch atau streaming, Anda menyediakan data pengujian menggunakan transformasi Create atau TestStream.
Menggunakan data pengujian untuk pengujian integrasi
Di lingkungan produksi, pipeline Anda kemungkinan akan terintegrasi dengan berbagai sumber dan sink data. Namun, untuk pengujian unit dan pengujian integrasi transformasi, fokuslah pada verifikasi logika bisnis kode pipeline Anda dengan memberikan input pengujian dan memverifikasi output secara langsung. Selain menyederhanakan pengujian, pendekatan ini memungkinkan Anda mengisolasi masalah khusus pipeline dari masalah yang mungkin disebabkan oleh sumber dan sink data.
Menguji pipeline batch
Untuk pipeline batch, gunakan transformasi Create untuk membuat objek PCollection
dari data pengujian input Anda dari koleksi dalam memori standar, seperti
objek List Java. Menggunakan transformasi Create sesuai jika data pengujian Anda cukup kecil untuk disertakan dalam kode. Kemudian, Anda dapat menggunakan PAssert pada objek PCollection output untuk menentukan kebenaran kode pipeline Anda.
Pendekatan ini didukung oleh Direct Runner dan Dataflow Runner.
Cuplikan kode Java berikut menunjukkan pernyataan terhadap objek PCollection output dari transformasi gabungan yang mencakup beberapa atau semua transformasi individual yang membentuk pipeline (WeatherStatsPipeline). Pendekatan ini mirip dengan pengujian unit transformasi individual dalam pipeline.
private class WeatherStatsPipeline extends
    PTransform<PCollection<Integer>, PCollection<WeatherSummary>> {
  @Override
  public PCollection<WeatherSummary> expand(PCollection<Integer> input) {
    // Pipeline transforms …
  }
}

@Rule
public final transient TestPipeline p = TestPipeline.create();

@Test
@Category(NeedsRunner.class)
public void testWeatherPipeline() {
  // Create test input consisting of temperature readings
  PCollection<Integer> tempCelsius =
      p.apply(Create.of(24, 22, 20, 22, 21, 21, 20));

  // CalculateWeatherStats calculates the min, max, and average temperature
  PCollection<WeatherSummary> result =
      tempCelsius.apply("Calculate weather statistics", new WeatherStatsPipeline());

   // Assert correct output from CalculateWeatherStats
   PAssert.thatSingleton(result).isEqualTo(new WeatherSummary.Builder()
       .withAverageTemp(21)
       .withMaxTemp(24)
       .withMinTemp(20)
       .build());

   p.run();
}
Untuk menguji perilaku windowing, Anda juga dapat menggunakan transformasi Create untuk membuat elemen dengan stempel waktu, seperti yang ditunjukkan dalam cuplikan kode berikut:
private static final Duration WINDOW_DURATION = Duration.standardMinutes(3);

@Rule
public final transient TestPipeline p = TestPipeline.create();

@Test
@Category(NeedsRunner.class)
public void testWindowedData() {
    PCollection<String> input =
        p.apply(
            Create.timestamped(
                    TimestampedValue.of("a", new Instant(0L)),
                    TimestampedValue.of("a", new Instant(0L)),
                    TimestampedValue.of("b", new Instant(0L)),
                    TimestampedValue.of("c", new Instant(0L)),
                    TimestampedValue.of("c", new Instant(0L).plus(WINDOW_DURATION)))
                .withCoder(StringUtf8Coder.of()));

   PCollection<KV<String, Long>> windowedCount =
       input
           .apply(Window.into(FixedWindows.of(WINDOW_DURATION)))
           .apply(Count.perElement());

    PAssert.that(windowedCount)
        .containsInAnyOrder(
            // Output from first window
            KV.of("a", 2L),
            KV.of("b", 1L),
            KV.of("c", 1L),
            // Output from second window
            KV.of("c", 1L));

   p.run();
}
Menguji pipeline streaming
Pipeline streaming berisi asumsi yang menentukan cara menangani data yang tidak terbatas. Asumsi ini sering kali berkaitan dengan ketepatan waktu data dalam kondisi dunia nyata, sehingga berdampak pada kebenaran, bergantung pada apakah asumsi tersebut terbukti benar atau salah. Pengujian integrasi untuk pipeline streaming idealnya mencakup pengujian yang menyimulasikan sifat non-deterministik dari kedatangan data streaming.
Untuk
mengaktifkan pengujian tersebut,
Apache Beam SDK menyediakan class
TestStream
untuk memodelkan efek pengaturan waktu elemen (data awal, tepat waktu, atau terlambat) pada
hasil pipeline data Anda. Gunakan pengujian ini bersama dengan
class
PAssert untuk memverifikasi hasil yang diharapkan.
TestStream didukung oleh Direct Runner dan Dataflow Runner. Contoh kode berikut membuat transformasi TestStream:
final Duration WINDOW_DURATION = Duration.standardMinutes(3);

@Rule
public final transient TestPipeline p = TestPipeline.create();

@Test
@Category(NeedsRunner.class)
public void testDroppedLateData() {
   TestStream<String> input = TestStream.create(StringUtf8Coder.of())
      // Add elements arriving before the watermark
      .addElements(
         TimestampedValue.of("a", new Instant(0L)),
         TimestampedValue.of("a", new Instant(0L)),
         TimestampedValue.of("b", new Instant(0L)),
         TimestampedValue.of("c", new Instant(0L).plus(Duration.standardMinutes(3))))
         // Advance the watermark past the end of the window
      .advanceWatermarkTo(new Instant(0L).plus(WINDOW_DURATION).plus(Duration.standardMinutes(1)))
      // Add elements which will be dropped due to lateness
      .addElements(
         TimestampedValue.of("c", new Instant(0L)))
      // Advance the watermark to infinity which will close all windows
      .advanceWatermarkToInfinity();

      PCollection<KV<String, Long>> windowedCount =
          p.apply(input)
             .apply(Window.into(FixedWindows.of(WINDOW_DURATION)))
             .apply(Count.perElement());

   PAssert.that(windowedCount)
      .containsInAnyOrder(
          // Output from first window
          KV.of("a", 2L),
          KV.of("b", 1L),
          KV.of("c", 1L));

   p.run();
}
Untuk mengetahui informasi selengkapnya tentang TestStream, lihat
Menguji Pipeline Tidak Terbatas di Apache Beam.
Untuk mengetahui informasi selengkapnya tentang cara menggunakan Apache Beam SDK untuk pengujian unit, lihat dokumentasi Apache Beam.
Menggunakan layanan Google Cloud dalam pengujian integrasi
Direct Runner dapat berintegrasi dengan layanan Google Cloud , sehingga pengujian ad hoc di lingkungan lokal dan pengujian integrasi sistem dapat menggunakan Pub/Sub, BigQuery, dan layanan lainnya sesuai kebutuhan. Saat Anda menggunakan Direct Runner, pipeline Anda menggunakan Kredensial Default Aplikasi (ADC) untuk mendapatkan kredensial. Cara menyiapkan ADC bergantung pada tempat pipeline Anda berjalan. Untuk mengetahui informasi selengkapnya, lihat Menyiapkan Kredensial Default Aplikasi.
Anda harus memberikan izin yang memadai ke akun yang digunakan pipeline untuk resource yang diperlukan sebelum menjalankan pipeline. Untuk mengetahui detail selengkapnya, lihat Keamanan dan izin Dataflow.
Untuk pengujian integrasi yang sepenuhnya lokal, Anda dapat menggunakan emulator lokal untuk beberapa layananGoogle Cloud . Emulator lokal tersedia untuk Pub/Sub dan Bigtable.
Untuk pengujian integrasi sistem pipeline streaming, Anda dapat menggunakan metode setBlockOnRun (ditentukan dalam antarmuka DirectOptions) agar Direct Runner menjalankan pipeline Anda secara asinkron.
Jika tidak, eksekusi pipeline akan memblokir proses induk panggilan (misalnya, skrip di pipeline build Anda) hingga pipeline dihentikan secara manual. Jika menjalankan pipeline secara asinkron, Anda dapat menggunakan instance
PipelineResult
yang ditampilkan untuk membatalkan eksekusi pipeline, seperti yang ditunjukkan dalam contoh kode
berikut:
public interface StreamingIntegrationTestOptions extends
   DirectOptions, StreamingOptions, MyOtherPipelineOptions {
   ...
}

@Rule
public final transient TestPipeline p = TestPipeline.create();

@Test
@Category(NeedsRunner.class)
public void testNonBlockingPipeline() {
    StreamingIntegrationTestOptions options =
        p.getOptions().as(StreamingIntegrationOptions.class);

    options.setBlockOnRun(false); // Set non-blocking pipeline execution
    options.setStreaming(true); // Set streaming mode

    p.apply(...); // Apply pipeline transformations

    PipelineResult result = p.run(); // Run the pipeline

    // Generate input, verify output, etc
    ...

    // Later on, cancel the pipeline using the previously returned
    result.cancel();
}
Pengujian menyeluruh
Pengujian menyeluruh memverifikasi operasi yang benar dari pipeline menyeluruh Anda dengan menjalankannya di Runner Dataflow dalam kondisi yang sangat menyerupai produksi. Pengujian ini memverifikasi bahwa logika bisnis berfungsi dengan benar menggunakan Dataflow Runner dan menguji apakah pipeline berperforma seperti yang diharapkan dalam beban seperti produksi. Anda biasanya menjalankan pengujian end-to-end di project Google Cloud khusus yang ditetapkan sebagai lingkungan praproduksi.
Untuk menguji pipeline Anda pada skala yang berbeda, gunakan berbagai jenis pengujian end-to-end, misalnya:
- Jalankan pengujian menyeluruh berskala kecil menggunakan sebagian kecil (seperti satu persen) set data pengujian Anda untuk memvalidasi fungsi pipeline dengan cepat di lingkungan praproduksi.
- Jalankan pengujian menyeluruh berskala besar menggunakan set data pengujian lengkap untuk memvalidasi fungsi pipeline dalam volume dan kondisi data yang mirip dengan produksi.
Untuk pipeline streaming, sebaiknya jalankan pipeline pengujian secara paralel dengan pipeline produksi jika keduanya dapat menggunakan data yang sama. Proses ini memungkinkan Anda membandingkan hasil dan perilaku operasional, seperti penskalaan otomatis dan performa.
Pengujian menyeluruh membantu memprediksi seberapa baik pipeline Anda akan memenuhi SLO produksi. Lingkungan praproduksi menguji pipeline Anda dalam kondisi yang mirip dengan produksi. Dalam pengujian menyeluruh, pipeline dijalankan menggunakan Dataflow Runner untuk memproses set data referensi lengkap yang cocok atau sangat mirip dengan set data dalam produksi.
Mungkin tidak mungkin untuk membuat data sintetis untuk pengujian yang secara akurat menyimulasikan data nyata. Untuk mengatasi masalah ini, salah satu pendekatannya adalah menggunakan ekstrak yang dibersihkan dari sumber data produksi untuk membuat set data referensi, di mana data sensitif apa pun dide-identifikasi melalui transformasi yang sesuai. Sebaiknya gunakan Sensitive Data Protection untuk tujuan ini. Sensitive Data Protection dapat mendeteksi data sensitif dari berbagai jenis konten dan sumber data serta menerapkan berbagai teknik de-identifikasi, termasuk penyuntingan, penyamaran, enkripsi yang mempertahankan format, dan pergeseran tanggal.
Perbedaan dalam pengujian menyeluruh untuk pipeline batch dan pipeline streaming
Sebelum menjalankan pengujian menyeluruh terhadap set data pengujian yang besar, Anda
mungkin ingin menjalankan pengujian dengan persentase data pengujian yang lebih kecil (seperti
satu persen) dan memverifikasi perilaku yang diharapkan dalam waktu yang lebih singkat. Seperti
halnya pengujian integrasi menggunakan Direct Runner, Anda dapat menggunakan PAssert pada
objek PCollection saat menjalankan pipeline menggunakan
Dataflow Runner. Untuk mengetahui informasi selengkapnya tentang PAssert, lihat bagian Pengujian unit di halaman ini.
Bergantung pada kasus penggunaan Anda, memverifikasi output yang sangat besar dari pengujian menyeluruh mungkin tidak praktis, mahal, atau sulit. Dalam hal ini, Anda dapat memverifikasi sampel perwakilan dari set hasil output. Misalnya, Anda dapat menggunakan BigQuery untuk mengambil sampel dan membandingkan baris output dengan set data referensi dari hasil yang diharapkan.
Untuk pipeline streaming, menyimulasikan kondisi streaming yang realistis dengan data sintetis mungkin akan sulit. Cara umum untuk menyediakan data streaming untuk pengujian menyeluruh adalah dengan mengintegrasikan pengujian dengan sumber data produksi. Jika menggunakan Pub/Sub sebagai sumber data, Anda dapat mengaktifkan datastream terpisah untuk pengujian menyeluruh melalui langganan tambahan ke topik yang ada. Kemudian, Anda dapat membandingkan hasil dari berbagai pipeline yang menggunakan data yang sama, yang berguna untuk memverifikasi pipeline kandidat terhadap pipeline praproduksi dan produksi lainnya.
Diagram berikut menunjukkan cara metode ini memungkinkan pipeline produksi dan pipeline pengujian berjalan secara paralel di berbagai lingkungan deployment.

Dalam diagram, kedua pipeline membaca dari topik Pub/Sub yang sama, tetapi menggunakan langganan terpisah. Penyiapan ini memungkinkan kedua pipeline memproses data yang sama secara independen dan memungkinkan Anda membandingkan hasilnya. Pipeline pengujian menggunakan akun layanan terpisah dari project produksi, sehingga menghindari penggunaan kuota pelanggan Pub/Sub untuk project produksi.
Tidak seperti pipeline batch, pipeline streaming terus berjalan hingga dibatalkan secara eksplisit. Dalam pengujian menyeluruh, Anda harus memutuskan apakah akan membiarkan pipeline berjalan, mungkin hingga pengujian menyeluruh berikutnya dijalankan, atau membatalkan pipeline pada titik yang mewakili penyelesaian pengujian sehingga Anda dapat memeriksa hasilnya.
Jenis data pengujian yang Anda gunakan akan memengaruhi keputusan ini. Misalnya, jika Anda menggunakan set data pengujian terbatas yang disediakan untuk pipeline streaming, Anda dapat membatalkan pipeline saat semua elemen telah selesai diproses. Atau, jika Anda menggunakan sumber data sungguhan, seperti topik Pub/Sub yang sudah ada dan digunakan dalam produksi, atau jika Anda membuat data pengujian secara terus-menerus, Anda mungkin ingin terus menjalankan pipeline pengujian dalam jangka waktu yang lebih lama. Opsi kedua memungkinkan Anda membandingkan perilaku dengan lingkungan produksi, atau bahkan dengan pipeline pengujian lainnya.