


Testare le pipeline Apache Beam localmente e in ambienti di gestione temporanea ti consente di convalidare la logica di trasformazione dei dati e di rilevare i difetti prima di eseguire il deployment dei job in Dataflow. Questo ciclo di vita dello sviluppo ti aiuta a ridurre il processo di debug, proteggere i sistemi downstream dai dati danneggiati e migliorare l'affidabilità della pipeline in produzione.
Panoramica
Il modo in cui viene implementato il codice della pipeline ha un'influenza significativa sul rendimento della pipeline in produzione. Per aiutarti a creare un codice della pipeline che funzioni in modo corretto ed efficiente, questo documento spiega quanto segue:
- Runner di pipeline per supportare l'esecuzione di codice nelle diverse fasi di sviluppo e deployment.
- Ambienti di deployment che consentono di eseguire pipeline durante lo sviluppo, i test, la pre-produzione e la produzione.
- Codice e modelli di pipeline open source che puoi utilizzare così come sono o come base per nuove pipeline per accelerare lo sviluppo del codice.
- Un approccio basato sulle best practice per testare il codice della pipeline. Innanzitutto, questo documento fornisce una panoramica che include l'ambito e la relazione di diversi tipi di test, come test delle unità, test di integrazione e test end-to-end. In secondo luogo, ogni tipo di test viene esplorato in dettaglio, inclusi i metodi per creare e integrare i dati di test e i runner della pipeline da utilizzare per ogni test.
Runner della pipeline
Durante lo sviluppo e i test, utilizzi diversi runner Apache Beam per eseguire il codice della pipeline. L'SDK Apache Beam fornisce un Direct Runner per lo sviluppo e i test locali. Gli strumenti di automazione delle release possono anche utilizzare il Direct Runner per i test delle unità e i test di integrazione. Ad esempio, puoi utilizzare il runner diretto all'interno della pipeline di integrazione continua (CI).
Le pipeline di cui viene eseguito il deployment in Dataflow utilizzano il runner di Dataflow, che esegue la pipeline in ambienti simili a quelli di produzione. Inoltre, puoi utilizzare Dataflow Runner per i test di sviluppo ad hoc e per i test delle pipeline end-to-end.
Sebbene questa pagina si concentri sull'esecuzione di pipeline create utilizzando l'SDK Apache Beam per Java, Dataflow supporta anche le pipeline Apache Beam sviluppate utilizzando Python e Go. Gli SDK Apache Beam per Java, Python e Go sono disponibili a livello generale per Dataflow. Gli sviluppatori SQL possono anche utilizzare Apache Beam SQL per creare pipeline che utilizzano dialetti SQL familiari.
Configura un ambiente di deployment
Per separare utenti, dati, codice e altre risorse nelle diverse fasi di sviluppo, crea ambienti di deployment. Quando possibile, per fornire ambienti isolati per le diverse fasi di sviluppo della pipeline, utilizza progettiGoogle Cloud separati.
Le sezioni seguenti descrivono un insieme tipico di ambienti di deployment.
Ambiente locale
L'ambiente locale è la workstation di uno sviluppatore. Per lo sviluppo e i test rapidi, utilizza Direct Runner per eseguire il codice della pipeline localmente.
Le pipeline eseguite localmente utilizzando il runner diretto possono interagire con risorse Google Cloud remote, come argomenti Pub/Sub o tabelle BigQuery. Assegna ai singoli sviluppatori progettiGoogle Cloud separati in modo che abbiano una sandbox per i test ad hoc con i serviziGoogle Cloud .
Alcuni servizi Google Cloud , come Pub/Sub e Bigtable, forniscono emulatori per lo sviluppo locale. Puoi utilizzare questi emulatori con Direct Runner per abilitare lo sviluppo e i test locali end-to-end.
Ambiente sandbox
L'ambiente sandbox è un progetto Google Cloud che fornisce agli sviluppatori l'accesso ai servizi Google Cloud durante lo sviluppo del codice. Gli sviluppatori di pipeline possono condividere un progetto Google Cloud con altri sviluppatori o utilizzare i propri progetti individuali. L'utilizzo di singoli progetti riduce la complessità della pianificazione relativa all'utilizzo delle risorse condivise e alla gestione delle quote.
Gli sviluppatori utilizzano l'ambiente sandbox per eseguire pipeline ad hoc con Dataflow Runner. L'ambiente sandbox è utile per il debug e il test del codice rispetto a un runner di produzione durante la fase di sviluppo del codice. Ad esempio, l'esecuzione ad hoc della pipeline consente agli sviluppatori di:
- Osserva l'effetto delle modifiche al codice sul comportamento di scalabilità.
- Comprendere le potenziali differenze tra il comportamento del runner diretto e del runner Dataflow.
- Scopri come Dataflow applica le ottimizzazioni dei grafici.
Per i test ad hoc, gli sviluppatori possono eseguire il deployment del codice dal proprio ambiente locale per eseguire Dataflow nel proprio ambiente sandbox.
Ambiente di pre-produzione
L'ambiente di pre-produzione è destinato alle fasi di sviluppo che devono essere eseguite in condizioni simili a quelle di produzione, come i test end-to-end. Utilizza un progetto separato per l'ambiente di pre-produzione e configuralo in modo che sia il più simile possibile alla produzione. Analogamente, per consentire test end-to-end con una scalabilità simile a quella di produzione, imposta le quote di progetto Google Cloud per Dataflow e altri servizi in modo che siano il più simili possibile all'ambiente di produzione.
A seconda dei requisiti, puoi suddividere ulteriormente la pre-produzione in più ambienti. Ad esempio, un ambiente di controllo qualità può supportare il lavoro degli analisti della qualità per testare gli obiettivi del livello di servizio (SLO), come la correttezza, l'aggiornamento e le prestazioni dei dati in diverse condizioni di workload.
I test end-to-end includono l'integrazione con origini dati e sink nell'ambito dei test. Valuta come renderli disponibili nell'ambiente di pre-produzione. Puoi archiviare i dati di test nell'ambiente di pre-produzione stesso. Ad esempio, i dati di test vengono archiviati in un bucket Cloud Storage con i dati di input. In altri casi, i dati di test potrebbero provenire dall'esterno dell'ambiente di pre-produzione, ad esempio un argomento Pub/Sub tramite una sottoscrizione separata che si trova nell'ambiente di produzione. Per le pipeline di streaming, puoi anche eseguire test end-to-end utilizzando i dati generati, ad esempio utilizzando il generatore di dati di streaming di Dataflow per emulare caratteristiche e volumi di dati simili a quelli di produzione.
Per le pipeline di streaming, utilizza l'ambiente di pre-produzione per testare gli aggiornamenti delle pipeline prima di apportare modifiche alla produzione. È importante testare e verificare le procedure di aggiornamento per le pipeline di streaming, in particolare se devi coordinare più passaggi, ad esempio quando esegui pipeline parallele per evitare tempi di inattività.
Ambiente di produzione
L'ambiente di produzione è un progetto Google Cloud dedicato. La distribuzione continua copia gli artefatti di deployment nell'ambiente di produzione quando tutti i test end-to-end sono stati superati.
Best practice per lo sviluppo
Consulta le best practice per le pipeline Dataflow.
Testa la pipeline
Nello sviluppo di software, i test delle unità, i test di integrazione e i test end-to-end sono tipi comuni di test del software. Questi tipi di test sono applicabili anche alle pipeline di dati.
L'SDK Apache Beam fornisce funzionalità per abilitare questi test. Idealmente, ogni tipo di test ha come target un ambiente di deployment diverso. Il seguente diagramma illustra come i test delle unità, i test di integrazione e i test end-to-end si applicano a diverse parti della pipeline e dei dati.
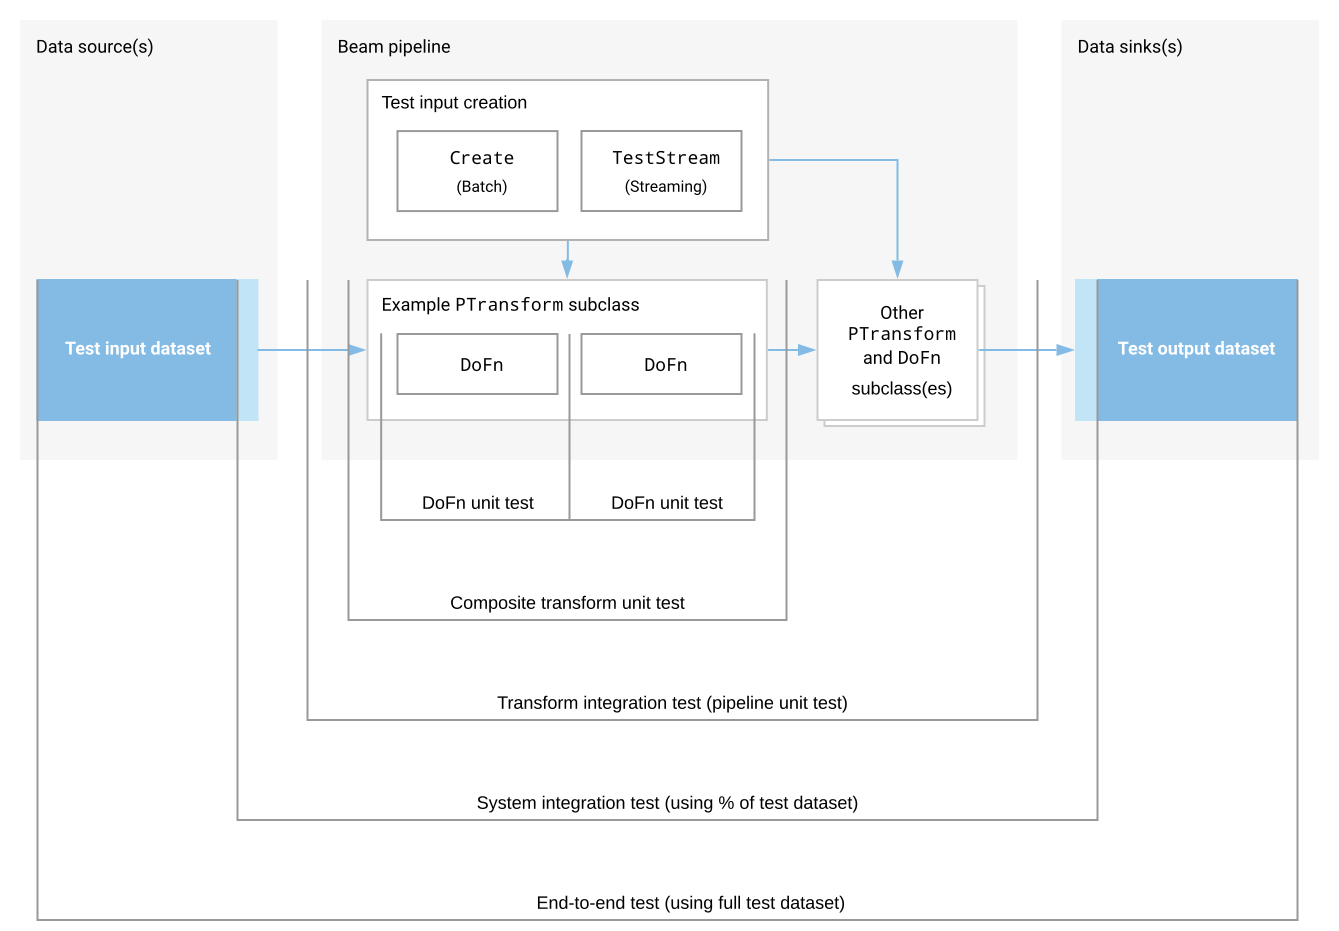
Il diagramma mostra l'ambito dei diversi test e la loro relazione con le trasformazioni (sottoclassi DoFn e PTransform), le pipeline, le origini dati e i data sink.
Le sezioni seguenti descrivono come vari test formali del software si applicano alle pipeline di dati che utilizzano Dataflow. Mentre leggi questa sezione, fai riferimento al diagramma per capire in che modo i diversi tipi di test sono correlati.
Campionamento dei dati
Per osservare i dati in ogni passaggio di una pipeline Dataflow, attiva il campionamento dei dati durante i test. In questo modo puoi visualizzare gli output delle trasformazioni per assicurarti che siano corretti.
Test delle unità
I test delle unità valutano il corretto funzionamento delle sottoclassi DoFn e delle trasformazioni composite (sottoclassi PTransform) confrontando l'output di queste trasformazioni con un insieme verificato di input e output di dati. In genere, gli sviluppatori possono eseguire questi test nell'ambiente locale. I test possono anche essere eseguiti automaticamente tramite l'automazione dei test delle unità utilizzando l'integrazione continua (CI) nell'ambiente di build.
Il runner diretto esegue test delle unità utilizzando un sottoinsieme più piccolo di dati di test di riferimento incentrati sul test della logica di business delle trasformazioni. I dati di test devono essere di dimensioni sufficientemente ridotte da poter essere inseriti nella memoria locale della macchina che esegue il test.
L'SDK Apache Beam fornisce una regola JUnit chiamata TestPipeline per i test delle unità delle singole trasformazioni (sottoclassi DoFn), delle trasformazioni composite (sottoclassi PTransform) e di intere pipeline. Puoi utilizzare TestPipeline su un runner della pipeline Apache Beam, ad esempio Direct Runner o Dataflow Runner, per applicare asserzioni ai contenuti degli oggetti PCollection utilizzando PAssert, come mostrato nel seguente snippet di codice di una classe di test JUnit:
@Rule
public final transient TestPipeline p = TestPipeline.create();

@Test
@Category(NeedsRunner.class)
public void myPipelineTest() throws Exception {
  final PCollection<String> pcol = p.apply(...)
  PAssert.that(pcol).containsInAnyOrder(...);
  p.run();
}
Test delle unità per singole trasformazioni
Se suddividi il codice in trasformazioni riutilizzabili, ad esempio come classi nidificate statiche o di primo livello, puoi creare test mirati per diverse parti della pipeline. Oltre ai vantaggi dei test, le trasformazioni riutilizzabili migliorano la manutenibilità e la riusabilità del codice incapsulando in modo naturale la logica di business della pipeline in parti di componenti. Al contrario, testare singole parti della pipeline potrebbe essere difficile se la pipeline utilizza classi interne anonime per implementare le trasformazioni.
Il seguente snippet Java mostra l'implementazione delle trasformazioni come classi interne anonime, il che rende più difficile il test.
PipelineOptions options = PipelineOptionsFactory.create();

Pipeline p = Pipeline.create(options)

PCollection<Integer> output =
    p.apply("Read from text", TextIO.Read.from(...))
        .apply("Split words", ParDo.of(new DoFn() {
          // Untestable anonymous transform 1
        }))
        .apply("Generate anagrams", ParDo.of(new DoFn() {
          // Untestable anonymous transform 2
        }))
        .apply("Count words", Count.perElement());
Confronta l'esempio precedente con il seguente, in cui le classi interne anonime vengono rifattorizzate in sottoclassi DoFn concrete denominate. Puoi creare test delle unità individuali per ogni sottoclasse DoFn concreta che compone la pipeline end-to-end.
PipelineOptions options = PipelineOptionsFactory.create();

Pipeline p = Pipeline.create(options)

PCollection<Integer> output =
    p.apply("Read from text", TextIO.Read.from(...))
        .apply("Split words", ParDo.of(new SplitIntoWordsFn()))
        .apply("Generate anagrams", ParDo.of(new GenerateAnagramsFn()))
        .apply("Count words", Count.perElement());
Il test di ogni sottoclasse DoFn è simile al test delle unità di una pipeline batch che contiene una singola trasformazione. Utilizza la trasformazione Create per creare un oggetto PCollection di dati di test, quindi passalo all'oggetto DoFn. Utilizza PAssert per verificare che i contenuti dell'oggetto PCollection siano corretti. Il seguente esempio di codice Java utilizza la classe PAssert per verificare la correttezza del formato di output.
@Rule
public final transient TestPipeline p = TestPipeline.create();

@Test
@Category(NeedsRunner.class)
public void testGenerateAnagramsFn() {
    // Create the test input
    PCollection<String> words = p.apply(Create.of("friend"));

    // Test a single DoFn using the test input
    PCollection<String> anagrams =
        words.apply("Generate anagrams", ParDo.of(new GenerateAnagramsFn()));

    // Assert correct output from
    PAssert.that(anagrams).containsInAnyOrder(
        "finder", "friend", "redfin", "refind");

    p.run();
}
Test di integrazione
I test di integrazione verificano il corretto funzionamento dell'intera pipeline. Prendi in considerazione i seguenti tipi di test di integrazione:
- Un test di integrazione delle trasformazioni che valuta la funzionalità integrata di tutte le singole trasformazioni che compongono la pipeline di dati. Pensa ai test di integrazione delle trasformazioni come a un test delle unità per l'intera pipeline, esclusa l'integrazione con origini dati e sink esterni. L'SDK Apache Beam fornisce metodi per fornire dati di test alla pipeline di dati e per verificare i risultati dell'elaborazione. Il runner diretto viene utilizzato per eseguire i test di integrazione delle trasformazioni.
Un test di integrazione del sistema che valuta l'integrazione della pipeline di dati con origini e sink di dati in tempo reale. Affinché la pipeline possa comunicare con i sistemi esterni, devi configurare i test con le credenziali appropriate per accedere ai servizi esterni. Le pipeline di streaming vengono eseguite a tempo indeterminato, quindi devi decidere quando e come interrompere la pipeline in esecuzione. Utilizzando il runner diretto per eseguire i test di integrazione del sistema, puoi verificare rapidamente l'integrazione tra la tua pipeline e altri sistemi senza dover inviare un job Dataflow e attendere che venga completato.
Progetta test di trasformazione e integrazione del sistema per fornire un rilevamento rapido dei difetti e un feedback senza rallentare la produttività degli sviluppatori. Per i test di più lunga durata, come quelli eseguiti come job Dataflow, ti consigliamo di utilizzare un test end-to-end eseguito con minore frequenza.
Pensa a una pipeline di dati come a una o più trasformazioni correlate. Puoi creare una trasformazione composita incapsulante per la tua pipeline e utilizzare TestPipeline per eseguire un test di integrazione dell'intera pipeline. A seconda che tu voglia testare la pipeline in modalità batch o flusso, fornisci i dati di test utilizzando le trasformazioni Create o TestStream.
Utilizza i dati di test per i test di integrazione
Nell'ambiente di produzione, è probabile che la pipeline si integri con diverse origini e sink di dati. Tuttavia, per i test delle unità e i test di integrazione delle trasformazioni, concentrati sulla verifica della logica di business del codice della pipeline fornendo input di test e verificando direttamente l'output. Oltre a semplificare i test, questo approccio ti consente di isolare i problemi specifici della pipeline da quelli che potrebbero essere causati da origini e sink di dati.
Testa le pipeline batch
Per le pipeline batch, utilizza la trasformazione Create per creare un oggetto PCollection dei dati di test di input da una raccolta standard in memoria, ad esempio un oggetto Java List. L'utilizzo della trasformazione Create è appropriato se i dati di test sono di dimensioni sufficientemente ridotte da poter essere inclusi nel codice. Puoi quindi utilizzare PAssert sugli oggetti PCollection di output per determinare la correttezza del codice della pipeline.
Questo approccio è supportato da Direct Runner e da Dataflow Runner.
Il seguente snippet di codice Java mostra le asserzioni sugli oggetti PCollection di output di una trasformazione composita che include alcune o tutte le singole trasformazioni che costituiscono una pipeline (WeatherStatsPipeline). L'approccio è simile al test delle unità delle singole trasformazioni in una pipeline.
private class WeatherStatsPipeline extends
    PTransform<PCollection<Integer>, PCollection<WeatherSummary>> {
  @Override
  public PCollection<WeatherSummary> expand(PCollection<Integer> input) {
    // Pipeline transforms …
  }
}

@Rule
public final transient TestPipeline p = TestPipeline.create();

@Test
@Category(NeedsRunner.class)
public void testWeatherPipeline() {
  // Create test input consisting of temperature readings
  PCollection<Integer> tempCelsius =
      p.apply(Create.of(24, 22, 20, 22, 21, 21, 20));

  // CalculateWeatherStats calculates the min, max, and average temperature
  PCollection<WeatherSummary> result =
      tempCelsius.apply("Calculate weather statistics", new WeatherStatsPipeline());

   // Assert correct output from CalculateWeatherStats
   PAssert.thatSingleton(result).isEqualTo(new WeatherSummary.Builder()
       .withAverageTemp(21)
       .withMaxTemp(24)
       .withMinTemp(20)
       .build());

   p.run();
}
Per testare il comportamento del windowing, puoi anche utilizzare la trasformazione Create per creare elementi con timestamp, come mostrato nel seguente snippet di codice:
private static final Duration WINDOW_DURATION = Duration.standardMinutes(3);

@Rule
public final transient TestPipeline p = TestPipeline.create();

@Test
@Category(NeedsRunner.class)
public void testWindowedData() {
    PCollection<String> input =
        p.apply(
            Create.timestamped(
                    TimestampedValue.of("a", new Instant(0L)),
                    TimestampedValue.of("a", new Instant(0L)),
                    TimestampedValue.of("b", new Instant(0L)),
                    TimestampedValue.of("c", new Instant(0L)),
                    TimestampedValue.of("c", new Instant(0L).plus(WINDOW_DURATION)))
                .withCoder(StringUtf8Coder.of()));

   PCollection<KV<String, Long>> windowedCount =
       input
           .apply(Window.into(FixedWindows.of(WINDOW_DURATION)))
           .apply(Count.perElement());

    PAssert.that(windowedCount)
        .containsInAnyOrder(
            // Output from first window
            KV.of("a", 2L),
            KV.of("b", 1L),
            KV.of("c", 1L),
            // Output from second window
            KV.of("c", 1L));

   p.run();
}
Testa le pipeline di streaming
Le pipeline di streaming contengono ipotesi che definiscono come gestire i dati illimitati. Queste ipotesi riguardano spesso la tempestività dei dati in condizioni reali e, di conseguenza, hanno un impatto sulla correttezza a seconda che le ipotesi si rivelino vere o false. I test di integrazione per le pipeline di streaming dovrebbero idealmente includere test che simulano la natura non deterministica dell'arrivo dei dati in streaming.
Per abilitare questi test, l'SDK Apache Beam fornisce la classe TestStream per modellare gli effetti delle tempistiche degli elementi (dati in anticipo, puntuali o in ritardo) sui risultati della pipeline di dati. Utilizza questi test insieme alla classe PAssert per verificare i risultati previsti.
TestStream è supportato da Direct Runner e Dataflow Runner. Il seguente esempio di codice crea una trasformazione TestStream:
final Duration WINDOW_DURATION = Duration.standardMinutes(3);

@Rule
public final transient TestPipeline p = TestPipeline.create();

@Test
@Category(NeedsRunner.class)
public void testDroppedLateData() {
   TestStream<String> input = TestStream.create(StringUtf8Coder.of())
      // Add elements arriving before the watermark
      .addElements(
         TimestampedValue.of("a", new Instant(0L)),
         TimestampedValue.of("a", new Instant(0L)),
         TimestampedValue.of("b", new Instant(0L)),
         TimestampedValue.of("c", new Instant(0L).plus(Duration.standardMinutes(3))))
         // Advance the watermark past the end of the window
      .advanceWatermarkTo(new Instant(0L).plus(WINDOW_DURATION).plus(Duration.standardMinutes(1)))
      // Add elements which will be dropped due to lateness
      .addElements(
         TimestampedValue.of("c", new Instant(0L)))
      // Advance the watermark to infinity which will close all windows
      .advanceWatermarkToInfinity();

      PCollection<KV<String, Long>> windowedCount =
          p.apply(input)
             .apply(Window.into(FixedWindows.of(WINDOW_DURATION)))
             .apply(Count.perElement());

   PAssert.that(windowedCount)
      .containsInAnyOrder(
          // Output from first window
          KV.of("a", 2L),
          KV.of("b", 1L),
          KV.of("c", 1L));

   p.run();
}
Per saperne di più su TestStream, consulta Test delle pipeline non limitate in Apache Beam.
Per saperne di più su come utilizzare l'SDK Apache Beam per i test delle unità, consulta la documentazione di Apache Beam.
Utilizza i servizi Google Cloud nei test di integrazione
Direct Runnerpuò integrarsi con i servizi Google Cloud , in modo che i test ad hoc nell'ambiente locale e i test di integrazione del sistema possano utilizzare Pub/Sub, BigQuery e altri servizi in base alle esigenze. Quando utilizzi Direct Runner, la pipeline utilizza le Credenziali predefinite dell'applicazione (ADC) per ottenere le credenziali. La configurazione di ADC dipende dalla posizione in cui viene eseguita la pipeline. Per ulteriori informazioni, consulta Configura le credenziali predefinite dell'applicazione.
Prima di eseguire la pipeline, devi concedere autorizzazioni sufficienti all'account utilizzato dalla pipeline per tutte le risorse richieste. Per maggiori dettagli, consulta Sicurezza e autorizzazioni di Dataflow.
Per i test di integrazione completamente locali, puoi utilizzare emulatori locali per alcuni serviziGoogle Cloud . Gli emulatori locali sono disponibili per Pub/Sub e Bigtable.
Per i test di integrazione di sistema delle pipeline di streaming, puoi utilizzare il metodo setBlockOnRun (definito nell'interfaccia DirectOptions) per fare in modo che Direct Runner esegua la pipeline in modo asincrono.
In caso contrario, l'esecuzione della pipeline blocca il processo padre chiamante (ad esempio uno script nella pipeline di build) finché la pipeline non viene arrestata manualmente. Se esegui la pipeline in modo asincrono, puoi utilizzare l'istanza
PipelineResult
restituita per annullare l'esecuzione della pipeline, come mostrato nell'esempio di codice seguente:
public interface StreamingIntegrationTestOptions extends
   DirectOptions, StreamingOptions, MyOtherPipelineOptions {
   ...
}

@Rule
public final transient TestPipeline p = TestPipeline.create();

@Test
@Category(NeedsRunner.class)
public void testNonBlockingPipeline() {
    StreamingIntegrationTestOptions options =
        p.getOptions().as(StreamingIntegrationOptions.class);

    options.setBlockOnRun(false); // Set non-blocking pipeline execution
    options.setStreaming(true); // Set streaming mode

    p.apply(...); // Apply pipeline transformations

    PipelineResult result = p.run(); // Run the pipeline

    // Generate input, verify output, etc
    ...

    // Later on, cancel the pipeline using the previously returned
    result.cancel();
}
Test end-to-end
I test end-to-end verificano il corretto funzionamento della pipeline end-to-end eseguendola sul runner Dataflow in condizioni molto simili a quelle di produzione. I test verificano che la logica di business funzioni correttamente utilizzando il runner di Dataflow e verificano se la pipeline funziona come previsto con carichi simili a quelli di produzione. In genere, i test end-to-end vengono eseguiti in un progetto Google Cloud dedicato, designato come ambiente di pre-produzione.
Per testare la pipeline su scale diverse, utilizza diversi tipi di test end-to-end, ad esempio:
- Esegui test end-to-end su piccola scala utilizzando una piccola parte (ad esempio l'1%) del set di dati di test per convalidare rapidamente la funzionalità della pipeline nell'ambiente di pre-produzione.
- Esegui test end-to-end su larga scala utilizzando un set di dati di test completo per convalidare la funzionalità della pipeline in volumi e condizioni di dati simili a quelli di produzione.
Per le pipeline di streaming, ti consigliamo di eseguire le pipeline di test in parallelo con la pipeline di produzione, se possono utilizzare gli stessi dati. Questo processo ti consente di confrontare i risultati e il comportamento operativo, ad esempio la scalabilità automatica e le prestazioni.
I test end-to-end aiutano a prevedere in che misura la pipeline soddisferà gli SLO di produzione. L'ambiente di pre-produzione testa la pipeline in condizioni simili a quelle di produzione. All'interno dei test end-to-end, le pipeline vengono eseguite utilizzando il runner Dataflow per elaborare set di dati di riferimento completi che corrispondono o assomigliano molto ai set di dati in produzione.
Potrebbe non essere possibile generare dati sintetici per i test che simulano accuratamente i dati reali. Per risolvere questo problema, un approccio consiste nell'utilizzare estratti puliti dalle origini dei dati di prodotto per creare set di dati di riferimento, in cui tutti i dati sensibili vengono anonimizzati tramite trasformazioni appropriate. A questo scopo, ti consigliamo di utilizzare Sensitive Data Protection. Sensitive Data Protection può rilevare dati sensibili da una serie di tipi di contenuti e origini dati e applicare una serie di tecniche di anonimizzazione, tra cui oscuramento, mascheramento, crittografia con protezione del formato (FPE) e spostamento delle date.
Differenze nei test end-to-end per le pipeline batch e di streaming
Prima di eseguire un test end-to-end completo su un set di dati di test di grandi dimensioni, ti consigliamo di eseguire un test con una percentuale inferiore dei dati di test (ad esempio l'1%) e di verificare il comportamento previsto in un periodo di tempo più breve. Come per i test di integrazione che utilizzano Direct Runner, puoi utilizzare PAssert sugli oggetti PCollection quando esegui le pipeline utilizzando Dataflow Runner. Per saperne di più su PAssert, consulta la sezione Test delle unità in questa pagina.
A seconda del caso d'uso, la verifica di un output molto grande dai test end-to-end potrebbe essere poco pratica, costosa o comunque difficile. In questo caso, puoi verificare campioni rappresentativi del set di risultati di output. Ad esempio, puoi utilizzare BigQuery per campionare e confrontare le righe di output con un set di dati di riferimento dei risultati previsti.
Per le pipeline di streaming, simulare condizioni di streaming realistiche con dati sintetici potrebbe essere difficile. Un modo comune per fornire dati in streaming per i test end-to-end è integrare i test con le origini dati di produzione. Se utilizzi Pub/Sub come origine dati, puoi attivare un flusso di dati separato per i test end-to-end tramite sottoscrizioni aggiuntive ad argomenti esistenti. Puoi quindi confrontare i risultati di diverse pipeline che utilizzano gli stessi dati, il che è utile per verificare le pipeline candidate rispetto ad altre pipeline di pre-produzione e produzione.
Il seguente diagramma mostra come questo metodo consente l'esecuzione in parallelo di una pipeline di produzione e di una pipeline di test in ambienti di deployment diversi.

Nel diagramma, entrambe le pipeline leggono dallo stesso argomento Pub/Sub, ma utilizzano sottoscrizioni separate. Questa configurazione consente alle due pipeline di elaborare gli stessi dati in modo indipendente e di confrontare i risultati. La pipeline di test utilizza un account di servizio separato dal progetto di produzione, evitando così di utilizzare la quota di sottoscrittori Pub/Sub per il progetto di produzione.
A differenza delle pipeline batch, le pipeline di streaming continuano a essere eseguite finché non vengono annullate esplicitamente. Nei test end-to-end, devi decidere se lasciare la pipeline in esecuzione, magari fino all'esecuzione del test end-to-end successivo, o annullarla in un punto che rappresenta il completamento del test in modo da poter esaminare i risultati.
Il tipo di dati di test che utilizzi influisce su questa decisione. Ad esempio, se utilizzi un set limitato di dati di test forniti alla pipeline di streaming, potresti annullare la pipeline quando tutti gli elementi hanno completato l'elaborazione. In alternativa, se utilizzi un'origine dati reale, ad esempio un argomento Pub/Sub esistente utilizzato in produzione, o se generi dati di test in modo continuo, potresti voler mantenere in esecuzione le pipeline di test per un periodo più lungo. Quest'ultimo ti consente di confrontare il comportamento con l'ambiente di produzione o anche con altre pipeline di test.