


התכונה right fitting משתמשת ברמזים למשאבים של Apache Beam כדי להתאים אישית את משאבי ה-worker לצינור עיבוד נתונים. היכולת לטרגט כמה משאבים שונים לשלבים ספציפיים בצינור עיבוד הנתונים מספקת גמישות ויכולות נוספות, וגם חיסכון פוטנציאלי בעלויות. אתם יכולים להקצות משאבים יקרים יותר לשלבים בצינור עיבוד הנתונים שדורשים אותם, ומשאבים זולים יותר לשלבים אחרים. אתם יכולים להשתמש בהתאמה נכונה כדי לציין את דרישות המשאבים של צינור עיבוד נתונים שלם או של שלבים ספציפיים בצינור עיבוד הנתונים.
תמיכה ומגבלות
- הנחיות למשאבים נתמכות ב-Apache Beam Java וב-Python SDK, בגרסאות 2.31.0 ואילך.
- התאמה נכונה נתמכת בצינורות עיבוד נתונים באצווה.
התאמה נכונה נתמכת בצינורות עיבוד נתונים בסטרימינג שמופעלת בהם התאמה אופקית לעומס (Horizontal Autoscaling).
- כדי להפעיל את התכונה, מגדירים את אפשרות צינור עיבוד הנתונים
--experiments=enable_streaming_rightfitting.
- כדי להפעיל את התכונה, מגדירים את אפשרות צינור עיבוד הנתונים
כשמשתמשים בהתאמה, צריך להשאיר את ההתאמה האוטומטית של קנה המידה האופקי מופעלת. אם משביתים את ההתאמה האוטומטית האופקית לעומס, יכול להיות שהמשימה תפעל עם התאמה נמוכה מהצפוי. כדי להגביל את מספר ה-workers שהמשימה משתמשת בהם, צריך להגדיר במקום זאת את
maxNumWorkersאו אתmax_num_workersבאפשרויות של צינור עיבוד הנתונים.התאמה נכונה תומכת ב-Dataflow Prime.
התאמה נכונה לא תומכת ב-FlexRS.
כשמשתמשים בערך right fitting, לא משתמשים ב
worker_acceleratorservice option.כשמשתמשים בשינוי קנה מידה אנכי, אי אפשר להשתמש בבחירה אוטומטית של מכונות וירטואליות.
הפעלת התאמה נכונה
כדי להפעיל את ההתאמה הנכונה, משתמשים באחד או יותר מהרמזים הזמינים למשאבים בצינור עיבוד הנתונים. כשמשתמשים ברמז למשאב בצינור עיבוד הנתונים, ההתאמה הנכונה מופעלת באופן אוטומטי. למידע נוסף, קראו את הקטע שימוש ברמזים למשאבים במאמר הזה.
הנחיות זמינות למשאבים
אלה הרמזים למשאבים שזמינים.
| רמז למשאב | תיאור |
|---|---|
min_ram |
הכמות המינימלית של זיכרון RAM בג'יגה-בייט שצריך להקצות לעובדים. Dataflow משתמש בערך הזה כגבול תחתון כשמקצים זיכרון ל-workers חדשים (התאמה אופקית לעומס) או ל-workers קיימים (התאמה אנכית לעומס). לדוגמה: min_ram=RAM_VALUEGB
|
cpu_count |
מספר המעבדים הווירטואליים שיוקצו לכל וורקר. כשמשתמשים בהנחיה הזו למשאב, מערכת Dataflow בוחרת סוגי מכונות עם מספר ה-vCPU שצוין שעומדים בדרישות הזיכרון. לדוגמה: cpu_count=CPU_VALUE
|
accelerator |
הקצאה של מעבדי GPU שסופקה על ידי המשתמש, שמאפשרת לכם לשלוט בשימוש במעבדי GPU ובעלות שלהם בצינור עיבוד הנתונים ובשלבים שלו. מציינים את הסוג והמספר של יחידות ה-GPU שרוצים לצרף ל-workers של Dataflow כפרמטרים לדגל. לדוגמה: accelerator="type:GPU_TYPE;count:GPU_COUNT;machine_type:MACHINE_TYPE;CONFIGURATION_OPTIONS"
למידע נוסף על השימוש ב-GPU, קראו את המאמר שימוש ב-GPU עם Dataflow. |
בחירה אוטומטית של מכונות וירטואליות לסוגי מכונות של וורקרים
כשמשתמשים בהנחיות למשאבים min_ram או cpu_count בשלבים של צינור עיבוד הנתונים שלא דורשים מאיצים, הבחירה האוטומטית של מכונות וירטואליות מופעלת באופן אוטומטי.
כשמשתמשים בבחירה אוטומטית של מכונות וירטואליות, העובדים מוקצים מתוך מבחר של סוגי מכונות תואמים שעומדים בדרישות של צינור עיבוד הנתונים, וכך משפרים את הזמינות של הקיבולת והאמינות.
במאמר בחירה אוטומטית של מכונות וירטואליות מוסבר בפירוט איך התכונה פועלת, מה המגבלות שלה ויש המלצות לגבי סוגי האחסון.
הטמעה של רמזים לגבי משאבים
ההנחיות למשאבים מיושמות בהיררכיית הטרנספורמציה של הצינור באופן הבא:
-
min_ram: הערך של טרנספורמציה מחושב בתור הערך הגדול ביותר שלmin_ramמבין הערכים שמוגדרים בטרנספורמציה עצמה ובכל ההורים שלה בהיררכיית הטרנספורמציות.- לדוגמה: אם הנחיית הטרנספורמציה הפנימית מגדירה את
min_ramל-16GB, והנחיית הטרנספורמציה החיצונית בהיררכיה מגדירה אתmin_ramל-32GB, המערכת תשתמש בהנחיה של 32GB לכל השלבים בטרנספורמציה כולה. - לדוגמה: אם בהנחיה פנימית לטרנספורמציה מוגדר
min_ramשל 16GB, ובהנחיה חיצונית לטרנספורמציה בהיררכיה מוגדרmin_ramשל 8GB, הנחיה של 8GB תשמש לכל השלבים בטרנספורמציה החיצונית שלא נמצאים בטרנספורמציה הפנימית, והנחיה של 16GB תשמש לכל השלבים בטרנספורמציה הפנימית.
- לדוגמה: אם הנחיית הטרנספורמציה הפנימית מגדירה את
-
accelerator: הערך הפנימי ביותר בהיררכיה של הטרנספורמציה מקבל עדיפות.- דוגמה: אם רמז
acceleratorשל טרנספורמציה פנימית שונה מרמזacceleratorשל טרנספורמציה חיצונית בהיררכיה, הרמזacceleratorשל הטרנספורמציה הפנימית משמש לטרנספורמציה הפנימית.
- דוגמה: אם רמז
הנחיות שמוגדרות לכל ה-pipeline נחשבות כאילו הן מוגדרות בטרנספורמציה חיצונית נפרדת.
שימוש ברמזים למשאבים
אפשר להגדיר רמזים למשאבים בכל הצינור או בשלבים של הצינור.
הינטים למשאבים של פייפליין
אפשר להגדיר רמזים למשאבים בכל הצינור כשמריצים את הצינור משורת הפקודה.
gcloud
כדי להגדיר רמזים למשאבים כשמריצים צינור עיבוד נתונים עם תבנית Flex, משתמשים בדגל --additional-pipeline-options עם הפקודה gcloud dataflow flex-template run.
השם של אפשרות הצינור תלוי בשפת ה-SDK. לדוגמה, עבור רמזים למשאבים:
- בצינורות עיבוד נתונים ב-Java, משתמשים ב-
resourceHints. - בצינורות עיבוד נתונים ב-Python, משתמשים ב-
resource_hints.
בדוגמה הבאה מוסבר איך להגדיר רמזים למשאבים כשמריצים צינור עיבוד נתונים של תבנית Flex ב-Java:
gcloud dataflow flex-template run JOB_NAME \
    --template-file-gcs-location="gs://TEMPLATE_LOCATION" \
    --region="REGION" \
    --additional-pipeline-options=resourceHints=min_ram=RAM_VALUEGB \
    --additional-pipeline-options=resourceHints=cpu_count=CPU_VALUE \
    --parameters ...
בדוגמה הבאה אפשר לראות איך מגדירים רמזים למשאבים כשמריצים צינור עיבוד נתונים של תבנית Flex ב-Python:
gcloud dataflow flex-template run JOB_NAME \
    --template-file-gcs-location="gs://TEMPLATE_LOCATION" \
    --region="REGION" \
    --additional-pipeline-options=resource_hints=min_ram=RAM_VALUEGB \
    --additional-pipeline-options=resource_hints=cpu_count=CPU_VALUE \
    --parameters ...
Java
כדי להגדיר את סביבת Java, קראו את המאמר יצירת צינור עיבוד נתונים ב-Dataflow באמצעות Java.
בדוגמה הבאה מוסבר איך להגדיר רמזים למשאבים כשמריצים צינור עיבוד נתונים ב-Java:
mvn -Pdataflow-runner compile exec:java \
    -Dexec.mainClass=com.example.MyPipeline \
    -Dexec.args="--runner=DataflowRunner \
    --resourceHints=min_ram=RAM_VALUEGB \
    --resourceHints=cpu_count=CPU_VALUE \
    ..."
Python
כדי להגדיר את סביבת Python, עיינו במדריך של Python.
בדוגמה הבאה מוסבר איך להגדיר רמזים למשאבים כשמריצים צינור עיבוד נתונים ב-Python:
python my_pipeline.py \
    --runner=DataflowRunner \
    --resource_hints=min_ram=RAM_VALUEGB \
    --resource_hints=cpu_count=CPU_VALUE \
    ...
רמזים למשאבים של שלבים בצינור עיבוד הנתונים
אפשר להגדיר רמזים למשאבים בשלבים של צינור עיבוד הנתונים (טרנספורמציות) באופן פרוגרמטי.
Java
כדי להתקין את Apache Beam SDK ל-Java, קראו את המאמר התקנת Apache Beam SDK.
אפשר להגדיר רמזים למשאבים באופן פרוגרמטי בטרנספורמציות של צינורות עיבוד נתונים באמצעות הכיתה ResourceHints.
בדוגמה הבאה מוסבר איך להגדיר באופן פרוגרמטי רמזים למשאבים בטרנספורמציות של צינור עיבוד נתונים.
pcoll.apply(MyCompositeTransform.of(...)
    .setResourceHints(
        ResourceHints.create()
            .withMinRam("15GB")
            .withCpuCount(8)
            .withAccelerator(
    "type:nvidia-l4;count:1;install-nvidia-driver")))

pcoll.apply(ParDo.of(new BigMemFn())
    .setResourceHints(
        ResourceHints.create()
          .withMinRam("30GB")
          .withCpuCount(16)))
כדי להגדיר באופן פרוגרמטי רמזים למשאבים בכל הצינור, משתמשים בממשק ResourceHintsOptions.
Python
כדי להתקין את Apache Beam SDK ל-Python, קראו את המאמר התקנת Apache Beam SDK.
אפשר להגדיר רמזים למשאבים באופן פרוגרמטי בטרנספורמציות של צינורות עיבוד נתונים באמצעות הכיתה PTransforms.with_resource_hints.
מידע נוסף זמין במאמר הכיתה ResourceHint.
בדוגמה הבאה מוסבר איך להגדיר באופן פרוגרמטי רמזים למשאבים בטרנספורמציות של צינור עיבוד נתונים.
pcoll | MyPTransform().with_resource_hints(
    min_ram="4GB",
    cpu_count=8,
    accelerator="type:nvidia-tesla-l4;count:1;install-nvidia-driver")

pcoll | beam.ParDo(BigMemFn()).with_resource_hints(
    min_ram="30GB",
    cpu_count=16)
כדי להגדיר רמזים למשאבים בכל הצינור, משתמשים באפשרות הצינור --resource_hints כשמריצים את הצינור. לדוגמה, ראו הנחיות למשאבי צינור עיבוד נתונים.
המשך
אין תמיכה בהצעות למשאבים ב-Go.
תמיכה בכמה מאיצים
בתוך צינור עיבוד נתונים, לטרנספורמציות שונות יכולות להיות הגדרות שונות של מאיצים. ההגדרות האלה כוללות הגדרות שדורשות סוגי מכונות שונים. הגדרות המאיצים האלה ברמת הטרנספורמציה מקבלות קדימות על פני ההגדרה ברמת הצינור, אם סופקה כזו.
התאמה ומיזוג נכונים
במקרים מסוימים, טרנספורמציות שמוגדרות עם רמזים שונים למשאבים יכולות לפעול על וורקרים באותו מאגר וורקרים, כחלק מתהליך האופטימיזציה של המיזוג. כשטרנספורמציות ממוזגות, Dataflow מריץ אותן בסביבה שעומדת באיחוד של הצעות המשאבים שמוגדרות בטרנספורמציות. במקרים מסוימים, זה כולל את כל הצינור.
אם אי אפשר למזג את ההצעות למשאבים, המיזוג לא מתבצע. לדוגמה, אי אפשר למזג רמזים למשאבים של מעבדי GPU שונים, ולכן הטרנספורמציות האלה לא משולבות.
אפשר גם למנוע מיזוג על ידי הוספת פעולה לצינור עיבוד הנתונים, שמאלצת את Dataflow להמיר PCollection ביניים. האפשרות הזו שימושית במיוחד כשמנסים לבודד משאבים יקרים כמו מעבדי GPU או מכונות עם זיכרון גבוה, משלבים איטיים או משלבים שדורשים משאבי מחשוב רבים ולא זקוקים למשאבים המיוחדים האלה. במקרים כאלה, יכול להיות שכדאי לאלץ הפסקה של המיזוג בין השלבים האיטיים שמוגבלים על ידי המעבד (CPU) לבין השלבים שדורשים מעבדים גרפיים (GPU) יקרים או מכונות עם הרבה זיכרון, ולשלם את עלות המטריאליזציה שקשורה להפסקת המיזוג. איך מונעים מיזוג
התאמה של זכויות סטרימינג
במשימות סטרימינג, אפשר להפעיל את ההתאמה הנכונה על ידי הגדרת אפשרות צינור עיבוד הנתונים --experiments=enable_streaming_rightfitting.
התאמה נכונה יכולה לשפר את הביצועים של צינור עיבוד הנתונים אם הוא כולל שלבים עם דרישות שונות למשאבים.
דוגמה: צינור עיבוד נתונים עם שלב שדורש הרבה משאבי מעבד ושלב שדורש GPU
דוגמה לצינור עיבוד נתונים שיכול להפיק תועלת מהתאמה נכונה היא צינור שמבצע שלב שדורש הרבה משאבי מעבד (CPU), ואחריו שלב שדורש GPU. בלי התאמה נכונה, צריך להגדיר מאגר GPU יחיד של Worker כדי להריץ את כל שלבי צינור עיבוד הנתונים, כולל השלב שדורש שימוש אינטנסיבי ב-CPU. זה עלול להוביל לניצול חלקי של משאבי ה-GPU כשמאגר ה-workers מבצע את השלב שדורש שימוש אינטנסיבי ב-CPU.
אם ההתאמה הנכונה מופעלת ומוחלת הנחיית משאבים על השלב שדורש GPU, הצינור ייצור שני מאגרים נפרדים, כך שהשלב שדורש הרבה משאבי מעבד יבוצע על ידי מאגר ה-workers של המעבד, והשלב שדורש GPU יבוצע על ידי מאגר ה-workers של ה-GPU.
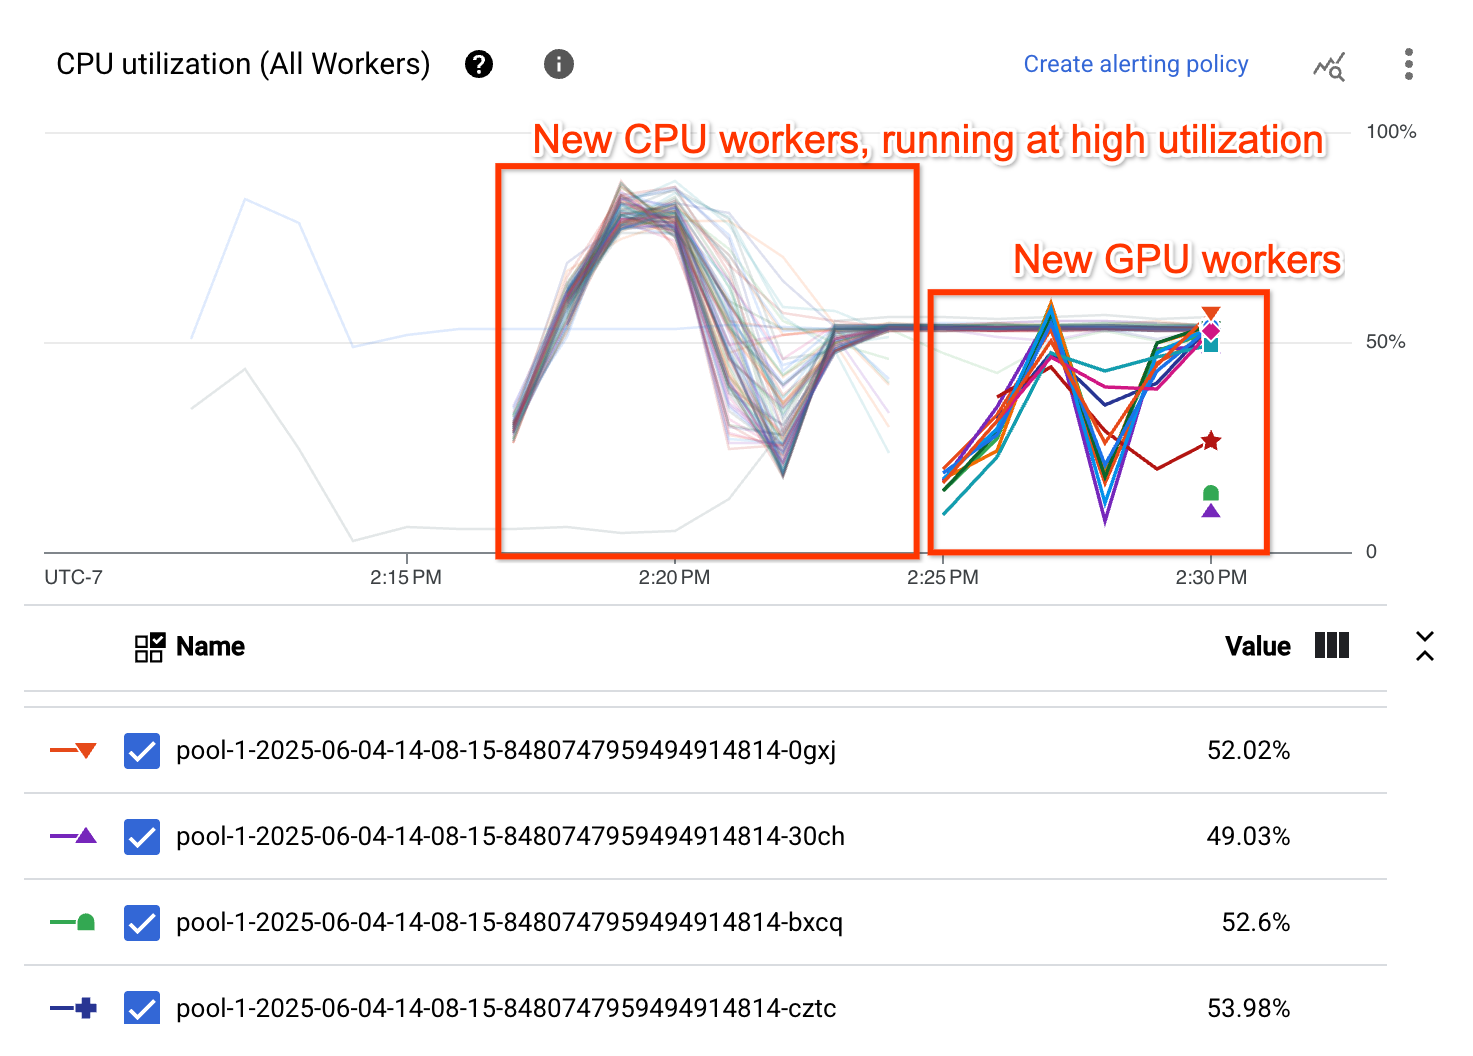
בצינור עיבוד הנתונים לדוגמה, בטבלת ההתאמה האוטומטית לעומס מוצג שמאגר ה-workers שמבצע את השלב שדורש שימוש אינטנסיבי ב-CPU, Pool 0, מוגדל בהתחלה ל-99 workers, ואחר כך מוקטן ל-87 workers. מאגר ה-workers שמריץ את השלב שדורש GPU, Pool 1, מוגדל ל-13 workers:

בתרשים CPU Utilization אפשר לראות שבשני מאגרי ה-Workers יש ניצול גבוה של המעבד:
פתרון בעיות בהתאמה של האוזניות
בקטע הזה מוסבר איך לפתור בעיות נפוצות שקשורות להתאמה.
הגדרות אישיות לא תקינות
כשמנסים להשתמש בהתאמה לימין, מופיעה השגיאה הבאה:
Workflow failed. Causes: One or more operations had an error: 'operation-OPERATION_ID':
[UNSUPPORTED_OPERATION] 'CPU_VALUE vCpus with RAM_VALUE MiB memory is
an invalid configuration for GPU_COUNT count of 'GPU_TYPE' in family 'MACHINE_TYPE'.'.
השגיאה הזו מתרחשת כשסוג ה-GPU שנבחר לא תואם לסוג המכונה שנבחרה. כדי לפתור את השגיאה, צריך לבחור סוג GPU וסוג מכונה תואמים. לפרטים על תאימות, ראו פלטפורמות GPU.
בדיקת ההתאמה של האוזנייה הימנית
כדי לוודא שההתאמה הנכונה מופעלת, אפשר להציג את המדדים של ההתאמה לעומס (autoscaling) ולוודא שהעמודה Worker pool גלויה ומציגה מאגרים שונים:

ביצועים שמתאימים לזכויות סטרימינג
יכול להיות שפייפליינים זורמים עם התאמה נכונה לא תמיד יניבו ביצועים טובים יותר מפייפליינים בלי התאמה נכונה. לדוגמה:
- הצינור משתמש ביותר עובדים
- זמן האחזור של המערכת ארוך יותר, או שהתפוקה נמוכה יותר
- הגדלים של מאגרי העובדים משתנים בתדירות גבוהה יותר, או שהם לא מתייצבים
אם אתם מבחינים בכך בצינור עיבוד הנתונים שלכם, אתם יכולים להשבית את ההתאמה הנכונה על ידי הסרת אפשרות צינור עיבוד הנתונים --experiments=enable_streaming_rightfitting. בנוסף, פייפליינים זורמים שמופעלת בהם התאמה נכונה באמצעות הצעות למשאבי מאיצים עשויים להשתמש ביותר מאיצים מהרצוי. אם אתם מבחינים בכך בצינור עיבוד הנתונים שלכם, אתם יכולים להגדיר את המספר המקסימלי של מאיצים שבהם צינור עיבוד הנתונים משתמש, על ידי הגדרת אפשרות צינור עיבוד הנתונים --experiments=max_num_accelerators=MAX_NUM_ACCELERATORS.