


Fitur penyesuaian yang tepat menggunakan petunjuk resource Apache Beam untuk menyesuaikan resource worker untuk pipeline. Kemampuan untuk menargetkan beberapa resource yang berbeda ke langkah-langkah pipeline tertentu memberikan fleksibilitas dan kemampuan pipeline tambahan, serta potensi penghematan biaya. Anda dapat menerapkan resource yang lebih mahal ke langkah-langkah pipeline yang memerlukannya, dan resource yang lebih murah ke langkah-langkah pipeline lainnya. Gunakan penyesuaian yang tepat untuk menentukan persyaratan resource untuk seluruh pipeline atau untuk langkah pipeline tertentu.
Dukungan dan batasan
- Petunjuk resource didukung dengan Apache Beam Java dan Python SDK, versi 2.31.0 dan yang lebih baru.
- Penyesuaian yang tepat didukung dengan pipeline batch.
Penyesuaian yang tepat didukung dengan pipeline streaming yang mengaktifkan Penskalaan Otomatis Horizontal.
- Anda dapat mengaktifkannya dengan menetapkan opsi pipeline
--experiments=enable_streaming_rightfitting.
- Anda dapat mengaktifkannya dengan menetapkan opsi pipeline
Saat Anda menggunakan penyesuaian yang tepat, biarkan Penskalaan Otomatis Horizontal tetap aktif. Jika Anda menonaktifkan Penskalaan Otomatis Horizontal, tugas Anda mungkin berjalan dengan paralelisme yang lebih rendah dari yang diharapkan. Untuk membatasi jumlah worker yang digunakan tugas Anda, tetapkan opsi pipeline
maxNumWorkersataumax_num_workers.Penyesuaian yang tepat mendukung Dataflow Prime.
Right fitting tidak mendukung FlexRS.
Saat Anda menggunakan penyesuaian yang tepat, jangan gunakan opsi layanan
worker_accelerator.Saat Anda menggunakan Penskalaan Otomatis Vertikal, Pemilihan VM Otomatis tidak didukung.
Aktifkan penyesuaian yang tepat
Untuk mengaktifkan penyesuaian yang tepat, gunakan satu atau beberapa petunjuk resource yang tersedia di pipeline Anda. Saat Anda menggunakan petunjuk resource di pipeline, penyesuaian yang tepat akan otomatis diaktifkan. Untuk mengetahui informasi selengkapnya, lihat bagian Menggunakan petunjuk resource dalam dokumen ini.
Petunjuk resource yang tersedia
Petunjuk resource berikut tersedia.
| Petunjuk resource | Deskripsi |
|---|---|
min_ram |
Jumlah RAM minimum dalam gigabyte yang akan dialokasikan ke worker. Dataflow menggunakan nilai ini sebagai batas bawah saat mengalokasikan memori ke worker baru (penskalaan horizontal) atau ke worker yang ada (penskalaan vertikal). Contoh: min_ram=RAM_VALUEGB
|
cpu_count |
Jumlah vCPU yang akan dialokasikan per worker. Saat Anda menggunakan petunjuk resource ini, Dataflow akan memilih jenis mesin yang memiliki jumlah vCPU yang ditentukan dan memenuhi persyaratan memori. Contoh: cpu_count=CPU_VALUE
|
accelerator |
Alokasi GPU yang disediakan pengguna yang memungkinkan Anda mengontrol penggunaan dan biaya GPU di pipeline Anda dan langkah-langkahnya. Tentukan jenis dan jumlah GPU yang akan dipasang ke worker Dataflow sebagai parameter untuk flag. Contoh: accelerator="type:GPU_TYPE;count:GPU_COUNT;machine_type:MACHINE_TYPE;CONFIGURATION_OPTIONS"
Untuk mengetahui informasi selengkapnya tentang penggunaan GPU, lihat GPU dengan Dataflow. |
Pemilihan VM Otomatis untuk jenis mesin worker
Saat Anda menggunakan petunjuk resource min_ram atau cpu_count untuk langkah-langkah pipeline yang tidak memerlukan akselerator, Pemilihan VM Otomatis akan diaktifkan secara otomatis.
Dengan Pemilihan VM Otomatis, worker disediakan dari pilihan jenis mesin yang kompatibel yang memenuhi persyaratan pipeline Anda, sehingga memaksimalkan keandalan dan ketersediaan kapasitas.
Untuk mengetahui informasi mendetail tentang cara kerja Pemilihan VM Otomatis, batasannya, dan rekomendasi terkait jenis penyimpanan, lihat Pemilihan VM Otomatis.
Penumpukan petunjuk resource
Petunjuk resource diterapkan ke hierarki transformasi pipeline sebagai berikut:
min_ram: Nilai pada transformasi dievaluasi sebagai nilai petunjukmin_ramterbesar di antara nilai yang ditetapkan pada transformasi itu sendiri dan semua induknya dalam hierarki transformasi.- Contoh: Jika petunjuk transformasi dalam menetapkan
min_ramke 16 GB, dan petunjuk transformasi luar dalam hierarki menetapkanmin_ramke 32 GB, petunjuk 32 GB akan digunakan untuk semua langkah di seluruh transformasi. - Contoh: Jika petunjuk transformasi dalam menetapkan
min_ramke 16 GB, dan petunjuk transformasi luar dalam hierarki menetapkanmin_ramke 8 GB, petunjuk 8 GB akan digunakan untuk semua langkah dalam transformasi luar yang tidak ada dalam transformasi dalam, dan petunjuk 16 GB digunakan untuk semua langkah dalam transformasi dalam.
- Contoh: Jika petunjuk transformasi dalam menetapkan
accelerator: Nilai terdalam dalam hierarki transformasi lebih diutamakan.- Contoh: Jika petunjuk
acceleratortransformasi dalam berbeda dengan petunjukacceleratortransformasi luar dalam hierarki, petunjukacceleratortransformasi dalam akan digunakan untuk transformasi dalam.
- Contoh: Jika petunjuk
Petunjuk yang ditetapkan untuk seluruh pipeline diperlakukan seolah-olah ditetapkan pada transformasi terluar yang terpisah.
Menggunakan petunjuk resource
Anda dapat menetapkan petunjuk resource di seluruh pipeline atau di langkah-langkah pipeline.
Petunjuk resource pipeline
Anda dapat menetapkan petunjuk resource di seluruh pipeline saat menjalankan pipeline dari command line.
gcloud
Untuk menetapkan petunjuk resource saat menjalankan pipeline dengan Template Flex, gunakan flag --additional-pipeline-options dengan perintah gcloud dataflow flex-template run.
Nama opsi pipeline bergantung pada bahasa SDK. Misalnya, untuk petunjuk resource:
- Untuk pipeline Java, gunakan
resourceHints. - Untuk pipeline Python, gunakan
resource_hints.
Contoh berikut menunjukkan cara menetapkan petunjuk resource saat menjalankan pipeline Template Flex Java:
gcloud dataflow flex-template run JOB_NAME \
    --template-file-gcs-location="gs://TEMPLATE_LOCATION" \
    --region="REGION" \
    --additional-pipeline-options=resourceHints=min_ram=RAM_VALUEGB \
    --additional-pipeline-options=resourceHints=cpu_count=CPU_VALUE \
    --parameters ...
Contoh berikut menunjukkan cara menetapkan petunjuk resource saat menjalankan pipeline Template Flex Python:
gcloud dataflow flex-template run JOB_NAME \
    --template-file-gcs-location="gs://TEMPLATE_LOCATION" \
    --region="REGION" \
    --additional-pipeline-options=resource_hints=min_ram=RAM_VALUEGB \
    --additional-pipeline-options=resource_hints=cpu_count=CPU_VALUE \
    --parameters ...
Java
Untuk menyiapkan lingkungan Java, lihat Membuat pipeline Dataflow menggunakan Java.
Contoh berikut menunjukkan cara menetapkan petunjuk resource saat menjalankan pipeline Java:
mvn -Pdataflow-runner compile exec:java \
    -Dexec.mainClass=com.example.MyPipeline \
    -Dexec.args="--runner=DataflowRunner \
    --resourceHints=min_ram=RAM_VALUEGB \
    --resourceHints=cpu_count=CPU_VALUE \
    ..."
Python
Untuk menyiapkan lingkungan Python, lihat tutorial Python.
Contoh berikut menunjukkan cara menetapkan petunjuk resource saat menjalankan pipeline Python:
python my_pipeline.py \
    --runner=DataflowRunner \
    --resource_hints=min_ram=RAM_VALUEGB \
    --resource_hints=cpu_count=CPU_VALUE \
    ...
Petunjuk resource langkah pipeline
Anda dapat menetapkan petunjuk resource pada langkah-langkah pipeline (transformasi) secara terprogram.
Java
Untuk menginstal Apache Beam SDK untuk Java, lihat Menginstal Apache Beam SDK.
Anda dapat menetapkan petunjuk resource secara terprogram pada transformasi pipeline menggunakan
class ResourceHints.
Contoh berikut menunjukkan cara menetapkan petunjuk resource secara terprogram pada transformasi pipeline.
pcoll.apply(MyCompositeTransform.of(...)
    .setResourceHints(
        ResourceHints.create()
            .withMinRam("15GB")
            .withCpuCount(8)
            .withAccelerator(
    "type:nvidia-l4;count:1;install-nvidia-driver")))

pcoll.apply(ParDo.of(new BigMemFn())
    .setResourceHints(
        ResourceHints.create()
          .withMinRam("30GB")
          .withCpuCount(16)))
Untuk menetapkan petunjuk resource secara terprogram di seluruh pipeline, gunakan
antarmuka ResourceHintsOptions.
Python
Untuk menginstal Apache Beam SDK untuk Python, lihat Menginstal Apache Beam SDK.
Anda dapat menetapkan petunjuk resource secara terprogram pada transformasi pipeline menggunakan
class PTransforms.with_resource_hints.
Untuk mengetahui informasi selengkapnya, lihat
class ResourceHint.
Contoh berikut menunjukkan cara menetapkan petunjuk resource secara terprogram pada transformasi pipeline.
pcoll | MyPTransform().with_resource_hints(
    min_ram="4GB",
    cpu_count=8,
    accelerator="type:nvidia-tesla-l4;count:1;install-nvidia-driver")

pcoll | beam.ParDo(BigMemFn()).with_resource_hints(
    min_ram="30GB",
    cpu_count=16)
Untuk menetapkan petunjuk resource di seluruh pipeline, gunakan opsi pipeline --resource_hints saat Anda menjalankan pipeline. Sebagai contoh, lihat
Petunjuk resource pipeline.
Go
Petunjuk resource tidak didukung di Go.
Dukungan beberapa akselerator
Dalam pipeline, transformasi yang berbeda dapat memiliki konfigurasi akselerator yang berbeda. Hal ini mencakup konfigurasi yang memerlukan jenis mesin yang berbeda. Konfigurasi akselerator tingkat transformasi ini lebih diprioritaskan daripada konfigurasi tingkat pipeline jika disediakan.
Penyesuaian dan penggabungan yang tepat
Dalam beberapa kasus, transformasi yang ditetapkan dengan petunjuk resource yang berbeda dapat dijalankan pada worker di worker pool yang sama, sebagai bagian dari proses pengoptimalan fusi. Saat transformasi digabungkan, Dataflow akan menjalankannya di lingkungan yang memenuhi gabungan petunjuk resource yang ditetapkan pada transformasi. Dalam beberapa kasus, hal ini mencakup seluruh pipeline.
Jika petunjuk resource tidak dapat digabungkan, penggabungan tidak akan terjadi. Misalnya, petunjuk resource untuk GPU yang berbeda tidak dapat digabungkan, sehingga transformasi tersebut tidak digabungkan.
Anda juga dapat mencegah penggabungan dengan menambahkan operasi ke pipeline yang memaksa Dataflow untuk mewujudkan PCollection perantara. Hal ini sangat berguna saat mencoba mengisolasi resource yang mahal seperti GPU atau mesin dengan memori tinggi dari langkah-langkah yang lambat atau mahal secara komputasi yang tidak memerlukan resource khusus tersebut. Dalam kasus tersebut, sebaiknya paksa pemutusan fusi antara langkah-langkah yang terikat CPU yang lambat dan langkah-langkah yang memerlukan GPU mahal atau mesin dengan memori tinggi, serta bayar biaya materialisasi yang terkait dengan pemutusan fusi. Untuk mempelajari lebih lanjut, lihat
Mencegah penggabungan.
Penyesuaian yang tepat untuk streaming
Untuk tugas streaming, Anda dapat mengaktifkan penyesuaian yang tepat dengan menetapkan opsi pipeline --experiments=enable_streaming_rightfitting.
Penyesuaian yang tepat dapat meningkatkan performa pipeline Anda jika melibatkan tahap dengan persyaratan resource yang berbeda.
Contoh: Pipeline dengan tahap intensif CPU dan tahap yang memerlukan GPU
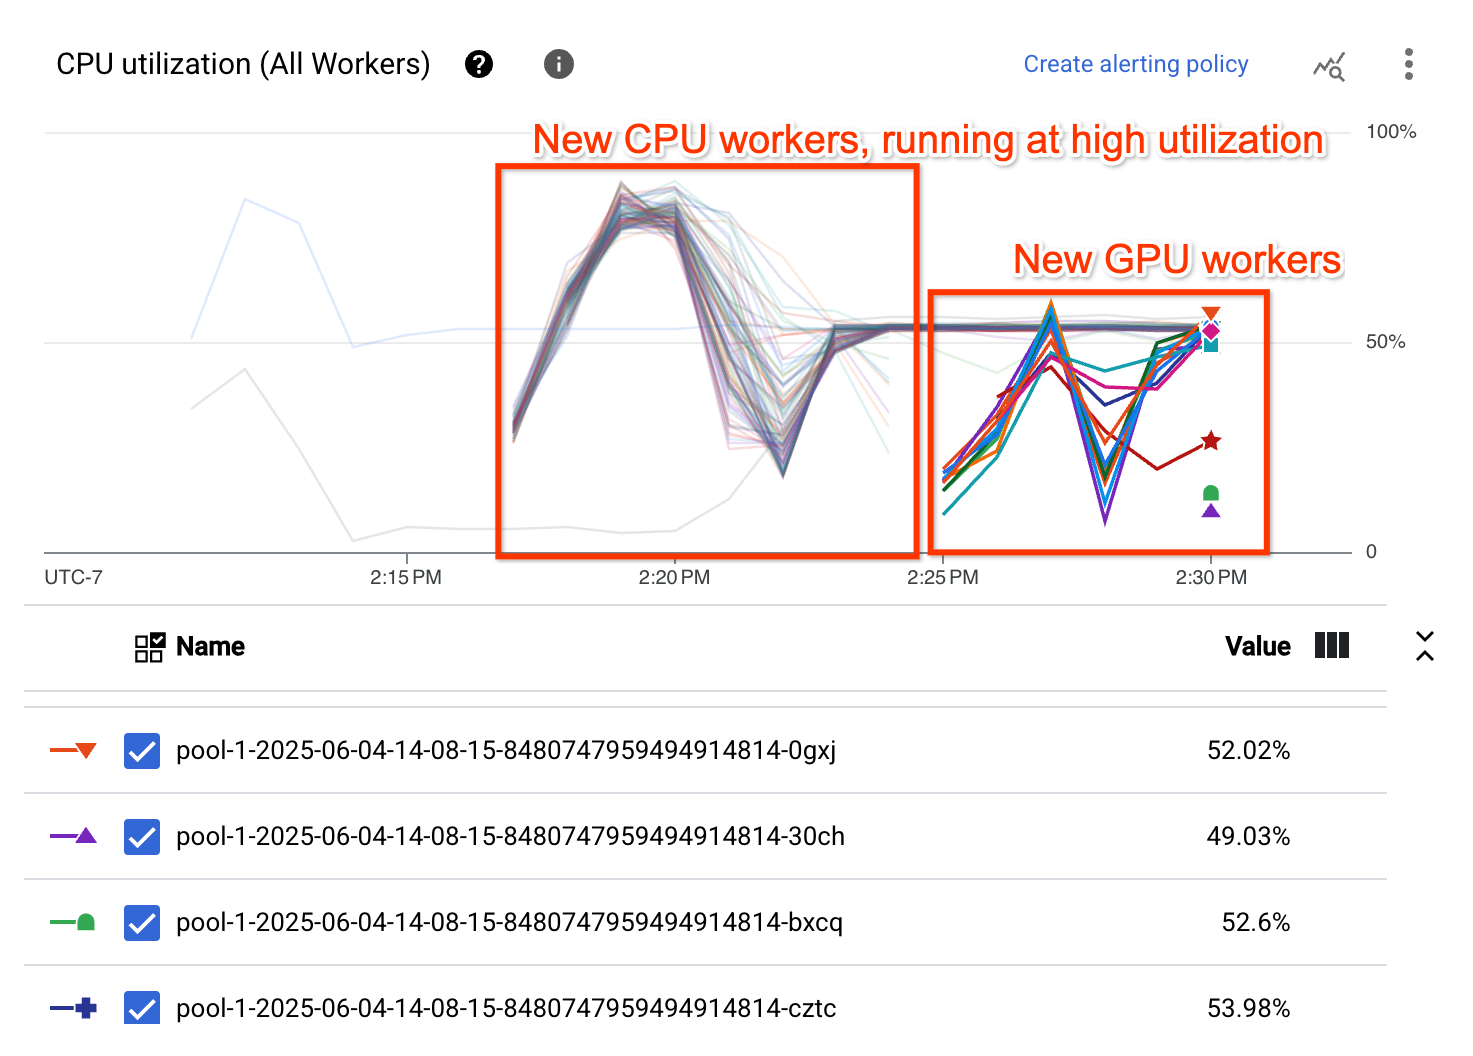
Contoh pipeline yang dapat memanfaatkan penyesuaian yang tepat adalah pipeline yang menjalankan tahap yang memerlukan banyak CPU, diikuti dengan tahap yang memerlukan GPU. Tanpa penyesuaian yang tepat, satu worker pool GPU perlu dikonfigurasi untuk menjalankan semua tahap pipeline, termasuk tahap yang menggunakan banyak CPU. Hal ini dapat menyebabkan kurangnya pemanfaatan resource GPU saat worker pool menjalankan tahap yang memerlukan banyak CPU.
Jika penyesuaian yang tepat diaktifkan dan Petunjuk Resource diterapkan ke langkah yang memerlukan GPU, pipeline akan membuat dua pool terpisah, sehingga tahap yang memerlukan banyak CPU akan dieksekusi oleh pool worker CPU, dan tahap yang memerlukan GPU akan dieksekusi oleh pool worker GPU.
Untuk contoh pipeline ini, tabel penskalaan otomatis menunjukkan bahwa pool worker yang menjalankan tahap intensif CPU, Pool 0, awalnya ditingkatkan skalanya menjadi 99 worker, dan kemudian diturunkan skalanya menjadi 87 worker. Worker pool yang menjalankan tahap yang memerlukan GPU, Pool 1, ditingkatkan skalanya menjadi 13 worker:

Grafik CPU Utilization menunjukkan bahwa worker di kedua worker pool menunjukkan pemakaian CPU yang tinggi secara keseluruhan:
Memecahkan masalah penyesuaian yang tepat
Bagian ini memberikan petunjuk untuk memecahkan masalah umum terkait penyesuaian yang tepat.
Konfigurasi tidak valid
Saat Anda mencoba menggunakan penyesuaian yang tepat, error berikut akan terjadi:
Workflow failed. Causes: One or more operations had an error: 'operation-OPERATION_ID':
[UNSUPPORTED_OPERATION] 'CPU_VALUE vCpus with RAM_VALUE MiB memory is
an invalid configuration for GPU_COUNT count of 'GPU_TYPE' in family 'MACHINE_TYPE'.'.
Error ini terjadi jika jenis GPU yang dipilih tidak kompatibel dengan jenis mesin yang dipilih. Untuk mengatasi error ini, pilih jenis GPU dan jenis mesin yang kompatibel. Untuk mengetahui detail kompatibilitas, lihat platform GPU.
Memverifikasi penyesuaian yang tepat
Anda dapat memverifikasi bahwa penyesuaian yang tepat diaktifkan dengan melihat metrik penskalaan otomatis dan memverifikasi bahwa kolom Worker pool terlihat dan mencantumkan pool yang berbeda:

Performa penyesuaian yang tepat untuk streaming
Pipeline streaming dengan penyesuaian yang tepat diaktifkan mungkin tidak selalu berperforma lebih baik daripada pipeline tanpa penyesuaian yang tepat diaktifkan. Contoh:
- Pipeline menggunakan lebih banyak worker
- Latensi sistem lebih tinggi, atau throughput lebih rendah
- Ukuran kumpulan worker lebih sering berubah, atau tidak stabil
Jika Anda mengamati hal ini untuk pipeline, Anda dapat menonaktifkan penyesuaian yang tepat dengan menghapus opsi pipeline --experiments=enable_streaming_rightfitting. Selain itu, pipeline streaming dengan penyesuaian yang tepat yang diaktifkan menggunakan Petunjuk Resource akselerator mungkin menggunakan lebih banyak akselerator daripada yang diinginkan. Jika Anda mengamati hal ini untuk pipeline, Anda dapat mengonfigurasi jumlah maksimum akselerator yang digunakan oleh pipeline dengan menetapkan opsi pipeline --experiments=max_num_accelerators=MAX_NUM_ACCELERATORS.