


Informazioni su letture e scritture su larga scala
Leggi questo documento per prendere decisioni informate sulla progettazione dell'architettura delle tue applicazioni per garantire prestazioni e affidabilità elevate. Questo documento include argomenti avanzati di Firestore. Se hai appena iniziato a utilizzare Firestore, consulta la guida rapida.
Firestore è un database flessibile e scalabile per lo sviluppo di dispositivi mobili, web e server di Firebase e Google Cloud. Iniziare a utilizzare Firestore e scrivere applicazioni complete e potenti è molto semplice.
Per assicurarti che le tue applicazioni continuino a funzionare bene man mano che le dimensioni e il traffico del database aumentano, è utile comprendere i meccanismi di lettura e scrittura nel backend di Firestore. Devi anche comprendere l'interazione delle letture e delle scritture con il livello di archiviazione e i vincoli sottostanti che potrebbero influire sulle prestazioni.
Consulta le sezioni seguenti per le best practice prima di progettare l'architettura della tua applicazione.
Comprendere i componenti di alto livello
Il seguente diagramma mostra i componenti di alto livello coinvolti in una richiesta API Firestore.

SDK e librerie client di Firestore
Firestore supporta SDK e librerie client per diverse piattaforme. Sebbene un'app possa effettuare chiamate HTTP e RPC dirette all'API Firestore, le librerie client forniscono un livello di astrazione per semplificare l'utilizzo dell'API e implementare le best practice. Inoltre, possono fornire funzionalità aggiuntive come l'accesso offline, le cache e così via.
Google Front End (GFE)
Si tratta di un servizio di infrastruttura comune a tutti i servizi Google Cloud. Il GFE accetta le richieste in entrata e le inoltra al servizio Google pertinente (il servizio Firestore in questo contesto). Inoltre, fornisce altre funzionalità importanti, tra cui la protezione dagli attacchi Denial of Service.
Servizio Firestore
Il servizio Firestore esegue controlli sulla richiesta API, tra cui autenticazione, autorizzazione, controlli delle quote e regole di sicurezza, e gestisce anche le transazioni. Questo servizio Firestore include un client di archiviazione che interagisce con il livello di archiviazione per le letture e le scritture dei dati.
Livello di archiviazione di Firestore
Il livello di archiviazione di Firestore è responsabile dell'archiviazione dei dati e dei metadati, nonché delle funzionalità del database associate fornite da Firestore. Le sezioni seguenti descrivono come sono organizzati i dati nel livello di archiviazione di Firestore e come viene scalato il sistema. Scoprire come sono organizzati i dati può aiutarti a progettare un modello dei dati scalabile e a comprendere meglio le best practice di Firestore.
Intervalli e suddivisioni delle chiavi
Firestore è un database NoSQL orientato ai documenti. I dati vengono archiviati in documenti, organizzati in gerarchie di raccolte. La gerarchia delle raccolte e l'ID documento vengono tradotti in una singola chiave per ogni documento. I documenti vengono archiviati logicamente e ordinati lessicograficamente in base a questa singola chiave. Utilizziamo il termine intervallo di chiavi per fare riferimento a un intervallo di chiavi lessicograficamente contiguo.
Un tipico database Firestore è troppo grande per essere contenuto in una singola macchina fisica. Esistono anche scenari in cui il carico di lavoro sui dati è troppo elevato per essere gestito da una singola macchina. Per gestire workload di grandi dimensioni, Firestore suddivide i dati in parti separate che possono essere archiviate e gestite da più macchine o server di archiviazione. Queste partizioni vengono create nelle tabelle del database in blocchi di intervalli di chiavi chiamati suddivisioni.
Replica sincrona
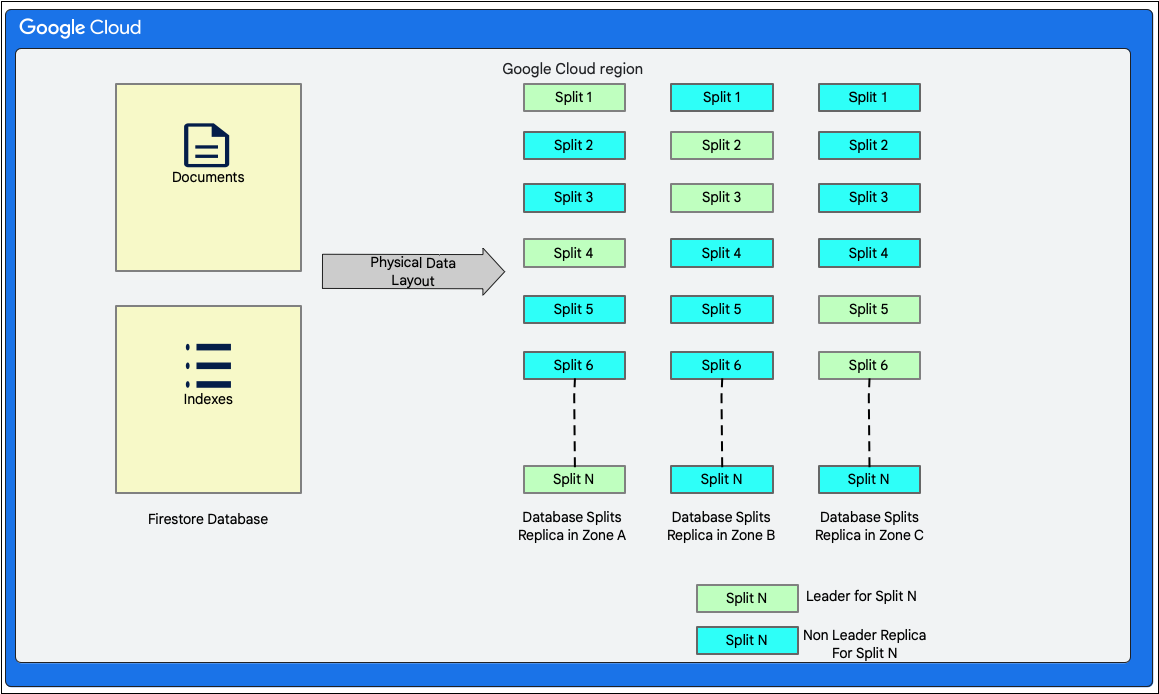
È importante notare che il database viene sempre replicato automaticamente e in modo sincrono. Le suddivisioni dei dati hanno repliche in zone diverse per mantenerle disponibili anche quando una zona diventa inaccessibile. La replica coerente nelle diverse copie della suddivisione è gestita dall'algoritmo Paxos per il consenso. Una replica di ogni suddivisione viene scelta per agire come leader Paxos, responsabile della gestione delle scritture in quella suddivisione. La replica sincrona ti consente di leggere sempre l'ultima versione dei dati da Firestore.
Il risultato complessivo è un sistema scalabile e ad alta affidabilità che offre basse latenze sia per le letture che per le scritture, indipendentemente dai workload pesanti e su larga scala.
Layout dei dati
Firestore è un database di documenti senza schema. Tuttavia, internamente i dati vengono disposti principalmente in due tabelle di tipo database relazionale nel livello di archiviazione, come segue:
- Tabella Documents: i documenti vengono archiviati in questa tabella.
- Tabella Indexes: in questa tabella sono memorizzate le voci dell'indice che consentono di ottenere risultati in modo efficiente e ordinati per valore dell'indice.
Il seguente diagramma mostra l'aspetto delle tabelle di un database Firestore con le suddivisioni. Le suddivisioni vengono replicate in tre zone diverse e a ogni suddivisione viene assegnato un leader Paxos.
Regione singola e multiregionale
Quando crei un database, devi selezionare una regione o una multiregione.
Una singola località regionale è una posizione geografica specifica, ad esempio us-west1. Le suddivisioni dei dati di un database Firestore hanno repliche in zone diverse all'interno della regione selezionata, come spiegato in precedenza.
Una località multiregionale è costituita da un insieme definito di regioni in cui sono archiviate le repliche del database. In un deployment multiregionale di Firestore, due delle regioni hanno repliche complete di tutti i dati nel database. Una terza regione ha una replica di controllo che non mantiene un set di dati completo, ma partecipa alla replica. Replicando i dati tra più regioni, i dati sono disponibili per la scrittura e la lettura anche in caso di perdita di un'intera regione.
Per saperne di più sulle località di una regione, consulta Località di Firestore.

Comprendi il ciclo di vita di una scrittura in Firestore
Un client Firestore può scrivere dati creando, aggiornando o eliminando un singolo documento. Una scrittura in un singolo documento richiede l'aggiornamento atomico sia del documento sia delle voci dell'indice associate nel livello di archiviazione. Firestore supporta anche operazioni atomiche costituite da più letture e/o scritture in uno o più documenti.
Per tutti i tipi di scrittura, Firestore fornisce le proprietà ACID (atomicità, coerenza, isolamento e durabilità) dei database relazionali. Firestore fornisce anche la serializzabilità, il che significa che tutte le transazioni vengono visualizzate come se fossero eseguite in un ordine seriale.
Passaggi di alto livello in una transazione di scrittura
Quando il client Firestore esegue una scrittura o un commit di una transazione, utilizzando uno dei metodi menzionati in precedenza, questa viene eseguita internamente come transazione di lettura/scrittura del database nel livello di archiviazione. La transazione consente a Firestore di fornire le proprietà ACID menzionate in precedenza.
Come primo passaggio di una transazione, Firestore legge il documento esistente e determina le mutazioni da apportare ai dati nella tabella Documenti.
Ciò include anche l'esecuzione degli aggiornamenti necessari alla tabella Indexes come segue:
- I campi che vengono aggiunti ai documenti devono avere inserimenti corrispondenti nella tabella Indexes.
- I campi che vengono rimossi dai documenti devono essere eliminati anche dalla tabella Indexes.
- I campi che vengono modificati nei documenti richiedono sia eliminazioni (per i valori precedenti) sia inserimenti (per i nuovi valori) nella tabella Indexes.
Per calcolare le mutazioni menzionate in precedenza, Firestore legge la configurazione di indicizzazione del database. La configurazione dell'indicizzazione memorizza le informazioni sugli indici di un database. Firestore utilizza due tipi di indici: a campo singolo e compositi. Per una comprensione dettagliata degli indici creati in Firestore, consulta Tipi di indice in Firestore.
Una volta calcolate le mutazioni, Firestore le raccoglie all'interno di una transazione e poi ne esegue il commit.
Comprendi una transazione di scrittura nel livello di archiviazione
Come spiegato in precedenza, una scrittura in Firestore comporta una transazione di lettura/scrittura nel livello di archiviazione. A seconda del layout dei dati, una scrittura potrebbe comportare una o più suddivisioni, come mostrato nel layout dei dati.
Nel diagramma seguente, il database Firestore ha otto suddivisioni (contrassegnate da 1 a 8) ospitate su tre diversi server di archiviazione in una singola zona e ogni suddivisione è replicata in 3 (o più) zone diverse. Ogni divisione ha un leader Paxos, che potrebbe trovarsi in una zona diversa per divisioni diverse.

Considera un database Firestore con la raccolta Restaurants come segue:

Il client Firestore richiede la seguente modifica a un documento nella raccolta Restaurant aggiornando il valore del campo priceCategory.

I seguenti passaggi di alto livello descrivono cosa succede durante la scrittura:
- Crea una transazione di lettura/scrittura.
- Leggi il documento
restaurant1nella raccoltaRestaurantsdalla tabella Documenti dal livello di archiviazione. - Leggi gli indici del documento dalla tabella Indexes.
- Calcola le mutazioni da apportare ai dati. In questo caso, sono presenti cinque mutazioni:
- M1: aggiorna la riga per
restaurant1nella tabella Documenti per riflettere la modifica del valore del campopriceCategory. - M2 e M3: elimina le righe per il valore precedente di
priceCategorynella tabella Indexes per gli indici decrescenti e crescenti. - M4 e M5: inserisci le righe per il nuovo valore di
priceCategorynella tabella Indexes per gli indici decrescenti e crescenti.
- M1: aggiorna la riga per
- Esegui il commit di queste mutazioni.
Il client di archiviazione nel servizio Firestore cerca al volo le suddivisioni che possiedono le chiavi delle righe da modificare. Prendiamo in considerazione un caso in cui la suddivisione 3 gestisce M1 e la suddivisione 6 gestisce M2-M5. Esiste una transazione distribuita che coinvolge tutte queste suddivisioni come partecipanti. Le suddivisioni dei partecipanti possono includere anche qualsiasi altra suddivisione da cui i dati sono stati letti in precedenza nell'ambito della transazione di lettura/scrittura.
I seguenti passaggi descrivono cosa succede durante il commit:
- Il client di archiviazione esegue un commit. Il commit contiene le mutazioni M1-M5.
- Le suddivisioni 3 e 6 sono i partecipanti a questa transazione. Uno dei partecipanti viene scelto come coordinatore, ad esempio Split 3. Il compito del coordinatore è garantire che il commit o l'interruzione della transazione avvenga in modo atomico per tutti i partecipanti.
- Le repliche leader di queste suddivisioni sono responsabili del lavoro svolto dai partecipanti e dai coordinatori.
- Ogni partecipante e coordinatore esegue un algoritmo Paxos con le rispettive repliche.
- Il leader esegue un algoritmo Paxos con le repliche. Il quorum viene raggiunto se la maggior parte delle repliche risponde con una risposta
ok to commital leader. - Ogni partecipante comunica quindi al coordinatore quando è pronto (prima fase del commit in due fasi). Se un partecipante non può eseguire il commit della transazione, l'intera transazione
aborts.
- Il leader esegue un algoritmo Paxos con le repliche. Il quorum viene raggiunto se la maggior parte delle repliche risponde con una risposta
- Una volta che il coordinatore sa che tutti i partecipanti, incluso se stesso, sono pronti, comunica il risultato della transazione
accepta tutti i partecipanti (seconda fase del commit in due fasi). In questa fase, ogni partecipante registra la decisione di commit nello spazio di archiviazione stabile e viene eseguito il commit della transazione. - Il coordinatore risponde al client di archiviazione in Firestore che è stato eseguito il commit della transazione. In parallelo, il coordinatore e tutti i partecipanti applicano le mutazioni ai dati.

Quando il database Firestore è di piccole dimensioni, può accadere che una singola suddivisione possieda tutte le chiavi nelle mutazioni M1-M5. In questo caso, la transazione ha un solo partecipante e il commit in due fasi menzionato in precedenza non è necessario, il che velocizza le scritture.
Scritture multiregione
In un deployment multiregionale, la distribuzione delle repliche tra le regioni aumenta la disponibilità, ma comporta un costo in termini di prestazioni. La comunicazione tra repliche in regioni diverse richiede tempi di round trip più lunghi. Pertanto, la latenza di base per le operazioni di Firestore è leggermente superiore rispetto ai deployment in una singola regione.
Configuriamo le repliche in modo che la leadership per le suddivisioni rimanga sempre nella regione principale. La regione principale è quella da cui proviene il traffico in entrata verso il server Firestore. Questa decisione di leadership riduce il ritardo di andata e ritorno nella comunicazione tra il client di archiviazione in Firestore e il leader della replica (o il coordinatore per le transazioni con più suddivisioni).
Ogni scrittura in Firestore comporta anche un'interazione con il motore in tempo reale di Firestore. Per saperne di più sulle query in tempo reale, consulta Informazioni sulle query in tempo reale su larga scala.
Comprendi il ciclo di vita di una lettura in Firestore
Questa sezione approfondisce le letture autonome non in tempo reale in Firestore. Internamente, il server Firestore gestisce la maggior parte di queste query in due fasi principali:
- Una singola scansione dell'intervallo nella tabella Indexes
- Ricerche puntuali nella tabella Documenti in base al risultato della scansione precedente
Le letture dei dati dal livello di archiviazione vengono eseguite internamente utilizzando una transazione di database per garantire letture coerenti. Tuttavia, a differenza delle transazioni utilizzate per le scritture, queste transazioni non acquisiscono blocchi. Invece, funzionano scegliendo un timestamp, quindi eseguendo tutte le letture in quel timestamp. Poiché non acquisiscono blocchi, non bloccano le transazioni di lettura/scrittura simultanee. Per eseguire questa transazione, il client di archiviazione in Firestore specifica un limite di timestamp, che indica al livello di archiviazione come scegliere un timestamp di lettura. Il tipo di timestamp bound scelto dal client di archiviazione in Firestore è determinato dalle opzioni di lettura per la richiesta di lettura.
Comprendi una transazione di lettura nel livello di archiviazione
Questa sezione descrive i tipi di letture e il modo in cui vengono elaborate nel livello di archiviazione di Firestore.
Letture forti
Per impostazione predefinita, le letture di Firestore sono a elevata coerenza. Questa elevata coerenza significa che una lettura di Firestore restituisce l'ultima versione dei dati che riflette tutte le scritture di cui è stato eseguito il commit fino all'inizio della lettura.
Lettura suddivisione singola
Il client di archiviazione in Firestore cerca al volo le suddivisioni che possiedono le chiavi delle righe da leggere. Supponiamo che debba eseguire una lettura dalla divisione 3 della sezione precedente. Il client invia la richiesta di lettura alla replica più vicina per ridurre la latenza di round trip.
A questo punto, potrebbero verificarsi i seguenti casi a seconda della replica scelta:
- La richiesta di lettura viene inviata a una replica leader (zona A).
- Poiché il leader è sempre aggiornato, la lettura può procedere direttamente.
- La richiesta di lettura viene inviata a una replica non leader (ad esempio, la zona B)
- La suddivisione 3 potrebbe sapere, in base al suo stato interno, di avere informazioni sufficienti per gestire la lettura e lo fa.
- La suddivisione 3 non è sicura di aver visto i dati più recenti. Invia un messaggio al leader per richiedere il timestamp dell'ultima transazione che deve applicare per gestire la lettura. Una volta applicata la transazione, la lettura può procedere.
Firestore restituisce quindi la risposta al client.
Lettura con suddivisione multipla
Nel caso in cui le letture debbano essere eseguite da più suddivisioni, lo stesso meccanismo si verifica in tutte le suddivisioni. Una volta che i dati sono stati restituiti da tutte le suddivisioni, il client di archiviazione in Firestore combina i risultati. Firestore risponde quindi al client con questi dati.
Letture di dati obsoleti
Le letture con coerenza elevata sono la modalità predefinita in Firestore. Tuttavia, ciò comporta un potenziale aumento della latenza a causa della comunicazione che potrebbe essere richiesta con il leader. Spesso l'applicazione Firestore non ha bisogno di leggere l'ultima versione dei dati e la funzionalità funziona bene con dati che potrebbero essere obsoleti di qualche secondo.
In questo caso, il client può scegliere di ricevere letture di dati obsoleti utilizzando le opzioni di lettura read_time. In questo caso, le letture vengono eseguite come se i dati fossero al momento read_time e la replica più vicina ha un'alta probabilità di aver già verificato di avere dati al momento read_time specificato.
Per prestazioni notevolmente migliori, 15 secondi è un valore di inattività ragionevole. Anche per le letture di dati obsoleti, le righe restituite sono coerenti tra loro.
Evita gli hotspot
Le suddivisioni in Firestore vengono suddivise automaticamente in parti più piccole per distribuire il lavoro di gestione del traffico a più server di archiviazione quando necessario o quando lo spazio delle chiavi si espande. Le suddivisioni create per gestire il traffico in eccesso vengono conservate per circa 24 ore anche se il traffico scompare. Pertanto, se si verificano picchi di traffico ricorrenti, le suddivisioni vengono mantenute e ne vengono introdotte altre ogni volta che è necessario. Questi meccanismi aiutano i database Firestore a scalare automaticamente in base all'aumento del carico di traffico o delle dimensioni del database. Tuttavia, esistono alcune limitazioni di cui tenere conto, come spiegato di seguito.
La suddivisione dello spazio di archiviazione e del carico non è istantanea e un aumento troppo rapido del traffico potrebbe causare una latenza elevata o errori di superamento della scadenza, comunemente definiti hotspot, mentre il servizio si adatta. Dopo alcuni minuti di carico sostenuto, Firestore introduce confini della suddivisione tra le chiavi per distribuire il traffico su più server di archiviazione. Se distribuisci le operazioni in modo uniforme nell'intervallo di chiavi e segui le best practice per la progettazione di chiavi e indici, il throughput di scrittura può raddoppiare ogni pochi minuti e il throughput di lettura migliora ogni pochi minuti man mano che vengono aggiunte le suddivisioni.
Sebbene le suddivisioni vengano create automaticamente con l'aumento del carico, Firestore può suddividere un intervallo di chiavi solo fino a quando non gestisce un singolo documento utilizzando un insieme dedicato di server di archiviazione replicati. Di conseguenza, volumi elevati e costanti di operazioni simultanee su un singolo documento possono causare un hotspot su quel documento. Se riscontri latenze elevate prolungate su un singolo documento, ti consigliamo di modificare il modello di dati per suddividere o replicare i dati in più documenti.
Gli errori di conflitto si verificano quando più operazioni tentano di leggere e/o scrivere lo stesso documento contemporaneamente.
Un altro caso speciale di hotspotting si verifica quando una chiave sequenziale crescente/decrescente viene utilizzata come ID documento in Firestore e il numero di operazioni al secondo è notevolmente elevato. La creazione di più suddivisioni non è utile in questo caso, poiché l'ondata di traffico si sposta semplicemente nella suddivisione appena creata. Poiché Firestore indicizza automaticamente tutti i campi del documento per impostazione predefinita, questi hotspot in movimento potrebbero essere creati anche nello spazio dell'indice per un campo del documento che contiene un valore che aumenta/diminuisce in sequenza, ad esempio un timestamp.
Tieni presente che, seguendo le pratiche descritte sopra, Firestore può scalare per gestire workload di dimensioni arbitrarie senza che tu debba modificare alcuna configurazione.
Risoluzione dei problemi
Firestore fornisce Key Visualizer come strumento di diagnostica progettato per analizzare i pattern di utilizzo e risolvere i problemi di hotspotting.
Passaggi successivi
- Scopri altre best practice
- Scopri di più sulle query in tempo reale su larga scala