


Un set di contesti è una raccolta di indicazioni che aiutano strumenti come QueryData a generare query GQL (Graph Query Language) accurate per il grafo delle proprietà nel database Spanner. QueryData legge lo schema del grafico delle proprietà direttamente dal database. Un set di contesto aggiunge ciò che lo schema non acquisisce: il significato dei termini della tua attività, le query verificate per le domande che gli utenti pongono spesso e il modo in cui gli utenti fanno riferimento ai valori archiviati nel tuo grafo. Non è necessario ridefinire lo schema del grafo in un set di contesti.
I seguenti database sono supportati da QueryData:
- AlloyDB per PostgreSQL
- Cloud SQL per MySQL
- Cloud SQL per PostgreSQL
- Spanner (incluso Spanner Graph)
- Firestore con compatibilità MongoDB
Per utilizzare i set di contesto con le tabelle Spanner relazionali anziché con Spanner Graph, consulta la panoramica dei set di contesto per Spanner.
Il contesto viene definito in un file JSON che contiene tre tipi di oggetti: modelli di query, aspetti delle query e ricerche di valori. Puoi creare questo file con l'aiuto dell'agente di progettazione del contesto e poi caricarlo in un set di contesti che crei in Spanner Studio. QueryData utilizza il set di contesti quando una richiesta QueryData vi fa riferimento nel campo agent_context_reference.context_set_id.
Puoi creare set di contesti nelle regioni us-central1, us-east1, europe-west4 e asia-southeast1. La regione di un set di contesto non deve necessariamente corrispondere alla località che utilizzi nelle richieste QueryData, ad esempio locations/global.
Gli esempi in questo documento utilizzano lo schema del grafo delle proprietà FinGraph (nodi Person e Account collegati da archi Owns e Transfers). Per configurare il grafico delle proprietà FinGraph nel database Spanner e inserire dati di esempio, consulta Configura ed esegui query su Spanner Graph.
Come QueryData utilizza un set di contesti
Un set di contesti può contenere tre tipi di contesto. Ogni tipo risolve un problema diverso e QueryData può utilizzarli in modo indipendente o congiunto:
| Tipo di contesto | Cosa fornisci | Quando utilizzarla | Come viene utilizzato da QueryData | Esempio di FinGraph |
|---|---|---|---|---|
| Modello di query | Una query GQL completa e verificata per un tipo di domanda, con segnaposto ? per i valori che cambiano. |
Gli utenti pongono la stessa domanda ripetutamente con valori parametro diversi, soprattutto quando la query è complessa da generare (ad esempio un pattern di percorso multi-hop). | Riutilizza direttamente la query sql per una corrispondenza esatta o sostituisce i parametri in parameterized_sql quando la domanda corrisponde al modello. |
"Il denaro inviato dal conto 7 è stato restituito entro 60 giorni?" |
| Query facet | Una clausola GQL riutilizzabile, come un pattern MATCH o una condizione WHERE, che definisce un termine o una condizione aziendale. |
Una condizione o un pattern riutilizzabile viene visualizzato in molte domande diverse. | Incorpora la clausola GQL definita durante la generazione di una nuova query GQL. | Un trasferimento ad alto rischio è un trasferimento di almeno 200 a un account bloccato. |
| Ricerca di valore | Una query che trova i valori delle proprietà archiviati che corrispondono a una frase di valore nella domanda dell'utente. | Gli utenti fanno riferimento ai valori utilizzando nomi o ortografie diversi da quelli memorizzati nel grafico. | Esegue la query di ricerca con la frase del valore prima di generare la query GQL, quindi filtra in base al valore e alla proprietà archiviati risolti. | "giorno di pioggia" si riferisce a Rainy Day Fund in Account.nick_name. |
Il seguente diagramma mostra come QueryData elabora una domanda utilizzando un set di contesti:
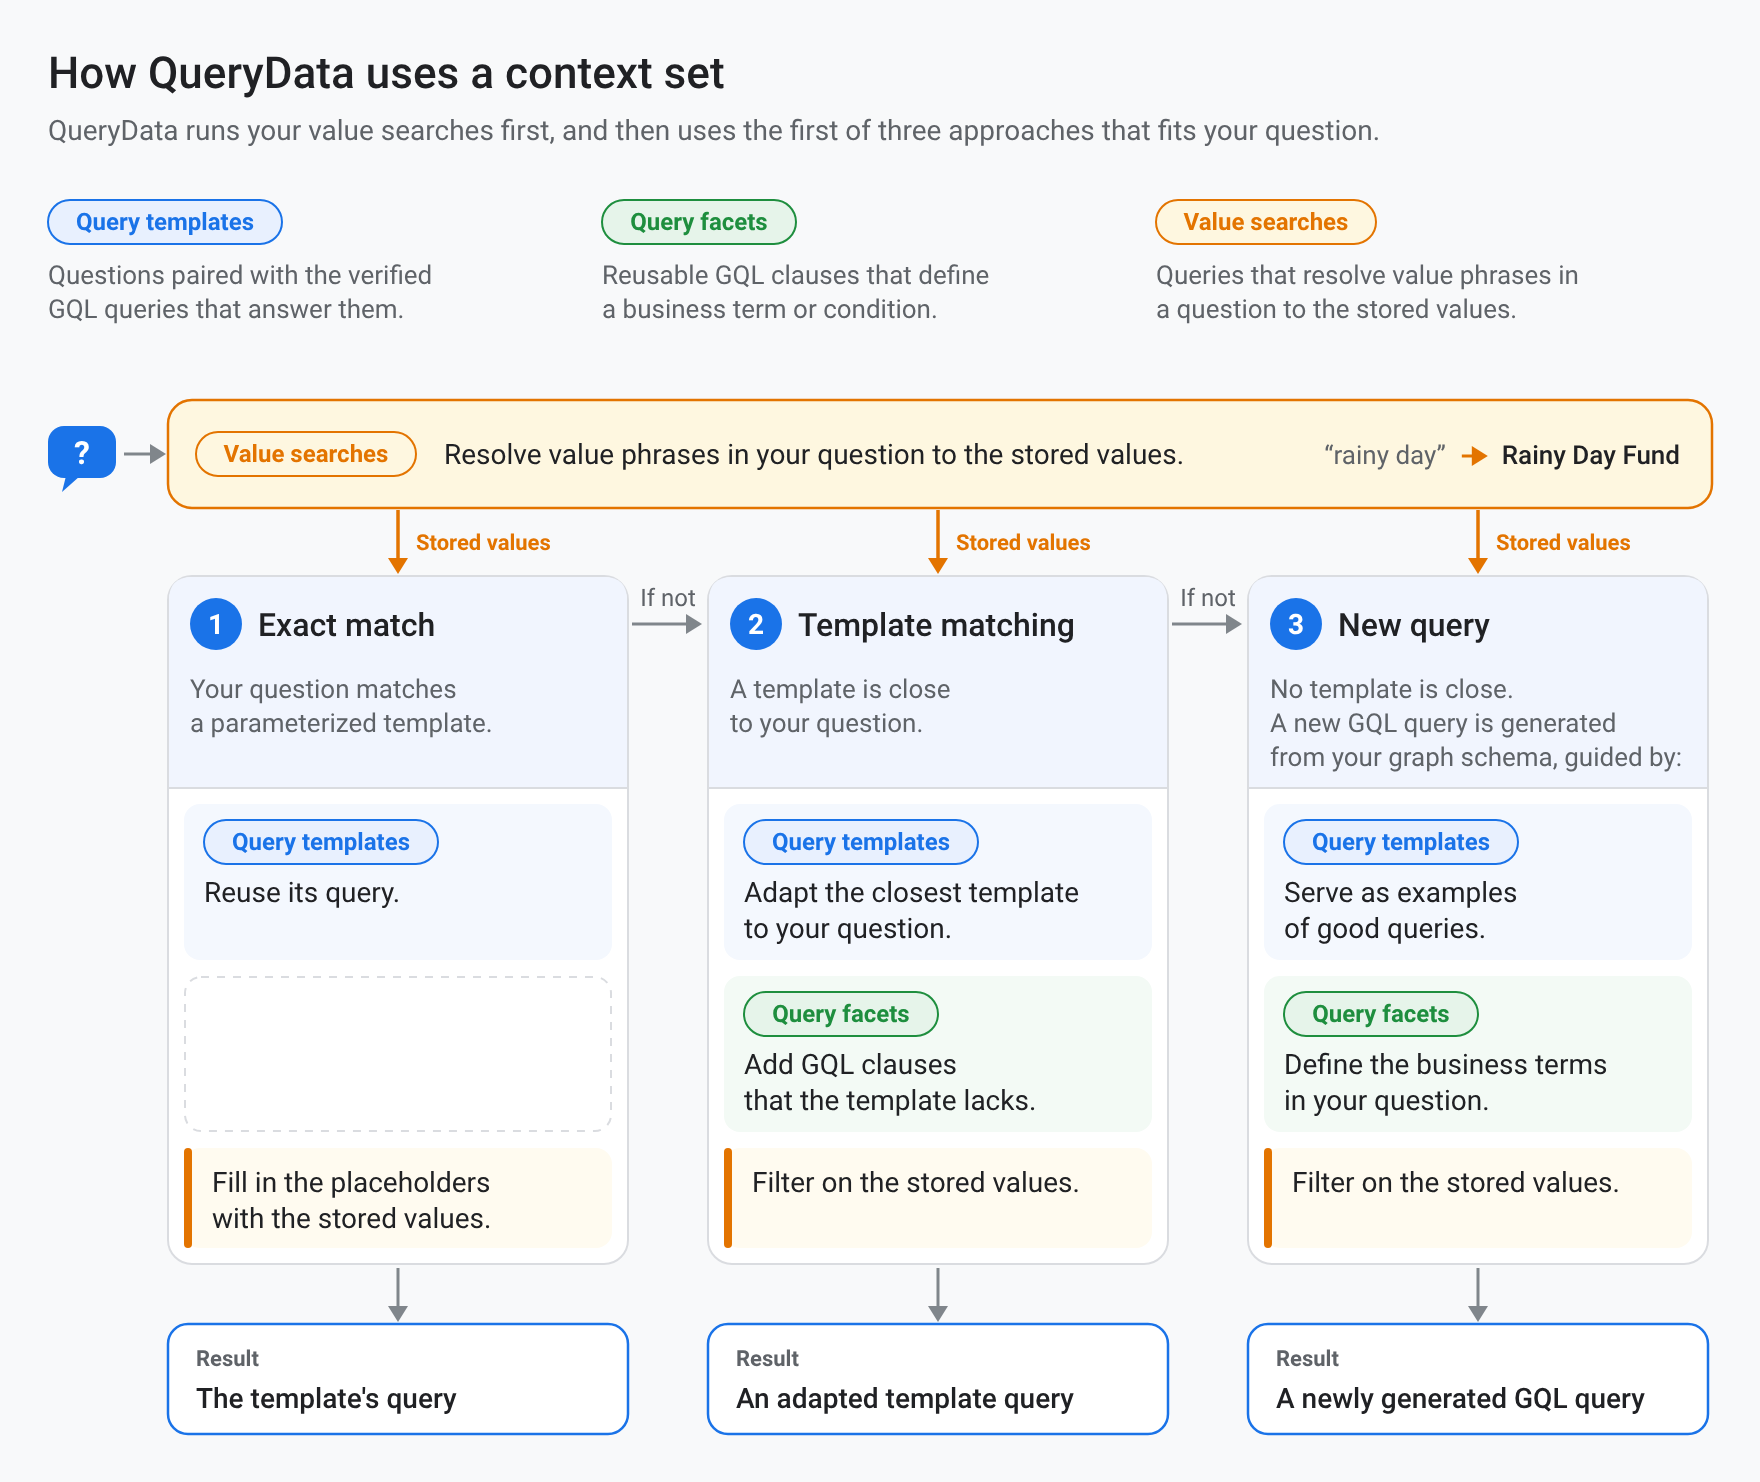
Come mostrato nel diagramma, quando QueryData riceve una domanda, utilizza il set di contesti nel seguente ordine:
- Recuperare il contesto pertinente. QueryData recupera i modelli, i facet e le ricerche di valori più simili alla domanda.
- Esegui ricerche di valore. Per ogni frase di valore nella domanda, ad esempio un nome o un nickname, QueryData esegue le ricerche dei valori per trovare i valori memorizzati corrispondenti. Le ricerche di valori non vengono eseguite per numeri, date, ore o importi in valuta.
- Corrispondenza con i modelli di query. Se la domanda corrisponde a un modello, QueryData utilizza la query GQL verificata del modello. Per una corrispondenza esatta con
nl_query, QueryData esegue direttamente la querysql. Per una corrispondenza con un modello con parametri, QueryData sostituisce i segnaposto?inparameterized_sqlcon i valori della domanda ed esegue la query risultante. - Genera una nuova query GQL. In caso contrario, QueryData genera una nuova query GQL dallo schema del grafico. Applica gli aspetti pertinenti come regole aziendali, utilizza i modelli pertinenti come esempi e utilizza i valori archiviati trovati dalle ricerche di valori.
Formato file del set di contesti
Un file di set di contesto è un oggetto JSON con tre campi di array (templates, facets e value_searches) per gli elementi di contesto descritti nelle sezioni seguenti. Un file di set di contesti vuoto ha la seguente struttura:
{
  "templates": [],
  "facets": [],
  "value_searches": []
}
Utilizza qualsiasi combinazione di questi campi e ometti quelli che non utilizzi. Un buon punto di partenza per Spanner Graph è creare un modello per ogni domanda multi-hop o con limiti di tempo che richiede una struttura di query specifica, un facet per ogni termine aziendale che appare in più domande e una ricerca di valori per ogni proprietà di testo a cui gli utenti fanno riferimento per nome (ad esempio nomi, nickname o paesi).
Quando modifichi un file di set di contesto, tieni presente le seguenti regole:
- Stringhe di query su una sola riga. I valori di
sql,parameterized_sql,sql_snippet,parameterized_sql_snippet,queryenl_querysono stringhe JSON, quindi ogni query viene scritta su una riga. All'interno di una query, utilizza le virgolette singole (') per i valori letterali stringa o l'interpretazione letterale delle virgolette doppie come\". - GQL nei campi
sql. Alcuni nomi di campo contengonosqlperché il formato è condiviso da tutti i database supportati da QueryData. Per Spanner Graph, fornisci query o clausole GQL insql,parameterized_sql,sql_snippeteparameterized_sql_snippet. - Nomi dei campi esatti. I nomi dei campi devono corrispondere esattamente ai nomi riportati in questo documento. I campi con nomi non riconosciuti vengono ignorati senza errori.
Modelli di query
Un modello associa una domanda posta dagli utenti alla query GQL verificata che risponde alla domanda. Utilizza i modelli per le domande che gli utenti pongono ripetutamente, soprattutto quando la query è complessa da generare (ad esempio un pattern di percorso multi-hop con una condizione temporale).
Esempio di modello
Con il seguente modello nel file del set di contesto, QueryData può rispondere a domande che condividono la stessa struttura, ad esempio "Il denaro inviato dal conto 7 è stato restituito entro 60 giorni?" o "Il denaro inviato dal conto 16 è stato restituito entro 30 giorni?":
{
  "templates": [
    {
      "nl_query": "Did any money sent from account 7 come back to it within 60 days?",
      "sql": "GRAPH FinGraph MATCH TRAIL (src:Account {id: 7})-[sent:Transfers]->(:Account)-[:Transfers]->{0,2}(:Account)-[returned:Transfers]->(src) WHERE returned.create_time > sent.create_time AND TIMESTAMP_DIFF(returned.create_time, sent.create_time, DAY) <= 60 RETURN sent.amount AS amount_sent, returned.amount AS amount_returned, TIMESTAMP_DIFF(returned.create_time, sent.create_time, DAY) AS days_to_return",
      "intent": "Find transfer loops of two to four transfers that start and end at account 7, where the last transfer happens within 60 days after the first transfer.",
      "manifest": "Find transfer loops of two to four transfers that start and end at a given account, where the last transfer happens within a given number of days after the first transfer.",
      "parameterized": {
        "parameterized_intent": "Find transfer loops of two to four transfers that start and end at account ?, where the last transfer happens within ? days after the first transfer.",
        "parameterized_sql": "GRAPH FinGraph MATCH TRAIL (src:Account {id: ?})-[sent:Transfers]->(:Account)-[:Transfers]->{0,2}(:Account)-[returned:Transfers]->(src) WHERE returned.create_time > sent.create_time AND TIMESTAMP_DIFF(returned.create_time, sent.create_time, DAY) <= ? RETURN sent.amount AS amount_sent, returned.amount AS amount_returned, TIMESTAMP_DIFF(returned.create_time, sent.create_time, DAY) AS days_to_return"
      }
    }
  ]
}
Quando un utente chiede: "È stato restituito del denaro inviato dal conto 7 entro 60 giorni?", QueryData associa la domanda al modello (o, per una domanda con valori parametro diversi, ad esempio l'account 16 e 30 giorni, sostituisce i due segnaposto ? in parameterized_sql) ed esegue la seguente query GQL:
GRAPH FinGraph
MATCH TRAIL
  (src:Account {id: 7})-[sent:Transfers]->(:Account)
    -[:Transfers]->{0,2}(:Account)-[returned:Transfers]->(src)
WHERE returned.create_time > sent.create_time
  AND TIMESTAMP_DIFF(returned.create_time, sent.create_time, DAY) <= 60
RETURN
  sent.amount AS amount_sent,
  returned.amount AS amount_returned,
  TIMESTAMP_DIFF(returned.create_time, sent.create_time, DAY) AS days_to_return
Utilizzando i dati campionati FinGraph, questa query restituisce risultati simili ai seguenti:
+-------------+-----------------+----------------+
| amount_sent | amount_returned | days_to_return |
+-------------+-----------------+----------------+
| 300         | 500             | 36             |
+-------------+-----------------+----------------+
Campi del modello
Un oggetto template contiene i seguenti campi:
| Campo | Requisito | Descrizione |
|---|---|---|
nl_query |
Obbligatorio | Una domanda di esempio, formulata nel modo in cui la pone un utente (ad esempio, "Il denaro inviato dall'account 7 è stato restituito entro 60 giorni?"). |
sql |
Obbligatorio | La query GQL completa che risponde a nl_query. Inizia la query con GRAPH seguito dal nome di un grafico delle proprietà specificato nel campo graph_ids delle richieste QueryData, ad esempio GRAPH FinGraph. |
intent |
Obbligatorio | Una descrizione precisa dei risultati restituiti da sql. La domanda di un utente spesso lascia le condizioni non dichiarate e intent le dichiara (ad esempio, specificando che il denaro "è tornato" significa "loop di trasferimento da due a quattro trasferimenti che iniziano e terminano nell'account 7, dove l'ultimo trasferimento avviene entro 60 giorni dal primo trasferimento"). |
manifest |
Obbligatorio | Una versione generalizzata di intent che descrive il tipo di domanda a cui risponde il template, senza i valori specifici (ad esempio, "account 7" diventa "un determinato account" e "60 giorni" diventa "un determinato numero di giorni"). QueryData recupera i modelli confrontando la domanda con il manifest. |
parameterized.parameterized_intent |
Facoltativo | intent, con ogni valore specifico sostituito da un segnaposto ?. |
parameterized.parameterized_sql |
Facoltativo | La query sql, con ogni valore specifico sostituito da un segnaposto ? nello stesso ordine di parameterized_intent. Quando una domanda corrisponde al modello, QueryData sostituisce i segnaposto con i valori della domanda ed esegue la query. |
Se scrivi il file del set di contesto manualmente, compila tutti e quattro i campi obbligatori. Il caricamento non va a buon fine e viene visualizzato un errore INVALID_ARGUMENT se uno di questi campi è vuoto. L'agente di progettazione del contesto genera intent, manifest e parameterized dalle coppie nl_query e sql. Esamina i valori generati e modificali se un valore che dovrebbe rimanere fisso viene sostituito da un segnaposto o se un valore che dovrebbe variare non viene sostituito.
Facet di query
Un facet è una clausola GQL riutilizzabile, ad esempio un pattern MATCH o una condizione WHERE, che definisce un termine o una condizione aziendale. A differenza di un template, un facet è una query parziale anziché una query completa, quindi non inizia con una clausola GRAPH e non è legato a una domanda. Quando QueryData genera una nuova query, applica i facet pertinenti alla domanda.
Esempio di facet
Nella seguente configurazione di facets, il primo facet acquisisce il pattern per i trasferimenti che coinvolgono un account bloccato, mentre il secondo definisce un trasferimento ad alto rischio come un trasferimento di 200 o più a un account bloccato:
{
  "facets": [
    {
      "sql_snippet": "MATCH (account:Account)-[transfer:Transfers]-(:Account {is_blocked: true})",
      "intent": "transfers involving a blocked account, in either direction"
    },
    {
      "sql_snippet": "MATCH (account:Account)-[transfer:Transfers]->(blocked_account:Account {is_blocked: true}) WHERE transfer.amount >= 200",
      "intent": "high-risk transfers, which are transfers of 200 or more to a blocked account",
      "manifest": "high-risk transfers, which are transfers of a given amount or more to a blocked account",
      "parameterized": {
        "parameterized_intent": "high-risk transfers, which are transfers of ? or more to a blocked account",
        "parameterized_sql_snippet": "MATCH (account:Account)-[transfer:Transfers]->(blocked_account:Account {is_blocked: true}) WHERE transfer.amount >= ?"
      }
    }
  ]
}
Quando un utente chiede "Quanti trasferimenti ad alto rischio ha effettuato Alex?", nessun template corrisponde alla domanda. QueryData genera una nuova query GQL e incorpora la seconda dimensione per conteggiare i trasferimenti di 200 o più a un account bloccato:
GRAPH `FinGraph`
MATCH (p:`Person` {`name`: "Alex"})-[:`Owns`]->(src:`Account`)
      -[t:`Transfers`]->(dst:`Account` {`is_blocked`: true})
FILTER t.`amount` >= 200.0
RETURN COUNT(*) AS high_risk_transfer_count
Utilizzando i dati campionati di FinGraph, questa query conteggia il trasferimento di 300 dall'account 7 all'account bloccato 16 e restituisce risultati simili ai seguenti:
+--------------------------+
| high_risk_transfer_count |
+--------------------------+
| 1                        |
+--------------------------+
Campi facet
Un oggetto facet utilizza la stessa struttura di un template di query, con le seguenti differenze:
- Nessun campo
nl_query. I facet non hanno un camponl_query, perché descrivono una condizione che appare in molte domande anziché in una singola domanda. sql_snippetinvece disql(obbligatorio). Una clausola GQL, ad esempio un patternMATCHo una condizioneWHERE. Per evitare ambiguità, utilizza etichette di nodi e archi e nomi di variabili espliciti, come(account:Account), in modo che QueryData possa combinare la clausola GQL con il resto della query.intent(obbligatorio),manifest(facoltativo) eparameterized(facoltativo). Definisci il termine o la condizione commerciale nello stesso modo dei campi del modello, con la differenza che QueryData associa le domande aintent(quindi rendilo descrittivo emanifestè facoltativo) eparameterizedcontieneparameterized_intenteparameterized_sql_snippet.
Query di ricerca di valore
Una ricerca di valori è una query, non una tabella di ricerca. Prima che QueryData generi una query GQL, esegue le ricerche dei valori una volta per ogni frase di valore nella domanda (un valore di testo come un nome, un nickname o un paese), sostituendo la frase con $value. Poi, utilizza i valori archiviati più vicini restituiti dalle query, insieme alla proprietà da cui provengono, quando scrive la query GQL. Le ricerche di valori non vengono eseguite per numeri, date, ore o importi di valuta.
Esempio di ricerca di valori
Ad esempio, in FinGraph, l'account 20 ha il nickname Rainy Day Fund e la proprietà Person.country memorizza Czech_Republic con un trattino basso. Le seguenti ricerche di valori mappano frasi di valore come "giorno di pioggia" a Rainy Day Fund in Account.nick_name e "Repubblica Ceca" a Czech_Republic in Person.country:
{
  "value_searches": [
    {
      "query": "SELECT value, columns, concept_type, distance, context FROM GRAPH_TABLE(FinGraph MATCH (a:Account) WHERE STRPOS(LOWER(a.nick_name), LOWER($value)) > 0 RETURN DISTINCT a.nick_name AS value, 'FinGraph.Account.nick_name' AS columns, 'Account nickname' AS concept_type, 1 - LENGTH($value) / LENGTH(a.nick_name) AS distance, JSON '{}' AS context)",
      "concept_type": "Account nickname",
      "description": "Case-insensitive partial match on account nicknames. Distance is 0 for an exact match and grows as the phrase covers less of the nickname."
    },
    {
      "query": "SELECT value, columns, concept_type, distance, context FROM GRAPH_TABLE(FinGraph MATCH (p:Person) WHERE LOWER(REPLACE(p.country, '_', ' ')) = LOWER(REPLACE($value, '_', ' ')) RETURN DISTINCT p.country AS value, 'FinGraph.Person.country' AS columns, 'Person country' AS concept_type, 0 AS distance, JSON '{}' AS context)",
      "concept_type": "Person country",
      "description": "Match for country names on Person nodes that ignores case and treats underscores as spaces"
    }
  ]
}
La query Account nickname, formattata per la leggibilità, è la seguente:
SELECT value, columns, concept_type, distance, context
FROM GRAPH_TABLE(
  FinGraph
  MATCH (a:Account)
  WHERE STRPOS(LOWER(a.nick_name), LOWER($value)) > 0
  RETURN DISTINCT
    a.nick_name AS value,
    'FinGraph.Account.nick_name' AS columns,
    'Account nickname' AS concept_type,
    1 - LENGTH($value) / LENGTH(a.nick_name) AS distance,
    JSON '{}' AS context
)
Quando un utente chiede "Chi è il proprietario dell'account per le emergenze?", QueryData esegue le ricerche dei valori con $value impostato su 'rainy day'. La ricerca di Account nickname calcola distance dalla lunghezza della frase rispetto alla lunghezza del nickname memorizzato (mentre una frase più ampia come "fondo" corrisponde a Vacation Fund a circa 0.69 e Rainy Day Fund a circa 0.71, e una corrispondenza esatta come "fondo per le emergenze" ha una distanza di 0) e restituisce risultati simili ai seguenti:
+----------------+----------------------------+------------------+--------------------+---------+
| value          | columns                    | concept_type     | distance           | context |
+----------------+----------------------------+------------------+--------------------+---------+
| Rainy Day Fund | FinGraph.Account.nick_name | Account nickname | 0.3571428571428571 | {}      |
+----------------+----------------------------+------------------+--------------------+---------+
QueryData genera quindi una query GQL che filtra in base a {nick_name: 'Rainy Day Fund'} anziché a {nick_name: 'rainy day'}:
GRAPH `FinGraph`
MATCH (p:`Person`)-[:`Owns`]->(a:`Account` {`nick_name`: 'Rainy Day Fund'})
RETURN DISTINCT SAFE_TO_JSON(p) AS person
Utilizzando i dati campionati FinGraph, questa query restituisce il nodo Person per Dana in formato JSON, simile al seguente:
{
  "element_definition_name": "Person",
  "identifier": "kQKRBA==",
  "kind": "node",
  "labels": ["Person"],
  "properties": {
    "birthday": "1980-10-31T08:00:00Z",
    "city": "Moravia",
    "country": "Czech_Republic",
    "id": 2,
    "name": "Dana"
  }
}
Campi di ricerca dei valori e colonne SELECT obbligatorie
Un oggetto di ricerca dei valori contiene i seguenti campi:
| Campo | Requisito | Descrizione |
|---|---|---|
query |
Obbligatorio | Una query GoogleSQL che trova i valori archiviati che corrispondono a una frase di valore. Utilizza $value dove va la frase. QueryData sostituisce $value con la frase come stringa letterale tra virgolette, quindi non racchiudere $value tra virgolette. Puoi utilizzare $value più di una volta. Scrivi la query come istruzione SELECT su un operatore GRAPH_TABLE che corrisponde a un'etichetta di nodo o arco, confronta una proprietà con $value e restituisce le cinque colonne della tabella seguente. |
concept_type |
Obbligatorio | Un'etichetta per il tipo di valore trovato dalla ricerca, ad esempio Account nickname o Person country. |
description |
Facoltativo | Una descrizione di come la ricerca corrisponde ai valori. |
Ogni ricerca di valori query deve restituire le seguenti cinque colonne in questo ordine:
| Colonna di output | Descrizione | Esempio di FinGraph |
|---|---|---|
value |
Il valore della proprietà corrispondente, così come è archiviato nel database. | a.nick_name AS value ('Rainy Day Fund') |
columns |
La località della proprietà, nel formato GRAPH_NAME.LABEL.PROPERTY. QueryData passa questo valore al modello come posizione del valore, quindi utilizza un formato coerente. |
'FinGraph.Account.nick_name' AS columns |
concept_type |
Un'etichetta per il tipo di valore. Utilizza la stessa stringa del campo concept_type della ricerca di valori: il campo etichetta la ricerca e la colonna etichetta ogni corrispondenza. |
'Account nickname' AS concept_type |
distance |
La distanza del valore memorizzato dalla frase, su una scala definita da te, dove 0 è una corrispondenza esatta. Per convenzione, utilizza valori compresi tra 0 e 1. QueryData ordina i candidati di tutte le ricerche di valori in base a distance e mantiene i 10 più vicini. Non applica una soglia, quindi escludi le corrispondenze deboli nella query stessa, ad esempio aggiungendo WHERE distance < 1.0 all'istruzione SELECT esterna. |
1 - LENGTH($value) / LENGTH(a.nick_name) AS distance |
context |
Un valore JSON. QueryData non utilizza questa colonna, ma la colonna deve essere presente con lo stesso tipo in ogni ricerca di valori. Restituisci JSON '{}'. |
JSON '{}' AS context |
In che modo QueryData esegue le ricerche di valori
QueryData non esegue ricerche di valori una alla volta. Per ogni frase di valore in una domanda, sostituisce la frase con $value in ogni ricerca di valore, aggiunge ORDER BY distance LIMIT 10 a ogni query, combina le query con UNION ALL ed esegue il risultato come una singola istruzione GoogleSQL che mantiene le 10 corrispondenze più vicine. La query combinata è il motivo per cui le ricerche di valori vengono scritte come istruzioni SELECT su GRAPH_TABLE anziché come istruzioni GQL autonome: GRAPH_TABLE esegue il pattern GQL MATCH come tabella, mentre UNION ALL e ORDER BY distance condiviso sono costrutti SQL.
Questo modello di esecuzione ha le seguenti conseguenze per le query che scrivi:
- Nessun
ORDER BYoLIMITesterno. Non aggiungereORDER BYoLIMITall'istruzioneSELECTesterna. QueryData li aggiunge e una clausola duplicata causa l'errore dell'istruzione. - Tipi di colonna compatibili. Ogni ricerca di valori nel file deve restituire le stesse cinque colonne, nello stesso ordine e con tipi compatibili. Ad esempio, restituisci
JSON '{}'percontextin tutti i casi, non'{}'in alcuni. - Segnaposto
$valueobbligatorio. La query deve contenere$valuealmeno una volta, altrimenti il caricamento non va a buon fine. - Solo valori di testo. Le ricerche di valori vengono eseguite solo per i valori di testo. QueryData non li esegue per numeri, date, ore o importi in valuta.
Limitazioni
I set di contesto per Spanner Graph presentano le seguenti limitazioni:
- I set di contesto per i database supportano solo modelli di query, facet di query e ricerche di valori.
- I set di contesti per i database vengono utilizzati solo dall'endpoint
QueryDatanell'API Analisi conversazionale.