


컨텍스트 세트는 QueryData와 같은 도구가 Spanner 데이터베이스의 속성 그래프에 대한 정확한 Graph Query Language(GQL) 쿼리를 생성하는 데 도움이 되는 안내 모음입니다. QueryData는 데이터베이스에서 직접 속성 그래프 스키마를 읽습니다. 컨텍스트 세트는 스키마가 포착하지 못하는 비즈니스 용어의 의미, 사용자가 자주 묻는 질문에 대한 검증된 쿼리, 사용자가 그래프에 저장된 값을 참조하는 방식을 추가합니다. 컨텍스트 세트에서 그래프 스키마를 다시 정의할 필요는 없습니다.
QueryData에서 지원하는 데이터베이스는 다음과 같습니다.
- PostgreSQL용 AlloyDB
- MySQL용 Cloud SQL
- PostgreSQL용 Cloud SQL
- Spanner(Spanner Graph 포함)
- MongoDB 호환성을 갖춘 Firestore
Spanner Graph가 아닌 관계형 Spanner 테이블에서 컨텍스트 세트를 사용하려면 Spanner의 컨텍스트 세트 개요를 참조하세요.
쿼리 템플릿, 쿼리 가짓수, 값 검색의 세 가지 유형의 객체가 포함된 JSON 파일에서 컨텍스트를 정의합니다. 컨텍스트 엔지니어링 에이전트를 사용하여 이 파일을 작성한 후 Spanner Studio에서 만든 컨텍스트 세트에 업로드할 수 있습니다. QueryData는 QueryData 요청이 agent_context_reference.context_set_id 필드에서 컨텍스트 세트를 참조할 때 이를 사용합니다.
us-central1, us-east1, europe-west4, asia-southeast1 리전에서 컨텍스트 세트를 만들 수 있습니다. 컨텍스트 세트의 리전은 QueryData 요청에 사용하는 위치(예: locations/global)와 일치하지 않아도 됩니다.
이 문서의 예시에서는 FinGraph 속성 그래프 스키마(Owns 및 Transfers 에지로 연결된 Person 및 Account 노드)를 사용합니다. Spanner 데이터베이스에서 FinGraph 속성 그래프를 설정하고 샘플 데이터를 삽입하려면 Spanner Graph 설정 및 쿼리를 참조하세요.
QueryData에서 컨텍스트 세트를 사용하는 방법
컨텍스트 집합에는 세 가지 유형의 컨텍스트가 포함될 수 있습니다. 각 유형은 서로 다른 문제를 해결하며 QueryData는 이를 독립적으로 또는 함께 사용할 수 있습니다.
| 컨텍스트 유형 | 광고주가 제공할 자료 | 사용해야 하는 경우 | QueryData에서 사용하는 방식 | FinGraph 예시 |
|---|---|---|---|---|
| 쿼리 템플릿 | 한 가지 유형의 질문에 대한 완전하고 검증된 GQL 쿼리로, 변경되는 값에 대한 ? 자리표시자가 있습니다. |
사용자가 서로 다른 파라미터 값으로 동일한 질문을 반복적으로 요청합니다. 특히 멀티홉 경로 패턴과 같이 쿼리가 복잡한 경우에 그렇습니다. | 정확한 일치를 위해 sql 쿼리를 직접 재사용하거나 질문이 템플릿과 일치하는 경우 매개변수를 parameterized_sql로 대체합니다. |
"계정 7에서 송금된 금액이 60일 이내에 다시 계정 7로 돌아왔나요?" |
| 쿼리 패싯 | 비즈니스 용어 또는 조건을 정의하는 재사용 가능한 GQL 절(예: MATCH 패턴 또는 WHERE 조건)입니다. |
재사용 가능한 조건 또는 패턴 하나가 여러 질문에 나타납니다. | 새 GQL 쿼리를 생성할 때 정의된 GQL 절을 통합합니다. | 고위험 송금은 차단된 계정으로 200 이상을 송금하는 것입니다. |
| 값 검색 | 사용자 질문의 값 문구와 일치하는 저장된 속성 값을 찾는 쿼리입니다. | 사용자가 그래프에 저장된 방식과 다른 이름이나 철자로 값을 참조합니다. | GQL 쿼리를 생성하기 전에 값 구문으로 조회 쿼리를 실행한 다음 확인된 저장된 값과 속성을 필터링합니다. | '비 오는 날'은 Account.nick_name의 Rainy Day Fund을(를) 의미합니다. |
다음 다이어그램은 QueryData가 컨텍스트 세트를 사용하여 질문을 처리하는 방법을 보여줍니다.
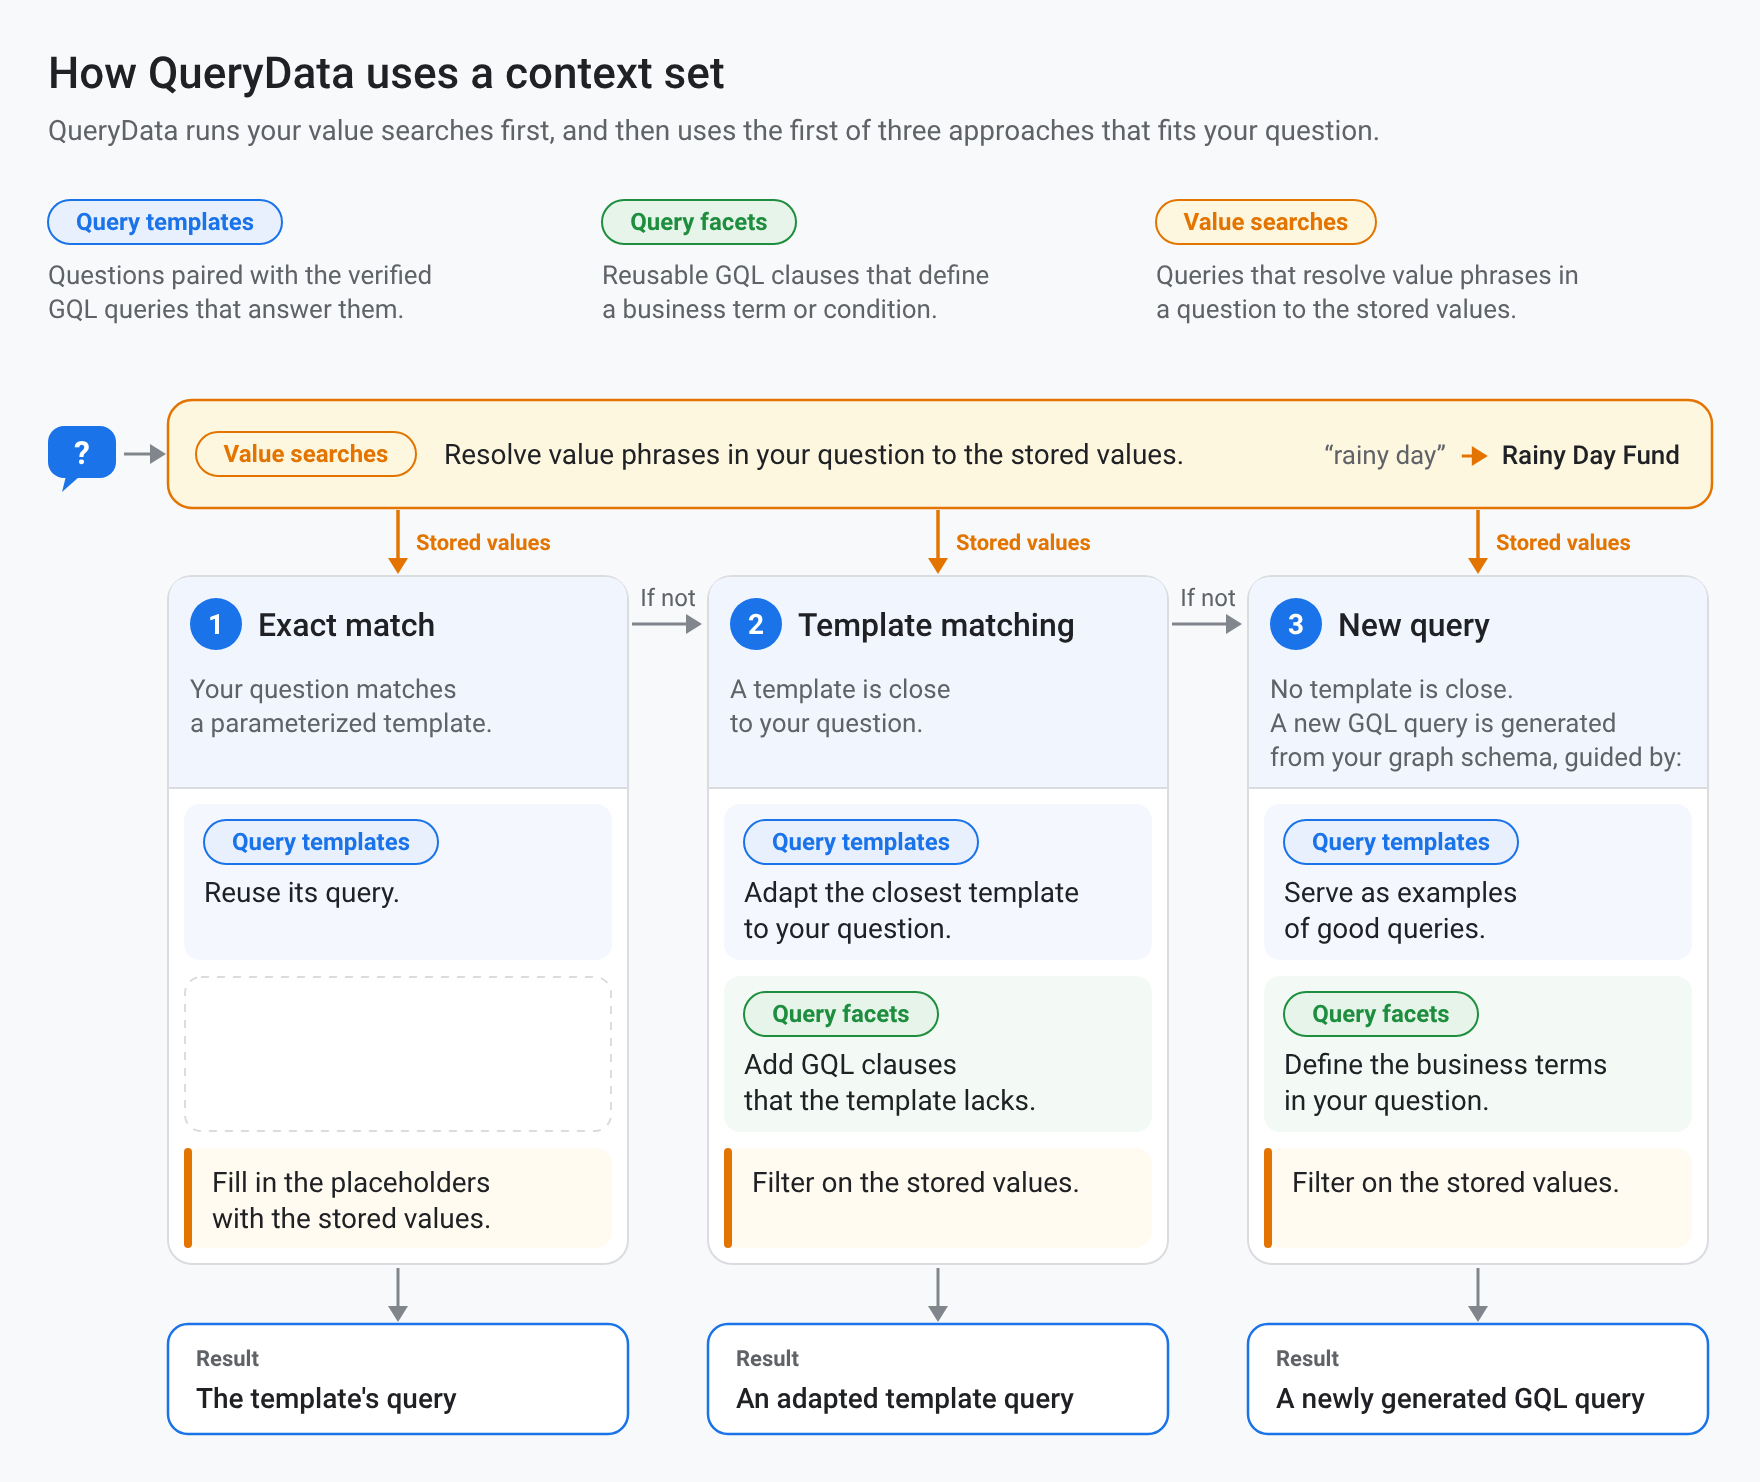
다이어그램에 표시된 것처럼 QueryData는 질문을 받으면 다음 순서로 컨텍스트 세트를 사용합니다.
- 관련 컨텍스트 검색 QueryData는 질문과 가장 유사한 템플릿, 패싯, 값 검색을 가져옵니다.
- 값 검색 실행 이름이나 닉네임과 같은 질문의 각 값 구문에 대해 QueryData는 값 검색을 실행하여 일치하는 저장된 값을 찾습니다. 숫자, 날짜, 시간, 통화 금액에 대해서는 값 검색이 실행되지 않습니다.
- 쿼리 템플릿과 일치 질문이 템플릿과 일치하면 QueryData는 템플릿의 검증된 GQL 쿼리를 사용합니다.
nl_query와 정확히 일치하는 경우 QueryData는sql쿼리를 직접 실행합니다. 매개변수화된 템플릿과 일치하는 경우 QueryData는parameterized_sql의?자리표시자를 질문의 값으로 바꾸고 결과 쿼리를 실행합니다. - 새 GQL 쿼리를 생성합니다. 그렇지 않으면 QueryData가 그래프 스키마에서 새 GQL 쿼리를 생성합니다. 관련 패싯을 비즈니스 규칙으로 적용하고, 관련 템플릿을 예시로 사용하며, 값 검색에서 찾은 저장된 값을 사용합니다.
컨텍스트 세트 파일 형식
컨텍스트 세트 파일은 다음 섹션에 설명된 컨텍스트 항목의 배열 필드 3개(templates, facets, value_searches)가 있는 JSON 객체입니다. 빈 컨텍스트 세트 파일의 구조는 다음과 같습니다.
{
  "templates": [],
  "facets": [],
  "value_searches": []
}
이러한 필드를 원하는 대로 조합하여 사용하고 사용하지 않는 필드는 생략합니다. Spanner Graph를 시작하는 좋은 방법은 특정 쿼리 구조가 필요한 각 멀티홉 또는 시간 제한 질문에 대한 템플릿, 여러 질문에 걸쳐 나타나는 각 비즈니스 용어에 대한 패싯, 사용자가 이름으로 참조하는 각 텍스트 속성(예: 이름, 닉네임, 국가)에 대한 값 검색을 만드는 것입니다.
컨텍스트 세트 파일을 수정할 때는 다음 규칙에 유의하세요.
- 한 줄 쿼리 문자열.
sql,parameterized_sql,sql_snippet,parameterized_sql_snippet,query,nl_query의 값은 JSON 문자열이므로 각 쿼리는 한 줄에 작성됩니다. 쿼리 내에서 문자열 리터럴에 작은따옴표(')를 사용하거나 큰따옴표를\"로 이스케이프 처리합니다. sql필드의 GQL QueryData에서 지원하는 모든 데이터베이스에서 형식을 공유하므로 일부 필드 이름에는sql가 포함됩니다. Spanner Graph의 경우sql,parameterized_sql,sql_snippet,parameterized_sql_snippet에 GQL 쿼리 또는 절을 제공합니다.- 정확한 필드 이름. 필드 이름은 이 문서의 이름과 정확히 일치해야 합니다. 인식할 수 없는 이름이 있는 필드는 오류 없이 무시됩니다.
쿼리 템플릿
템플릿은 사용자가 하는 질문과 이에 대한 답변을 제공하는 검증된 GQL 쿼리를 페어링합니다. 사용자가 반복적으로 묻는 질문에 템플릿을 사용합니다. 특히 시간 조건이 있는 멀티홉 경로 패턴과 같이 생성하기 복잡한 쿼리의 경우에 유용합니다.
템플릿 예시
컨텍스트 세트 파일에 다음 템플릿이 있으면 QueryData는 '계정 7에서 송금된 금액이 60일 이내에 반환되었나요?' 또는 '계정 16에서 송금된 금액이 30일 이내에 반환되었나요?'와 같이 동일한 구조를 공유하는 질문에 답변할 수 있습니다.
{
  "templates": [
    {
      "nl_query": "Did any money sent from account 7 come back to it within 60 days?",
      "sql": "GRAPH FinGraph MATCH TRAIL (src:Account {id: 7})-[sent:Transfers]->(:Account)-[:Transfers]->{0,2}(:Account)-[returned:Transfers]->(src) WHERE returned.create_time > sent.create_time AND TIMESTAMP_DIFF(returned.create_time, sent.create_time, DAY) <= 60 RETURN sent.amount AS amount_sent, returned.amount AS amount_returned, TIMESTAMP_DIFF(returned.create_time, sent.create_time, DAY) AS days_to_return",
      "intent": "Find transfer loops of two to four transfers that start and end at account 7, where the last transfer happens within 60 days after the first transfer.",
      "manifest": "Find transfer loops of two to four transfers that start and end at a given account, where the last transfer happens within a given number of days after the first transfer.",
      "parameterized": {
        "parameterized_intent": "Find transfer loops of two to four transfers that start and end at account ?, where the last transfer happens within ? days after the first transfer.",
        "parameterized_sql": "GRAPH FinGraph MATCH TRAIL (src:Account {id: ?})-[sent:Transfers]->(:Account)-[:Transfers]->{0,2}(:Account)-[returned:Transfers]->(src) WHERE returned.create_time > sent.create_time AND TIMESTAMP_DIFF(returned.create_time, sent.create_time, DAY) <= ? RETURN sent.amount AS amount_sent, returned.amount AS amount_returned, TIMESTAMP_DIFF(returned.create_time, sent.create_time, DAY) AS days_to_return"
      }
    }
  ]
}
사용자가 "계정 7에서 송금된 금액이 60일 이내에 다시 입금되었나요?"라고 물으면 QueryData는 질문을 템플릿과 일치시키거나(또는 계정 16 및 30일과 같이 파라미터 값이 다른 질문의 경우 parameterized_sql의 두 ? 자리표시자를 대체) 다음 GQL 쿼리를 실행합니다.
GRAPH FinGraph
MATCH TRAIL
  (src:Account {id: 7})-[sent:Transfers]->(:Account)
    -[:Transfers]->{0,2}(:Account)-[returned:Transfers]->(src)
WHERE returned.create_time > sent.create_time
  AND TIMESTAMP_DIFF(returned.create_time, sent.create_time, DAY) <= 60
RETURN
  sent.amount AS amount_sent,
  returned.amount AS amount_returned,
  TIMESTAMP_DIFF(returned.create_time, sent.create_time, DAY) AS days_to_return
FinGraph 샘플 데이터를 사용하면 이 쿼리는 다음과 유사한 결과를 반환합니다.
+-------------+-----------------+----------------+
| amount_sent | amount_returned | days_to_return |
+-------------+-----------------+----------------+
| 300         | 500             | 36             |
+-------------+-----------------+----------------+
템플릿 필드
템플릿 객체에는 다음 필드가 포함됩니다.
| 필드 | 요구사항 | 설명 |
|---|---|---|
nl_query |
필수 | 사용자가 질문하는 방식으로 표현된 질문 예시입니다(예: '7번 계좌에서 송금된 금액이 60일 이내에 다시 입금되었나요?'). |
sql |
필수 | nl_query에 답변하는 전체 GQL 쿼리입니다. GRAPH로 쿼리를 시작하고 그 뒤에 QueryData 요청의 graph_ids 필드에 지정한 속성 그래프 이름(예: GRAPH FinGraph)을 입력합니다. |
intent |
필수 | sql에서 반환하는 결과에 대한 정확한 설명입니다. 사용자의 질문에는 조건이 명시되지 않는 경우가 많으며, intent는 이를 명시합니다(예: 금액이 '반환됨'은 '계정 7에서 시작하고 끝나는 2~4회의 이체 루프로, 마지막 이체는 첫 번째 이체 후 60일 이내에 발생함'을 의미함). |
manifest |
필수 | 특정 값 없이 템플릿이 답변하는 질문의 종류를 설명하는 일반화된 버전의 intent입니다(예: '계정 7'은 '지정된 계정'이 되고 '60일'은 '지정된 일수'가 됨). QueryData는 질문을 매니페스트와 비교하여 템플릿을 검색합니다. |
parameterized.parameterized_intent |
선택사항 | intent. 각 특정 값은 ? 자리표시자로 대체됩니다. |
parameterized.parameterized_sql |
선택사항 | sql 쿼리. 각 특정 값은 parameterized_intent와 동일한 순서로 ? 자리표시자로 대체됩니다. 질문이 템플릿과 일치하면 QueryData는 자리표시자를 질문의 값으로 바꾸고 이 쿼리를 실행합니다. |
컨텍스트 세트 파일을 직접 작성하는 경우 필수 입력란 4개를 모두 작성합니다. 하나라도 비어 있으면 INVALID_ARGUMENT 오류와 함께 업로드가 실패합니다. 컨텍스트 엔지니어링 에이전트는 nl_query 및 sql 쌍에서 intent, manifest, parameterized를 생성합니다. 생성된 값을 검토하고, 고정되어야 하는 값이 플레이스홀더로 대체되거나 변경되어야 하는 값이 대체되지 않은 경우 수정합니다.
쿼리 패싯
패싯은 비즈니스 용어 또는 조건을 정의하는 MATCH 패턴 또는 WHERE 조건과 같은 재사용 가능한 GQL 절입니다. 템플릿과 달리 패싯은 완전한 쿼리가 아닌 부분 쿼리이므로 GRAPH 절로 시작하지 않으며 하나의 질문에 연결되지 않습니다. QueryData는 새 쿼리를 생성할 때 질문과 관련된 패싯을 적용합니다.
패싯 예시
다음 facets 구성에서 첫 번째 패싯은 차단된 계정과 관련된 송금 패턴을 캡처하고 두 번째 패싯은 고위험 송금을 차단된 계정으로 200 이상 송금하는 것으로 정의합니다.
{
  "facets": [
    {
      "sql_snippet": "MATCH (account:Account)-[transfer:Transfers]-(:Account {is_blocked: true})",
      "intent": "transfers involving a blocked account, in either direction"
    },
    {
      "sql_snippet": "MATCH (account:Account)-[transfer:Transfers]->(blocked_account:Account {is_blocked: true}) WHERE transfer.amount >= 200",
      "intent": "high-risk transfers, which are transfers of 200 or more to a blocked account",
      "manifest": "high-risk transfers, which are transfers of a given amount or more to a blocked account",
      "parameterized": {
        "parameterized_intent": "high-risk transfers, which are transfers of ? or more to a blocked account",
        "parameterized_sql_snippet": "MATCH (account:Account)-[transfer:Transfers]->(blocked_account:Account {is_blocked: true}) WHERE transfer.amount >= ?"
      }
    }
  ]
}
사용자가 "알렉스가 고위험 이체를 몇 번이나 했나요?"라고 질문하면 질문과 일치하는 템플릿이 없습니다. QueryData는 새 GQL 쿼리를 생성하고 두 번째 패싯을 통합하여 차단된 계정으로의 200 이상 이체 횟수를 계산합니다.
GRAPH `FinGraph`
MATCH (p:`Person` {`name`: "Alex"})-[:`Owns`]->(src:`Account`)
      -[t:`Transfers`]->(dst:`Account` {`is_blocked`: true})
FILTER t.`amount` >= 200.0
RETURN COUNT(*) AS high_risk_transfer_count
이 쿼리는 FinGraph 샘플 데이터를 사용하여 7 계정에서 차단된 계정 16으로의 300 이전을 계산하고 다음과 유사한 결과를 반환합니다.
+--------------------------+
| high_risk_transfer_count |
+--------------------------+
| 1                        |
+--------------------------+
패싯 필드
패싯 객체는 쿼리 템플릿과 동일한 구조를 사용하지만 다음과 같은 차이점이 있습니다.
nl_query필드 없음. 패싯은 단일 질문이 아닌 여러 질문 내에 표시되는 조건을 설명하므로nl_query필드가 없습니다.sql대신sql_snippet(필수).MATCH패턴 또는WHERE조건과 같은 GQL 절입니다. 모호성을 방지하려면 QueryData가 GQL 절을 나머지 쿼리와 결합할 수 있도록 명시적인 노드 및 에지 라벨과 변수 이름(예:(account:Account))을 사용합니다.intent(필수),manifest(선택사항),parameterized(선택사항). 템플릿 필드와 동일한 방식으로 비즈니스 용어 또는 조건을 정의합니다. 단, QueryData는 질문을intent와 일치시키므로 설명이 포함되어야 하며manifest는 선택사항입니다.parameterized에는parameterized_intent및parameterized_sql_snippet가 포함됩니다.
가치 검색어
값 검색은 참고표가 아닌 쿼리입니다. QueryData는 GQL 쿼리를 생성하기 전에 질문의 각 값 문구(이름, 닉네임, 국가와 같은 텍스트 값)에 대해 값 검색을 한 번 실행하여 문구를 $value로 대체합니다. 그런 다음 GQL 쿼리를 작성할 때 쿼리에서 반환하는 가장 가까운 저장된 값과 해당 값이 속한 속성을 사용합니다. 숫자, 날짜, 시간, 통화 금액에 대해서는 값 검색이 실행되지 않습니다.
값 검색 예시
예를 들어 FinGraph에서 계정 20의 닉네임은 Rainy Day Fund이고 Person.country 속성은 밑줄이 있는 Czech_Republic를 저장합니다. 다음 값 검색은 'rainy day'와 같은 값 구문을 Account.nick_name의 Rainy Day Fund에 매핑하고 'Czech Republic'을 Person.country의 Czech_Republic에 매핑합니다.
{
  "value_searches": [
    {
      "query": "SELECT value, columns, concept_type, distance, context FROM GRAPH_TABLE(FinGraph MATCH (a:Account) WHERE STRPOS(LOWER(a.nick_name), LOWER($value)) > 0 RETURN DISTINCT a.nick_name AS value, 'FinGraph.Account.nick_name' AS columns, 'Account nickname' AS concept_type, 1 - LENGTH($value) / LENGTH(a.nick_name) AS distance, JSON '{}' AS context)",
      "concept_type": "Account nickname",
      "description": "Case-insensitive partial match on account nicknames. Distance is 0 for an exact match and grows as the phrase covers less of the nickname."
    },
    {
      "query": "SELECT value, columns, concept_type, distance, context FROM GRAPH_TABLE(FinGraph MATCH (p:Person) WHERE LOWER(REPLACE(p.country, '_', ' ')) = LOWER(REPLACE($value, '_', ' ')) RETURN DISTINCT p.country AS value, 'FinGraph.Person.country' AS columns, 'Person country' AS concept_type, 0 AS distance, JSON '{}' AS context)",
      "concept_type": "Person country",
      "description": "Match for country names on Person nodes that ignores case and treats underscores as spaces"
    }
  ]
}
가독성을 위해 형식이 지정된 Account nickname 쿼리는 다음과 같습니다.
SELECT value, columns, concept_type, distance, context
FROM GRAPH_TABLE(
  FinGraph
  MATCH (a:Account)
  WHERE STRPOS(LOWER(a.nick_name), LOWER($value)) > 0
  RETURN DISTINCT
    a.nick_name AS value,
    'FinGraph.Account.nick_name' AS columns,
    'Account nickname' AS concept_type,
    1 - LENGTH($value) / LENGTH(a.nick_name) AS distance,
    JSON '{}' AS context
)
사용자가 "비상금 계좌는 누구 소유야?"라고 물으면 QueryData는 $value를 'rainy day'로 설정하여 값 검색을 실행합니다. Account nickname 검색은 저장된 닉네임의 길이를 기준으로 구문의 길이에서 distance를 계산하고('fund'와 같은 더 광범위한 구문은 약 0.69에서 Vacation Fund와 일치하고 약 0.71에서 Rainy Day Fund와 일치하며 'rainy day fund'와 같은 일치검색은 거리가 0임) 다음과 유사한 결과를 반환합니다.
+----------------+----------------------------+------------------+--------------------+---------+
| value          | columns                    | concept_type     | distance           | context |
+----------------+----------------------------+------------------+--------------------+---------+
| Rainy Day Fund | FinGraph.Account.nick_name | Account nickname | 0.3571428571428571 | {}      |
+----------------+----------------------------+------------------+--------------------+---------+
그러면 QueryData는 {nick_name: 'rainy day'} 대신 {nick_name: 'Rainy Day Fund'}를 필터링하는 GQL 쿼리를 생성합니다.
GRAPH `FinGraph`
MATCH (p:`Person`)-[:`Owns`]->(a:`Account` {`nick_name`: 'Rainy Day Fund'})
RETURN DISTINCT SAFE_TO_JSON(p) AS person
FinGraph 샘플 데이터를 사용하는 이 쿼리는 Dana의 Person 노드를 다음과 유사한 JSON 형식으로 반환합니다.
{
  "element_definition_name": "Person",
  "identifier": "kQKRBA==",
  "kind": "node",
  "labels": ["Person"],
  "properties": {
    "birthday": "1980-10-31T08:00:00Z",
    "city": "Moravia",
    "country": "Czech_Republic",
    "id": 2,
    "name": "Dana"
  }
}
값 검색 필드 및 필수 SELECT 열
값 검색 객체에는 다음 필드가 포함됩니다.
| 필드 | 요구사항 | 설명 |
|---|---|---|
query |
필수 | 값 문구와 일치하는 저장된 값을 찾는 GoogleSQL 쿼리입니다. 문구가 들어가는 위치에 $value를 사용합니다. QueryData는 $value를 따옴표로 묶인 문자열 리터럴로 대체하므로 $value를 따옴표로 묶지 마세요. $value를 두 번 이상 사용할 수 있습니다. 노드 또는 에지 라벨과 일치하고, 속성을 $value과 비교하고, 다음 표의 5개 열을 반환하는 GRAPH_TABLE 연산자에 대한 SELECT 문으로 쿼리를 작성합니다. |
concept_type |
필수 | 검색에서 찾는 값 유형의 라벨입니다(예: Account nickname 또는 Person country). |
description |
선택사항 | 검색이 값과 일치하는 방식에 대한 설명입니다. |
모든 값 검색 query은 다음 5개 열을 이 순서대로 반환해야 합니다.
| 출력 열 | 설명 | FinGraph 예시 |
|---|---|---|
value |
데이터베이스에 저장된 일치하는 속성 값입니다. | a.nick_name AS value('Rainy Day Fund') |
columns |
GRAPH_NAME.LABEL.PROPERTY 형식의 숙박 시설 위치입니다. QueryData는 이 값을 값의 위치로 모델에 전달하므로 일관된 형식을 사용하세요. |
'FinGraph.Account.nick_name' AS columns |
concept_type |
값 종류의 라벨입니다. 값 검색의 concept_type 필드와 동일한 문자열을 사용합니다. 필드는 검색에 라벨을 지정하고 열은 각 일치 항목에 라벨을 지정합니다. |
'Account nickname' AS concept_type |
distance |
저장된 값이 구문에서 얼마나 떨어져 있는지 정의한 척도로 나타냅니다. 여기서 0은 정확히 일치하는 값입니다. 일반적으로 0~1 사이의 값을 사용합니다. QueryData는 모든 값 검색의 후보를 distance로 정렬하고 가장 가까운 10개를 유지합니다. 기준점을 적용하지 않으므로 외부 SELECT 문에 WHERE distance < 1.0를 추가하는 등 쿼리 자체에서 약한 일치를 제외합니다. |
1 - LENGTH($value) / LENGTH(a.nick_name) AS distance |
context |
JSON 값 QueryData는 이 열을 사용하지 않지만 모든 값 검색에서 동일한 유형의 열이 있어야 합니다. JSON '{}'를 반환합니다. |
JSON '{}' AS context |
QueryData가 값 검색을 실행하는 방법
QueryData는 값 검색을 한 번에 하나씩 실행하지 않습니다. 질문의 각 값 문구에 대해 모든 값 검색에서 문구를 $value로 대체하고, 각 쿼리에 ORDER BY distance LIMIT 10를 추가하고, 쿼리를 UNION ALL와 결합하고, 가장 가까운 일치 항목 10개를 유지하는 단일 GoogleSQL 문으로 결과를 실행합니다. 결합된 쿼리는 값 검색이 독립형 GQL 문이 아닌 GRAPH_TABLE에 대한 SELECT 문으로 작성되는 이유입니다. GRAPH_TABLE는 GQL MATCH 패턴을 테이블로 실행하고 UNION ALL 및 공유 ORDER BY distance는 SQL 구문입니다.
이 실행 모델은 작성하는 쿼리에 다음과 같은 영향을 미칩니다.
- 외부
ORDER BY또는LIMIT없음. 외부SELECT문에ORDER BY또는LIMIT를 추가하지 마세요. QueryData가 이를 추가하고 중복 절로 인해 문이 실패합니다. - 호환되는 열 유형 파일의 모든 값 검색은 동일한 순서와 호환되는 유형으로 동일한 5개 열을 반환해야 합니다. 예를 들어 모든 항목에서
context에 대해JSON '{}'를 반환하고 일부 항목에서'{}'를 반환하지 않습니다. - 필수
$value플레이스홀더. 쿼리에는$value가 한 번 이상 포함되어야 합니다. 그렇지 않으면 업로드가 실패합니다. - 텍스트 값만 값 검색은 텍스트 값에 대해서만 실행됩니다. QueryData는 숫자, 날짜, 시간, 통화 금액에 대해서는 실행되지 않습니다.
제한사항
Spanner Graph의 컨텍스트 세트에는 다음과 같은 제한사항이 있습니다.
- 데이터베이스의 컨텍스트 세트는 쿼리 템플릿, 쿼리 패싯, 값 검색만 지원합니다.
- 데이터베이스의 컨텍스트 세트는 대화형 분석 API의
QueryData엔드포인트에서만 사용됩니다.
다음 단계
- Spanner Studio에서 컨텍스트 세트를 만들거나 삭제하는 방법을 알아보세요.
- 컨텍스트 엔지니어링 에이전트를 사용하여 컨텍스트 세트를 빌드하는 방법을 알아보세요.