


Knowledge Catalog ist eine auf Gemini basierende Kontextschicht, die universellen Geschäftskontext und aktive Fundierungsmöglichkeiten für Ihren gesamten Datenbestand bietet. Durch die Erstellung eines dynamischen Kontextgraphen aus strukturierten und unstrukturierten Daten können Datenteams und Entwickler Assets ermitteln, die Datenqualität überprüfen und generative KI-Anwendungen sicher verankern, um Halluzinationen zu reduzieren.
Eine detaillierte Anleitung zu Knowledge Catalog finden Sie im folgenden Video:
Zielgruppe und Voraussetzungen
Diese Übersicht richtet sich an Data Engineers, Kontext-Engineers, Data Scientists, Data Stewards und KI-Entwickler. Bevor Sie Knowledge Catalog verwenden können, benötigen Sie Folgendes:
Kenntnisse von Datenbank- und Speichersystemen wie BigQuery oder Cloud Storage.
Grundlegendes Verständnis von Konzepten generativer KI wie Retrieval-Augmented Generation (RAG) oder Model Context Protocol (MCP).
Branchenspezifische Datenkomplexität bewältigen
In modernen Unternehmen sind Daten komplex, stark verteilt und in strukturierten und unstrukturierten Formaten vorhanden. Geschäftsanfragen lassen sich selten einem einzelnen Datenbankschema oder Dokumentspeicher zuordnen. Diese Silos sicher aufeinander abzustimmen und gleichzeitig sofortige, zuverlässige Antworten auf domänenübergreifende Fragen zu liefern, ist eine große operative Herausforderung.
Knowledge Catalog dient als semantische Grundlage, die diese Lücke schließt und es KI-Agenten und Analysetools ermöglicht, fundierten, relevanten Kontext abzurufen.
Schlüsselnutzerrollen
Context Engineers (Data Engineers): Automatisieren Sie die Metadatenaggregation über Datenbanken und Cloud Storage hinweg, verfolgen Sie Transformationen mit der Herkunft und erstellen Sie Workflows für die Anreicherung und Bewertung.
Data Stewards (Governance-Teams): Überwachen Sie die Qualität von Metadaten, indem Sie KI-generierte Beschreibungen von Menschen überprüfen lassen, Unternehmensvokabulare mit Glossaren standardisieren und benutzerdefinierte Aspekte definieren, um Katalogeinträgen domänenspezifischen Kontext hinzuzufügen.
KI-Entwickler LLMs und KI-Anwendungen mit vertrauenswürdigen Unternehmensdatenschemas auf Grundlage von MCP-Servern oder APIs zum Abrufen von Kontextinformationen fundieren.
Einsatzfelder nach Branchen
Die folgende Tabelle veranschaulicht die komplexen Fragen, die in der Praxis auftreten, wie sie technische Grenzen überschreiten und wie Knowledge Catalog Organisationen dabei hilft, sie zu beantworten:
| Branche | Herausforderungen in Bezug auf Daten und Betrieb | Zu lösendes Geschäftsproblem | So wird das Problem im Knowledge Catalog gelöst |
|---|---|---|---|
| E-Commerce |
|
„Finde Elektronikprodukte mit hohen Rückgabequoten und Kundenfotos, die Anzeichen von Schäden bei der Ankunft zeigen.“ | Semantische Fundierung über Datenformate hinweg:Metadaten aus Transaktionsdatenbanken werden automatisch ermittelt und mit unstrukturierten Bildern in Cloud Storage-Buckets verknüpft. So können KI-Tools die Anfrage über verschiedene Speichersysteme hinweg beantworten. |
| Produktion/Fertigung |
|
„Erstelle Zusammenfassungen für alle Inspektionsberichte zu Maschinen in der Region West, die im letzten Quartal Sicherheitsprüfungen nicht bestanden haben.“ | Regionales und unstrukturiertes Crawling:Unstrukturierte PDF-Prüfberichte werden zusammen mit Asset-Metadaten gecrawlt und katalogisiert. So können generative KI-Agents Berichte nach Region suchen, zusammenstellen und zusammenfassen. |
| Gesundheitswesen |
|
„Welche Patienten haben das höchste Risiko für eine erneute Aufnahme innerhalb von 30 Tagen, wenn man sich die letzten Laborwerte und die Häufigkeit der Arzttermine ansieht?“ | Datenqualität und Datenherkunft:Berechnet die Datenqualitätsprofilierung und Datenherkunftskarten auf Zeilenebene für Feeds mit elektronischen Gesundheitsdaten. So wird sichergestellt, dass klinische Vorhersagemodelle nur auf verifizierten, hochwertigen Vitalparametern basieren. |
| Finanzdienstleistungen |
|
„Welche der 10 Kunden mit dem höchsten Umsatz haben sich über Leistungsprobleme beschwert und wie wirkt sich das auf die Prognosen für das 3. Quartal aus?“ | Einheitlicher Kontextgraph:Kundeninformationen, Support-Feedback und Finanztabellen werden zusammengeführt. So können mit Abfragen in natürlicher Sprache Kundenumsatzstatistiken mit unstrukturierten Feedbackdateien verknüpft werden, um die finanziellen Auswirkungen zu prognostizieren. |
Um diese betrieblichen Herausforderungen zu bewältigen, bietet Knowledge Catalog wichtige Funktionen, die Data Engineers, Data Scientists und KI-Entwicklern helfen, geregelte Datensysteme zu erstellen:
KI-Agenten mit dem Model Context Protocol (MCP) fundieren. Metadaten, Schemas, Datenherkunft und Geschäftsregeln können KI-Agenten direkt über lokale oder Remote-MCP-Server zur Verfügung gestellt werden. Auf diesen Servern können Modelle betriebliche Erwartungen prüfen, bevor sie Aktionen vorschlagen.
Erkenntnisse für KI und Analysen schneller gewinnen: Relevante Daten-Assets mit der semantischen Suche in natürlicher Sprache finden. Generative Zusammenfassungen und Empfehlungen helfen Nutzern, Daten zu finden, ohne auf manuelle Dokumentationsprüfungen warten zu müssen.
Kontext aus unstrukturierten Daten extrahieren: Unstrukturierte Dateien wie PDFs in Cloud Storage werden automatisch geparst, um Entitäten und Beziehungen zu extrahieren und in abfragefähige Assets in BigQuery zu konvertieren, um Conversational Agents zu unterstützen.
Datenprodukte in großem Maßstab verwalten: Fassen Sie Sammlungen von Assets mit Service Level Agreements (SLAs), Verträgen, Eigentumsdetails und Nutzungshinweisen in einzelnen, verwalteten Einheiten für die Suche und das Abo zusammen.
So funktioniert Knowledge Catalog
Knowledge Catalog vereinheitlicht die Datenverwaltung und den Kontext durch einen dreistufigen Lebenszyklus. Das folgende Diagramm veranschaulicht, wie der Dienst physische Daten-Assets für die KI-Agenten-Fundierung geschäftlichen Semantiken zuordnet:

Weitere Informationen zu diesen Metadatenkonzepten finden Sie unter Informationen zu Metadaten.
In den folgenden Abschnitten werden die drei Säulen des Metadatenlebenszyklus beschrieben und es wird veranschaulicht, wie ein Einzelhandelsunternehmen sie auf Datenbanktabellen, Dateien und externe Katalogeinträge anwendet:
Aggregation (Discover and ingest) Knowledge Catalog crawlt und indexiert automatisch technische Metadaten in Ihrer Datenumgebung, ohne die zugrunde liegenden Daten zu verschieben:
- Integrierte Datenbanken: Beim automatischen Katalogisieren werden Schemas und Attribute plattformübergreifend erfasst, z. B. in BigQuery, AlloyDB for PostgreSQL und Spanner.
- Verwaltete Konnektivität Sie können Definitionen aus externen Systemen wie Oracle oder PostgreSQL oder aus Partnerregistrierungen wie Collibra aufnehmen, ohne benutzerdefinierte Pipelines schreiben zu müssen.
- Data Lineage Sie können Transformationen auf Spaltenebene über Pipelines hinweg nachvollziehen, um zu sehen, woher Ihre Daten stammen und wie sie sich geändert haben.
- Beispiel:Ein Einzelhandelsunternehmen nimmt automatisch Metadaten aus Transaktionsdatenbanken wie den Tabellen
ordersundorder_itemsauf und indexiert unstrukturierte Produktdateien, die in Cloud Storage-Buckets gespeichert sind. Sie verknüpfen externe Datenbanken, um einen einheitlichen Metadatenindex in einem auffindbaren Verzeichnis zu erstellen.
Weitere Informationen zur Metadatenaggregation und Datenaufnahme (zum Maximieren anklicken)
- Unterstützte Datenquellen: Hier werden alle unterstützten Google Cloud und externen Quellen für die automatische Aufnahme aufgeführt.
- Verwaltete Verbindungen – Übersicht: Hier wird beschrieben, wie technische Schemas aus externen Systemen aufgenommen werden.
- Datenherkunft nachvollziehen: Hier wird beschrieben, wie Sie Pipeline-Transformationen und den Datenfluss auf Spaltenebene visualisieren.
Kontext anreichern und Vertrauen bestätigen Knowledge Catalog ordnet technischen Strukturen eine geschäftliche Bedeutung zu und erstellt Vertrauenssignale:
- KI-generierte Statistiken: Gemini analysiert Abfragelogs, um Spaltenbeschreibungen, Tabellenzusammenfassungen und empfohlene Joins zu generieren.
- Unstrukturierte Indexierung: Dateiverzeichnisse crawlen, um Entitäten und Verbindungen aus unstrukturierten Assets wie PDFs oder Bildern zu extrahieren.
- Glossare und Aspekte Ordnen Sie interne Messwertnamen mithilfe von Geschäftsbegriffen und logischen Vorlagen einem gemeinsamen Vokabular zu.
- Datenqualität und Anomalieerkennung: Richtlinien zur Datenbereinigung durchsetzen und Scans mit maschinellem Lernen ausführen, um statistische Ausreißer oder Probleme mit der Aktualität der Daten zu erkennen und wichtige Vertrauenssignale zu generieren.
- Governance-Überprüfungen: Risiken lassen sich minimieren, indem Sie Workflow-Überprüfungsprozesse verwenden, um Metadaten-Updates vor der Veröffentlichung zu bestätigen.
- Beispiel:Das Einzelhandelsteam reichert Assets an, indem es Datenanalysen auslöst, um Spaltenbeschreibungen zu empfehlen und Datenqualitätsregeln auszuführen. Sie ordnen Geschäftsdefinitionen aktiven Bestellungen zu, indem sie Glossare und Aspekte erstellen.
Weitere Informationen zur Metadatenanreicherung und Vertrauensüberprüfung (zum Maximieren klicken)
- Data Insights konfigurieren: Hier erfahren Sie, wie Sie automatische Dataset-Beschreibungen und ‑Zusammenfassungen erstellen.
- Geschäftsglossare verwalten: Hier wird beschrieben, wie Sie Standardbegriffe und Geschäftsvokabular anpassen.
- Metadaten mit Aspekten anreichern: Hier wird beschrieben, wie Sie logischen Assets strukturierte Metadateneigenschaften zuweisen.
- Datenqualitätsregeln wiederverwenden: Hier erfahren Sie, wie Sie Datenbankvalidierungsregeln erstellen und wiederverwenden.
- Übersicht zur Datenprofilerstellung: Hier wird beschrieben, wie Sie Scans für Schemaanomalien und statistische Abweichungen konfigurieren.
Suchen und Abrufen (Zugriff und Fundierung): KI-Anwendungen und Geschäftsnutzer fragen das einheitliche Kontextdiagramm ab, um sicher auf Daten zuzugreifen:
- Agents fundieren. Verbinden Sie Ihre LLM-basierten Apps und Agenten mit dem Katalog.
- Context API Führen Sie Anfragen für die Fundierung von Nutzlasten mit niedriger Latenz aus.
- Semantische Suche: Mit Abfragen in natürlicher Sprache die richtigen Assets finden
- Datenpakete: Bündeln Sie Sammlungen von Tabellen, Lizenzierungsdetails und SLAs in sicheren Selfservice-Datenpaketen.
- Beispiel:Analysten führen semantische Suchen in natürlicher Sprache durch, um Assets zu finden. KI-Anwendungen nutzen diesen Index sicher über MCP-Server oder die API zum Abrufen von Kontext. Hochwertige Assets werden in einer sicheren Ansicht zusammengefasst.
Weitere Informationen zum Abrufen von Kontext und zur Fundierung von Agents (zum Maximieren klicken)
- Übersicht über das Model Context Protocol (MCP): Hier wird erläutert, wie generative KI-Agenten und Anwendungsebenen mit dem Kontext des Knowledge Catalog verknüpft werden.
- Kontext mit LookupContext abrufen: Hier wird gezeigt, wie Sie wichtige operative Nutzlasten für das Auffordern von Agenten extrahieren.
- Nach Assets suchen: Hier wird beschrieben, wie Sie mit der semantischen Abfragesyntax in natürlicher Sprache nach Assets suchen können.
Knowledge Catalog in Google Cloud und KI-Ökosystem
Es ist wichtig zu wissen, wie Knowledge Catalog in zugehörige Dienste eingebunden wird, wenn Sie eine Datenbasis erstellen.
Google Cloud -Datenbanken und ‑Modelle
- BigQuery. Knowledge Catalog crawlt und indexiert automatisch BigQuery-Datasets, -Tabellen und -Ansichten. Dadurch werden Gemini-basierte Data Insights ausgelöst, um Abfrageverläufe zu analysieren, Beschreibungen zu veröffentlichen und geprüfte Beispielabfragen vorzuschlagen.
- Looker (Google Cloud Core) Im Knowledge Catalog werden Looker-Dashboards, Looks und LookML-Strukturen wie Ansichten, Explores, Dimensionen und Messwerte aufgenommen. Bei dieser Aufnahme werden Lineage-Zuordnungen erstellt, um nachzuvollziehen, wie operative Werte auf Geschäftssemantik abgebildet werden.
- Lighthouse-Laufzeitkatalog. Knowledge Catalog ist in Lighthouse eingebunden, den Laufzeit-Metastore für Open-Source-Iceberg-Arbeitslasten. Es indexiert automatisch technische Metadaten zusätzlich zu Lighthouse-Arbeitslasten, um einen einheitlichen aktiven Kontext zu bieten.
Plattformen und Assistenten für KI‑Agenten
- Konversationsanalyse: Analyseschnittstellen verwenden Katalogbegriffe und Nachschlagetools, damit Nutzer Geschäftsstatistiken in natürlicher Sprache mit überprüfter Fundierung abfragen können.
- Gemini für KI‑Agenten. Assistenten-KI-Agenten mit hoher Präzision verwenden Katalogmetadaten, um Datenbankabfragen auszuführen und Halluzinationen zu reduzieren.
- Gemini Enterprise Agent Platform Knowledge Catalog dient als zentraler Standard für die Datenverwaltung in Zielplattformumgebungen. Sie ist mit der Gemini Enterprise Agent Platform verknüpft, um Tools und Kontext in die Agent Registry der Plattform einzuspeisen.
Google Cloud Datenbank- und KI-Dienstintegration
Knowledge Catalog arbeitet mit anderenGoogle Cloud -Produkten zusammen, um Ihre Datengrundlage zu bilden. In der folgenden Tabelle wird beschrieben, wie Knowledge Catalog in verwandte Dienste eingebunden wird und diese ergänzt:
| Dienst | Primäre Rolle | Einbindung in Knowledge Catalog |
|---|---|---|
| Knowledge Catalog | Governance und Kontext von KI-Agenten | Dient als einheitlicher semantischer Kontextgraph, führt Scans zur Überprüfung der Datenqualität aus und stellt fundierte Schemas für KI-Modelle und ‑Anwendungen bereit. |
| BigQuery | Data-Warehouse-Prozess in Unternehmen | Speichert, fragt ab und verarbeitet Datasets; crawlt, indexiert und erweitert diese Tabellen automatisch mit Aspekten der Unternehmensklassifizierung. |
| Vertex AI | Entwicklung von KI-Modellen | Erstellt, stellt bereit und hostet Foundation Models. Benutzerdefinierte KI-Agents rufen Metadatenkontext ab, um logische Schlussfolgerungen zu fundieren. |
| Cloud Storage | Unstrukturierte Dateien speichern | Hier werden unstrukturierte Rohdateien gespeichert. Es werden automatisch Scans zur Erkennung unstrukturierter Daten ausgeführt, um PDFs und Bilder zu parsen und Beziehungsdiagramme zu erstellen. |
Semantik und Datenformate
Um Agentensysteme effektiv zu instruieren und zu fundieren, müssen Sie zwischen physischer Datenstruktur und semantischer Bedeutung unterscheiden:
- Semantik Die geschäftliche Bedeutung, die Intention und die Beziehungen, die mit Ihren Daten verknüpft sind. Technische Schemas definieren zwar strukturelle Speicherspezifikationen wie einen Datenbanktyp, eine Zeichenlänge oder eine Ganzzahlbeschränkung, die Semantik beschreibt jedoch, was das Dataset tatsächlich darstellt. Sie können beispielsweise eine Spalte mit dem Namen
txn_qtyder Geschäftsdefinition „gekaufte Menge“ zuordnen. - Strukturierte Daten: Informationen, die in definierten Schemas und relationalen Formaten gespeichert sind. Beispiele sind BigQuery-Tabellen, Spanner-Datenbanken und operative Postgres-Tabellen. Knowledge Catalog crawlt diese Metadaten automatisch und erfasst Spalten und Einschränkungen.
- Unstrukturierte Daten: Unformatierte Informationen mit Rohtext oder Media-Dateien ohne strukturelles Schema. Beispiele sind PDF-Datenblätter, E‑Mails vom Kundensupport und in Cloud Storage gespeicherte Bilder. Knowledge Catalog führt Discovery-Scans durch, indem es Erkenntnisse aus unstrukturierten Daten verwendet, um zugrunde liegende Entitätsbeziehungen zu extrahieren und in einem Graph-Profil aufzuzeichnen. Das ist ein spezieller Aspekt, der KI-extrahierte Entitätsbeziehungsknoten und ‑kanten enthält.
Kontextorchestrierung in der Agentischen Daten-Cloud
Im Rahmen der agentischen Data Cloud von Google dient Knowledge Catalog als semantische Orchestrationsebene. Anstatt dass Entwickler Datenbankschemas und Regeln manuell in Prompts codieren müssen, stellt die Kontext-Engine dynamisch den genauen semantischen Kontext bereit, den ein Agent für intelligente Entscheidungen benötigt.
Die folgende Abbildung zeigt, wie Knowledge Catalog den Datenkontext orchestriert und bereitstellt:
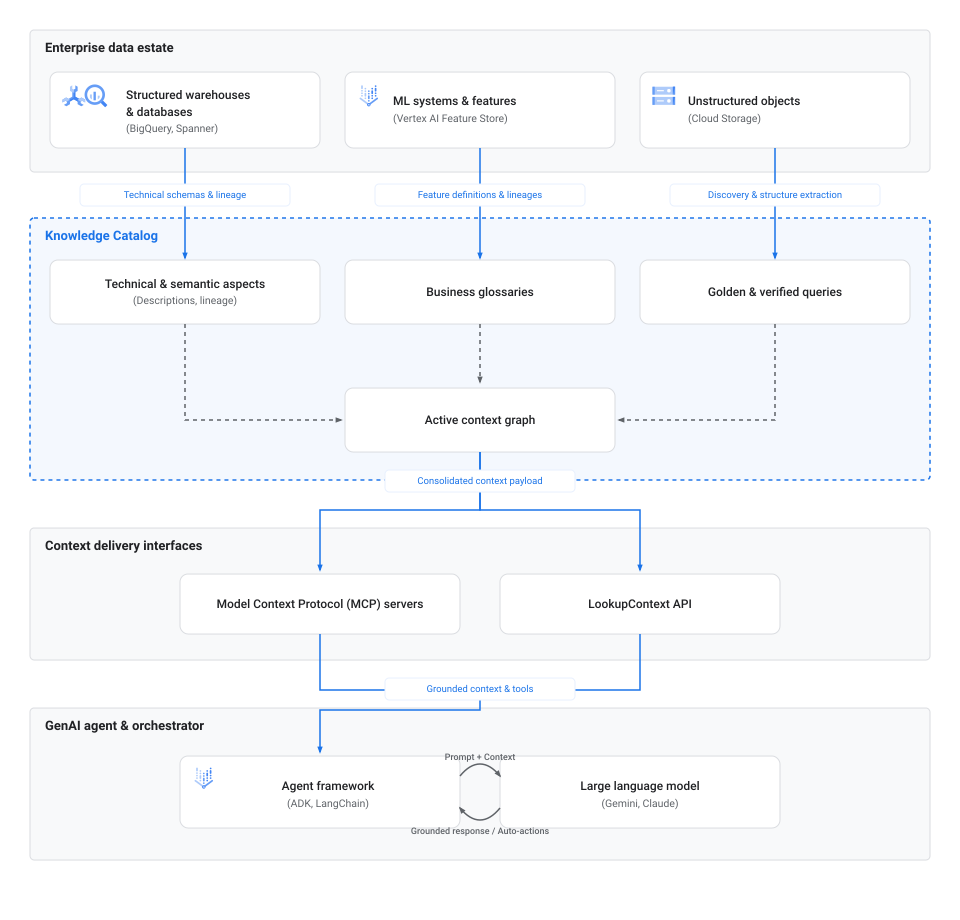
Der Workflow für die Kontextorchestration besteht aus den folgenden Phasen:
- Aufnahme und Auffindbarkeit: Operative Datenbanken, Data Warehouses wie Spanner und BigQuery, unstrukturierte Objektspeicher wie Cloud Storage und Laufzeit-Metastores wie Lighthouse liefern technische Schemas, Lineage-Diagramme und Metadatendefinitionen direkt in den Knowledge Catalog.
- Kontextzuordnung: Im Knowledge Catalog werden diese Metadateneigenschaften mit semantischen Elementen verknüpft, darunter technische Aspekte, Geschäftsglossare und bestätigte Abfragen, um den aktiven Kontextgraphen zu erstellen.
- Schnittstellen für die Bereitstellung: KI-Anwendungen und Orchestratoren rufen diesen konsolidierten Kontextgraphen programmatisch über Standard-Connectors wie MCP oder direkte
LookupContext-API-Endpunkte ab. - Agent-Grounding Orchestrierungs-Frameworks wie das Agent Development Kit (ADK) oder LangChain fügen diesen Metadatenkontext direkt in LLM-Prompts ein. Durch diese Injektion wird die Argumentation des KI-Agents auf überprüften Organisationsregeln basiert, sodass er Datenbanken abfragen oder automatisierte Aktionen ohne Halluzinationen ausführen kann.
KI-Agenten-Profile
Je nach den Workflows, die Sie automatisieren möchten, können Sie verschiedene Klassen von Agenten erstellen, die auf dem Knowledge Catalog basieren:
- Data Discovery-Agents: Diese Assistenten helfen Nutzern, die Daten zu durchsuchen und darin zu navigieren. Anstatt Keyword-Optionen zu verwenden, analysieren sie die Intention und Einschränkungen in natürlicher Sprache, um die relevantesten physischen Assets abzurufen.
- Agents zur Metadatenanreicherung: Diese Hintergrund-Agents nehmen unstrukturierten Text aus Wikis, README-Dateien oder Chatprotokollen auf, parsen den Text in formale Metadaten und schreiben die Metadaten als Aspekte in den Knowledge Catalog, um die Metadaten auf dem neuesten Stand zu halten.
- Datenqualität und Pipeline-Agents Diese autonomen Agents werten Qualitätsregeln aus, erkennen Schema-Drift und erstellen oder reparieren Datentransformationspipelines, indem sie Datenherkunft und Profilstatistiken abfragen.
Orchestrierungstools
Für die Entwicklung und Integration dieser Agents können Sie die folgenden Tools verwenden:
- Model Context Protocol (MCP). Ein standardisiertes, offenes Protokoll zum Verknüpfen von Agenten mit externen Ressourcen. Sie können Agenten so konfigurieren, dass sie entweder über den Remote-MCP-Server oder die lokale MCP-Toolbox eine Verbindung zum Katalog herstellen. Weitere Informationen finden Sie unter Model Context Protocol (MCP) im Knowledge Catalog.
- Agent Development Kit (ADK). Ein Framework von Google, das die Entwicklung, Ausführung und das Testen von generativen KI-Agents vereinfacht und integrierte Bindungen an die Catalog Service API bietet. Weitere Informationen finden Sie auf der ADK-Startseite.
- LookupContext API Ein REST- und gRPC-API-Endpunkt, der eine einheitliche YAML- oder JSON-Kontextnutzlast für Daten-Assets extrahiert, die direkt in LLM-Prompts eingefügt werden kann. Weitere Informationen finden Sie unter Kontext mit der LookupContext API abrufen.
Zugriffskontext mit MCP
Das Model Context Protocol (MCP) ist eine standardisierte Brücke, über die KI-Agents und Tools nahtlos mit Datenquellen wie dem Knowledge Catalog verbunden werden können. Anhand der folgenden Vergleichstabelle können Sie die beste Option für Ihre Integration ermitteln:
| Implementierung | Optimal für | Wichtige Details | Endpunkt oder Einrichtung |
|---|---|---|---|
| Remote-MCP-Server | Cloud-first-Bereitstellungen, serverlose Umgebungen wie Cloud Run und verwaltete externe Dienste. | Von Google gehosteter Endpunkt, für den keine lokale Serververwaltung erforderlich ist. | Endpunkt: https://dataplex.googleapis.com/mcpInformationen zur Einrichtung finden Sie unter Remote-MCP-Server verwenden. |
| Lokale MCP Toolbox | Lokale Agent-Entwicklung, schnelles Prototyping und Desktop-IDE-Integrationen wie VS Code oder Cursor. | Befehlszeilentool, das als lokaler Proxy zwischen Ihrer Workspace-Umgebung und dem Knowledge Catalog fungiert. | Erfordert die Installation von Binärdateien und .mcp.json-Einstellungen.Informationen zur Einrichtung finden Sie unter Lokalen MCP-Server verwenden. |
Best Practices für den agentischen Datenkontext
Wenn Sie zuverlässige agentenbasierte Anwendungen entwickeln möchten, sollten Sie die folgenden Best Practices für die Organisation und Abfrage von Metadaten im Knowledge Catalog beachten:
- Aspekte hinzufügen KI-Agents können nicht allein anhand des Namens zwischen offiziellen Produktionstabellen und temporären Sandbox-Mockups unterscheiden. Definieren und wenden Sie einen benutzerdefinierten Aspekt für das Vertrauenssignal an, um autoritative Datenprodukte zu zertifizieren. So können Sie dafür sorgen, dass Agents Anfragen an diese Ressourcen priorisieren oder darauf beschränken.
- Suchvorgänge mit Kontextbudgets optimieren: Geben Sie beim Aufrufen der
LookupContextAPI den Parametercontext_budgetan. Die API optimiert und passt zuerst die wichtigsten Metadaten wie Herkunft und primäre Beschreibungen an die von Ihnen angegebenen Token-Beschränkungen an. - Zugehörige Ressourcen bereitstellen, um Join-Pfade zu präsentieren: Geben Sie in Ihren Kontextanfragen bis zu 10 zugehörige Tabellen oder Assets an. Wenn Sie eine Gruppe von Assets bereitstellen, kann die Kontext-Engine automatisch Join-Pfade und ‑Beziehungen einfügen. So kann der KI-Agent besser nachvollziehen, wie Tabellen interagieren.
- Semantische Glossare strukturieren: Begriffe und Abkürzungen in Unternehmensglossaren standardisieren. Durch diese Standardisierung können Konversationstools unternehmensspezifische Synonyme und Messwerte präzise auflösen.
- Golden Queries veröffentlichen: Hängen Sie bestätigte Abfragen in natürlicher Sprache und die entsprechenden korrekten SQL-Äquivalente direkt an Knowledge Catalog-Einträge an. Wenn Sie die Argumentation auf diesen geprüften Vorlagen basieren, vermeiden Sie SQL-Konvertierungsfehler in Text-zu-SQL-Agents.
Von Dataplex Universal Catalog auf Knowledge Catalog umstellen
Dataplex Universal Catalog wurde zu Knowledge Catalog weiterentwickelt. Weitere Informationen zu dieser Umstellung finden Sie unter Von Dataplex Universal Catalog zu Knowledge Catalog umstellen.
Beschränkungen
Beachten Sie bei der Planung der Bereitstellung die folgenden Einschränkungen:
Unterstützte Integrationen: Der Knowledge Catalog unterstützt zwar wichtige Drittanbietersysteme, bestimmte automatisierte semantische Extraktionen sind jedoch möglicherweise auf integrierte Google Cloud Dienste beschränkt.
Kontingentlimits Für Vorgänge zum Abrufen von Kontext und zum Extrahieren von Metadaten gelten die Standardkontingente für die Google Cloud API.
Nächste Schritte
Datenkontext
Erfahren Sie, wie aktiver Kontext passive Metadaten in Informationen umwandelt, die KI-Agenten als Grundlage dienen und Halluzinationen verhindern.
Grundlegenden Datenkontext schaffen
Erstellen Sie ein Unternehmensglossar, definieren Sie benutzerdefinierte Aspekttypen und reichern Sie Assets in BigQuery an.
KI-Agenten mit MCP verknüpfen
KI-Agenten und Entwicklertools über das Model Context Protocol mit dem Knowledge Catalog verbinden
Nach Ressourcen suchen
Katalogressourcen in Google Cloud und in Drittanbietersystemen in natürlicher Sprache finden und untersuchen.
Datenqualitätsscans automatisieren
Mit automatisierten Qualitätsscans können Sie Validierungsregeln definieren und die Datenreinheit in Tabellen überwachen.
Interaktive Anwendungsfälle ansehen
Sie lernen praxisnahe Lösungen für Kontextanreicherung, Datenherkunft und agentische Workflows kennen.