


Ce document explique comment interroger et analyser vos données de journaux à l'aide de l'Analyse de l'observabilité, qui fournit une interface de requête basée sur SQL. En utilisant SQL, vous pouvez effectuer des tâches telles que compter les entrées de journal avec un champ correspondant à un modèle. Analyse de l'observabilité fournit un éditeur SQL et un système basé sur des menus pour créer des requêtes. Pour afficher les résultats de votre requête, vous pouvez utiliser le format tabulaire ou visualiser les données sous forme de graphique. Vous pouvez enregistrer vos graphiques dans vos tableaux de bord personnalisés.
Vous pouvez interroger une vue de journaux sur un bucket de journaux ou une vue d'analyse. Lorsque vous interrogez une vue de journal, le schéma correspond à celui de la structure de données LogEntry.
Étant donné que le créateur d'une vue d'analyse détermine le schéma, l'un des cas d'utilisation des vues d'analyse consiste à transformer les données de journal du format LogEntry dans un format qui vous convient mieux.
Vous pouvez également utiliser l'Analyse de l'observabilité pour interroger vos données de trace. Pour en savoir plus, consultez Interroger et analyser des traces.
L'analyse de l'observabilité ne déduplique pas les entrées de journal, ce qui peut affecter la façon dont vous écrivez vos requêtes. De plus, l'utilisation de l'analyse de l'observabilité est soumise à certaines restrictions. Pour en savoir plus sur ces sujets, consultez les documents suivants :
- Dépannage : Mes résultats d'Analyse de l'observabilité contiennent des entrées de journal en double.
- Analyse de l'observabilité : restrictions.
À propos des ensembles de données BigQuery associés
Vous n'avez pas besoin d'un ensemble de données BigQuery associé lorsque vous souhaitez interroger vos données de journaux, ou vos données de journaux et de traces. Dans ce cas, vous pouvez utiliser la page Analyse de l'observabilité. Vous pouvez également enregistrer et partager vos requêtes, et enregistrer la requête dans un tableau de bord personnalisé. Pour en savoir plus sur l'interrogation de vos données de trace, consultez Interroger et analyser des traces.
Vous avez besoin d'un ensemble de données BigQuery associé lorsque vous souhaitez effectuer l'une des opérations suivantes :
- Joindre les données des entrée de journal à d'autres ensembles de données BigQuery.
- Interrogez les données de journal à partir d'un autre service, comme la page BigQuery Studio ou Data Studio.
- Exécutez des requêtes à partir de l'analyse de l'observabilité sur le moteur BigQuery à l'aide d'emplacements à la demande ou d'emplacements réservés BigQuery.
- Créez une règle d'alerte qui surveille le résultat d'une requête SQL. Pour en savoir plus, consultez Surveiller les résultats de vos requêtes SQL avec une règle d'alerte.
Si vous choisissez de créer un ensemble de données BigQuery associé sur un bucket de journaux, vous étendez la limite de sécurité de vos données de journaux pour inclure les services BigQuery. En d'autres termes, les services BigQuery peuvent désormais interroger vos données de journal en envoyant une requête à l'ensemble de données BigQuery associé. Avant de créer un ensemble de données BigQuery associé, nous vous recommandons de consulter Sécurité des données avec Analyse de l'observabilité.
Avant de commencer
Cette section décrit les étapes à suivre avant de pouvoir utiliser l'analyse de l'observabilité.
Configurer des buckets de journaux
Assurez-vous que vos buckets de journaux ont été mis à niveau pour utiliser l'Analyse de l'observabilité :
-
Dans la console Google Cloud , accédez à la page Stockage des journaux :
Accéder à la page Stockage des journaux
Si vous utilisez la barre de recherche pour trouver cette page, sélectionnez le résultat dont le sous-titre est Logging.
- Pour chaque bucket de journaux contenant une vue de journaux que vous souhaitez interroger, assurez-vous que la colonne Analyse de l'observabilité disponible affiche Ouvrir. Si l'option Mettre à niveau s'affiche, cliquez dessus et suivez les instructions de la boîte de dialogue.
Configurer les rôles et les autorisations IAM
Cette section décrit les rôles ou les autorisations IAM requis pour utiliser l'analyse de l'observabilité :
-
Pour obtenir les autorisations nécessaires pour utiliser l'Analyse de l'observabilité et interroger les vues de journaux, demandez à votre administrateur de vous accorder les rôles IAM suivants sur votre projet :
-
Pour interroger les buckets de journaux
_Requiredet_Default: Visionneuse de journaux (roles/logging.viewer) -
Pour interroger toutes les vues de journaux d'un projet : Accesseur de vues de journaux (
roles/logging.viewAccessor)
Vous pouvez limiter l'accès d'un compte principal à une vue de journaux spécifique en ajoutant une condition IAM à l'attribution du rôle d'accesseur de vues de journaux au niveau du projet, ou en ajoutant une liaison IAM au fichier de stratégie de la vue de journaux. Pour en savoir plus, consultez Contrôler l'accès à une vue de journal.
Il s'agit des mêmes autorisations que celles dont vous avez besoin pour afficher les entrées de journal sur la page Explorateur de journaux. Pour en savoir plus sur les rôles supplémentaires dont vous avez besoin pour interroger des vues sur des buckets définis par l'utilisateur ou pour interroger la vue
_AllLogsdu bucket de journaux_Default, consultez Rôles Cloud Logging. -
Pour interroger les buckets de journaux
-
Pour obtenir les autorisations nécessaires pour interroger des vues d'analyse, demandez à votre administrateur de vous accorder le rôle IAM Utilisateur de l'analyse de l'observabilité (
roles/observability.analyticsUser) sur votre projet.
Interroger les données des journaux
Cette section décrit les approches que vous pouvez utiliser pour interroger vos données de journal :
- Chargez une requête définie par le système, modifiez-la, puis exécutez-la.
- Saisissez et exécutez une requête personnalisée. Par exemple, vous pouvez coller une requête que vous avez ou en écrire une. Les requêtes personnalisées peuvent inclure des jointures, des requêtes imbriquées et d'autres instructions SQL complexes. Pour obtenir des exemples, consultez Exemples de requêtes SQL.
- Créez une requête en sélectionnant des options dans le menu, puis exécutez-la. Analyse de l'observabilité convertit vos sélections en une requête SQL que vous pouvez afficher et modifier.
Charger, modifier et exécuter la requête définie par le système
-
Dans la console Google Cloud , accédez à la page manage_searchAnalyse de l'observabilité :
Accéder à Observability Analytics
Si vous utilisez la barre de recherche pour trouver cette page, sélectionnez le résultat dont le sous-titre est Logging.
Dans le menu Vues, accédez à la section Journaux ou Vues d'analyse, puis sélectionnez la vue que vous souhaitez interroger.
Pour trouver la vue à interroger, utilisez la barre de filtre filter_list ou faites défiler la liste :
- Les vues de journaux sont listées par
BUCKET_ID.LOG_VIEW_ID, où ces champs font référence aux ID du bucket de journaux et de la vue de journaux. - Les vues d'analyse sont listées par
LOCATION.ANALYTICS_VIEW_ID, où ces champs font référence à l'emplacement et à l'ID d'une vue d'analyse. Les vues d'analyse sont en version Preview publique.
- Les vues de journaux sont listées par
Effectuez l'une des opérations suivantes :
Pour charger une requête définie par le système qui repose sur le générateur de requêtes, qui vous permet de définir la requête à l'aide de sélections de menu, assurez-vous que le volet Requête affiche Générateur de requêtes. Si un éditeur SQL s'affiche, cliquez sur tune Générateur.
Pour charger une requête définie par le système qui extrait des valeurs JSON, assurez-vous que le volet Requête affiche l'éditeur SQL. Si ce volet affiche Générateur de requêtes, cliquez sur code SQL.
Dans le volet Schéma, sélectionnez Requête, puis cliquez sur Écraser.
Le volet Requête affiche une requête définie par le système. Si vous avez sélectionné le mode Générateur de requêtes, mais que vous souhaitez afficher la requête SQL, cliquez sur code SQL.
Facultatif : modifiez la requête.
Pour exécuter la requête, accédez à la barre d'outils et sélectionnez Exécuter la requête.
Analyse de l'observabilité présente les résultats de la requête dans un tableau. Toutefois, vous pouvez créer un graphique, et enregistrer le tableau ou le graphique dans un tableau de bord personnalisé. Pour en savoir plus, consultez Créer un graphique à partir des résultats d'une requête SQL.
Si la barre d'outils affiche Exécuter dans BigQuery, vous devez configurer l'Analyse de l'observabilité pour qu'elle utilise le moteur de requête par défaut. Pour effectuer cette modification, dans la barre d'outils du volet Requête, cliquez sur settings Paramètres, puis sélectionnez Analytics (par défaut).
Saisir et exécuter une requête personnalisée
Pour saisir une requête SQL, procédez comme suit :
-
Dans la console Google Cloud , accédez à la page manage_searchAnalyse de l'observabilité :
Accéder à Observability Analytics
Si vous utilisez la barre de recherche pour trouver cette page, sélectionnez le résultat dont le sous-titre est Logging.
Dans le volet Requête, cliquez sur code SQL.
Pour spécifier une période, nous vous recommandons d'utiliser le sélecteur de période. Si vous ajoutez une clause
WHEREqui spécifie le champtimestamp, cette valeur remplace le paramètre du sélecteur de période, et ce sélecteur est désactivé.Pour obtenir des exemples, consultez Exemples de requêtes SQL.
Vous pouvez interroger des vues de journaux ou des vues d'analyse. Utilisez le format suivant pour la clause
FROM:- Vues de journaux :
FROM `PROJECT_ID.LOCATION.BUCKET_ID.LOG_VIEW_ID`
- Vues Analytics :
FROM `analytics_view.PROJECT_ID.LOCATION.ANALYTICS_VIEW_ID`
Les champs des expressions précédentes ont la signification suivante :
- PROJECT_ID : identifiant du projet.
- LOCATION : emplacement de la vue de journaux ou de la vue d'analyse.
- BUCKET_ID : nom ou ID du bucket de journaux.
- LOG_VIEW_ID : identifiant de la vue de journal, limité à 100 caractères et ne pouvant inclure que des lettres, des chiffres, des traits de soulignement et des traits d'union.
- ANALYTICS_VIEW_ID : ID de la vue d'analyse, limité à 100 caractères et ne pouvant inclure que des lettres, des chiffres, des traits de soulignement et des traits d'union.
Si le volet de requête affiche un message d'erreur faisant référence à l'instruction
FROM, cela signifie que la vue est introuvable. Pour en savoir plus sur la résolution de ce problème, consultez Erreur : la clauseFROMdoit contenir exactement une vue de journal.- Vues de journaux :
Pour exécuter la requête, accédez à la barre d'outils et sélectionnez Exécuter la requête.
Analyse de l'observabilité présente les résultats de la requête dans un tableau. Toutefois, vous pouvez créer un graphique, et enregistrer le tableau ou le graphique dans un tableau de bord personnalisé. Pour en savoir plus, consultez Créer un graphique à partir des résultats d'une requête SQL.
Si la barre d'outils affiche Exécuter dans BigQuery, vous devez configurer l'Analyse de l'observabilité pour qu'elle utilise le moteur de requête par défaut. Pour effectuer cette modification, dans la barre d'outils du volet Requête, cliquez sur settings Paramètres, puis sélectionnez Analytics (par défaut).
Créer, modifier et exécuter une requête
L'interface du générateur de requêtes vous permet de créer une requête en effectuant des sélections dans des menus. Analyse de l'observabilité convertit vos sélections en une requête SQL que vous pouvez afficher et modifier. Par exemple, vous pouvez commencer par utiliser l'interface du générateur de requêtes, puis passer à l'éditeur SQL pour affiner votre requête.
L'Analyse de l'observabilité peut toujours convertir vos sélections de menu de l'interface du générateur de requêtes en requête SQL. Cependant, toutes les requêtes SQL ne peuvent pas être représentées par l'interface du générateur de requêtes. Par exemple, les requêtes avec des jointures ne peuvent pas être représentées par cette interface.
Pour créer une requête, procédez comme suit :
-
Dans la console Google Cloud , accédez à la page manage_searchAnalyse de l'observabilité :
Accéder à Observability Analytics
Si vous utilisez la barre de recherche pour trouver cette page, sélectionnez le résultat dont le sous-titre est Logging.
Si le volet Requête affiche un éditeur SQL, sélectionnez tune Générateur, ce qui ouvre le volet Générateur de requêtes.
Utilisez le menu Source pour sélectionner la vue que vous souhaitez interroger. Vos sélections sont mappées à la clause
FROMdans la requête SQL.Facultatif : Utilisez les menus suivants pour limiter ou mettre en forme la table de résultats :
Rechercher dans tous les champs : recherchez des chaînes correspondantes. Vos sélections sont mappées à la clause
WHEREdans la requête SQL.Colonnes : sélectionnez les colonnes qui s'affichent dans le tableau des résultats. Vos sélections sont mappées aux clauses
SELECTde la requête SQL.Lorsque vous sélectionnez un nom de champ dans ce menu, une boîte de dialogue s'ouvre. Dans cette boîte de dialogue, vous pouvez effectuer les opérations suivantes :
Utilisez le menu pour agréger ou regrouper vos données.
Pour éviter les erreurs de syntaxe, toute agrégation et tout regroupement que vous appliquez à une colonne sont automatiquement appliqués aux autres colonnes. Pour obtenir un exemple d'agrégation et de regroupement d'entrées, consultez Regrouper et agréger des données à l'aide du générateur de requêtes.
Convertit une valeur de n'importe quel type en un autre type de données spécifié. Pour en savoir plus, consultez la documentation
CAST.Extrayez une sous-chaîne de valeurs à l'aide d'expressions régulières. Pour en savoir plus, consultez la documentation
REGEXP_EXTRACT.
Filtres : ajoutez des filtres lorsque vous souhaitez limiter la requête aux segments contenant un attribut ou un ID de segment spécifique. Le menu liste toutes les options de filtre disponibles. Vos sélections sont mappées à la clause
WHEREdans la requête SQL.Trier par : définissez les colonnes à trier et indiquez si le tri est croissant ou décroissant. Vos sélections sont mappées à la clause
ORDER BYdans la requête SQL.Limite : définissez le nombre maximal de lignes dans la table de résultats. Vos sélections sont mappées à la clause
LIMITdans la requête SQL.
Pour exécuter la requête, accédez à la barre d'outils et sélectionnez Exécuter la requête.
Analyse de l'observabilité présente les résultats de la requête dans un tableau. Toutefois, vous pouvez créer un graphique, et enregistrer le tableau ou le graphique dans un tableau de bord personnalisé. Pour en savoir plus, consultez Créer un graphique à partir des résultats d'une requête SQL.
Si la barre d'outils affiche Exécuter dans BigQuery, vous devez configurer l'Analyse de l'observabilité pour qu'elle utilise le moteur de requête par défaut. Pour effectuer cette modification, dans la barre d'outils du volet Requête, cliquez sur settings Paramètres, puis sélectionnez Analytics (par défaut).
Exemple : Regrouper et agréger des données à l'aide du générateur de requêtes
Lorsque vous sélectionnez une colonne dans le générateur de requêtes, chaque champ inclut un menu dans lequel vous pouvez ajouter un regroupement et une agrégation. Le regroupement vous permet d'organiser vos données en groupes en fonction de la valeur d'une ou de plusieurs colonnes, et l'agrégation vous permet d'effectuer des calculs sur ces groupes pour renvoyer une seule valeur.
Chaque champ que vous sélectionnez dans l'élément Colonnes est associé à un menu contenant les options suivantes :
- Aucun : ne pas regrouper ni agréger par ce champ.
- Agrégation : regroupe les champs listés dans l'élément Colonnes, sauf si le champ comporte une sélection Agrégation. Pour ces champs, calculez la valeur en effectuant une opération sur toutes les entrées de chaque regroupement. L'opération peut consister à calculer la moyenne d'un champ ou à compter le nombre d'entrées dans chaque regroupement.
- Critère de regroupement : regroupe les entrées par tous les champs listés dans l'élément Columns.
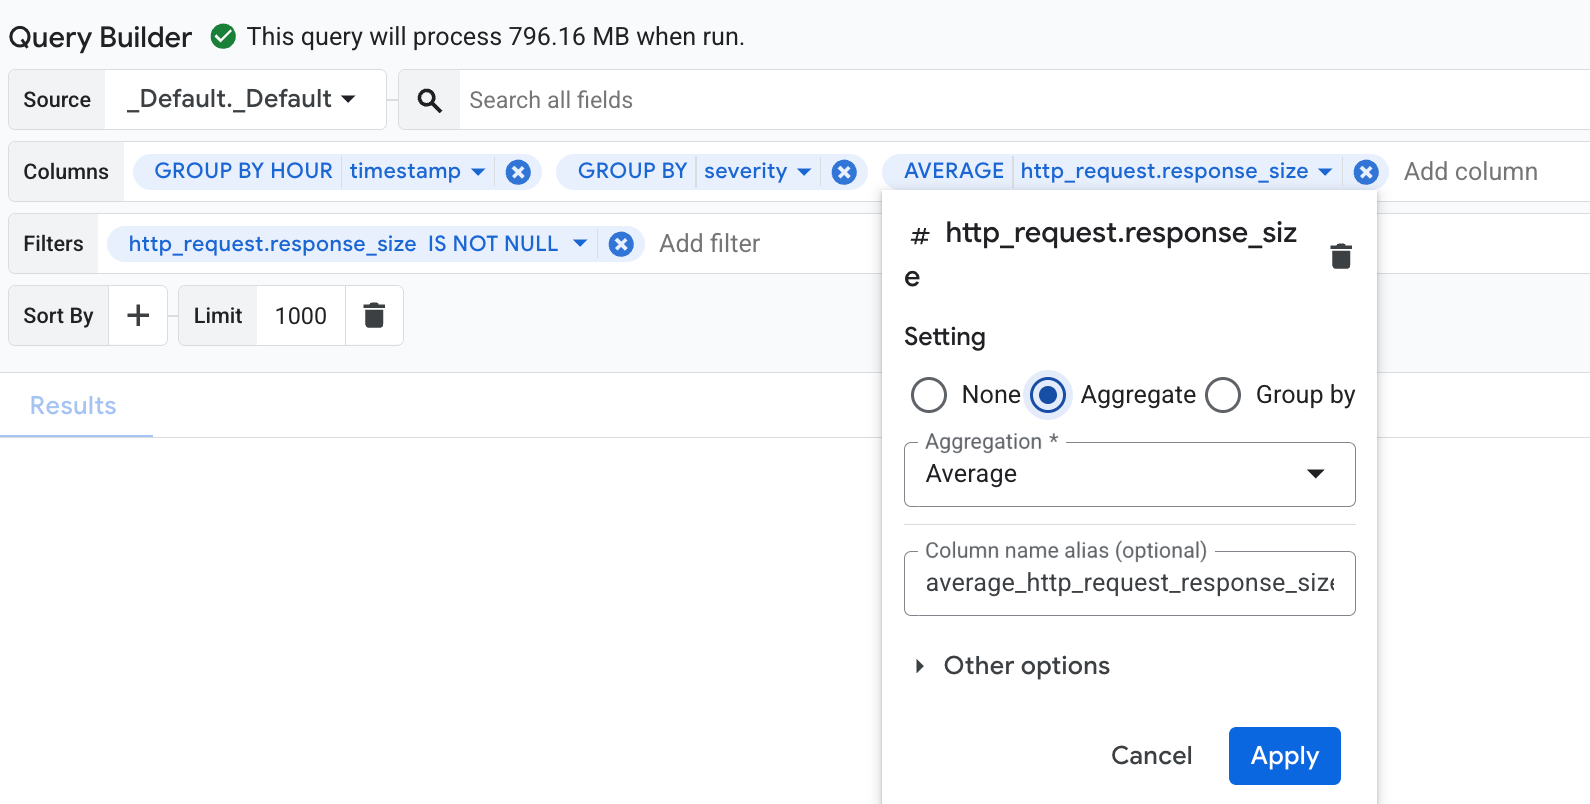
Cet exemple montre comment utiliser le générateur de requêtes pour regrouper les entrées de journal par gravité et par code temporel, puis calculer la moyenne du champ http_request.response_size pour chaque groupe :
Dans le menu Colonnes, sélectionnez les champs
timestamp,severityethttp_request.response_size.Pour regrouper vos données, cliquez sur le champ
timestamppour ouvrir la boîte de dialogue des paramètres. Dans cette boîte de dialogue, sélectionnez l'option Critère de regroupement, puis définissez la Précision de la troncature surHOUR. Le regroupement est ensuite automatiquement appliqué à tous les autres champs pour éviter les erreurs de syntaxe. Si des champs non valides ne permettent pas d'appliquer le regroupement, un message d'erreur s'affiche. Supprimez les champs non valides du menu pour résoudre cette erreur.Pour effectuer une agrégation sur le champ
http_request.response_size, cliquez sur le champ pour ouvrir la boîte de dialogue des paramètres. Dans cette boîte de dialogue, sélectionnez Agrégat. Dans le menu Agrégation, cliquez sur Moyenne.
Dans le menu Filtres, ajoutez
http_request.response_sizeet définissez le comparateur surIS NOT NULL. Ce filtre correspond aux entrées de journal contenant une valeurresponse_size.Les menus du Générateur de requêtes ressemblent à ceci :
Pour exécuter la requête, accédez à la barre d'outils et sélectionnez Exécuter la requête.
Le résultat de cette requête se présente comme suit :
+-----------------------------------+----------+---------------+
| Row | hour_timestamp              | severity | response_size |
|     | TIMESTAMP                   | STRING   | INTEGER       |
+-----+-----------------------------+----------+---------------+
| 1   | 2025-10-06 16:00:00.000 UTC | NOTICE   | 3082          |
| 2   | 2025-10-06 17:00:00.000 UTC | WARNING  | 338           |
| 3   | 2025-10-06 16:00:00.000 UTC | INFO     | 149           |
La requête SQL correspondante pour l'exemple précédent est la suivante :
SELECT
  -- Truncate the timestamp by hour.
  TIMESTAMP_TRUNC( timestamp, HOUR ) AS hour_timestamp,
  severity,
  -- Compute average response_size.
  AVG( http_request.response_size ) AS average_http_request_response_size
FROM
  `PROJECT_ID.LOCATION.BUCKET_ID.LOG_VIEW_ID`
WHERE
  -- Matches log entries that have a response_size.
  http_request.response_size IS NOT NULL
GROUP BY
  -- Group log entries by timestamp and severity.
  TIMESTAMP_TRUNC( timestamp, HOUR ),
  severity
LIMIT
  1000
Afficher le schéma
Le schéma définit la façon dont les données sont stockées, ce qui inclut les champs et leurs types de données. Ces informations sont importantes, car le schéma détermine les champs que vous interrogez et si vous devez caster des champs vers différents types de données. Par exemple, pour écrire une requête qui calcule la latence moyenne des requêtes HTTP, vous devez savoir comment accéder au champ de latence et s'il est stocké sous forme d'entier (100) ou de chaîne ("100"). Si les données de latence sont stockées sous forme de chaîne, la requête doit caster la valeur en valeur numérique avant de calculer une moyenne.
Pour identifier le schéma, procédez comme suit :
-
Dans la console Google Cloud , accédez à la page manage_searchAnalyse de l'observabilité :
Accéder à Observability Analytics
Si vous utilisez la barre de recherche pour trouver cette page, sélectionnez le résultat dont le sous-titre est Logging.
Dans le menu Vues, accédez à la section Journaux ou Vues d'analyse, puis sélectionnez la vue que vous souhaitez interroger.
Le volet Schéma est mis à jour. L'analyse de l'observabilité déduit automatiquement les champs d'une colonne lorsque le type de données est JSON. Pour voir à quelle fréquence ces champs inférés apparaissent dans vos données, cliquez sur more_vert Options, puis sélectionnez Afficher les informations et la description.
Pour les vues de journaux, le schéma est fixe et correspond à
LogEntry. Pour les vues d'analyse, vous pouvez modifier la requête SQL pour changer le schéma.