


La protection des données sensibles inclut différents types de méthodes que vous pouvez utiliser pour inspecter, transformer (anonymiser), découvrir et classer des données. Ces méthodes vous permettent d'analyser les données sur Google Cloud et en dehors, et d'optimiser le comportement de Sensitive Data Protection pour différents types de charges de travail.
Sensitive Data Protection propose les types de méthodes suivants :
Méthodes d'inspection et d'anonymisation
Cette section décrit les méthodes que vous pouvez utiliser pour localiser et, éventuellement, anonymiser chaque élément de données correspondant à un type d'informations répertorié dans votre configuration d'inspection.
Méthodes de contenu
Les méthodes de contenu sont des méthodes synchrones et sans état. Les données à inspecter ou à transformer sont envoyées directement dans la requête adressée à l'API DLP. Les résultats de l'inspection de Sensitive Data Protection ou les données transformées sont renvoyés dans la réponse de l'API. Les données de la requête sont chiffrées en transit et ne sont pas stockées.
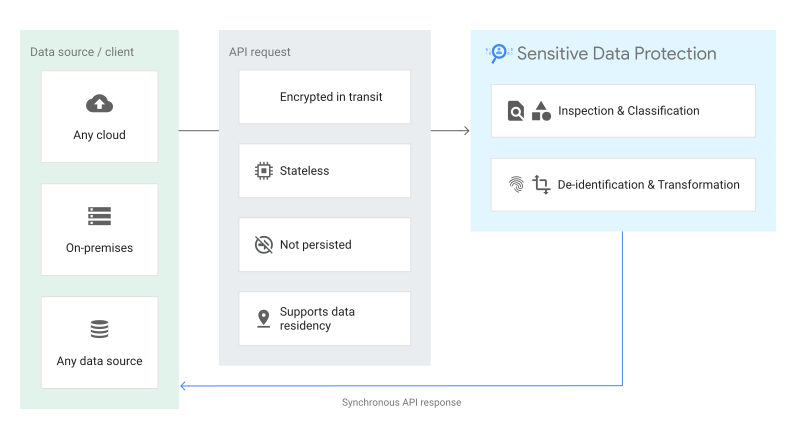
Quand utiliser les méthodes de contenu
Voici quelques cas d'utilisation courants :
- Inspecter les entrées utilisateur en temps réel : analysez les champs de formulaire, les messages de chat ou les commentaires de manière synchrone dans les applications Web et mobiles avant de stocker les données dans des bases de données.
- Masquer le texte sensible avant le traitement externe : anonymisez ou masquez les jetons sensibles des chaînes de texte de manière synchrone avant de transmettre le contenu à des API tierces ou à des grands modèles de langage (LLM).
- Masquer les données sensibles des images importées : masquez le texte sensible dans les formats d'image (tels que JPEG, PNG ou BMP) en superposant des rectangles opaques sur les informations permettant d'identifier personnellement l'utilisateur détectées avant d'afficher ou de stocker l'image.
- Désanonymiser les données tokenisées à la demande : détokenisez les jetons précédemment pseudonymisés dans les workflows côté serveur autorisés lorsqu'un utilisateur professionnel authentifié doit accéder au texte brut d'origine.
- Valider la confidentialité des données dans les applications côté client : exécutez des vérifications de confidentialité sans état sur les points de terminaison sans provisionner de dépôts de stockage cloud ni configurer d'infrastructure de job backend.
Pour en savoir plus, consultez la documentation de référence de l'API REST concernant les méthodes de contenu :
Méthodes de stockage
Les méthodes de stockage sont conçues pour inspecter les données stockées sur Google Cloud dans des systèmes tels que Cloud Storage, BigQuery et Firestore en mode Datastore (Datastore). Pour activer l'inspection du stockage, vous devez créer un job Sensitive Data Protection à l'aide de la ressource dlpJobs. Chaque job s'exécute en tant que service géré pour inspecter les données, puis effectuer des actions de Sensitive Data Protection, telles que l'enregistrement ou la publication des résultats. En plus de ces actions facultatives, Sensitive Data Protection crée et stocke des détails sur le job, y compris l'état du job, les octets analysés et les résultats récapitulatifs par infoType. Vous pouvez gérer les jobs à l'aide de l'API DLP ou de Sensitive Data Protection dans la consoleGoogle Cloud .

Quand utiliser les méthodes de stockage
Voici quelques cas d'utilisation courants :
- Analyser des tables analytiques à grande échelle : inspectez des ensembles de données à l'échelle du pétaoctet dans BigQuery à l'aide d'une analyse par lot distribuée et sans serveur.
- Auditer les dépôts de fichiers non structurés : inspectez les documents, les archives et les fichiers multimédias stockés dans des buckets Cloud Storage pour localiser les données sensibles non chiffrées ou mal placées.
- Suivre l'historique des résultats d'analyse et les tendances : conservez les résultats d'inspection détaillés directement dans des tables BigQuery pour suivre les résultats au fil du temps et générer des pistes d'audit de conformité.
- Déclenchez des workflows de correction basés sur des événements : diffusez les événements de fin d'analyse et les alertes de résultats à haut risque vers Pub/Sub pour lancer des playbooks de réponse de sécurité automatisés.
- Échantillonner de grands ensembles de données pour réduire les coûts : configurez des limites d'échantillonnage ou de lignes pour estimer la stratégie de gestion des risques liés aux données dans de grandes bases de données sans analyser l'intégralité des ensembles de données.
Pour en savoir plus, consultez la documentation de référence de l'API REST pour la ressource projects.dlpJobs. Vous spécifiez les détails de stockage dans l'objet StorageConfig.
Méthodes hybrides
Les méthodes hybrides sont un ensemble de méthodes d'API asynchrones qui vous permettent d'analyser les charges utiles de données envoyées depuis pratiquement n'importe quelle source pour détecter des informations sensibles et stocker les résultats dans Google Cloud. Les méthodes hybrides sont semblables aux méthodes de contenu, car les données que vous souhaitez inspecter sont incluses dans une ou plusieurs requêtes d'inspection. Toutefois, contrairement aux méthodes de contenu, les méthodes hybrides ne renvoient pas les résultats d'inspection dans la réponse de l'API. Au lieu de cela, les résultats de l'inspection sont traités de manière asynchrone côté serveur, puis ils sont tabulés et stockés d'une manière similaire aux méthodes de stockage.
Pour activer l'inspection hybride, vous devez créer un job Sensitive Data Protection à l'aide de la ressource dlpJobs. Chaque job hybride s'exécute en tant que service géré pour écouter les requêtes d'inspection et effectue des actions de Sensitive Data Protection, telles que l'enregistrement ou la publication des résultats. En plus de ces actions facultatives, Sensitive Data Protection crée et stocke des détails sur le job, y compris l'état du job, les octets analysés et un résumé des résultats par infoType. Vous pouvez gérer les jobs à l'aide de l'API DLP ou de Sensitive Data Protection dans la consoleGoogle Cloud .

Quand utiliser des méthodes hybrides
Voici quelques cas d'utilisation courants :
- Inspecter les données dans des environnements hybrides et multicloud : transmettez des données de bases de données sur site, de serveurs Bare Metal ou d'autres fournisseurs de services cloud à Sensitive Data Protection tout en centralisant les rapports de résultats dansGoogle Cloud.
- Auditer les pipelines de données d'applications personnalisées : envoyez des données en flux continu depuis des robots d'exploration, des microservices ou des pipelines ETL personnalisés vers Sensitive Data Protection sans gérer de parcs de nœuds de calcul d'analyseurs locaux.
- Nettoyer les charges de travail lors de la migration vers le cloud : inspectez et tokenisez en continu les éléments sensibles lors de la réplication de bases de données actives depuis des systèmes anciens vers Google Cloud.
- Centralisez les rapports de conformité multicloud : regroupez les résultats d'inspection de différents environnements d'exploitation dans un seul ensemble de données BigQuery pour une gouvernance unifiée.
- Traiter des types de fichiers personnalisés et des formats propriétaires : extrayez le texte côté client à partir de formats binaires propriétaires et diffusez les charges utiles extraites vers Sensitive Data Protection pour inspection.
Pour en savoir plus, consultez la documentation de référence de l'API REST pour la ressource projects.dlpJobs. Vous spécifiez la source de données dans le champ hybridOptions de l'objet StorageConfig.
Méthodes de découverte
Les méthodes de découverte vous permettent de configurer la découverte des données sensibles pour générer des profils de données. Les profils de données fournissent des insights qui vous aident à déterminer où se trouvent les données sensibles dans votre organisation, quel type de données sensibles vous stockez et si des contrôles d'accès sont en place pour ces données.
Vous pouvez configurer la détection pour analyser les données stockées sur Google Cloud dans des datastores tels que BigQuery, Cloud SQL, Cloud Storage et Vertex AI. Si vous avez activé Security Command Center Enterprise, vous pouvez également utiliser Sensitive Data Protection pour analyser les données d'autres fournisseurs de services cloud.
Vous pouvez spécifier les actions que vous souhaitez que Sensitive Data Protection effectue après chaque analyse de découverte. Par exemple, vous pouvez envoyer les résultats d'analyse à d'autres servicesGoogle Cloud , comme Security Command Center et Google Security Operations, pour améliorer la visibilité sur la stratégie de sécurité des données de votre organisation. Vous pouvez configurer le service de découverte pour taguer vos ressources profilées afin d'accorder ou de refuser automatiquement l'accès IAM à ces ressources. Vous pouvez également exporter les profils de données vers BigQuery. Vous pouvez connecter les profils exportés à Data Studio pour afficher le rapport prédéfini. Vous pouvez également créer vos propres requêtes et rapports personnalisés.
Pour activer la découverte, vous devez créer une ressource DiscoveryConfig. La découverte s'exécute en fonction du champ d'application et de la fréquence que vous définissez dans la configuration de découverte. Pour savoir où Sensitive Data Protection stocke les profils générés, consultez Considérations sur la résidence des données.
Vous pouvez gérer les configurations de découverte, les profils de données et les connexions Cloud SQL à l'aide de l'API DLP ou de la consoleGoogle Cloud .

Quand utiliser les méthodes de découverte
Voici quelques cas d'utilisation courants :
- Automatisez la découverte des données à l'échelle de l'organisation : analysez et profilez en continu tous les éléments de données dans BigQuery, Cloud SQL et Cloud Storage sans avoir à écrire de jobs d'analyse ni de planifications individuels.
- Identifier les dépôts de données à haut risque : générez des scores de risque et de sensibilité des données pour les tables et les buckets afin de prioriser les initiatives de protection et de gouvernance des données.
- Appliquer des contrôles d'accès dynamiques avec des tags de données : ajoutez automatiquement des tags aux ressources profilées en fonction des infoTypes découverts pour accorder ou restreindre l'accès à l'aide de stratégies Identity and Access Management.
- Alimenter la gestion de la stratégie de sécurité des données : envoyez des insights de profil de découverte à Security Command Center et à Google Security Operations pour mettre en corrélation les risques liés aux données avec les menaces pesant sur l'infrastructure.
- Visualisez la stratégie de conformité à l'aide de tableaux de bord exécutifs : exportez des profils de données vers BigQuery et connectez des tableaux de bord Data Studio prédéfinis pour surveiller la distribution des données sensibles dans l'organisation, les dossiers et les projets.
Pour en savoir plus, consultez la documentation de référence de l'API REST pour les éléments suivants :
Configurations de découverte
Connexions
Les connexions ne concernent que la découverte pour Cloud SQL.
Profils de données
organizations.locations.projectDataProfilesprojects.locations.projectDataProfilesorganizations.locations.fileStoreDataProfilesprojects.locations.fileStoreDataProfilesorganizations.locations.tableDataProfilesprojects.locations.tableDataProfilesorganizations.locations.columnDataProfilesprojects.locations.columnDataProfiles
Étapes suivantes
- Consultez les guides d'utilisation pour découvrir comment inspecter du texte et des images, ainsi que masquer les données sensibles détectées.
- Pour en savoir plus sur l'inspection du stockage et l'utilisation des actions, consultez la page Inspecter le stockage et les bases de données pour identifier les données sensibles.
- Pour en savoir plus sur la découverte de données sensibles, consultez Profils de données.
- Consultez les tarifs.