


Pseudonimisasi adalah teknik de-identifikasi yang mengganti nilai data sensitif dengan token yang dihasilkan secara kriptografis. Pseudonimisasi banyak digunakan dalam industri seperti keuangan dan layanan kesehatan untuk membantu mengurangi risiko data yang digunakan, mempersempit cakupan kepatuhan, dan meminimalkan eksposur data sensitif ke sistem sekaligus mempertahankan utilitas dan akurasi data.
Sensitive Data Protection mendukung tiga teknik pseudonimisasi de-identifikasi, dan menghasilkan token dengan menerapkan salah satu dari tiga metode transformasi kriptografis ke nilai data sensitif asli. Setiap nilai sensitif asli kemudian diganti dengan token yang sesuai. Pseudonimisasi terkadang disebut sebagai tokenisasi atau penggantian surrogate.
Teknik pseudonimisasi memungkinkan token satu arah atau dua arah. Token satu arah telah diubah secara permanen, sedangkan token dua arah dapat dibalik. Karena token dibuat menggunakan enkripsi simetris, kunci kriptografis yang sama yang dapat menghasilkan token baru juga dapat membalikkan token. Untuk situasi yang tidak memerlukan reversibilitas, Anda dapat menggunakan token satu arah yang menggunakan mekanisme hashing yang aman.
Penting untuk memahami bagaimana pseudonimisasi dapat membantu melindungi data sensitif sekaligus memungkinkan operasi bisnis dan alur kerja analisis Anda mengakses dan menggunakan data yang diperlukan dengan mudah. Topik ini membahas konsep pseudonimisasi dan tiga metode kriptografi untuk mentransformasi data yang didukung oleh Sensitive Data Protection.
Untuk mengetahui petunjuk tentang cara menerapkan metode pseudonimisasi ini dan contoh penggunaan Sensitive Data Protection lainnya, lihat Melakukan de-identifikasi data sensitif.
Kapan harus menggunakan pseudonimisasi
Berikut adalah beberapa kasus penggunaan umum:
- Mempertahankan integritas referensial di seluruh set data analisis: Ganti ID pelanggan dan kunci utama dengan token kriptografis yang konsisten sehingga tim dapat menggabungkan dan mengagregasi tabel di BigQuery tanpa mengekspos ID sensitif.
- Mengurangi cakupan kepatuhan dan audit: Ganti nomor kartu kredit dan informasi identitas pribadi (PII) dengan token yang mempertahankan format untuk mempersempit batas kepatuhan PCI DSS atau HIPAA di aplikasi downstream.
- Melindungi lingkungan pengujian dan pengembangan: Mereplikasi database produksi ke lingkungan pengembangan tingkat lebih rendah dengan kolom yang ditokenisasi. Pendekatan ini memungkinkan developer menguji aplikasi dengan struktur data yang realistis tanpa mengakses data pelanggan yang sebenarnya.
- Aktifkan reversibilitas yang aman untuk alur kerja yang diizinkan: Gunakan enkripsi dua arah (seperti AES-SIV atau FPE) dengan kunci yang disimpan di Cloud Key Management Service sehingga hanya layanan backend yang diautentikasi dan memiliki hak istimewa yang dapat melakukan de-tokenisasi nilai asli jika diwajibkan secara hukum.
- Menerapkan penyamaran data yang tidak dapat dibatalkan dengan hashing kriptografis: Buat ringkasan HMAC-SHA-256 satu arah. Metode ini cocok jika korelasi lintas data diperlukan untuk analisis statistik, tetapi pemulihan teks biasa asli harus tetap tidak dapat dilakukan secara komputasi.
Metode kriptografis yang didukung di Sensitive Data Protection
Sensitive Data Protection mendukung tiga teknik pseudonimisasi, yang semuanya menggunakan kunci kriptografis. Berikut adalah metode yang tersedia:
- Enkripsi deterministik menggunakan AES-SIV: Nilai input diganti dengan nilai yang telah dienkripsi menggunakan algoritma enkripsi AES-SIV dengan kunci kriptografis, dienkode menggunakan base64, lalu ditambahkan dengan anotasi surrogate, jika ditentukan. Metode ini menghasilkan nilai hash, sehingga tidak mempertahankan himpunan karakter atau panjang nilai input. Nilai yang dienkripsi dan di-hash dapat diidentifikasi ulang menggunakan kunci kriptografi asli dan seluruh nilai output, termasuk anotasi pengganti. Pelajari lebih lanjut format nilai yang ditokenisasi menggunakan enkripsi AES-SIV.
- Enkripsi yang mempertahankan format: Nilai input diganti dengan nilai yang telah dienkripsi menggunakan algoritma enkripsi FPE-FFX dengan kunci kriptografis, lalu ditambahkan dengan anotasi pengganti, jika ditentukan. Secara desain, himpunan karakter dan panjang nilai input dipertahankan dalam nilai output. Nilai terenkripsi dapat diidentifikasi ulang menggunakan kunci kriptografis asli dan seluruh nilai output, termasuk anotasi surrogate. (Untuk beberapa pertimbangan penting seputar penggunaan metode enkripsi ini, lihat Enkripsi yang mempertahankan format nanti dalam topik ini.)
- Hashing kriptografis: Nilai input diganti dengan nilai yang telah dienkripsi dan di-hash menggunakan Hash-based Message Authentication Code (HMAC)-Secure Hash Algorithm (SHA)-256 pada nilai input dengan kunci kriptografis. Output transformasi yang di-hash selalu memiliki panjang yang sama dan tidak dapat diidentifikasi ulang. Pelajari lebih lanjut format nilai yang dijadikan token menggunakan hashing kriptografis.
Metode pseudonimisasi ini diringkas dalam tabel berikut. Baris tabel dijelaskan setelah tabel.
| Enkripsi deterministik menggunakan AES-SIV | Enkripsi dengan mempertahankan format | Hashing kriptografis | |
|---|---|---|---|
| Encryption type | AES-SIV | FPE-FFX | HMAC-SHA-256 |
| Nilai input yang didukung | Panjang minimal 1 karakter; tidak ada batasan himpunan karakter. | Panjang minimal 2 karakter; harus dienkode sebagai ASCII. | Harus berupa nilai string atau bilangan bulat. |
| Anotasi surrogate | Opsional. | Opsional. | T/A |
| Penyesuaian konteks | Opsional. | Opsional. | T/A |
| Himpunan karakter dan panjang dipertahankan | ✗ | ✓ | ✗ |
| Dapat dibalik | ✓ | ✓ | ✗ |
| Integritas referensial | ✓ | ✓ | ✓ |
- Jenis enkripsi: Jenis enkripsi yang digunakan dalam transformasi de-identifikasi.
- Nilai input yang didukung: Persyaratan minimum untuk nilai input.
- Anotasi surrogate: Anotasi yang ditentukan pengguna yang ditambahkan ke nilai terenkripsi untuk memberikan konteks kepada pengguna dan memberikan informasi untuk Sensitive Data Protection yang akan digunakan dalam mengidentifikasi ulang nilai yang dide-identifikasi. Anotasi pengganti diperlukan untuk identifikasi ulang data tidak terstruktur. Ini bersifat opsional saat mengubah kolom data terstruktur atau data tabulasi dengan
RecordTransformation. - Penyesuaian konteks: Referensi ke kolom data yang "menyesuaikan" nilai input
sehingga nilai input yang identik dapat dide-identifikasi ke nilai output
yang berbeda. Penyesuaian konteks bersifat opsional saat mengubah kolom
data terstruktur atau data tabulasi dengan
RecordTransformation. Untuk mempelajari lebih lanjut, lihat Menggunakan penyesuaian konteks. - Himpunan dan panjang karakter dipertahankan: Apakah nilai yang dide-identifikasi terdiri dari himpunan karakter yang sama dengan nilai aslinya, dan apakah panjang nilai yang dide-identifikasi cocok dengan nilai aslinya.
- Dapat dibalik: Dapat diidentifikasi ulang menggunakan kunci kriptografis, anotasi pengganti, dan penyesuaian konteks apa pun.
- Integritas referensial: Integritas referensial memungkinkan kumpulan data mempertahankan hubungannya satu sama lain bahkan setelah datanya dide-identifikasi satu per satu. Dengan kunci kripto dan penyesuaian konteks yang sama, tabel data akan diganti dengan bentuk yang di-obfuscate yang sama setiap kali diubah, yang memastikan bahwa koneksi antara nilai (dan, dengan data terstruktur, data) dipertahankan, bahkan di seluruh tabel.
Cara kerja tokenisasi di Sensitive Data Protection
Proses dasar tokenisasi sama untuk ketiga metode yang didukung oleh Sensitive Data Protection.
Langkah 1: Sensitive Data Protection memilih data yang akan dijadikan token. Cara paling umum untuk melakukannya adalah dengan menggunakan detektor infoType bawaan atau kustom untuk mencocokkan nilai data sensitif yang diinginkan. Jika Anda memindai data terstruktur (seperti tabel BigQuery), Anda juga dapat melakukan tokenisasi pada seluruh kolom data menggunakan transformasi data.
Untuk mengetahui informasi selengkapnya tentang dua kategori transformasi—transformasi infoType dan kumpulan data—lihat Transformasi de-identifikasi.
Langkah 2: Dengan menggunakan kunci kriptografis, Sensitive Data Protection mengenkripsi setiap nilai input. Anda dapat memberikan kunci ini dengan salah satu dari tiga cara berikut:
- Dengan menggabungkannya menggunakan Cloud Key Management Service (Cloud KMS). (Untuk keamanan maksimum, Cloud KMS adalah metode yang direkomendasikan.)
- Dengan menggunakan kunci sementara, yang dibuat oleh Sensitive Data Protection pada saat de-identifikasi, lalu dihapus. Kunci sementara hanya menjaga integritas per permintaan API. Jika Anda memerlukan integritas atau berencana untuk mengidentifikasi ulang data ini, jangan gunakan jenis kunci ini.
- Langsung dalam bentuk teks mentah. (Tidak direkomendasikan.)
Untuk mengetahui detail selengkapnya, lihat bagian Menggunakan kunci kriptografis, nanti dalam topik ini.
Langkah 3 (Hanya hashing kriptografis dan enkripsi deterministik dengan AES-SIV): Sensitive Data Protection mengenkode nilai terenkripsi menggunakan base64. Dengan hash kriptografis, nilai yang dienkode dan dienkripsi ini adalah token, dan prosesnya berlanjut ke Langkah 6. Dengan enkripsi deterministik menggunakan AES-SIV, nilai yang dienkode dan dienkripsi ini adalah nilai pengganti, yang hanya merupakan salah satu komponen token. Proses berlanjut dengan Langkah 4.
Langkah 4 (Hanya enkripsi deterministik dan mempertahankan format dengan AES-SIV):
Sensitive Data Protection menambahkan anotasi surrogate opsional ke nilai
yang dienkripsi. Anotasi surrogate membantu mengidentifikasi nilai surrogate terenkripsi dengan
menambahkan string deskriptif yang Anda tentukan di awal. Misalnya, tanpa
anotasi, Anda mungkin tidak dapat membedakan nomor telepon yang dide-identifikasi
dan nomor Jaminan Sosial atau nomor identifikasi lainnya yang dide-identifikasi. Selain itu,
untuk mengidentifikasi ulang nilai dalam data tidak terstruktur yang telah dide-identifikasi menggunakan
enkripsi yang mempertahankan format atau enkripsi deterministik, Anda harus
menentukan anotasi surrogate. (Anotasi surrogate tidak diperlukan saat
mentransformasi kolom data terstruktur atau tabel dengan
RecordTransformation.)
Langkah 5 (Enkripsi deterministik dan mempertahankan format dengan AES-SIV hanya untuk data terstruktur): Sensitive Data Protection dapat menggunakan konteks opsional dari kolom lain untuk "menyesuaikan" token yang dihasilkan. Hal ini memungkinkan Anda mengubah cakupan token. Misalnya, Anda memiliki database data kampanye pemasaran yang menyertakan alamat email dan Anda ingin membuat token unik untuk alamat email yang sama yang "disesuaikan" dengan ID kampanye. Hal ini akan memungkinkan seseorang menggabungkan data untuk pengguna yang sama dalam kampanye yang sama, tetapi tidak di berbagai kampanye yang berbeda. Jika penyesuaian konteks digunakan untuk membuat token, penyesuaian konteks ini juga diperlukan agar transformasi de-identifikasi dapat dibalik. Enkripsi deterministik dan yang mempertahankan format menggunakan AES-SIV mendukung konteks. Pelajari lebih lanjut cara menggunakan penyesuaian konteks.
Langkah 6: Sensitive Data Protection mengganti nilai asli dengan nilai yang dide-identifikasi.
Perbandingan nilai yang ditokenisasi
Bagian ini menunjukkan tampilan token standar setelah dide-identifikasi menggunakan masing-masing dari tiga metode yang dibahas dalam topik ini. Contoh nilai data sensitif adalah nomor telepon Amerika Utara (1-206-555-0123).
Enkripsi deterministik menggunakan AES-SIV
Dengan de-identifikasi menggunakan enkripsi deterministik dan AES-SIV, nilai input (dan, secara opsional, penyesuaian konteks yang ditentukan) dienkripsi menggunakan AES-SIV dengan kunci kriptografis, dienkode menggunakan base64, lalu secara opsional ditambahkan dengan anotasi surrogate, jika ditentukan. Metode ini tidak mempertahankan himpunan karakter (atau "alfabet") dari nilai input. Untuk menghasilkan output yang dapat dicetak, nilai yang dihasilkan dienkode dalam base64.
Token yang dihasilkan, dengan asumsi infoType surrogate telah ditentukan, akan dalam bentuk:
SURROGATE_INFOTYPE(SURROGATE_VALUE_LENGTH):SURROGATE_VALUE
Diagram yang dianotasi berikut menunjukkan contoh token—output dari operasi de-identifikasi menggunakan enkripsi deterministik dengan AES-SIV pada nilai 1-206-555-0123. InfoType surrogate opsional telah ditetapkan ke
NAM_PHONE_NUMB:
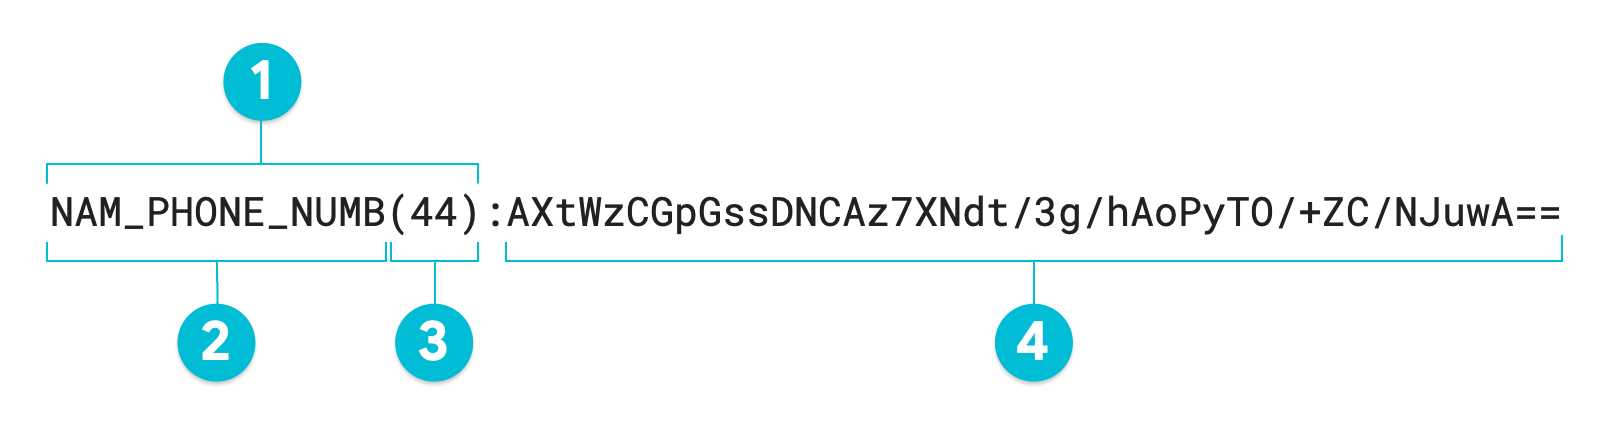
- Anotasi pengganti
- infoType pengganti (ditentukan oleh pengguna)
- Panjang karakter nilai yang diubah
- Nilai pengganti (yang diubah)
Jika Anda tidak menentukan anotasi pengganti, token yang dihasilkan akan sama dengan nilai yang diubah, atau #4 dalam diagram yang dianotasi. Untuk mengidentifikasi ulang
data tidak terstruktur, seluruh token ini diperlukan, termasuk anotasi
pengganti. Saat mengubah data terstruktur seperti tabel, anotasi pengganti bersifat opsional; Sensitive Data Protection dapat melakukan de-identifikasi dan re-identifikasi pada seluruh kolom menggunakan RecordTransformation tanpa anotasi pengganti.
Enkripsi dengan mempertahankan format
Dengan de-identifikasi menggunakan enkripsi yang mempertahankan format, nilai input (dan, secara opsional, penyesuaian konteks yang ditentukan) dienkripsi menggunakan mode FFX dari enkripsi yang mempertahankan format ("FPE-FFX") dengan kunci kriptografis, lalu secara opsional ditambahkan dengan anotasi surrogate, jika ditentukan.
Tidak seperti metode tokenisasi lain yang dijelaskan dalam topik ini, nilai surrogate output memiliki panjang yang sama dengan nilai input, dan tidak dienkode menggunakan base64. Anda menentukan himpunan karakter—atau "alfabet"—yang menyusun nilai terenkripsi. Ada tiga cara untuk menentukan alfabet yang akan digunakan Sensitive Data Protection dalam nilai output:
- Gunakan salah satu dari empat nilai enumerasi yang mewakili empat himpunan karakter/alfabet yang paling umum.
- Gunakan nilai radix, yang menentukan ukuran alfabet. Menentukan nilai radiks minimum
2akan menghasilkan alfabet yang hanya terdiri dari0dan1. Menentukan nilai radix maksimum95akan menghasilkan alfabet yang mencakup semua karakter numerik, karakter alfa huruf besar, karakter alfa huruf kecil, dan karakter simbol. - Buat alfabet dengan mencantumkan karakter yang tepat untuk digunakan. Misalnya,
menentukan
1234567890-*akan menghasilkan nilai pengganti yang hanya terdiri dari angka, tanda hubung, dan tanda bintang.
Tabel berikut mencantumkan empat himpunan karakter umum berdasarkan nilai enumerasi
(FfxCommonNativeAlphabet),
nilai radix, dan daftar karakter himpunan. Baris terakhir mencantumkan himpunan karakter lengkap, yang sesuai dengan nilai radiks maksimum.
| Nama alfabet/himpunan karakter | Radix | Daftar karakter |
|---|---|---|
NUMERIC |
10 |
0123456789 |
HEXADECIMAL |
16 |
0123456789ABCDEF |
UPPER_CASE_ALPHA_NUMERIC |
36 |
0123456789ABCDEFGHIJKLMNOPQRSTUVWXYZ |
ALPHA_NUMERIC |
62 |
0123456789ABCDEFGHIJKLMNOPQRSTUVWXYZabcdefghijklmnopqrstuvwxyz |
| - | 95 |
0123456789ABCDEFGHIJKLMNOPQRSTUVWXYZabcdefghijklmnopqrstuvwxyz~`!@#$%^&*()_-+={[}]|\:;"'<,>.?/ |
Token yang dihasilkan, dengan asumsi infoType surrogate telah ditentukan, dalam bentuk:
SURROGATE_INFOTYPE(SURROGATE_VALUE_LENGTH):SURROGATE_VALUE
Diagram yang dianotasi berikut adalah output dari operasi de-identifikasi Sensitive Data Protection menggunakan format preserving encryption pada nilai 1-206-555-0123 menggunakan radix 95. infoType pengganti opsional telah
ditetapkan ke NAM_PHONE_NUMB:

- Anotasi pengganti
- infoType pengganti (ditentukan oleh pengguna)
- Panjang karakter nilai yang diubah
- Nilai pengganti (yang diubah)—panjangnya sama dengan nilai input
Jika Anda tidak menentukan anotasi pengganti, token yang dihasilkan akan sama dengan nilai yang diubah, atau #4 dalam diagram yang dianotasi. Untuk mengidentifikasi ulang
data tidak terstruktur, seluruh token ini diperlukan, termasuk anotasi
pengganti. Saat mengubah data terstruktur seperti tabel, anotasi pengganti bersifat opsional; Sensitive Data Protection dapat melakukan de-identifikasi dan re-identifikasi pada seluruh kolom menggunakan RecordTransformation tanpa pengganti.
Hashing kriptografis
Dengan de-identifikasi menggunakan hashing kriptografis, nilai input di-hash menggunakan HMAC-SHA-256 dengan kunci kriptografis, lalu dienkode menggunakan base64. Nilai yang dide-identifikasi selalu memiliki panjang yang seragam, bergantung pada ukuran kunci.
Tidak seperti metode tokenisasi lain yang dibahas dalam topik ini, hashing kriptografis membuat token satu arah. Artinya, de-identifikasi menggunakan hashing kriptografis tidak dapat dibatalkan.
Berikut adalah output dari operasi de-identifikasi menggunakan hashing
kriptografis pada nilai 1-206-555-0123. Output ini adalah representasi berenkode base64
dari nilai yang di-hash:
XlTCv8h0GwrCZK+sS0T3Z8txByqnLLkkF4+TviXfeZY=
Menggunakan kunci kriptografis
Ada tiga opsi untuk kunci kriptografis yang dapat Anda gunakan dengan metode de-identifikasi kriptografis di Sensitive Data Protection:
Kunci kriptografis yang digabungkan Cloud KMS: Ini adalah jenis kunci kriptografis paling aman yang tersedia untuk digunakan dengan metode de-identifikasi Sensitive Data Protection. Kunci gabungan Cloud KMS terdiri dari kunci kriptografis 128, 192, atau 256 bit yang telah dienkripsi menggunakan kunci lain. Anda memberikan kunci kriptografis pertama, yang kemudian digabungkan menggunakan kunci kriptografis yang disimpan di Cloud Key Management Service. Jenis kunci ini disimpan di Cloud KMS untuk re-identifikasi nanti. Untuk mengetahui informasi selengkapnya tentang cara membuat dan menggabungkan kunci untuk tujuan de-identifikasi dan identifikasi ulang, lihat Panduan memulai: Melakukan de-identifikasi dan identifikasi ulang teks sensitif.
Kunci kriptografis sementara: Kunci kriptografis sementara dibuat oleh Sensitive Data Protection pada saat de-identifikasi, lalu dihapus. Oleh karena itu, jangan gunakan kunci kriptografis sementara dengan metode de-identifikasi kriptografis apa pun yang ingin Anda balikkan. Kunci kriptografis sementara hanya menjaga integritas per permintaan API. Jika Anda memerlukan integritas di lebih dari satu permintaan API atau berencana untuk mengidentifikasi ulang data Anda, jangan gunakan jenis kunci ini.
Kunci kriptografis yang tidak digabungkan: Kunci yang tidak digabungkan adalah kunci kriptografis 128, 192, atau 256 bit mentah berenkode base64 yang Anda berikan di dalam permintaan de-identifikasi ke DLP API. Anda bertanggung jawab untuk menjaga keamanan jenis kunci kriptografis ini untuk re-identifikasi nanti. Karena risiko kebocoran kunci yang tidak disengaja, jenis kunci ini tidak direkomendasikan. Kunci ini dapat berguna untuk pengujian, tetapi untuk workload produksi, sebaiknya gunakan kunci kriptografis yang digabungkan dengan Cloud KMS.
Untuk mempelajari lebih lanjut opsi yang tersedia saat menggunakan kunci kriptografis, lihat
CryptoKey
di referensi DLP API.
Menggunakan penyesuaian konteks
Secara default, semua metode transformasi kriptografis de-identifikasi memiliki integritas referensial, baik token outputnya satu arah maupun dua arah. Artinya, dengan kunci kriptografis yang sama, nilai input selalu diubah menjadi nilai terenkripsi yang sama. Dalam situasi saat data atau pola data berulang mungkin terjadi, risiko identifikasi ulang akan meningkat. Sebagai gantinya, agar nilai input yang sama selalu diubah menjadi nilai terenkripsi yang berbeda, Anda dapat menentukan penyesuaian konteks yang unik.
Anda menentukan penyesuaian konteks (disebut
context
di DLP API) saat mentransformasi data tabulasi, karena penyesuaian tersebut
secara efektif merupakan pointer ke kolom data, seperti ID.
Sensitive Data Protection menggunakan nilai dalam kolom yang ditentukan oleh penyesuaian konteks saat mengenkripsi nilai input. Untuk memastikan bahwa nilai terenkripsi selalu merupakan nilai unik, tentukan kolom untuk tweak yang berisi ID unik.
Perhatikan contoh sederhana ini. Tabel berikut menunjukkan beberapa rekam medis, yang beberapa di antaranya menyertakan ID pasien duplikat.
| record_id | patient_id | icd10_code |
|---|---|---|
| 5437 | 43789 | E11.9 |
| 5438 | 43671 | M25.531 |
| 5439 | 43789 | N39.0, I25.710 |
| 5440 | 43766 | I10 |
| 5441 | 43766 | I10 |
| 5442 | 42989 | R07.81 |
| 5443 | 43098 | I50.1, R55 |
| ... | ... | ... |
Jika Anda menginstruksikan Sensitive Data Protection untuk melakukan de-identifikasi ID pasien dalam
tabel, ID pasien yang berulang akan di-de-identifikasi ke nilai yang sama secara default, seperti
yang ditunjukkan dalam tabel berikut. Misalnya, kedua ID pasien "43789" dide-identifikasi menjadi "47222". (Kolom patient_id menampilkan nilai token setelah pseudonimisasi menggunakan FPE-FFX dan tidak menyertakan anotasi pengganti. Lihat Enkripsi yang mempertahankan format untuk mengetahui informasi selengkapnya.)
| record_id | patient_id | icd10_codes |
|---|---|---|
| 5437 | 47222 | E11.9 |
| 5438 | 82160 | M25.531 |
| 5439 | 47222 | N39.0, I25.710 |
| 5440 | 04452 | I10 |
| 5441 | 04452 | I10 |
| 5442 | 47826 | R07.81 |
| 5443 | 52428 | I50.1, R55 |
| ... | ... | ... |
Artinya, cakupan integritas referensial mencakup seluruh set data.
Untuk mempersempit cakupan agar Anda dapat menghindari perilaku ini, tentukan penyesuaian konteks. Anda dapat menentukan kolom apa pun sebagai penyesuaian konteks, tetapi untuk menjamin bahwa setiap nilai yang dide-identifikasi bersifat unik, tentukan kolom yang setiap nilainya unik.
Misalnya, Anda ingin melihat apakah pasien yang sama muncul per nilai icd10_codes,
tetapi tidak jika pasien yang sama muncul dalam nilai icd10_codes yang berbeda. Untuk melakukannya, Anda harus menentukan kolom icd10_codes sebagai penyesuaian konteks.
Berikut adalah tabel setelah melakukan de-identifikasi kolom patient_id menggunakan kolom icd10_codes sebagai penyesuaian konteks:
| record_id | patient_id | icd10_codes |
|---|---|---|
| 5437 | 18954 | E11.9 |
| 5438 | 33068 | M25.531 |
| 5439 | 76368 | N39.0, I25.710 |
| 5440 | 29460 | I10 |
| 5441 | 29460 | I10 |
| 5442 | 23877 | R07.81 |
| 5443 | 96129 | I50.1, R55 |
| ... | ... | ... |
Perhatikan bahwa nilai patient_id keempat dan kelima yang dide-identifikasi (29460) sama karena tidak hanya nilai patient_id aslinya yang identik, nilai icd10_codes kedua baris juga identik. Karena Anda perlu menjalankan
analisis dengan ID pasien yang konsisten dalam cakupan nilai icd10_codes,
perilaku inilah yang Anda cari.
Untuk sepenuhnya memutuskan integritas referensial antara nilai patient_id dan nilai icd10_codes, Anda dapat menggunakan kolom record_id sebagai penyesuaian konteks:
| record_id | patient_id | icd10_code |
|---|---|---|
| 5437 | 15826 | E11.9 |
| 5438 | 61722 | M25.531 |
| 5439 | 34424 | N39.0, I25.710 |
| 5440 | 02875 | I10 |
| 5441 | 52549 | I10 |
| 5442 | 17945 | R07.81 |
| 5443 | 19030 | I50.1, R55 |
| ... | ... | ... |
Perhatikan bahwa setiap nilai patient_id yang dide-identifikasi dalam tabel kini bersifat unik.
Untuk mempelajari cara menggunakan penyesuaian konteks di DLP API, perhatikan penggunaan
context dalam topik referensi metode transformasi berikut:
- Enkripsi dengan mempertahankan format:
CryptoReplaceFfxFpeConfig - Enkripsi deterministik menggunakan AES-SIV:
CryptoDeterministicConfig - Pergeseran tanggal:
DateShiftConfig