


La pseudonimizzazione è una tecnica di anonimizzazione che sostituisce i valori dei dati sensibili con token generati in modo crittografico. La pseudonimizzazione è ampiamente utilizzata in settori come quello finanziario e sanitario per ridurre il rischio di dati in uso, restringere l'ambito di conformità e ridurre al minimo l'esposizione di dati sensibili ai sistemi, preservando al contempo l'utilità e l'accuratezza dei dati.
Sensitive Data Protection supporta tre tecniche di pseudonimizzazione dell'anonimizzazione e genera token applicando uno dei tre metodi di trasformazione crittografica ai valori dei dati sensibili originali. Ogni valore sensibile originale viene quindi sostituito con il token corrispondente. La pseudonimizzazione viene talvolta definita tokenizzazione o sostituzione surrogata.
Le tecniche di pseudonimizzazione consentono di utilizzare token unidirezionali o bidirezionali. Un token unidirezionale è stato trasformato in modo irreversibile, mentre un token bidirezionale può essere invertito. Poiché il token viene creato utilizzando la crittografia simmetrica, la stessa chiave di crittografia che può generare nuovi token può anche invertire i token. Per le situazioni in cui non hai bisogno della reversibilità, puoi utilizzare token unidirezionali che utilizzano meccanismi di hashing sicuri.
È utile capire in che modo la pseudonimizzazione può aiutare a proteggere i dati sensibili, consentendo al contempo alle operazioni aziendali e ai workflow analitici di accedere e utilizzare facilmente i dati di cui hanno bisogno. Questo argomento esplora il concetto di assegnazione di pseudonimi e i tre metodi crittografici per trasformare i dati supportati da Sensitive Data Protection.
Per istruzioni su come implementare questi metodi di assegnazione di pseudonimi e per altri esempi di utilizzo di Sensitive Data Protection, consulta Anonimizzazione dei dati sensibili.
Quando utilizzare la pseudonimizzazione
Ecco alcuni casi d'uso comuni:
- Preserva l'integrità referenziale tra i set di dati analitici: sostituisci gli ID cliente e le chiavi primarie con token crittografici coerenti in modo che i team possano unire e aggregare le tabelle in BigQuery senza esporre identificatori sensibili.
- Riduci l'ambito di conformità e audit: sostituisci i numeri delle carte di credito e le informazioni che consentono l'identificazione personale (PII) con token che preservano il formato per restringere i limiti di conformità PCI DSS o HIPAA nelle applicazioni downstream.
- Proteggi gli ambienti di test e sviluppo: replica i database di produzione in ambienti di sviluppo di livello inferiore con campi tokenizzati. Questo approccio consente agli sviluppatori di testare le applicazioni con strutture di dati realistiche senza accedere ai record dei clienti attivi.
- Abilita la reversibilità sicura per i workflow autorizzati: utilizza la crittografia bidirezionale (come AES-SIV o FPE) con chiavi archiviate in Cloud Key Management Service in modo che solo i servizi di backend autenticati e con privilegi possano detokenizzare i valori originali quando richiesto dai requisiti legali.
- Applica il mascheramento irreversibile dei dati con l'hashing di crittografia: genera digest HMAC-SHA-256 unidirezionali. Questo metodo è adatto quando è necessaria la correlazione tra record per l'analisi statistica, ma il ripristino del testo non crittografato originale deve rimanere computazionalmente impossibile.
Metodi di crittografia supportati in Sensitive Data Protection
Sensitive Data Protection supporta tre tecniche di pseudonimizzazione, tutte che utilizzano chiavi di crittografia. Di seguito sono riportati i metodi disponibili:
- Crittografia deterministica con AES-SIV: un valore di input viene sostituito con un valore criptato utilizzando l'algoritmo di crittografia AES-SIV con una chiave di crittografia, codificato utilizzando base64 e poi preceduto da un'annotazione surrogata, se specificata. Questo metodo produce un valore sottoposto ad hashing, pertanto non conserva il set di caratteri o la lunghezza del valore di input. I valori criptati e sottoposti ad hashing possono essere identificati nuovamente utilizzando la chiave di crittografia originale e l'intero valore di output, inclusa l'annotazione surrogata. Scopri di più sul formato dei valori tokenizzati utilizzando la crittografia AES-SIV.
- Crittografia con protezione del formato: un valore di input viene sostituito con un valore che è stato crittografato utilizzando l'algoritmo crittografico FPE-FFX con una chiave di crittografia, quindi viene anteposta un'annotazione surrogata, se specificata. Per impostazione predefinita, sia il set di caratteri che la lunghezza del valore di input vengono conservati nel valore di output. I valori criptati possono essere reidentificati utilizzando la chiave di crittografia originale e l'intero valore di output, inclusa l'annotazione surrogata. (Per alcune considerazioni importanti sull'utilizzo di questo metodo di crittografia, consulta Crittografia con conservazione del formato più avanti in questo argomento.)
- Hashing di crittografia: un valore di input viene sostituito con un valore che è stato criptato e sottoposto ad hashing utilizzando l'algoritmo HMAC (Hash-based Message Authentication Code)-SHA (Secure Hash Algorithm)-256 sul valore di input con una chiave di crittografia. L'output sottoposto ad hashing della trasformazione ha sempre la stessa lunghezza e non può essere reidentificato. Scopri di più sul formato dei valori tokenizzati utilizzando l'hashing di crittografia.
Questi metodi di pseudonimizzazione sono riassunti nella tabella seguente. Le righe della tabella sono spiegate di seguito.
| Crittografia deterministica con AES-SIV | Crittografia con conservazione del formato | Hashing di crittografia | |
|---|---|---|---|
| Tipo di crittografia | AES-SIV | FPE-FFX | HMAC-SHA-256 |
| Valori di input supportati | Almeno 1 carattere; nessuna limitazione del set di caratteri. | Almeno 2 caratteri; deve essere codificato come ASCII. | Deve essere una stringa o un valore intero. |
| Annotazione surrogata | Facoltativo. | Facoltativo. | N/D |
| Modifica del contesto | Facoltativo. | Facoltativo. | N/D |
| Set di caratteri e lunghezza conservati | ✗ | ✓ | ✗ |
| Reversibile | ✓ | ✓ | ✗ |
| Integrità referenziale | ✓ | ✓ | ✓ |
- Tipo di crittografia: il tipo di crittografia utilizzato nella trasformazione di anonimizzazione.
- Valori di input supportati: requisiti minimi per i valori di input.
- Annotazione surrogata: un'annotazione specificata dall'utente che viene anteposta ai valori criptati per fornire contesto agli utenti e informazioni che Sensitive Data Protection può utilizzare per la reidentificazione di un valore anonimizzato. Per la reidentificazione dei dati non strutturati è necessaria un'annotazione surrogata. È facoltativo quando si trasforma una colonna di dati strutturati o tabulari con un
RecordTransformation. - Modifica del contesto: un riferimento a un campo di dati che "modifica" il valore di input in modo che valori di input identici possano essere anonimizzati in valori di output diversi. La modifica del contesto è facoltativa quando si trasforma una colonna di dati strutturati o dati tabulari con un
RecordTransformation. Per saperne di più, consulta Utilizza le modifiche al contesto. - Set di caratteri e lunghezza conservati: indica se un valore anonimizzato è composto dallo stesso set di caratteri del valore originale e se la lunghezza del valore anonimizzato corrisponde a quella del valore originale.
- Reversibile: può essere reidentificato utilizzando la chiave di crittografia, l'annotazione surrogata e qualsiasi modifica del contesto.
- Integrità referenziale: l'integrità referenziale consente ai record di mantenere la relazione tra loro anche dopo l'anonimizzazione individuale dei dati. Con la stessa chiave di crittografia e lo stesso tweak di contesto, una tabella di dati verrà sostituita con la stessa forma offuscata ogni volta che viene trasformata, il che garantisce che le connessioni tra i valori (e, con i dati strutturati, i record) vengano conservate, anche tra le tabelle.
Come funziona la tokenizzazione in Sensitive Data Protection
Il processo di base della tokenizzazione è lo stesso per tutti e tre i metodi supportati da Sensitive Data Protection.
Passaggio 1: Sensitive Data Protection seleziona i dati da tokenizzare. Il modo più comune per farlo è utilizzare un rilevatore infoType integrato o personalizzato per trovare i valori dei dati sensibili desiderati. Se stai scansionando dati strutturati (ad esempio una tabella BigQuery), puoi anche eseguire la tokenizzazione su intere colonne di dati utilizzando le trasformazioni dei record.
Per ulteriori informazioni sulle due categorie di trasformazioni, ovvero le trasformazioni infoType e dei record, consulta Trasformazioni di anonimizzazione.
Passaggio 2: utilizzando una chiave di crittografia, Sensitive Data Protection cripta ogni valore di input. Puoi fornire questa chiave in uno dei tre modi seguenti:
- Eseguendo il wrapping con Cloud Key Management Service (Cloud KMS). (Per la massima sicurezza, Cloud KMS è il metodo preferito).
- Utilizzando una chiave temporanea, che Sensitive Data Protection genera al momento dell'anonimizzazione e poi elimina. Una chiave temporanea mantiene l'integrità solo per richiesta API. Se hai bisogno di integrità o prevedi di reidentificare questi dati, non utilizzare questo tipo di chiave.
- Direttamente in formato testo non elaborato. (Non consigliato)
Per maggiori dettagli, consulta la sezione Utilizzo delle chiavi di crittografia più avanti in questo argomento.
Passaggio 3 (solo hashing di crittografia e crittografia deterministica con AES-SIV): Sensitive Data Protection codifica il valore criptato utilizzando base64. Con l'hashing di crittografia, questo valore codificato e crittografato è il token e il processo continua con il passaggio 6. Con la crittografia deterministica che utilizza AES-SIV, questo valore codificato e criptato è il valore surrogato, che è solo un componente del token. La procedura continua con il passaggio 4.
Passaggio 4 (solo per la crittografia deterministica e con conservazione del formato con AES-SIV): Sensitive Data Protection aggiunge un'annotazione surrogata facoltativa al valore criptato. L'annotazione surrogata aiuta a identificare i valori surrogati criptati anteponendo una stringa descrittiva definita da te. Ad esempio, senza un'annotazione potresti non essere in grado di distinguere un numero di telefono anonimizzato da un codice fiscale o un altro numero di identificazione anonimizzato. Inoltre, per reidentificare i valori nei dati non strutturati che sono stati anonimizzati utilizzando la crittografia con protezione del formato o la crittografia deterministica, devi specificare un'annotazione surrogata. (Le annotazioni surrogate non sono necessarie quando si trasforma una colonna di dati strutturati o tabulari con un RecordTransformation.)
Passaggio 5 (crittografia deterministica e con conservazione del formato con AES-SIV solo dei dati strutturati): Sensitive Data Protection può utilizzare il contesto facoltativo di un altro campo per "modificare" il token generato. In questo modo puoi modificare l'ambito del token. Ad esempio, supponiamo di avere un database di dati di campagne di marketing che include indirizzi email e di voler generare token univoci per lo stesso indirizzo email "modificato" dall'ID campagna. In questo modo, qualcuno potrebbe unire i dati dello stesso utente all'interno della stessa campagna, ma non tra campagne diverse. Se per creare il token viene utilizzato un aggiustamento del contesto, questo aggiustamento è necessario anche per invertire le trasformazioni di anonimizzazione. La crittografia deterministica e che preserva il formato utilizzando AES-SIV supporta i contesti. Scopri di più sull'utilizzo delle modifiche al contesto.
Passaggio 6: Sensitive Data Protection sostituisce il valore originale con il valore anonimizzato.
Confronto dei valori tokenizzati
Questa sezione mostra l'aspetto dei token tipici dopo l'anonimizzazione utilizzando ciascuno dei tre metodi discussi in questo argomento. Il valore dei dati sensibili di esempio è un numero di telefono nordamericano (1-206-555-0123).
Crittografia deterministica con AES-SIV
Con l'anonimizzazione che utilizza la crittografia deterministica e AES-SIV, un valore di input (e, facoltativamente, qualsiasi modifica del contesto specificata) viene criptato utilizzando AES-SIV con una chiave di crittografia, codificato utilizzando base64 e, facoltativamente, preceduto da un'annotazione surrogata, se specificata. Questo metodo non conserva il set di caratteri (o "alfabeto") del valore di input. Per generare un output stampabile, il valore risultante viene codificato in base64.
Il token risultante, supponendo che sia stato specificato un infoType surrogato, è nel seguente formato:
SURROGATE_INFOTYPE(SURROGATE_VALUE_LENGTH):SURROGATE_VALUE
Il seguente diagramma annotato mostra un token di esempio, ovvero l'output di un'operazione di anonimizzazione che utilizza la crittografia deterministica con AES-SIV sul valore 1-206-555-0123. L'infoType surrogato facoltativo è stato impostato su
NAM_PHONE_NUMB:
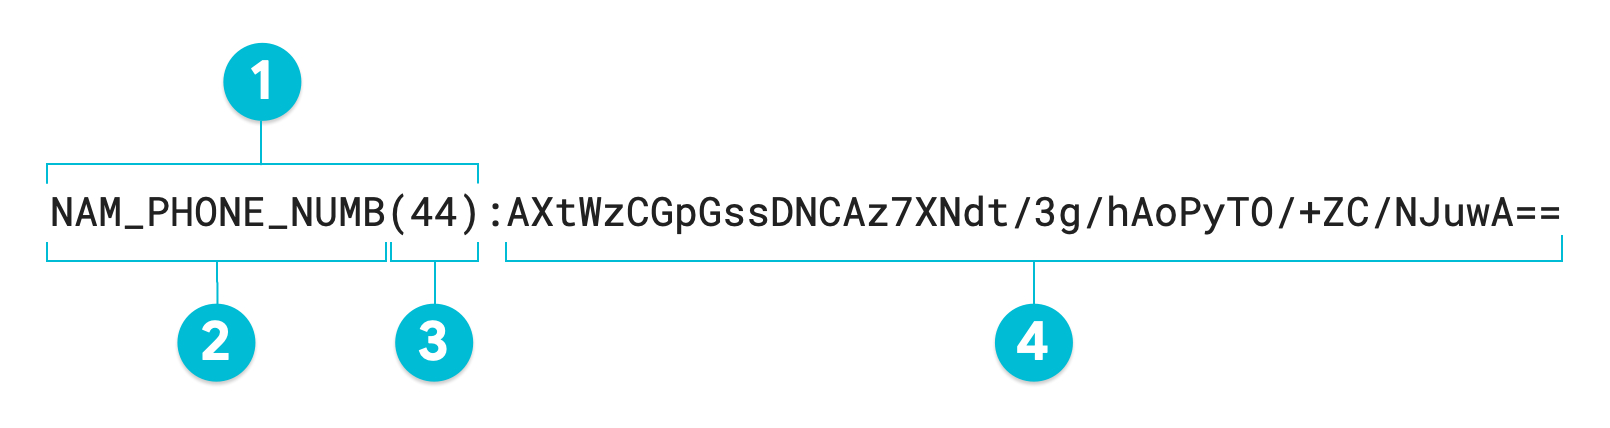
- Annotazione surrogata
- InfoType surrogato (definito dall'utente)
- Numero di caratteri del valore trasformato
- Valore surrogato (trasformato)
Se non specifichi un'annotazione surrogata, il token risultante è uguale al valore trasformato o al n. 4 nel diagramma annotato. Per reidentificare i dati non strutturati, è necessario l'intero token, inclusa l'annotazione surrogata. Quando si trasformano dati strutturati come una tabella, l'annotazione surrogata è facoltativa; Sensitive Data Protection può eseguire sia l'anonimizzazione che la reidentificazione su un'intera colonna utilizzando un RecordTransformation senza un'annotazione surrogata.
Crittografia con protezione del formato
Con l'anonimizzazione che utilizza la crittografia con protezione del formato, un valore di input (e, facoltativamente, qualsiasi modifica del contesto specificata) viene criptato utilizzando la modalità FFX della crittografia con protezione del formato ("FPE-FFX") con una chiave di crittografia e, facoltativamente, viene anteposta un'annotazione surrogata, se specificata.
A differenza degli altri metodi di tokenizzazione descritti in questo argomento, il valore surrogato di output ha la stessa lunghezza del valore di input e non è codificato utilizzando base64. Sei tu a definire il set di caratteri, o "alfabeto", che compone il valore criptato. Esistono tre modi per specificare l'alfabeto che Sensitive Data Protection deve utilizzare nel valore di output:
- Utilizza uno dei quattro valori di enumerazione che rappresentano i quattro set di caratteri/alfabeti più comuni.
- Utilizza un valore di base, che specifica la dimensione dell'alfabeto. Se specifichi il valore minimo della base
2, l'alfabeto sarà composto solo da0e1. Se specifichi il valore massimo della base95, l'alfabeto include tutti i caratteri numerici, i caratteri alfabetici maiuscoli, i caratteri alfabetici minuscoli e i caratteri dei simboli. - Crea un alfabeto elencando i caratteri esatti da utilizzare. Ad esempio, se specifichi
1234567890-*, il valore surrogato sarà composto solo da numeri, trattini e asterischi.
La tabella seguente elenca quattro set di caratteri comuni in base al valore di enumerazione
(FfxCommonNativeAlphabet),
al valore di base e all'elenco dei caratteri del set. L'ultima riga elenca il set di caratteri completo, che corrisponde al valore massimo della base.
| Nome dell'alfabeto/set di caratteri | Radix | Elenco dei personaggi |
|---|---|---|
NUMERIC |
10 |
0123456789 |
HEXADECIMAL |
16 |
0123456789ABCDEF |
UPPER_CASE_ALPHA_NUMERIC |
36 |
0123456789ABCDEFGHIJKLMNOPQRSTUVWXYZ |
ALPHA_NUMERIC |
62 |
0123456789ABCDEFGHIJKLMNOPQRSTUVWXYZabcdefghijklmnopqrstuvwxyz |
| - | 95 |
0123456789ABCDEFGHIJKLMNOPQRSTUVWXYZabcdefghijklmnopqrstuvwxyz~`!@#$%^&*()_-+={[}]|\:;"'<,>.?/ |
Il token risultante, supponendo che sia stato specificato un infoType surrogato, è nel seguente formato:
SURROGATE_INFOTYPE(SURROGATE_VALUE_LENGTH):SURROGATE_VALUE
Il seguente diagramma annotato è l'output di un'operazione di anonimizzazione di Sensitive Data Protection che utilizza la crittografia con protezione del formato sul valore 1-206-555-0123 utilizzando una radice di 95. L'infoType surrogato facoltativo è stato impostato su NAM_PHONE_NUMB:

- Annotazione surrogata
- InfoType surrogato (definito dall'utente)
- Numero di caratteri del valore trasformato
- Valore surrogato (trasformato): stessa lunghezza del valore di input
Se non specifichi un'annotazione surrogata, il token risultante è uguale al valore trasformato o al n. 4 nel diagramma annotato. Per reidentificare i dati non strutturati, è necessario l'intero token, inclusa l'annotazione surrogata. Quando si trasformano dati strutturati come una tabella, l'annotazione surrogata è facoltativa; Sensitive Data Protection può eseguire sia l'anonimizzazione che la reidentificazione su un'intera colonna utilizzando un RecordTransformation senza un surrogato.
Hashing di crittografia
Con l'anonimizzazione tramite hashing di crittografia, un valore di input viene sottoposto ad hashing utilizzando HMAC-SHA-256 con una chiave di crittografia e poi codificato utilizzando base64. Il valore anonimizzato ha sempre una lunghezza uniforme, a seconda delle dimensioni della chiave.
A differenza degli altri metodi di tokenizzazione discussi in questo argomento, l'hashing di crittografia crea un token unidirezionale. In altre parole, l'anonimizzazione tramite hashing di crittografia non può essere invertita.
Di seguito è riportato l'output di un'operazione di anonimizzazione che utilizza l'hashing di crittografia sul valore 1-206-555-0123. Questo output è una rappresentazione con codifica Base64 del valore hash:
XlTCv8h0GwrCZK+sS0T3Z8txByqnLLkkF4+TviXfeZY=
Utilizzo delle chiavi di crittografia
Esistono tre opzioni per le chiavi di crittografia che puoi utilizzare con i metodi di anonimizzazione crittografica in Sensitive Data Protection:
Chiave di crittografia con wrapping di Cloud KMS: questo è il tipo di chiave di crittografia più sicuro disponibile per l'utilizzo con i metodi di anonimizzazione di Sensitive Data Protection. Una chiave con wrapping Cloud KMS è costituita da una chiave di crittografia a 128, 192 o 256 bit che è stata criptata utilizzando un'altra chiave. Sei tu a fornire la prima chiave di crittografia, che viene poi sottoposta a wrapping utilizzando una chiave di crittografia archiviata in Cloud Key Management Service. Questi tipi di chiavi vengono archiviati in Cloud KMS per una successiva reidentificazione. Per ulteriori informazioni sulla creazione e l'aggregazione di una chiave ai fini dell'anonimizzazione e della reidentificazione, consulta Guida rapida: anonimizzazione e reidentificazione del testo sensibile.
Chiave di crittografia temporanea: una chiave di crittografia temporanea viene generata da Sensitive Data Protection al momento dell'anonimizzazione e poi eliminata. Per questo motivo, non utilizzare una chiave di crittografia temporanea con un metodo di anonimizzazione crittografica che vuoi invertire. Le chiavi di crittografia temporanee mantengono l'integrità solo per richiesta API. Se hai bisogno di integrità per più di una richiesta API o se prevedi di identificare nuovamente i tuoi dati, non utilizzare questo tipo di chiave.
Chiave di crittografia senza wrapping: una chiave senza wrapping è una chiave di crittografia non elaborata a 128, 192 o 256 bit con codifica base64 che fornisci all'interno della richiesta di anonimizzazione all'API DLP. Spetta a te conservare queste chiavi di crittografia al sicuro per la successiva reidentificazione. A causa del rischio di fuga accidentale della chiave, questi tipi di chiavi non sono consigliati. Queste chiavi possono essere utili per i test, ma per i workload di produzione è consigliabile utilizzare una chiave di crittografia con wrapping di Cloud KMS.
Per scoprire di più sulle opzioni disponibili quando utilizzi le chiavi di crittografia, consulta CryptoKey nel riferimento API DLP.
Utilizzo delle modifiche al contesto
Per impostazione predefinita, tutti i metodi di trasformazione crittografica dell'anonimizzazione hanno l'integrità referenziale, indipendentemente dal fatto che i token di output siano unidirezionali o bidirezionali. In altre parole, con la stessa chiave di crittografia, un valore di input viene sempre trasformato nello stesso valore crittografato. In situazioni in cui potrebbero verificarsi dati o pattern di dati ripetitivi, il rischio di reidentificazione aumenta. Per fare in modo che lo stesso valore di input venga sempre trasformato in un valore criptato diverso, puoi specificare un tweak di contesto univoco.
Quando trasformi i dati tabulari, specifichi un tweak del contesto (chiamato semplicemente context nell'API DLP), poiché il tweak è effettivamente un puntatore a una colonna di dati, ad esempio un identificatore.
Sensitive Data Protection utilizza il valore nel campo specificato dalla modifica del contesto durante la crittografia del valore di input. Per assicurarti che il valore criptato sia sempre un valore univoco, specifica una colonna per il tweak che contiene identificatori univoci.
Considera questo semplice esempio. La tabella seguente mostra diverse storie cliniche, alcune delle quali includono ID paziente duplicati.
| record_id | patient_id | icd10_code |
|---|---|---|
| 5437 | 43789 | E11.9 |
| 5438 | 43671 | M25.531 |
| 5439 | 43789 | N39.0, I25.710 |
| 5440 | 43766 | I10 |
| 5441 | 43766 | I10 |
| 5442 | 42989 | R07.81 |
| 5443 | 43098 | I50.1, R55 |
| … | … | … |
Se indichi a Sensitive Data Protection di anonimizzare gli ID paziente nella tabella, per impostazione predefinita gli ID paziente ripetuti vengono anonimizzati con gli stessi valori, come mostrato nella tabella seguente. Ad esempio, entrambe le istanze dell'ID paziente "43789" vengono anonimizzate in "47222". (La colonna patient_id mostra i valori dei token dopo l'assegnazione di pseudonimi utilizzando FPE-FFX e non include le annotazioni surrogate. Per saperne di più, consulta Crittografia con protezione del formato.
| record_id | patient_id | icd10_codes |
|---|---|---|
| 5437 | 47222 | E11.9 |
| 5438 | 82160 | M25.531 |
| 5439 | 47222 | N39.0, I25.710 |
| 5440 | 04452 | I10 |
| 5441 | 04452 | I10 |
| 5442 | 47826 | R07.81 |
| 5443 | 52428 | I50.1, R55 |
| … | … | … |
Ciò significa che l'ambito dell'integrità referenziale riguarda l'intero set di dati.
Per restringere l'ambito ed evitare questo comportamento, specifica un aggiustamento del contesto. Puoi specificare qualsiasi colonna come modifica del contesto, ma per garantire che ogni valore anonimizzato sia univoco, specifica una colonna per la quale ogni valore è univoco.
Supponiamo che tu voglia vedere se lo stesso paziente compare per valore icd10_codes, ma non se lo stesso paziente compare in valori icd10_codes diversi. Per farlo, devi specificare la colonna icd10_codes come modifica del contesto.
Questa è la tabella dopo l'anonimizzazione della colonna patient_id utilizzando la colonna icd10_codes come modifica del contesto:
| record_id | patient_id | icd10_codes |
|---|---|---|
| 5437 | 18954 | E11.9 |
| 5438 | 33068 | M25.531 |
| 5439 | 76368 | N39.0, I25.710 |
| 5440 | 29460 | I10 |
| 5441 | 29460 | I10 |
| 5442 | 23877 | R07.81 |
| 5443 | 96129 | I50.1, R55 |
| … | … | … |
Tieni presente che il quarto e il quinto valore patient_id anonimizzato (29460) sono gli stessi perché non solo i valori patient_id originali erano identici, ma anche i valori icd10_codes di entrambe le righe erano identici. Poiché dovevi eseguire l'analisi con ID paziente coerenti nell'ambito del valore icd10_codes, questo comportamento è quello che stai cercando.
Per interrompere completamente l'integrità referenziale tra i valori patient_id e
icd10_codes, puoi utilizzare la colonna record_id come modifica del contesto:
| record_id | patient_id | icd10_code |
|---|---|---|
| 5437 | 15826 | E11.9 |
| 5438 | 61722 | M25.531 |
| 5439 | 34424 | N39.0, I25.710 |
| 5440 | 02875 | I10 |
| 5441 | 52549 | I10 |
| 5442 | 17945 | R07.81 |
| 5443 | 19030 | I50.1, R55 |
| … | … | … |
Tieni presente che ogni valore patient_id anonimizzato nella tabella è ora univoco.
Per scoprire come utilizzare gli aggiustamenti del contesto nell'API DLP, tieni presente l'utilizzo di context nei seguenti argomenti di riferimento sui metodi di trasformazione:
- Crittografia con conservazione del formato:
CryptoReplaceFfxFpeConfig - Crittografia deterministica con AES-SIV:
CryptoDeterministicConfig - Spostamento della data:
DateShiftConfig