


Cette page présente les erreurs de dépassement de délai Spanner : de quoi il s'agit, pourquoi elles se produisent, et comment les dépanner et les résoudre.
Lors de l'accès aux API Spanner, les requêtes peuvent échouer en raison d'erreurs DEADLINE_EXCEEDED. Cette erreur indique qu'aucune réponse n'a été reçue dans le délai configuré.
Une erreur de dépassement de délai peut se produire pour de nombreuses raisons, telles que des instances Spanner surchargées, des schémas non optimisés ou des requêtes non optimisées. Cette page décrit les scénarios courants dans lesquels une erreur de dépassement de délai se produit, et fournit un guide pour examiner et résoudre ces problèmes.
Philosophie de Spanner concernant les délais et les nouvelles tentatives
La philosophie de Spanner en matière de délais avant expiration et de nouvelles tentatives diffère de celle de nombreux autres systèmes. Dans Spanner, vous devez spécifier un délai avant expiration comme durée maximale pendant laquelle une réponse est utile. Il n'est pas recommandé de définir un délai artificiellement court juste pour réessayer immédiatement la même opération, car cela peut entraîner des situations où les opérations ne se terminent jamais. Dans ce contexte, les stratégies et opérations suivantes ne sont pas recommandées. Elles sont contre-productives et annulent le comportement de nouvelle tentative interne de Spanner :
Fixer un délai trop court. Cela signifie que l'opération n'est pas résiliente aux augmentations occasionnelles de la latence de queue et qu'elle ne peut pas se terminer avant d'expirer. Définissez plutôt un délai correspondant à la durée maximale pendant laquelle une réponse est utile.
Définir un délai trop long et annuler l'opération avant qu'il ne soit dépassé. Cela entraîne des nouvelles tentatives et un gaspillage de travail à chaque essai. Globalement, cela peut créer une charge supplémentaire importante sur votre instance.
Qu'est-ce qu'une erreur de dépassement de délai ?
Lorsque vous utilisez l'une des bibliothèques clientes Spanner, la couche gRPC sous-jacente gère la communication, le marshaling, l'unmarshaling et l'application des délais. Les délais permettent à votre application de spécifier combien de temps elle est prête à attendre qu'une requête se termine avant que celle-ci ne soit interrompue avec l'erreur "Délai dépassé".
Le guide de configuration des délais avant expiration explique comment spécifier des délais (ou des délais avant expiration) dans chacune des bibliothèques clientes Spanner compatibles. Les bibliothèques clientes Spanner utilisent des paramètres de délai avant expiration et de stratégie de nouvelle tentative par défaut, qui sont définis dans les fichiers de configuration suivants :
- spanner_grpc_service_config.json
- spanner_admin_instance_grpc_service_config.json
- spanner_admin_database_grpc_service_config.json
Pour en savoir plus sur les délais gRPC, consultez gRPC et les délais.
Examiner et résoudre les erreurs courantes de dépassement de délai
Vous pouvez rencontrer des erreurs DEADLINE_EXCEEDED pour les types de problèmes suivants :
- Problèmes liés à l'API d'accès aux données
- Problèmes liés à l'API Data
- Problèmes liés à l'API Admin
- Problèmes liés à la consoleGoogle Cloud
- Problèmes liés à Dataflow
Problèmes liés à l'API d'accès aux données
Une instance Spanner doit être configurée de manière appropriée pour vos charges de travail spécifiques afin d'éviter les problèmes d'API d'accès aux données. Les sections suivantes expliquent comment examiner et résoudre différents problèmes liés à l'API d'accès aux données.
Vérifier la charge du processeur de l'instance Spanner
La latence des requêtes peut augmenter considérablement lorsque l'utilisation du processeur dépasse le seuil d'intégrité recommandé. Vous pouvez vérifier l'utilisation du processeur Spanner dans la console de surveillance fournie dans la console Google Cloud . Vous pouvez également créer des alertes basées sur l'utilisation du processeur de l'instance.
Solution
Pour savoir comment réduire l'utilisation du processeur de l'instance, consultez Réduire l'utilisation du processeur.
Vérifier la répartition de la latence de bout en bout de la requête
Lorsqu'une requête est envoyée du client aux serveurs Spanner et inversement, plusieurs sauts réseau doivent être effectués : de la bibliothèque cliente à Google Front End (GFE), du GFE à l'interface de l'API Spanner, et enfin de l'interface de l'API Spanner à la base de données Spanner. Si des problèmes de réseau surviennent à l'une de ces étapes, des erreurs de dépassement de délai peuvent s'afficher.
Il est possible de capturer la latence à chaque étape. Pour en savoir plus, consultez Points de latence dans une requête Spanner. Pour savoir où la latence se produit dans Spanner, consultez Identifier où la latence se produit dans Spanner.
Solution
Une fois que vous avez obtenu la répartition de la latence, vous pouvez utiliser des métriques pour diagnostiquer la latence, comprendre pourquoi elle se produit et trouver des solutions.
Problèmes liés à l'API Data
Certains modèles d'utilisation non optimaux de l'API Data de Spanner peuvent entraîner des erreurs de dépassement de délai. Cette section fournit des instructions pour identifier ces modèles d'utilisation non optimaux.
Rechercher les requêtes coûteuses
Si vous essayez d'exécuter des requêtes coûteuses qui ne s'exécutent pas dans le délai avant expiration configuré dans les bibliothèques clientes, une erreur de dépassement de délai peut se produire. Voici quelques exemples de requêtes coûteuses : analyses complètes d'une grande table, jointures croisées sur plusieurs grandes tables ou exécution d'une requête avec un prédicat sur une colonne non clé (également une analyse complète de la table).
Vous pouvez inspecter les requêtes coûteuses à l'aide de la table des statistiques de requêtes et de la table des statistiques de transactions. Ces tables affichent des informations sur les requêtes et les transactions lentes, telles que le nombre moyen de lignes lues, le nombre moyen d'octets lus, le nombre moyen de lignes analysées, etc. De plus, vous pouvez générer des plans d'exécution de requêtes pour examiner plus en détail la façon dont vos requêtes sont exécutées.
Solution
Pour optimiser vos requêtes, consultez le guide Bonnes pratiques pour les requêtes SQL. Vous pouvez également utiliser les données obtenues via les tables de statistiques mentionnées précédemment et les plans d'exécution pour optimiser vos requêtes et modifier le schéma de vos bases de données. Ces bonnes pratiques peuvent vous aider à réduire le temps d'exécution des instructions, ce qui peut vous aider à éliminer les erreurs de dépassement de délai.
Vérifier les conflits de verrouillage
Les transactions Spanner doivent acquérir des verrous pour être validées. Les applications s'exécutant à haut débit peuvent entraîner une concurrence entre les transactions pour les mêmes ressources, ce qui augmente le temps d'attente pour obtenir les verrous et affecte les performances globales. Cela peut entraîner un dépassement des délais pour les requêtes de lecture ou d'écriture.
Vous pouvez identifier la cause principale d'une latence élevée pour les transactions en lecture-écriture à l'aide de la table des statistiques de verrouillage et en consultant l'article de blog suivant. Dans votre table de statistiques de verrouillage, vous pouvez trouver les clés de ligne avec les temps d'attente de verrouillage les plus élevés.
Ce guide de dépannage des conflits de verrouillage explique comment trouver les transactions qui accèdent aux colonnes impliquées dans le conflit de verrouillage. Vous pouvez également découvrir quelles transactions sont impliquées dans un conflit de verrouillage à l'aide du guide de dépannage avec des tags de transaction.
Solution
Appliquez ces bonnes pratiques pour réduire les conflits de verrouillage. En outre, utilisez des transactions en lecture seule pour les cas d'utilisation de lecture simple afin d'éviter les conflits de verrouillage avec les écritures. L'utilisation de transactions en lecture/écriture doit être réservée aux écritures ou aux workflows mixtes de lecture/écriture. En suivant ces étapes, vous devriez améliorer la latence globale du temps d'exécution de vos transactions et réduire les erreurs de dépassement de délai.
Rechercher les schémas non optimisés
Avant de concevoir un schéma de base de données optimal pour votre base de données Spanner, vous devez réfléchir aux types de requêtes qui seront exécutées dans votre base de données. Les schémas non optimaux peuvent entraîner des problèmes de performances lors de l'exécution de certaines requêtes. Ces problèmes de performances peuvent empêcher les requêtes de se terminer dans le délai configuré.
Solution
La conception de schéma la plus optimale dépend des lectures et des écritures effectuées dans votre base de données. Les guides sur les bonnes pratiques de conception de schémas et les bonnes pratiques SQL doivent être suivis, quelles que soient les spécificités du schéma. En suivant ces guides, vous éviterez les problèmes de conception de schéma les plus courants. D'autres causes de performances médiocres sont attribuées à votre choix de clés primaires, à la mise en page de la table (voir Utiliser des tables entrelacées pour un accès plus rapide), à la conception du schéma (voir Optimiser le schéma pour les performances) et aux performances du nœud configuré dans votre instance Spanner (voir la Présentation des performances de Spanner).
Rechercher les hotspots
Spanner étant une base de données distribuée, la conception du schéma doit tenir compte de la prévention des hotspots. Par exemple, la création de colonnes à croissance monotone limite le nombre de divisions que Spanner peut utiliser pour répartir uniformément la charge de travail. Ces goulots d'étranglement peuvent entraîner des délais d'expiration. Vous pouvez également utiliser Key Visualizer pour résoudre les problèmes de performances causés par les hotspots.
Solution
Pour résoudre ce problème, reportez-vous d'abord aux solutions identifiées dans la section précédente Rechercher des schémas non optimisés. Repensez votre schéma de base de données et utilisez des index entrelacés pour éviter les index susceptibles de provoquer des hotspots. Si ces étapes ne permettent pas de résoudre le problème, consultez le guide Choisir une clé primaire en évitant de créer des hotspots. Enfin, évitez les schémas de trafic non optimaux, tels que les lectures de plages étendues, qui peuvent empêcher la division basée sur la charge.
Rechercher les délais avant expiration mal configurés
Les bibliothèques clientes fournissent des délais avant expiration par défaut raisonnables pour toutes les requêtes dans Spanner. Toutefois, ces configurations par défaut peuvent nécessiter un ajustement pour votre charge de travail spécifique. Il est utile d'observer le coût de vos requêtes et d'ajuster les délais en fonction de votre cas d'utilisation spécifique.
Solution
Les paramètres par défaut des délais avant expiration conviennent à la plupart des cas d'utilisation. Les utilisateurs peuvent ignorer ces configurations (consultez le guide sur les délais avant expiration et les nouvelles tentatives personnalisés), mais il n'est pas recommandé d'utiliser des délais avant expiration plus agressifs que ceux par défaut. Si vous décidez de modifier le délai avant expiration, définissez-le sur la durée réelle que l'application est prête à attendre pour obtenir le résultat. Vous pouvez tester des délais avant expiration plus longs, mais ne définissez jamais un délai avant expiration inférieur au temps réel que l'application est prête à attendre, car cela entraînerait une nouvelle tentative plus fréquente de l'opération.
Problèmes liés à l'API Admin
Les requêtes API Admin sont des opérations coûteuses par rapport aux requêtes API Data.
Les requêtes d'administration telles que CreateInstance, CreateDatabase ou CreateBackups peuvent prendre plusieurs secondes avant de renvoyer une réponse. Les bibliothèques clientes Spanner définissent des délais de 60 minutes pour les requêtes d'administrateur d'instance et de base de données. Cela permet de s'assurer que le serveur a la possibilité de traiter la requête avant que le client ne réessaie ou n'échoue.
Solution
Si vous utilisez la bibliothèque cliente Google Spanner pour accéder à l'API Administrator, assurez-vous qu'elle est à jour et qu'elle utilise la dernière version. Si vous accédez directement à l'API Spanner via une bibliothèque cliente que vous avez créée, assurez-vous que les paramètres de délai avant expiration ne sont pas plus agressifs que les paramètres par défaut (60 minutes) pour les requêtes d'administrateur d'instance et de base de données.
Google Cloud problèmes liés à la console
Les requêtes émises depuis la page Spanner Studio de la console Google Cloud ne peuvent pas dépasser cinq minutes. Si vous créez une requête coûteuse dont l'exécution prend plus de cinq minutes, le message d'erreur suivant s'affiche :
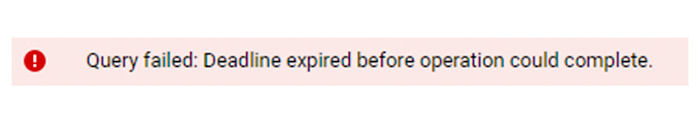
Le backend annulera la requête ayant échoué, et la transaction pourra être annulée si nécessaire.
Solution
Vous pouvez réécrire la requête en suivant le guide des bonnes pratiques pour les requêtes SQL.
Problèmes liés à Dataflow
Dans Apache Beam, la configuration du délai avant expiration par défaut est de deux heures pour les opérations de lecture et de 15 secondes pour les opérations de commit. Ces configurations permettent des opérations plus longues par rapport aux délais avant expiration de la bibliothèque cliente autonome. Toutefois, il est toujours possible de recevoir une erreur de délai avant expiration et de dépassement de délai lorsque les éléments de travail sont trop volumineux. Si nécessaire, vous pouvez personnaliser la configuration du délai avant expiration du commit Apache Beam.
Solution
Si une erreur de dépassement de délai se produit lors des étapes ReadFromSpanner / Execute
query / Read from Spanner / Read from Partitions, consultez la table des statistiques de requête pour identifier la requête qui a analysé un grand nombre de lignes. Ensuite, modifiez ces requêtes pour essayer de réduire le temps d'exécution.
Un autre exemple d'erreur de dépassement de délai Dataflow est présenté dans le message d'exception suivant :
exception:
     org.apache.beam.sdk.util.UserCodeException:
     com.google.cloud.spanner.SpannerException: DEADLINE_EXCEEDED:
     io.grpc.StatusRuntimeException: DEADLINE_EXCEEDED: deadline exceeded after
     3599.999905380s.
     [remote_addr=batch-spanner.googleapis.com/172.217.5.234:443] at
 org.apache.beam.runners.dataflow.worker.GroupAlsoByWindowsParDoFn$1.output(GroupAlsoByWindowsParDoFn.java:184)
Ce délai avant expiration est dû au fait que les éléments de travail sont trop volumineux. Dans l'exemple précédent, les deux recommandations suivantes pourraient vous aider. Tout d'abord, vous pouvez essayer d'activer le service de brassage s'il n'est pas encore activé. Deuxièmement, vous pouvez essayer de modifier les configurations de la lecture de votre base de données, telles que maxPartitions et partitionSizeBytes. Pour en savoir plus, consultez PartitionOptions pour essayer de réduire la taille des éléments de travail. Vous trouverez un exemple de cette procédure dans ce modèle Dataflow.
Ressources de dépannage supplémentaires pour les dépassements de délai
Si l'erreur DEADLINE_EXCEEDED persiste après avoir suivi les étapes de dépannage, ouvrez une demande d'assistance si vous rencontrez les scénarios suivants :
- Latence Google Front End élevée, mais faible latence des requêtes API Spanner
- Une latence élevée des requêtes API Spanner, mais une faible latence des requêtes
Vous pouvez également consulter les ressources de dépannage suivantes :