


En esta página, se describen las técnicas para ajustar el rendimiento de las consultas de Spanner. Antes de comenzar a ajustar tus consultas, revisa las siguientes páginas, en las que se explican los conceptos y las herramientas fundamentales que se usan en el ajuste de consultas:
- Prácticas recomendadas sobre SQL
- Descripción general del visualizador del plan de consulta
- Estadísticas de consultas
- Operadores de ejecución de consultas
Las consultas y los planes de ejecución en esta página se basan en el siguiente esquema de base de datos:
CREATE TABLE Singers (
  SingerId   INT64 NOT NULL,
  FirstName  STRING(1024),
  LastName   STRING(1024),
  SingerInfo BYTES(MAX),
  BirthDate  DATE
) PRIMARY KEY(SingerId);

CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);

CREATE TABLE Albums (
  SingerId        INT64 NOT NULL,
  AlbumId         INT64 NOT NULL,
  AlbumTitle      STRING(MAX),
  MarketingBudget INT64
) PRIMARY KEY(SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);

CREATE INDEX AlbumsByAlbumTitle2 ON Albums(AlbumTitle) STORING (MarketingBudget);

CREATE TABLE Songs (
  SingerId  INT64 NOT NULL,
  AlbumId   INT64 NOT NULL,
  TrackId   INT64 NOT NULL,
  SongName  STRING(MAX),
  Duration  INT64,
  SongGenre STRING(25)
) PRIMARY KEY(SingerId, AlbumId, TrackId),
  INTERLEAVE IN PARENT Albums ON DELETE CASCADE;

CREATE INDEX SongsBySingerAlbumSongNameDesc ON Songs(SingerId, AlbumId, SongName DESC), INTERLEAVE IN Albums;

CREATE INDEX SongsBySongName ON Songs(SongName);

CREATE TABLE Concerts (
  VenueId      INT64 NOT NULL,
  SingerId     INT64 NOT NULL,
  ConcertDate  DATE NOT NULL,
  BeginTime    TIMESTAMP,
  EndTime      TIMESTAMP,
  TicketPrices ARRAY<INT64>
) PRIMARY KEY(VenueId, SingerId, ConcertDate);
Puedes usar las siguientes declaraciones del lenguaje de manipulación de datos (DML) para agregar datos a estas tablas:
INSERT INTO Singers (SingerId, FirstName, LastName, BirthDate)
VALUES (1, "Marc", "Richards", "1970-09-03"),
       (2, "Catalina", "Smith", "1990-08-17"),
       (3, "Alice", "Trentor", "1991-10-02"),
       (4, "Lea", "Martin", "1991-11-09"),
       (5, "David", "Lomond", "1977-01-29");

INSERT INTO Albums (SingerId, AlbumId, AlbumTitle)
VALUES (1, 1, "Total Junk"),
       (1, 2, "Go, Go, Go"),
       (2, 1, "Green"),
       (2, 2, "Forever Hold Your Peace"),
       (2, 3, "Terrified"),
       (3, 1, "Nothing To Do With Me"),
       (4, 1, "Play");

INSERT INTO Songs (SingerId, AlbumId, TrackId, SongName, Duration, SongGenre)
VALUES (2, 1, 1, "Let's Get Back Together", 182, "COUNTRY"),
       (2, 1, 2, "Starting Again", 156, "ROCK"),
       (2, 1, 3, "I Knew You Were Magic", 294, "BLUES"),
       (2, 1, 4, "42", 185, "CLASSICAL"),
       (2, 1, 5, "Blue", 238, "BLUES"),
       (2, 1, 6, "Nothing Is The Same", 303, "BLUES"),
       (2, 1, 7, "The Second Time", 255, "ROCK"),
       (2, 3, 1, "Fight Story", 194, "ROCK"),
       (3, 1, 1, "Not About The Guitar", 278, "BLUES");
Recomendaciones de comparativas
Las estadísticas de rendimiento más confiables provienen de la ejecución de una prueba de carga que usa valores de parámetros de consulta diferentes y aleatorios de una instancia de máquina virtual (VM) de Google Cloud que reside en la misma región que la instancia de destino.
Evita depender de Spanner Studio o del modo QueryMode.PROFILE para comparar las consultas, ya que estas herramientas no replican los entornos de red y cliente de producción reales. Sin embargo, después de que una prueba de carga identifica un problema de rendimiento, los planes de consulta (ya sea que se muestreen en Estadísticas de consultas o se ejecuten a pedido en Spanner Studio) son herramientas útiles para investigar ese problema específico.
Comprende los planes de ejecución de consultas
En el visualizador del plan de consulta, se muestra un plan de ejecución de consultas como un árbol de operadores, en el que cada operador lee filas de sus operadores secundarios, las procesa y pasa los resultados a su operador superior.
Para la mayoría de los operadores del plan visual, la latencia informada es aditiva (solo
refleja el tiempo que se pasa en ese operador). Sin embargo, para los operadores Distributed union y Distributed apply, la latencia informada es acumulativa: incluye el tiempo invertido en el operador distribuido y el tiempo invertido en sus operadores secundarios. Para obtener más información sobre estos
operadores, consulta Unión distribuida y
Aplicación distribuida.
Por ejemplo, en el siguiente plan de unión distribuida, la tarjeta Distributed union
informa una latencia total de 8.46 ms, mientras que su operador secundario Stream aggregate
informa 3.51 ms y Table scan informa 1 ms. Debido a que la
latencia de Distributed union es acumulativa, el operador Distributed union
en sí agrega solo alrededor de 5 ms de latencia, en lugar de 8 ms:

En el siguiente ejemplo, la tarjeta Distributed union informa 13.69 ms de latencia, mientras que sus operadores secundarios (Stream aggregate en <1 ms, Cross apply en 1.14 ms, Table scan en Albums en <1 ms, Filter scan en 1 ms y Table scan en Singers en 10.85 ms) representan aproximadamente 13 ms. Como resultado, el operador Distributed union agrega menos de 1 ms de latencia, en lugar de 13 ms:

También puedes ver los valores de latencia acumulados en el panel de resumen del operador.
Combina varios índices
Cuando una consulta filtra varias columnas indexadas con condiciones OR o AND,
Spanner a veces puede combinar varios índices secundarios para evitar
analizar la tabla base completa. En los ejemplos de esta sección, se extiende la tabla Albums
del esquema de ejemplo anterior agregando una columna ReleaseDate y un
índice secundario AlbumsByReleaseDate:
CREATE TABLE Albums (
  SingerId        INT64 NOT NULL,
  AlbumId         INT64 NOT NULL,
  AlbumTitle      STRING(MAX),
  ReleaseDate     DATE,
  MarketingBudget INT64
) PRIMARY KEY(SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);

CREATE INDEX AlbumsByReleaseDate ON Albums(ReleaseDate);
Considera la siguiente consulta, que usa una condición OR para filtrar predicados
de dos índices secundarios independientes (AlbumsByAlbumTitle y
AlbumsByReleaseDate):
SELECT a.AlbumId, a.AlbumTitle, a.ReleaseDate
FROM Albums AS a
WHERE a.AlbumTitle = 'Play' OR a.ReleaseDate = '2023-09-07';
Cuando una consulta tiene una condición OR en predicados de dos índices separados,
Spanner puede usar la optimización basada en costos para leer ambos índices
y combinar los resultados (una unión de índices). También puedes forzar esta optimización
agregando la sugerencia de tabla INDEX_STRATEGY=FORCE_INDEX_UNION a la consulta:
SELECT a.AlbumId, a.AlbumTitle, a.ReleaseDate
FROM Albums@{INDEX_STRATEGY=FORCE_INDEX_UNION} AS a
WHERE a.AlbumTitle = 'Play' OR a.ReleaseDate = '2023-09-07';
Para obtener más información sobre las sugerencias de tablas, consulta Sugerencias de tablas.
En el siguiente diagrama del plan de ejecución, se muestra cómo Spanner evalúa
esta condición OR (disyunción) analizando cada rama por separado y
combinando los resultados con los operadores Union all y Hash aggregate:

A continuación, considera una consulta que use una condición AND para filtrar ambas columnas
indexadas:
SELECT a.AlbumId, a.ReleaseDate, a.AlbumTitle
FROM Albums AS a
WHERE a.AlbumTitle = 'Aardvark' AND a.ReleaseDate = '2023-09-07';
Con una condición AND, Spanner elige un solo índice de forma predeterminada
y, luego, se une a la tabla base, si es necesario, para evaluar la condición restante
en la cláusula AND. Para determinar si esta unión inversa de la tabla base es
un cuello de botella de rendimiento, inspecciona el plan de ejecución de la consulta en el visualizador: si
el operador Index scan devuelve muchas filas que, luego, se filtran
después de unirse con el operador Table scan en la tabla base (lo que genera
una latencia o un tiempo de CPU altos en la rama Table scan en relación con la cantidad final
de filas devueltas), la unión inversa es un cuello de botella.
Si la unión posterior de la tabla base es el cuello de botella de la consulta, la solución recomendada
es agregar la columna adicional en la condición AND a la cláusula STORING
del índice secundario para que Spanner pueda evaluar ambas
condiciones directamente desde el índice sin leer la tabla base:
CREATE INDEX AlbumsByAlbumTitleStoringReleaseDate
  ON Albums(AlbumTitle)
  STORING (ReleaseDate);
Si no es viable modificar el índice, una alternativa es volver a escribir la consulta para
realizar una intersección de ambos índices con INTERSECT DISTINCT y, luego,
unir las claves primarias coincidentes a la tabla base Albums:
SELECT union_a.AlbumId, a.ReleaseDate, a.AlbumTitle FROM
  (SELECT a1.SingerId, a1.AlbumId
  FROM Albums @{force_index=AlbumsByReleaseDate} AS a1
  WHERE a1.ReleaseDate = '2023-09-07'
  INTERSECT DISTINCT
  SELECT a2.SingerId, a2.AlbumId
  FROM Albums @{force_index=AlbumsByAlbumTitle} AS a2
  WHERE a2.AlbumTitle = 'Aardvark') AS union_a
JOIN Albums AS a
  ON a.SingerId = union_a.SingerId AND a.AlbumId = union_a.AlbumId;
En el siguiente diagrama del plan de ejecución, se muestra la consulta reescrita. Observa cómo el
plan usa dos operadores Index scan (on AlbumsByAlbumTitle y
on AlbumsByReleaseDate) para encontrar las claves de intersección antes de realizar la
Table scan en la tabla base Albums:

Si el filtrado en varias columnas es un patrón frecuente en tu carga de trabajo, considera usar la búsqueda en el texto completo de varias columnas en lugar de índices secundarios. Para obtener más información, consulta Realiza una búsqueda de varias columnas.
Optimiza las uniones
Cuando Spanner ejecuta una consulta que une varias tablas, el optimizador de consultas elige el orden de unión (la secuencia en la que se unen las tablas) y el método de unión (el algoritmo que se usa para combinar filas de dos entradas, como una unión de aplicación, una unión de hash o una unión de combinación). Si una consulta con una unión es más lenta de lo esperado, puedes usar una sugerencia de consulta para indicarle a Spanner que use un orden de unión o un método de unión diferente. Esto cambia el plan de ejecución, pero no los resultados que se muestran. Por ejemplo:
GoogleSQL
Orden de unión forzada:
SELECT *
FROM Singers AS s JOIN@{FORCE_JOIN_ORDER=TRUE} Albums AS a
ON s.SingerId = a.SingerId
WHERE s.LastName LIKE '%x%' AND a.AlbumTitle LIKE '%love%';
Cambia el método de unión:
SELECT *
FROM Singers AS s JOIN@{JOIN_METHOD=HASH_JOIN} Albums AS a
ON s.SingerId = a.SingerId;
PostgreSQL
Orden de unión forzada:
SELECT *
FROM Singers AS s JOIN/*@ FORCE_JOIN_ORDER=TRUE */ Albums AS a
ON s.SingerId = a.SingerId
WHERE s.LastName LIKE '%x%' AND a.AlbumTitle LIKE '%love%';
Cambia el método de unión:
SELECT *
FROM Singers AS s JOIN/*@ JOIN_METHOD=HASH_JOIN */ Albums AS a
ON s.SingerId = a.SingerId;
En las siguientes secciones, se proporcionan antecedentes que pueden ayudarte a determinar qué órdenes y métodos de unión pueden mejorar el rendimiento de las consultas.
Método de unión y análisis
Spanner admite varios métodos de unión, y la elección del método afecta directamente la forma en que Spanner analiza las tablas o los índices subyacentes:
- Aplicar unión (conocida en algunos sistemas como unión de búsqueda o unión de bucle anidado): ejecuta su lado derecho ("mapa") una vez para cada fila del lado izquierdo ("entrada"). Debido a que cada búsqueda de la derecha usa valores de la fila de la izquierda actual, las columnas de unión de la izquierda se pueden usar como una clave de búsqueda en la derecha. Una unión de aplicación distribuida funciona de manera similar a una unión de aplicación local, pero agrupa las filas en lotes para una comunicación más eficiente entre las divisiones en una unión distribuida.
- Unión de hash: Lee filas de una entrada para compilar una tabla de hash en la memoria en las claves de unión y, luego, analiza la otra entrada para buscar coincidencias en la tabla de hash.
- Unión de combinación: lee ambas entradas en orden de clasificación en las claves de unión y combina las filas que coinciden en un solo pase.
Por ejemplo, considera la siguiente consulta que une Singers y Albums:
SELECT s.*, a.AlbumTitle
FROM Singers AS s
JOIN Albums AS a ON s.SingerId = a.SingerId
WHERE s.SingerId = 2 AND a.AlbumId = 1;
Con una unión de aplicación, s.SingerId = a.SingerId actúa como una condición de búsqueda en el
lado derecho de la unión, por lo que la consulta solo tiene que leer una fila de la tabla
Albums.
Por el contrario, en una unión hash o de combinación, las entradas izquierda y derecha se leen de forma independiente, por lo que la condición de unión no proporciona una clave de búsqueda de un lado al otro. En el peor de los casos, una unión de hash o combinación realiza un análisis de tabla completa de cada entrada.
En las consultas interactivas y transaccionales, la mayoría de las uniones usan índices, por lo que la aplicación distribuida es el tipo de unión más común en Spanner. Sin embargo, a veces, una unión hash o de combinación es una mejor opción, ya que leer un rango contiguo de filas es mucho más rápido que realizar la misma cantidad de búsquedas dispersas de una sola fila. La compensación es si es más rápido buscar menos filas (con una unión de aplicación) o analizar un rango contiguo más grande de filas (con una unión de hash o combinación). Para obtener más información sobre esta compensación, consulta Lecturas secuenciales frente a búsquedas dispersas.
Para las consultas que leen miles de filas, si hay un índice disponible en la clave de unión, suele ser más seguro usar una unión de aplicación distribuida. Esto se debe a que el costo de la unión de aplicación es proporcional a la cantidad de filas unidas, mientras que con una unión de hash o combinación, el costo puede ser proporcional al tamaño total de la tabla. Para consultas más grandes (como las que procesan millones de filas), usar una unión hash o de combinación podría ofrecer una mejora significativa del rendimiento.
Para obtener más información sobre los operadores y las sugerencias de unión, consulta los siguientes recursos:
- Aplicar unión
- Aplicación distribuida
- Unión hash
- Unión por combinación
- Referencia de métodos de unión
Orden de las uniones
Al igual que en otros sistemas de administración de base de datos relacional (RDBMS), ordena las uniones para mantener el tamaño del resultado intermedio lo más pequeño posible. Esto significa filtrar los datos lo antes posible y aplazar las coincidencias grandes lo más tarde posible.
Si proporcionas la sugerencia FORCE_JOIN_ORDER=TRUE, Spanner ejecuta
las uniones en el orden exacto en el que aparecen en el texto de la consulta. Mueve las uniones
con filtros muy selectivos antes en la consulta y mueve las uniones con coincidencias
grandes más adelante en la consulta.
Optimiza las agregaciones
Las siguientes técnicas pueden ayudarte a reducir la cantidad de filas analizadas y ordenadas durante las consultas de agregación.
Recupera una fila por prefijo de clave
Un patrón de agregación común es recuperar una fila por prefijo de clave (por
ejemplo, la fila con el número de versión o la marca de tiempo más altos). En
GoogleSQL, la forma más eficiente de hacerlo es usar ANY_VALUE
con HAVING MAX, que encuentra la fila con el valor máximo y devuelve la
columna solicitada en un solo pase de agregación sin requerir una unión de tabla con sí misma ni
una ordenación completa. Por ejemplo, en la siguiente consulta, se agrupa la tabla Concerts por
ConcertDate y se devuelve el BeginTime del concierto con la EndTime
más reciente para cada fecha:
SELECT ConcertDate, ANY_VALUE(BeginTime HAVING MAX(EndTime))
FROM Concerts
GROUP BY ConcertDate;
Verifica la existencia de filas
Para verificar si una tabla tiene filas o filas que coinciden con una condición específica,
usa LIMIT en lugar de COUNT. Por ejemplo:
SELECT 1 FROM Albums LIMIT 1;
Aumenta el paralelismo
Spanner divide las tablas y los índices en rangos de claves primarias contiguos
llamados divisiones, que se pueden procesar en paralelo en varios
servidores. Por lo general, Spanner elige el paralelismo de consultas para equilibrar
la latencia y la eficiencia. Por ejemplo, si una consulta tiene una cláusula LIMIT, puede
usar menos paralelismo para evitar desperdiciar el trabajo que descarta el límite. La cantidad
de divisiones analizadas por la consulta limita el grado máximo de paralelismo.
En el caso de las consultas con límites o análisis grandes, puedes establecer la sugerencia de sentencia USE_ADDITIONAL_PARALLELISM=TRUE para indicarle a Spanner que optimice principalmente la latencia:
GoogleSQL
@{USE_ADDITIONAL_PARALLELISM=TRUE}
SELECT *
FROM Singers
LIMIT 10;
PostgreSQL
/*@ USE_ADDITIONAL_PARALLELISM=TRUE */
SELECT *
FROM Singers
LIMIT 10;
Esta sugerencia podría saturar la CPU en una división determinada. Si la consulta es de larga duración, envíala con prioridad de solicitud media para evitar aumentar la latencia de otras consultas de prioridad alta.
Límites de Optimize
Si una consulta contiene una cláusula LIMIT, pero analiza muchas más filas que el valor
límite, verifica las siguientes causas posibles:
Falta el índice
Si una consulta tiene un filtro que no se puede satisfacer con un índice, el plan de consulta
analiza la tabla base o un índice que no proporciona el orden de clasificación
requerido. Luego, la consulta ordena por completo los datos coincidentes antes de evaluar la
cláusula LIMIT.
Para resolver este problema, considera agregar un índice secundario que abarque las
columnas de filtro. Si el índice se define como NULL_FILTERED (lo que significa que
excluye las filas en las que una columna indexada es NULL), asegúrate de que el predicado de la consulta
incluya IS NOT NULL para que el optimizador pueda usar el índice. Para obtener más
información sobre cómo crear índices secundarios, consulta
Índices secundarios.
Orden completo
Si existe un índice en la columna filtrada, pero el índice no proporciona el
orden de clasificación que requiere la cláusula ORDER BY, Spanner debe leer
todas las filas que coincidan y pasarlas a un operador Sort en el plan de ejecución de la consulta
antes de aplicar el LIMIT.
Para evitar una ordenación completa, especifica las columnas en tu sentencia CREATE INDEX en
el siguiente orden:
- Primero, cualquier columna que tenga una condición de igualdad (
=) oINen la consulta - Luego, las mismas columnas que la cláusula
ORDER BYde la consulta, en el mismo orden y con la misma dirección de ordenamiento (ASCoDESC)
Por ejemplo, supongamos que tienes una tabla Users (que no se muestra en el esquema de ejemplo anterior) y deseas optimizar la siguiente consulta:
SELECT * FROM Users
WHERE Name='Alex'
ORDER BY LastLogin DESC
LIMIT 10;
Crea un índice en (Name, LastLogin DESC) para que Spanner pueda leer
las 10 filas superiores directamente en el orden del índice sin ordenar:
CREATE INDEX UsersByNameLastLogin ON Users(Name, LastLogin DESC);
Ordena por sufijo de clave
Incluso cuando un índice incluye la columna ORDER BY como un sufijo de la clave de índice,
una consulta podría analizar filas adicionales si hay un predicado IN, OR o de rango
en una de las columnas de prefijo del índice.
Por ejemplo, considera la siguiente consulta que usa el índice (Name, LastLogin DESC)
del ejemplo de ordenamiento completo anterior, que no forma parte del esquema
de ejemplo:
SELECT *
FROM Users
WHERE Name IN ('Alex','Amal')
ORDER BY LastLogin DESC
LIMIT 10;
Debido a que Name coincide con varios valores, las filas que coinciden no se almacenan en un
solo rango ordenado de forma global por LastLogin DESC. Puedes reestructurar la consulta
con UNNEST y una unión para que Spanner recupere las filas superiores de
cada valor de Name por separado y, luego, las combine:
SELECT *
FROM UNNEST(['Alex','Amal']) AS Name
JOIN Users AS u ON u.Name = Name
ORDER BY LastLogin DESC
LIMIT 10;
Esta reescritura genera análisis más eficientes, ya que lee la cantidad mínima de
filas de cada clave de prefijo vinculada ('Alex' y 'Amal'), seguida de una pequeña
ordenación de los resultados combinados para producir el LIMIT final.
Un caso especial común de este patrón es un prefijo de fragmento, en el que se agrega una columna ShardId como la columna de clave principal para distribuir las operaciones de escritura entre las divisiones.
Por ejemplo, la siguiente consulta analiza 32 fragmentos (de 0 a 31):
SELECT *
FROM Users
WHERE ShardId BETWEEN 0 AND 31
ORDER BY LastLogin DESC
LIMIT 10;
Para optimizar esta consulta, enumera de forma explícita los IDs de fragmento (del 0 al 31)
y únelos con la tabla Users usando GENERATE_ARRAY en
GoogleSQL o generate_series en PostgreSQL:
GoogleSQL
SELECT *
FROM GENERATE_ARRAY(0, 31) AS id
JOIN Users AS u ON u.ShardId = id
ORDER BY LastLogin DESC
LIMIT 10;
PostgreSQL
SELECT *
FROM generate_series(0, 31) AS id
JOIN Users AS u ON u.ShardId = id
ORDER BY LastLogin DESC
LIMIT 10;
Para obtener más información sobre estas funciones de generación de arrays y series, consulta
GENERATE_ARRAY para GoogleSQL y
generate_series para PostgreSQL.
Comprende el rendimiento de los análisis
En las siguientes secciones, se describen las causas más comunes de los análisis lentos de tablas o índices, y cómo mitigarlos.
Se eliminaron filas
De forma predeterminada, Spanner conserva las filas borradas o reemplazadas durante una hora para admitir lecturas históricas y la recuperación de un momento determinado, y puedes aumentar este período de retención hasta siete días. Después de que una versión de fila antigua pasa el período de retención, se vuelve apta para quitarse durante la compactación del almacenamiento en segundo plano, lo que puede tardar hasta siete días más. Hasta que se compacte una versión de fila anterior, es posible que las consultas que analizan el rango de claves deban leer las versiones de fila borradas o reemplazadas y filtrarlas. Para obtener más información sobre la retención de datos, consulta Recuperación de un momento determinado (PITR).
Para verificar si una consulta analizó filas borradas, inspecciona la métrica Filas borradas que se analizaron en la vista de detalles del operador Análisis en el panel de detalles del visualizador del plan de consulta.
Para mitigar los análisis lentos causados por una gran cantidad de filas borradas recientemente, puedes activar una compactación de datos manual. Para obtener más información, consulta Compactación manual de datos.
Filas grandes
En el caso de las filas pequeñas (hasta unos cientos de bytes), el costo de un análisis depende principalmente de la cantidad de filas analizadas. A medida que aumenta el tamaño de las filas, el tamaño en bytes de las filas se vuelve más significativo. En el almacenamiento orientado a filas, el tamaño total de la fila afecta el rendimiento del análisis, no solo el tamaño de las columnas proyectadas por la consulta.
Para las consultas analíticas con muchos análisis en tablas grandes, considera usar el motor de columnas. Para obtener más información, consulta Supervisa el motor de columnas.
Para las consultas en conjuntos de filas más estrechos, si una tabla tiene columnas grandes y columnas más pequeñas que se consultan con frecuencia, considera las siguientes opciones:
- Separa las columnas más grandes en un grupo de localidad no predeterminado (que almacena las columnas especificadas por separado en el disco del resto de la tabla) o en una tabla secundaria separada para que los análisis de las columnas más pequeñas no lean los datos de las columnas grandes. Para obtener más información, consulta Crea y administra grupos de localidad.
- Para optimizar aún más el tiempo de lectura, duplica las columnas más pequeñas en un
índice secundario con la misma clave primaria que la tabla base y usa la
cláusula
STORINGpara incluir las columnas más pequeñas.
Por ejemplo, supongamos que una tabla Documents (que no forma parte del esquema de ejemplo
anterior) almacena una cadena Metadata pequeña junto con un objeto JSON Content
grande. Puedes crear un índice secundario que almacene solo Metadata para que las consultas
que no necesitan Content puedan analizar el índice más pequeño en lugar de la tabla base:
CREATE TABLE Documents (
  Id INT64,
  Metadata STRING(MAX),
  Content JSON
) PRIMARY KEY (Id);

CREATE INDEX DocumentMetadata ON Documents(Id) STORING (Metadata);
Datos intercalados grandes
Cuando las tablas se intercalan, Spanner almacena físicamente cada fila superior junto con sus filas secundarias intercaladas en orden de clave. Si una tabla superior tiene muchas filas secundarias intercaladas o una tabla secundaria tiene muchas menos filas que sus tablas superiores o hermanas, los análisis de rango en la tabla más pequeña son más dispersos y menos eficientes, ya que el análisis debe omitir las filas intercaladas de las otras tablas.
Por ejemplo, considera el siguiente esquema (que no forma parte del esquema de ejemplo
anterior), en el que Transaction y AuthorizedPerson se intercalan en
Account:
CREATE TABLE Account (
  AccountId INT64,
  -- Additional columns omitted
) PRIMARY KEY (AccountId);

CREATE TABLE Transaction (
  AccountId INT64,
  TransactionId STRING(MAX),
  -- Additional columns omitted
) PRIMARY KEY (AccountId, TransactionId),
INTERLEAVE IN PARENT Account;

CREATE TABLE AuthorizedPerson (
  AccountId INT64,
  SignerId INT64,
  Name STRING(MAX),
  -- Additional columns omitted
) PRIMARY KEY (AccountId, SignerId),
INTERLEAVE IN PARENT Account;
Si cada fila de Account tiene miles de filas de Transaction y solo unas pocas filas de AuthorizedPerson, un análisis de rango en Account o AuthorizedPerson tiene un costo por fila más alto que un análisis de rango en Transaction (aunque su costo total sigue siendo más bajo). Esto sucede porque un análisis de Transaction lee muchas
filas de Transaction contiguas a la vez, mientras que un análisis de Account o
AuthorizedPerson tiene menos filas adyacentes de la misma tabla y debe omitir
las filas de Transaction intercaladas.
Para optimizar los análisis de rango en la tabla más dispersa (Account o AuthorizedPerson),
crea un índice secundario no intercalado que duplique las columnas que necesita
tu consulta, de forma similar al enfoque para las filas grandes:
CREATE INDEX AuthorizedPersonByAccount
  ON AuthorizedPerson(AccountId, SignerId)
  STORING (Name);
Usa la ejecución orientada a lotes
Spanner puede ejecutar análisis de consultas y operadores de consultas con un método orientado a filas (procesando una fila a la vez) o un método orientado a lotes (procesando bloques de filas a la vez). En las siguientes secciones, se explica cómo inspeccionar y configurar los análisis orientados a lotes y la ejecución de operadores orientados a lotes.
Análisis orientados a lotes
Algunas consultas de Spanner podrían beneficiarse del uso de un método de procesamiento orientado a lotes cuando se analizan datos, en lugar del método de procesamiento orientado a filas más común. El procesamiento de análisis por lotes es una forma más eficiente de procesar grandes volúmenes de datos de una sola vez y permite que las consultas logren un menor uso de CPU y una menor latencia.
La operación de análisis de Spanner siempre comienza la ejecución en el método orientado a filas. Durante este tiempo, Spanner recopila varias métricas de tiempo de ejecución. Luego, Spanner aplica un conjunto de heurísticas basadas en el resultado de estas métricas para determinar el método de análisis óptimo. Cuando es apropiado, Spanner cambia a un método de procesamiento orientado a lotes para ayudar a mejorar la capacidad de procesamiento y el rendimiento del análisis.
Casos de uso habituales
Las consultas con las siguientes características suelen beneficiarse del procesamiento orientado a lotes:
- Análisis grandes de datos que se actualizan con poca frecuencia
- Análisis con predicados en columnas de ancho fijo
- Análisis con recuentos de búsqueda grandes (una búsqueda usa un índice para recuperar registros)
Casos de uso sin mejoras de rendimiento
No todas las consultas se benefician del procesamiento orientado a lotes. Los siguientes tipos de consultas tienen un mejor rendimiento con el procesamiento de análisis orientado a filas:
- Consultas de búsqueda de puntos: Son consultas que recuperan solo una fila.
- Consultas de análisis pequeñas: Son análisis de tablas que analizan solo unas pocas filas, a menos que tengan recuentos de búsqueda grandes.
- Consultas con una cláusula
LIMIT: Son consultas que dejan de analizar después de devolver una cantidad fija de filas. - Consultas que leen datos con alta deserción: Consultas en las que se actualiza con frecuencia más del 10% de los datos leídos.
- Consultas con filas que contienen valores grandes: Son consultas en filas que contienen valores superiores a 32,000 bytes (antes de la compresión) en una sola columna.
Verifica el método de análisis que usa una consulta
Para verificar si tu consulta usa el procesamiento orientado a lotes, el procesamiento orientado a filas o cambia de forma automática entre los dos métodos de análisis, sigue estos pasos:
En la consola de Google Cloud , ve a la página Instancias de Spanner.
Haz clic en el nombre de la instancia con la consulta que deseas investigar.
En la tabla Bases de datos, haz clic en la base de datos con la consulta que deseas investigar.
En el menú de navegación de Spanner, haz clic en Spanner Studio.
Haz clic en Nueva pestaña del editor de SQL o Nueva pestaña.
En el editor de consultas, ingresa tu consulta.
Haz clic en Ejecutar.
Spanner ejecuta la consulta y muestra los resultados.
En el panel del editor de consultas, haz clic en la pestaña Explicación.
Spanner muestra el visualizador del plan de ejecución de consultas. Cada tarjeta del gráfico representa un iterador. Para obtener más información sobre los planes de ejecución, consulta Planes de ejecución de consultas.
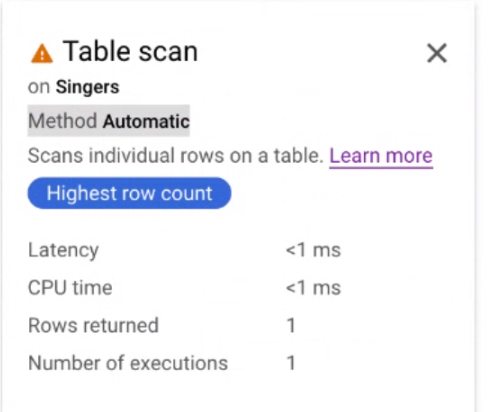
Haz clic en la tarjeta del iterador Análisis de tabla para abrir un panel de información.
En el panel de información, se muestra información contextual sobre el análisis seleccionado, incluido el método de análisis (Método). Automático indica que Spanner determina el método de análisis. Otros valores posibles incluyen Lote para el procesamiento orientado a lotes y Fila para el procesamiento orientado a filas, como se muestra en la siguiente imagen:
Aplica el método de análisis que usa una consulta
Para optimizar el rendimiento de las consultas, Spanner elige el método de análisis óptimo para tu consulta. Google recomienda que uses este método de análisis predeterminado. Sin embargo, puede haber situaciones en las que quieras aplicar un tipo específico de método de análisis.
Aplicar el análisis orientado a lotes
Puedes aplicar el análisis orientado a lotes a nivel de tabla y de sentencia.
Para aplicar el método de análisis orientado a lotes a nivel de la tabla, usa una sugerencia de tabla en tu consulta:
GoogleSQL
SELECT *
FROM (Singers@{SCAN_METHOD=BATCH} AS s
  JOIN Albums AS a ON s.SingerId = a.SingerId);
PostgreSQL
SELECT *
FROM (Singers/*@ scan_method=batch */ AS s
  JOIN Albums AS a ON s.SingerId = a.SingerId);
Para aplicar el método de análisis orientado a lotes a nivel de la instrucción, usa una sugerencia de instrucción en tu consulta:
GoogleSQL
@{SCAN_METHOD=BATCH}
SELECT *
FROM Singers;
PostgreSQL
/*@ scan_method=batch */
SELECT *
FROM Singers;
Cuando usas una sugerencia a nivel de la sentencia, se aplica a toda la consulta. Es preferible establecer la sugerencia a nivel de la tabla, ya que proporciona un control más detallado.
Forzar la búsqueda orientada a filas
Aunque Google no recomienda inhabilitar el método de análisis automático establecido por Spanner, puedes inhabilitarlo y usar el método de análisis orientado a filas para solucionar problemas, como diagnosticar la latencia.
Para inhabilitar la selección automática del método de análisis y aplicar el procesamiento de filas a nivel de la tabla, usa una sugerencia de tabla en tu consulta:
GoogleSQL
SELECT *
FROM (Singers@{SCAN_METHOD=ROW} AS s
  JOIN Albums AS a ON s.SingerId = a.SingerId);
PostgreSQL
SELECT *
FROM (Singers/*@ scan_method=row */ AS s
  JOIN Albums AS a ON s.SingerId = a.SingerId);
Para inhabilitar el método de análisis automático y aplicar el procesamiento de filas a nivel de la sentencia, usa una sugerencia de sentencia en tu consulta:
GoogleSQL
@{SCAN_METHOD=ROW}
SELECT *
FROM Singers;
PostgreSQL
/*@ scan_method=row */
SELECT *
FROM Singers;
Método de ejecución
Además de los análisis orientados a lotes, también puedes optimizar la ejecución de consultas aplicando el método de ejecución a nivel de la sentencia. Esto solo funciona para algunos operadores y es independiente del método de análisis, que solo usa el operador de análisis. Para obtener más información sobre los análisis orientados a lotes, consulta la sección Análisis orientados a lotes de este documento.
De forma predeterminada, la mayoría de los operadores se ejecutan en el método orientado a filas, que procesa los datos de una fila a la vez. Los operadores vectorizados se ejecutan con el método orientado a lotes para ayudar a mejorar la capacidad de procesamiento y el rendimiento de la ejecución. Estos operadores procesan los datos de a un bloque por vez. Cuando un operador necesita procesar muchas filas, el método de ejecución orientado a lotes suele ser más eficiente.
Método de ejecución frente al método de análisis
El método de ejecución de consultas es independiente del método de análisis de consultas. Puedes establecer uno, ambos o ninguno de estos métodos en la sugerencia de consulta.
El método de ejecución de consultas se refiere a la forma en que los operadores de consultas procesan los resultados intermedios y cómo interactúan entre sí, mientras que el método de análisis se refiere a la forma en que el operador de análisis interactúa con la capa de almacenamiento de Spanner.
Aplica el método de ejecución que usa la consulta
Para optimizar el rendimiento de las consultas, Spanner elige el método de ejecución óptimo para tu consulta en función de varias heurísticas. Google recomienda que uses este método de ejecución predeterminado. Sin embargo, puede haber situaciones en las que quieras aplicar un tipo específico de método de ejecución.
Puedes aplicar tu método de ejecución a nivel de la sentencia. La sugerencia de consulta EXECUTION_METHOD es un aviso, no una directiva. En última instancia,
el optimizador de consultas decide qué método usar para cada operador individual.
Para aplicar el método de ejecución orientado a lotes a nivel de la sentencia, usa una sugerencia de sentencia en tu consulta:
GoogleSQL
@{EXECUTION_METHOD=BATCH}
SELECT *
FROM Singers;
PostgreSQL
/*@ EXECUTION_METHOD=BATCH */
SELECT *
FROM Singers;
Aunque Google no recomienda inhabilitar el método de ejecución automático establecido por Spanner, puedes inhabilitarlo y usar el método de ejecución orientado a filas para solucionar problemas, como diagnosticar la latencia.
Para inhabilitar el método de ejecución automático y aplicar el método de ejecución orientado a filas a nivel de la sentencia, usa una sugerencia de sentencia en tu consulta:
GoogleSQL
@{EXECUTION_METHOD=ROW}
SELECT *
FROM Singers;
PostgreSQL
/*@ EXECUTION_METHOD=ROW */
SELECT *
FROM Singers;
Verifica qué método de ejecución está habilitado
No todos los operadores de Spanner admiten los métodos de ejecución orientados a lotes y a filas. Para cada operador, el visualizador del plan de ejecución de consultas muestra el método de ejecución en la tarjeta del iterador. Si el método de ejecución está orientado a lotes, se muestra Lote. Si está orientada a filas, se muestra Fila. Para obtener más información sobre el visualizador, consulta Planes de ejecución de consultas.
Si los operadores de tu consulta se ejecutan con diferentes métodos de ejecución, los
adaptadores de métodos de ejecución DataBlockToRowAdapter y RowToDataBlockAdapter
aparecen entre los operadores para mostrar el cambio en el método de ejecución. Para obtener más
información sobre estos operadores, consulta
DataBlockToRowAdapter y
RowToDataBlockAdapter.