


Cette page décrit les techniques permettant d'ajuster les performances des requêtes Spanner. Avant de commencer à régler vos requêtes, consultez les pages suivantes, qui expliquent les concepts et les outils de base utilisés pour le réglage des requêtes :
- Bonnes pratiques SQL
- Présentation du visualiseur de plan de requête
- Statistiques sur les requêtes
- Opérateurs d'exécution de requêtes
Les requêtes et les plans d'exécution de cette page sont basés sur le schéma de base de données suivant :
CREATE TABLE Singers (
  SingerId   INT64 NOT NULL,
  FirstName  STRING(1024),
  LastName   STRING(1024),
  SingerInfo BYTES(MAX),
  BirthDate  DATE
) PRIMARY KEY(SingerId);

CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);

CREATE TABLE Albums (
  SingerId        INT64 NOT NULL,
  AlbumId         INT64 NOT NULL,
  AlbumTitle      STRING(MAX),
  MarketingBudget INT64
) PRIMARY KEY(SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);

CREATE INDEX AlbumsByAlbumTitle2 ON Albums(AlbumTitle) STORING (MarketingBudget);

CREATE TABLE Songs (
  SingerId  INT64 NOT NULL,
  AlbumId   INT64 NOT NULL,
  TrackId   INT64 NOT NULL,
  SongName  STRING(MAX),
  Duration  INT64,
  SongGenre STRING(25)
) PRIMARY KEY(SingerId, AlbumId, TrackId),
  INTERLEAVE IN PARENT Albums ON DELETE CASCADE;

CREATE INDEX SongsBySingerAlbumSongNameDesc ON Songs(SingerId, AlbumId, SongName DESC), INTERLEAVE IN Albums;

CREATE INDEX SongsBySongName ON Songs(SongName);

CREATE TABLE Concerts (
  VenueId      INT64 NOT NULL,
  SingerId     INT64 NOT NULL,
  ConcertDate  DATE NOT NULL,
  BeginTime    TIMESTAMP,
  EndTime      TIMESTAMP,
  TicketPrices ARRAY<INT64>
) PRIMARY KEY(VenueId, SingerId, ConcertDate);
Vous pouvez utiliser les instructions LMD (langage de manipulation de données) suivantes pour ajouter des données à ces tables :
INSERT INTO Singers (SingerId, FirstName, LastName, BirthDate)
VALUES (1, "Marc", "Richards", "1970-09-03"),
       (2, "Catalina", "Smith", "1990-08-17"),
       (3, "Alice", "Trentor", "1991-10-02"),
       (4, "Lea", "Martin", "1991-11-09"),
       (5, "David", "Lomond", "1977-01-29");

INSERT INTO Albums (SingerId, AlbumId, AlbumTitle)
VALUES (1, 1, "Total Junk"),
       (1, 2, "Go, Go, Go"),
       (2, 1, "Green"),
       (2, 2, "Forever Hold Your Peace"),
       (2, 3, "Terrified"),
       (3, 1, "Nothing To Do With Me"),
       (4, 1, "Play");

INSERT INTO Songs (SingerId, AlbumId, TrackId, SongName, Duration, SongGenre)
VALUES (2, 1, 1, "Let's Get Back Together", 182, "COUNTRY"),
       (2, 1, 2, "Starting Again", 156, "ROCK"),
       (2, 1, 3, "I Knew You Were Magic", 294, "BLUES"),
       (2, 1, 4, "42", 185, "CLASSICAL"),
       (2, 1, 5, "Blue", 238, "BLUES"),
       (2, 1, 6, "Nothing Is The Same", 303, "BLUES"),
       (2, 1, 7, "The Second Time", 255, "ROCK"),
       (2, 3, 1, "Fight Story", 194, "ROCK"),
       (3, 1, 1, "Not About The Guitar", 278, "BLUES");
Recommandations de benchmark
Les statistiques de performances les plus fiables proviennent de l'exécution d'un test de charge qui utilise différentes valeurs de paramètres de requête aléatoires à partir d'une instance de machine virtuelle (VM) Google Cloud située dans la même région que l'instance cible.
Évitez d'utiliser Spanner Studio ou le mode QueryMode.PROFILE pour évaluer les requêtes, car ces outils ne reproduisent pas les environnements réseau et client de production réels. Toutefois, après qu'un test de charge a identifié un problème de performances, les plans de requête (qu'ils soient échantillonnés dans Insights sur les requêtes ou exécutés à la demande dans Spanner Studio) sont des outils utiles pour examiner ce problème spécifique.
Comprendre les plans d'exécution des requêtes
Dans l'outil de visualisation du plan de requête, un plan d'exécution de requête est représenté sous la forme d'une arborescence d'opérateurs, où chaque opérateur lit les lignes de ses opérateurs enfants, les traite et transmet les résultats à son opérateur parent.
Pour la plupart des opérateurs du plan visuel, la latence signalée est additive (elle ne reflète que le temps passé dans cet opérateur). Toutefois, pour les opérateurs Distributed union et Distributed apply, la latence signalée est cumulative : elle inclut à la fois le temps passé dans l'opérateur distribué lui-même et le temps passé dans ses opérateurs enfants. Pour en savoir plus sur ces opérateurs, consultez Union distribuée et Application distribuée.
Par exemple, dans le plan d'union distribué suivant, la fiche Distributed union indique une latence totale de 8,46 ms, tandis que son opérateur enfant Stream aggregate indique 3,51 ms et Table scan indique 1 ms. Étant donné que la latence Distributed union est cumulée, l'opérateur Distributed union lui-même n'ajoute qu'environ 5 ms de latence, au lieu de 8 ms :

Dans l'exemple suivant, la fiche Distributed union indique une latence de 13,69 ms, tandis que ses opérateurs enfants (Stream aggregate à < 1 ms, Cross apply à 1,14 ms, Table scan sur Albums à < 1 ms, Filter scan à 1 ms et Table scan sur Singers à 10,85 ms) représentent environ 13 ms. Par conséquent, l'opérateur Distributed union lui-même ajoute moins de 1 ms de latence, plutôt que 13 ms :

Vous pouvez également afficher les valeurs de latence cumulées dans le panneau de résumé de l'opérateur.
Combiner plusieurs index
Lorsqu'une requête filtre plusieurs colonnes indexées à l'aide de conditions OR ou AND, Spanner peut parfois combiner plusieurs index secondaires pour éviter d'analyser l'intégralité de la table de base. Les exemples de cette section étendent la table Albums de l'exemple de schéma précédent en ajoutant une colonne ReleaseDate et un index secondaire AlbumsByReleaseDate :
CREATE TABLE Albums (
  SingerId        INT64 NOT NULL,
  AlbumId         INT64 NOT NULL,
  AlbumTitle      STRING(MAX),
  ReleaseDate     DATE,
  MarketingBudget INT64
) PRIMARY KEY(SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);

CREATE INDEX AlbumsByReleaseDate ON Albums(ReleaseDate);
Prenons l'exemple de la requête suivante, qui utilise une condition OR pour filtrer les prédicats de deux index secondaires distincts (AlbumsByAlbumTitle et AlbumsByReleaseDate) :
SELECT a.AlbumId, a.AlbumTitle, a.ReleaseDate
FROM Albums AS a
WHERE a.AlbumTitle = 'Play' OR a.ReleaseDate = '2023-09-07';
Lorsqu'une requête comporte une condition OR sur des prédicats de deux index distincts, Spanner peut utiliser l'optimisation basée sur les coûts pour lire les deux index et combiner les résultats (une union d'index). Vous pouvez également forcer cette optimisation en ajoutant l'indice de table INDEX_STRATEGY=FORCE_INDEX_UNION à la requête :
SELECT a.AlbumId, a.AlbumTitle, a.ReleaseDate
FROM Albums@{INDEX_STRATEGY=FORCE_INDEX_UNION} AS a
WHERE a.AlbumTitle = 'Play' OR a.ReleaseDate = '2023-09-07';
Pour en savoir plus sur les indications de table, consultez Indications de table.
Le diagramme de plan d'exécution suivant montre comment Spanner évalue cette condition OR (disjonction) en analysant chaque branche séparément et en combinant les résultats à l'aide des opérateurs Union all et Hash aggregate :

Ensuite, considérons une requête qui utilise une condition AND pour filtrer les deux colonnes indexées :
SELECT a.AlbumId, a.ReleaseDate, a.AlbumTitle
FROM Albums AS a
WHERE a.AlbumTitle = 'Aardvark' AND a.ReleaseDate = '2023-09-07';
Avec une condition AND, Spanner sélectionne un seul index par défaut, puis rejoint la table de base, si nécessaire, pour évaluer la condition restante dans la clause AND. Pour déterminer si cette jointure de table de base constitue un goulot d'étranglement des performances, inspectez le plan d'exécution de la requête dans le visualiseur : si l'opérateur Index scan renvoie de nombreuses lignes qui sont ensuite filtrées après la jointure avec l'opérateur Table scan sur la table de base (ce qui entraîne une latence ou un temps CPU élevés sur la branche Table scan par rapport au nombre final de lignes renvoyées), la jointure est un goulot d'étranglement.
Si la jointure de la table de base est le goulot d'étranglement de la requête, la solution recommandée consiste à ajouter la colonne supplémentaire de la condition AND à la clause STORING de l'index secondaire afin que Spanner puisse évaluer les deux conditions directement à partir de l'index sans lire la table de base :
CREATE INDEX AlbumsByAlbumTitleStoringReleaseDate
  ON Albums(AlbumTitle)
  STORING (ReleaseDate);
Si la modification de l'index n'est pas possible, vous pouvez réécrire la requête pour effectuer une intersection des deux index à l'aide de INTERSECT DISTINCT, puis joindre les clés primaires correspondantes à la table de base Albums :
SELECT union_a.AlbumId, a.ReleaseDate, a.AlbumTitle FROM
  (SELECT a1.SingerId, a1.AlbumId
  FROM Albums @{force_index=AlbumsByReleaseDate} AS a1
  WHERE a1.ReleaseDate = '2023-09-07'
  INTERSECT DISTINCT
  SELECT a2.SingerId, a2.AlbumId
  FROM Albums @{force_index=AlbumsByAlbumTitle} AS a2
  WHERE a2.AlbumTitle = 'Aardvark') AS union_a
JOIN Albums AS a
  ON a.SingerId = union_a.SingerId AND a.AlbumId = union_a.AlbumId;
Le diagramme de plan d'exécution suivant montre la requête réécrite. Notez que le plan utilise deux opérateurs Index scan (on AlbumsByAlbumTitle et on AlbumsByReleaseDate) pour trouver les clés d'intersection avant d'effectuer l'opération Table scan sur la table de base Albums :

Si le filtrage sur plusieurs colonnes est un modèle fréquent dans votre charge de travail, envisagez d'utiliser la recherche en texte intégral sur plusieurs colonnes au lieu d'index secondaires. Pour en savoir plus, consultez Effectuer une recherche sur plusieurs colonnes.
Optimiser les jointures
Lorsque Spanner exécute une requête qui joint plusieurs tables, l'optimiseur de requête choisit à la fois l'ordre de jointure (la séquence dans laquelle les tables sont jointes) et la méthode de jointure (l'algorithme utilisé pour combiner les lignes de deux entrées, comme une jointure d'application, une jointure de hachage ou une jointure de fusion). Si une requête avec une jointure est plus lente que prévu, vous pouvez utiliser une indication de requête pour demander à Spanner d'utiliser un ordre de jointure ou une méthode de jointure différents. Cela modifie le plan d'exécution, mais pas les résultats renvoyés. Exemple :
GoogleSQL
Forcer l'ordre de jointure :
SELECT *
FROM Singers AS s JOIN@{FORCE_JOIN_ORDER=TRUE} Albums AS a
ON s.SingerId = a.SingerId
WHERE s.LastName LIKE '%x%' AND a.AlbumTitle LIKE '%love%';
Modifier la méthode de participation :
SELECT *
FROM Singers AS s JOIN@{JOIN_METHOD=HASH_JOIN} Albums AS a
ON s.SingerId = a.SingerId;
PostgreSQL
Forcer l'ordre de jointure :
SELECT *
FROM Singers AS s JOIN/*@ FORCE_JOIN_ORDER=TRUE */ Albums AS a
ON s.SingerId = a.SingerId
WHERE s.LastName LIKE '%x%' AND a.AlbumTitle LIKE '%love%';
Modifier la méthode de participation :
SELECT *
FROM Singers AS s JOIN/*@ JOIN_METHOD=HASH_JOIN */ Albums AS a
ON s.SingerId = a.SingerId;
Les sections suivantes fournissent des informations qui peuvent vous aider à déterminer les ordres et les méthodes de jointure qui peuvent améliorer les performances des requêtes.
Méthode de participation et analyses
Spanner accepte plusieurs méthodes de jointure, et votre choix de méthode de jointure affecte directement la façon dont Spanner analyse les tables ou les index sous-jacents :
- Jointure d'application (appelée jointure de recherche ou jointure de boucle imbriquée dans certains systèmes) : exécute son côté droit ("mappage") une fois pour chaque ligne du côté gauche ("entrée"). Étant donné que chaque recherche à droite utilise les valeurs de la ligne de gauche actuelle, les colonnes de jointure de gauche peuvent être utilisées comme clé de recherche à droite. Une jointure d'application distribuée fonctionne de la même manière qu'une jointure d'application locale, mais regroupe les lignes pour une communication plus efficace entre les divisions d'une jointure distribuée.
- Jointure par hachage : lit les lignes d'une entrée pour créer une table de hachage en mémoire sur les clés de jointure, puis analyse l'autre entrée pour rechercher des correspondances dans la table de hachage.
- Jointure par fusion : lit les deux entrées dans l'ordre de tri sur les clés de jointure et fusionne les lignes correspondantes en un seul passage.
Prenons l'exemple de la requête suivante, qui joint Singers et Albums :
SELECT s.*, a.AlbumTitle
FROM Singers AS s
JOIN Albums AS a ON s.SingerId = a.SingerId
WHERE s.SingerId = 2 AND a.AlbumId = 1;
Avec une jointure d'application, s.SingerId = a.SingerId agit comme une condition de recherche sur le côté droit de la jointure. La requête ne doit donc lire qu'une seule ligne de la table Albums.
En revanche, dans une jointure de hachage ou une jointure de fusion, les entrées de gauche et de droite sont lues indépendamment l'une de l'autre. Par conséquent, la condition de jointure ne fournit pas de clé de recherche d'un côté à l'autre. Dans le pire des cas, une jointure par hachage ou par fusion effectue une analyse complète de chaque entrée.
Dans les requêtes interactives et transactionnelles, la plupart des jointures utilisent des index. L'application distribuée est donc le type de jointure le plus courant dans Spanner. Toutefois, une jointure par hachage ou par fusion est parfois un meilleur choix, car la lecture d'une plage de lignes contiguës est beaucoup plus rapide que l'exécution du même nombre de recherches de lignes uniques dispersées. Le compromis consiste à déterminer s'il est plus rapide de rechercher moins de lignes (à l'aide d'une jointure d'application) ou d'analyser une plage de lignes contiguës plus importante (à l'aide d'une jointure de hachage ou de fusion). Pour en savoir plus sur ce compromis, consultez Lectures séquentielles et recherches dispersées.
Pour les requêtes qui lisent des milliers de lignes, si un index est disponible sur la clé de jointure, il est généralement plus sûr d'utiliser une jointure d'application distribuée. En effet, le coût de la jointure d'application est proportionnel au nombre de lignes jointes, tandis qu'avec une jointure de hachage ou de fusion, le coût peut être proportionnel à la taille totale de la table. Pour les requêtes plus volumineuses (par exemple, celles qui traitent des millions de lignes), l'utilisation d'une jointure par hachage ou par fusion peut améliorer considérablement les performances.
Pour en savoir plus sur les opérateurs et les indications de jointure, consultez les ressources suivantes :
Ordre de jointure
Comme dans d'autres systèmes de gestion de bases de données relationnelles (SGBDR), ordonnez les jointures de manière à réduire au maximum la taille des résultats intermédiaires. Cela signifie qu'il faut filtrer les données le plus tôt possible et différer les correspondances volumineuses le plus tard possible.
Si vous fournissez l'indice FORCE_JOIN_ORDER=TRUE, Spanner exécute les jointures dans l'ordre exact dans lequel elles apparaissent dans le texte de la requête. Déplacez les jointures avec des filtres très sélectifs plus tôt dans la requête, et déplacez les jointures avec des correspondances volumineuses plus tard dans la requête.
Optimiser les agrégations
Les techniques suivantes peuvent vous aider à réduire le nombre de lignes analysées et triées lors des requêtes d'agrégation.
Récupérer une ligne par préfixe de clé
Un modèle d'agrégation courant consiste à récupérer une ligne par préfixe de clé (par exemple, la ligne avec le numéro de version ou le code temporel le plus élevé). Dans GoogleSQL, le moyen le plus efficace d'y parvenir consiste à utiliser ANY_VALUE avec HAVING MAX, qui recherche la ligne avec la valeur maximale et renvoie la colonne demandée en une seule passe d'agrégation, sans nécessiter d'auto-jointure ni de tri complet. Par exemple, la requête suivante regroupe la table Concerts par ConcertDate et renvoie le BeginTime du concert avec la dernière EndTime pour chaque date :
SELECT ConcertDate, ANY_VALUE(BeginTime HAVING MAX(EndTime))
FROM Concerts
GROUP BY ConcertDate;
Vérifier l'existence d'une ligne
Pour vérifier si une table contient des lignes ou des lignes correspondant à une condition spécifique, utilisez LIMIT plutôt que COUNT. Exemple :
SELECT 1 FROM Albums LIMIT 1;
Augmenter le parallélisme
Spanner divise les tables et les index en plages de clés primaires contiguës appelées divisions, qui peuvent être traitées en parallèle sur plusieurs serveurs. En règle générale, Spanner choisit le parallélisme des requêtes pour équilibrer la latence et l'efficacité. Par exemple, si une requête comporte une clause LIMIT, elle peut utiliser moins de parallélisme pour éviter de gaspiller du travail que la limite supprime. Le nombre de divisions analysées par la requête limite le degré maximal de parallélisme.
Pour les requêtes avec des limites ou des analyses volumineuses, vous pouvez définir l'indice d'instruction USE_ADDITIONAL_PARALLELISM=TRUE pour indiquer à Spanner d'optimiser principalement la latence :
GoogleSQL
@{USE_ADDITIONAL_PARALLELISM=TRUE}
SELECT *
FROM Singers
LIMIT 10;
PostgreSQL
/*@ USE_ADDITIONAL_PARALLELISM=TRUE */
SELECT *
FROM Singers
LIMIT 10;
Cette indication peut saturer le processeur sur une division donnée. Si la requête est de longue durée, envoyez-la avec une priorité de requête moyenne pour éviter d'augmenter la latence des autres requêtes à priorité élevée.
Optimiser les limites
Si une requête contient une clause LIMIT, mais analyse beaucoup plus de lignes que la valeur limite, vérifiez les causes potentielles suivantes :
Index manquant
Si une requête comporte un filtre qui ne peut pas être satisfait à l'aide d'un index, le plan de requête analyse la table de base ou un index qui ne fournit pas l'ordre de tri requis. La requête trie ensuite entièrement les données correspondantes avant d'évaluer la clause LIMIT.
Pour résoudre ce problème, envisagez d'ajouter un index secondaire qui couvre les colonnes de filtre. Si l'index est défini comme NULL_FILTERED (ce qui signifie qu'il exclut les lignes où une colonne indexée est NULL), assurez-vous que le prédicat de la requête inclut IS NOT NULL afin que l'optimiseur puisse utiliser l'index. Pour en savoir plus sur la création d'index secondaires, consultez Index secondaires.
Tri complet
Si un index existe sur la colonne filtrée, mais qu'il ne fournit pas l'ordre de tri requis par la clause ORDER BY, Spanner doit lire toutes les lignes correspondantes et les transmettre à un opérateur Sort dans le plan d'exécution de la requête avant d'appliquer la clause LIMIT.
Pour éviter un tri complet, spécifiez les colonnes de votre instruction CREATE INDEX dans l'ordre suivant :
- Tout d'abord, toutes les colonnes qui ont une condition d'égalité (
=) ouINdans la requête - Ensuite, les mêmes colonnes que la clause
ORDER BYde la requête, dans le même ordre et avec la même direction de tri (ASCouDESC)
Par exemple, supposons que vous disposiez d'une table Users (non affichée dans l'exemple de schéma précédent) et que vous souhaitiez optimiser la requête suivante :
SELECT * FROM Users
WHERE Name='Alex'
ORDER BY LastLogin DESC
LIMIT 10;
Créez un index sur (Name, LastLogin DESC) afin que Spanner puisse lire les 10 premières lignes directement dans l'ordre de l'index sans tri :
CREATE INDEX UsersByNameLastLogin ON Users(Name, LastLogin DESC);
Trier par suffixe de clé
Même lorsqu'un index inclut la colonne ORDER BY en tant que suffixe de la clé d'index, une requête peut toujours analyser des lignes supplémentaires s'il existe un prédicat IN, OR ou de plage sur l'une des colonnes de préfixe de l'index.
Prenons l'exemple de la requête suivante, qui utilise l'index (Name, LastLogin DESC) de l'exemple de tri complet précédent, qui ne fait pas partie de l'exemple de schéma :
SELECT *
FROM Users
WHERE Name IN ('Alex','Amal')
ORDER BY LastLogin DESC
LIMIT 10;
Étant donné que Name correspond à plusieurs valeurs, les lignes correspondantes ne sont pas stockées dans une seule plage triée globalement par LastLogin DESC. Vous pouvez restructurer la requête à l'aide de UNNEST et d'une jointure afin que Spanner récupère les premières lignes pour chaque valeur Name séparément, puis les combine :
SELECT *
FROM UNNEST(['Alex','Amal']) AS Name
JOIN Users AS u ON u.Name = Name
ORDER BY LastLogin DESC
LIMIT 10;
Cette réécriture permet d'effectuer des analyses plus efficaces en lisant le nombre minimal de lignes de chaque clé de préfixe liée ('Alex' et 'Amal'), puis en effectuant un petit tri sur les résultats combinés pour produire le LIMIT final.
Un cas particulier courant de ce modèle est un préfixe de segment, où une colonne ShardId est ajoutée en tant que colonne de clé principale pour répartir les écritures entre les divisions.
Par exemple, la requête suivante analyse 32 segments (de 0 à 31) :
SELECT *
FROM Users
WHERE ShardId BETWEEN 0 AND 31
ORDER BY LastLogin DESC
LIMIT 10;
Pour optimiser cette requête, énumérez explicitement les ID de segment (0 à 31) et joignez-les à la table Users à l'aide de GENERATE_ARRAY dans GoogleSQL ou de generate_series dans PostgreSQL :
GoogleSQL
SELECT *
FROM GENERATE_ARRAY(0, 31) AS id
JOIN Users AS u ON u.ShardId = id
ORDER BY LastLogin DESC
LIMIT 10;
PostgreSQL
SELECT *
FROM generate_series(0, 31) AS id
JOIN Users AS u ON u.ShardId = id
ORDER BY LastLogin DESC
LIMIT 10;
Pour en savoir plus sur ces fonctions de génération de tableaux et de séries, consultez GENERATE_ARRAY pour GoogleSQL et generate_series pour PostgreSQL.
Comprendre les performances d'analyse
Les sections suivantes décrivent les causes les plus courantes de lenteur des analyses de tables ou d'index, et comment les atténuer.
Lignes supprimées
Par défaut, Spanner conserve les lignes supprimées ou écrasées pendant une heure pour permettre les lectures de l'historique et la récupération à un moment précis. Vous pouvez augmenter cette durée de conservation jusqu'à sept jours. Une fois qu'une ancienne version de ligne a dépassé la période de conservation, elle peut être supprimée lors du compactage du stockage en arrière-plan, ce qui peut prendre jusqu'à sept jours supplémentaires. Tant qu'une ancienne version de ligne n'est pas compactée, les requêtes qui analysent la plage de clés peuvent devoir lire les versions de ligne supprimées ou écrasées et les filtrer. Pour en savoir plus sur la conservation des données, consultez Récupération à un moment précis (PITR).
Vous pouvez vérifier si une requête a analysé des lignes supprimées en inspectant la métrique Lignes supprimées analysées dans la vue détaillée de l'opérateur Analyse du panneau d'informations du visualiseur de plan de requête.
Pour limiter les analyses lentes causées par un grand nombre de lignes récemment supprimées, vous pouvez déclencher une compaction manuelle des données. Pour en savoir plus, consultez Compacter manuellement les données.
Lignes volumineuses
Pour les petites lignes (jusqu'à quelques centaines d'octets), le coût d'une analyse dépend principalement du nombre de lignes analysées. À mesure que la taille des lignes augmente, la taille en octets des lignes devient plus importante. Dans le stockage orienté lignes, la taille totale de la ligne affecte les performances d'analyse, et pas seulement la taille des colonnes projetées par la requête.
Pour les requêtes analytiques nécessitant de nombreuses analyses sur des tables volumineuses, envisagez d'utiliser le moteur de données en colonnes. Pour en savoir plus, consultez Surveiller le moteur de données en colonnes.
Pour les requêtes sur des ensembles de lignes plus étroits, si une table comporte à la fois des colonnes volumineuses et des colonnes plus petites qui sont fréquemment interrogées, envisagez les options suivantes :
- Séparez les colonnes plus volumineuses dans un groupe de localités autre que celui par défaut (qui stocke les colonnes spécifiées séparément sur le disque du reste de la table) ou dans une table enfant distincte, afin que les analyses des colonnes plus petites ne lisent pas les données des colonnes volumineuses. Pour en savoir plus, consultez Créer et gérer des groupes de zones géographiques.
- Pour optimiser davantage le temps de lecture, dupliquez les colonnes plus petites dans un index secondaire avec la même clé primaire que la table de base, en utilisant la clause
STORINGpour inclure les colonnes plus petites.
Par exemple, supposons qu'une table Documents (ne faisant pas partie de l'exemple de schéma précédent) stocke une petite chaîne Metadata à côté d'un grand objet JSON Content. Vous pouvez créer un index secondaire qui ne stocke que Metadata afin que les requêtes qui n'ont pas besoin de Content puissent analyser l'index plus petit au lieu de la table de base :
CREATE TABLE Documents (
  Id INT64,
  Metadata STRING(MAX),
  Content JSON
) PRIMARY KEY (Id);

CREATE INDEX DocumentMetadata ON Documents(Id) STORING (Metadata);
Données entrelacées volumineuses
Lorsque les tables sont entrelacées, Spanner stocke physiquement chaque ligne parente avec ses lignes enfants entrelacées, dans l'ordre des clés. Si une table parente comporte de nombreuses lignes enfants entrelacées, ou si une table enfant comporte beaucoup moins de lignes que ses tables parentes ou sœurs, les analyses de plage sur la table plus petite sont plus éparses et moins efficaces, car l'analyse doit ignorer les lignes entrelacées des autres tables.
Par exemple, considérons le schéma suivant (qui ne fait pas partie de l'exemple de schéma précédent), dans lequel Transaction et AuthorizedPerson sont tous deux entrelacés dans Account :
CREATE TABLE Account (
  AccountId INT64,
  -- Additional columns omitted
) PRIMARY KEY (AccountId);

CREATE TABLE Transaction (
  AccountId INT64,
  TransactionId STRING(MAX),
  -- Additional columns omitted
) PRIMARY KEY (AccountId, TransactionId),
INTERLEAVE IN PARENT Account;

CREATE TABLE AuthorizedPerson (
  AccountId INT64,
  SignerId INT64,
  Name STRING(MAX),
  -- Additional columns omitted
) PRIMARY KEY (AccountId, SignerId),
INTERLEAVE IN PARENT Account;
Si chaque ligne Account comporte des milliers de lignes Transaction et seulement quelques lignes AuthorizedPerson, une analyse de plage sur Account ou AuthorizedPerson a un coût par ligne plus élevé qu'une analyse de plage sur Transaction (même si son coût total est toujours inférieur). Cela est dû au fait qu'une analyse Transaction lit plusieurs lignes Transaction contiguës à la fois, tandis qu'une analyse sur Account ou AuthorizedPerson comporte moins de lignes adjacentes de la même table et doit ignorer les lignes Transaction entrelacées.
Pour optimiser les analyses de plage sur la table plus éparse (Account ou AuthorizedPerson), créez un index secondaire non entrelacé qui duplique les colonnes nécessaires à votre requête, de la même manière que pour les lignes volumineuses :
CREATE INDEX AuthorizedPersonByAccount
  ON AuthorizedPerson(AccountId, SignerId)
  STORING (Name);
Utiliser l'exécution par lot
Spanner peut exécuter des analyses de requêtes et des opérateurs de requête à l'aide d'une méthode orientée lignes (traitement d'une ligne à la fois) ou d'une méthode orientée lots (traitement de blocs de lignes à la fois). Les sections suivantes expliquent comment inspecter et configurer les analyses par lot et l'exécution des opérateurs par lot.
Analyses par lot
Certaines requêtes Spanner peuvent bénéficier d'une méthode de traitement par lot lors de l'analyse des données, plutôt que de la méthode de traitement par ligne plus courante. Le traitement des analyses par lots est un moyen plus efficace de traiter de grands volumes de données en une seule fois. Il permet aux requêtes de réduire l'utilisation du processeur et la latence.
L'opération d'analyse Spanner commence toujours par la méthode orientée lignes. Pendant ce temps, Spanner collecte plusieurs métriques d'exécution. Ensuite, Spanner applique un ensemble d'heuristiques basées sur le résultat de ces métriques pour déterminer la méthode d'analyse optimale. Le cas échéant, Spanner passe à une méthode de traitement par lot pour améliorer le débit et les performances d'analyse.
Cas d'utilisation courants
Les requêtes présentant les caractéristiques suivantes bénéficient généralement d'un traitement par lot :
- Analyses volumineuses sur des données rarement mises à jour
- Analyses avec des prédicats sur des colonnes de largeur fixe
- Analyses avec un grand nombre de recherches (une recherche utilise un index pour récupérer des enregistrements)
Cas d'utilisation sans gain de performances
Toutes les requêtes ne bénéficient pas du traitement par lot. Les types de requêtes suivants sont plus performants avec le traitement d'analyse orienté lignes :
- Requêtes de recherche de points : requêtes qui ne récupèrent qu'une seule ligne.
- Requêtes d'analyse de petite taille : analyses de table qui n'analysent que quelques lignes, sauf si elles ont un nombre élevé de recherches.
- Requêtes avec une clause
LIMIT: requêtes qui arrêtent l'analyse après avoir renvoyé un nombre fixe de lignes. - Requêtes qui lisent des données à fort taux de renouvellement : requêtes dans lesquelles plus d'environ 10% des données lues sont fréquemment mises à jour.
- Requêtes avec des lignes contenant des valeurs volumineuses : requêtes sur des lignes contenant des valeurs supérieures à 32 000 octets (avant compression) dans une seule colonne.
Vérifier la méthode d'analyse utilisée par une requête
Pour vérifier si votre requête utilise un traitement par lot, un traitement par ligne ou bascule automatiquement entre les deux méthodes d'analyse, procédez comme suit :
Dans la console Google Cloud , accédez à la page Instances de Spanner.
Cliquez sur le nom de l'instance contenant la requête que vous souhaitez examiner.
Dans la table Bases de données, cliquez sur la base de données contenant la requête que vous souhaitez examiner.
Dans le menu de navigation Spanner, cliquez sur Spanner Studio.
Cliquez sur Nouvel onglet de l'éditeur SQL ou Nouvel onglet.
Dans l'éditeur de requête, saisissez votre requête.
Cliquez sur Exécuter.
Spanner exécute la requête et affiche les résultats.
Dans le volet de l'éditeur de requête, cliquez sur l'onglet Explication.
Spanner affiche le visualiseur du plan d'exécution de la requête. Chaque fiche du graphique représente un itérateur. Pour en savoir plus sur les plans d'exécution, consultez Plans d'exécution de requêtes.
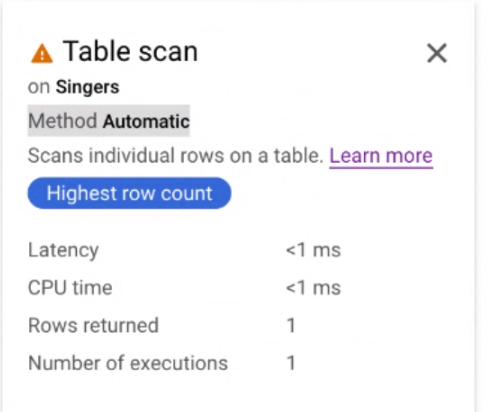
Cliquez sur la fiche de l'itérateur Analyse de table pour ouvrir un panneau d'informations.
Le panneau d'informations affiche des informations contextuelles sur l'analyse sélectionnée, y compris la méthode d'analyse (Méthode). Automatique indique que Spanner détermine la méthode d'analyse. Les autres valeurs possibles sont Batch pour le traitement par lot et Row pour le traitement par ligne, comme illustré dans l'image suivante :
Appliquer la méthode d'analyse utilisée par une requête
Pour optimiser les performances des requêtes, Spanner choisit la méthode d'analyse optimale pour votre requête. Google vous recommande d'utiliser cette méthode d'analyse par défaut. Toutefois, il peut arriver que vous souhaitiez appliquer un type de méthode d'analyse spécifique.
Appliquer l'analyse par lot
Vous pouvez appliquer l'analyse par lot au niveau de la table et de l'instruction.
Pour appliquer la méthode d'analyse par lot au niveau de la table, utilisez un indice de table dans votre requête :
GoogleSQL
SELECT *
FROM (Singers@{SCAN_METHOD=BATCH} AS s
  JOIN Albums AS a ON s.SingerId = a.SingerId);
PostgreSQL
SELECT *
FROM (Singers/*@ scan_method=batch */ AS s
  JOIN Albums AS a ON s.SingerId = a.SingerId);
Pour appliquer la méthode d'analyse par lot au niveau de l'instruction, utilisez un indice d'instruction dans votre requête :
GoogleSQL
@{SCAN_METHOD=BATCH}
SELECT *
FROM Singers;
PostgreSQL
/*@ scan_method=batch */
SELECT *
FROM Singers;
Lorsque vous utilisez un indice au niveau de l'instruction, il s'applique à l'ensemble de la requête. Il est préférable de définir l'indice au niveau de la table, car cela permet un contrôle plus précis.
Forcer l'exploration par ligne
Bien que Google ne recommande pas de désactiver la méthode d'analyse automatique définie par Spanner, vous pouvez la désactiver et utiliser la méthode d'analyse orientée lignes à des fins de dépannage, par exemple pour diagnostiquer la latence.
Pour désactiver la sélection automatique de la méthode d'analyse et appliquer le traitement des lignes au niveau de la table, utilisez un indice de table dans votre requête :
GoogleSQL
SELECT *
FROM (Singers@{SCAN_METHOD=ROW} AS s
  JOIN Albums AS a ON s.SingerId = a.SingerId);
PostgreSQL
SELECT *
FROM (Singers/*@ scan_method=row */ AS s
  JOIN Albums AS a ON s.SingerId = a.SingerId);
Pour désactiver la méthode d'analyse automatique et appliquer le traitement des lignes au niveau de l'instruction, utilisez un indice d'instruction dans votre requête :
GoogleSQL
@{SCAN_METHOD=ROW}
SELECT *
FROM Singers;
PostgreSQL
/*@ scan_method=row */
SELECT *
FROM Singers;
Méthode d'exécution
En plus des analyses par lot, vous pouvez également optimiser l'exécution des requêtes en appliquant la méthode d'exécution au niveau de l'instruction. Cela ne fonctionne que pour certains opérateurs et est indépendant de la méthode d'analyse, qui n'est utilisée que par l'opérateur d'analyse. Pour en savoir plus sur les analyses par lot, consultez la section Analyses par lot de ce document.
Par défaut, la plupart des opérateurs s'exécutent selon la méthode orientée ligne, qui traite les données une ligne à la fois. Les opérateurs vectorisés s'exécutent selon la méthode par lot pour améliorer le débit et les performances d'exécution. Ces opérateurs traitent les données un bloc à la fois. Lorsqu'un opérateur doit traiter de nombreuses lignes, la méthode d'exécution par lot est généralement plus efficace.
Méthode d'exécution et méthode d'analyse
La méthode d'exécution de la requête est indépendante de la méthode d'analyse de la requête. Vous pouvez définir l'une de ces méthodes, les deux ou aucune dans votre indice de requête.
La méthode d'exécution de la requête fait référence à la manière dont les opérateurs de requête traitent les résultats intermédiaires et à la manière dont les opérateurs interagissent entre eux, tandis que la méthode d'analyse fait référence à la manière dont l'opérateur d'analyse interagit avec la couche de stockage Spanner.
Appliquer la méthode d'exécution utilisée par la requête
Pour optimiser les performances des requêtes, Spanner choisit la méthode d'exécution optimale pour votre requête en fonction de différentes heuristiques. Google vous recommande d'utiliser cette méthode d'exécution par défaut. Toutefois, il peut arriver que vous souhaitiez appliquer un type de méthode d'exécution spécifique.
Vous pouvez appliquer votre méthode d'exécution au niveau de l'instruction. L'indice de requête EXECUTION_METHOD est un conseil plutôt qu'une directive. En fin de compte, l'optimiseur de requête décide de la méthode à utiliser pour chaque opérateur individuel.
Pour appliquer la méthode d'exécution par lot au niveau de l'instruction, utilisez un indice d'instruction dans votre requête :
GoogleSQL
@{EXECUTION_METHOD=BATCH}
SELECT *
FROM Singers;
PostgreSQL
/*@ EXECUTION_METHOD=BATCH */
SELECT *
FROM Singers;
Bien que Google ne recommande pas de désactiver la méthode d'exécution automatique définie par Spanner, vous pouvez la désactiver et utiliser la méthode d'exécution orientée lignes à des fins de dépannage, par exemple pour diagnostiquer la latence.
Pour désactiver la méthode d'exécution automatique et appliquer la méthode d'exécution orientée lignes au niveau de l'instruction, utilisez un indice d'instruction dans votre requête :
GoogleSQL
@{EXECUTION_METHOD=ROW}
SELECT *
FROM Singers;
PostgreSQL
/*@ EXECUTION_METHOD=ROW */
SELECT *
FROM Singers;
Vérifier quelle méthode d'exécution est activée
Les opérateurs Spanner ne sont pas tous compatibles avec les méthodes d'exécution par lot et par ligne. Pour chaque opérateur, l'outil de visualisation du plan d'exécution de la requête affiche la méthode d'exécution dans la fiche de l'itérateur. Si la méthode d'exécution est orientée par lot, elle affiche Lot. S'il est orienté ligne, il affiche Ligne. Pour en savoir plus sur le visualiseur, consultez Plans d'exécution des requêtes.
Si les opérateurs de votre requête s'exécutent à l'aide de différentes méthodes d'exécution, les adaptateurs de méthode d'exécution DataBlockToRowAdapter et RowToDataBlockAdapter s'affichent entre les opérateurs pour indiquer le changement de méthode d'exécution. Pour en savoir plus sur ces opérateurs, consultez DataBlockToRowAdapter et RowToDataBlockAdapter.