


このページでは、Spanner クエリのパフォーマンスをチューニングする手法について説明します。クエリのチューニングを開始する前に、次のページを確認してください。クエリのチューニングで使用される基本的なコンセプトとツールについて説明しています。
このページのクエリと実行プランは、次のデータベース スキーマに基づいています。
CREATE TABLE Singers (
  SingerId   INT64 NOT NULL,
  FirstName  STRING(1024),
  LastName   STRING(1024),
  SingerInfo BYTES(MAX),
  BirthDate  DATE
) PRIMARY KEY(SingerId);

CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);

CREATE TABLE Albums (
  SingerId        INT64 NOT NULL,
  AlbumId         INT64 NOT NULL,
  AlbumTitle      STRING(MAX),
  MarketingBudget INT64
) PRIMARY KEY(SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);

CREATE INDEX AlbumsByAlbumTitle2 ON Albums(AlbumTitle) STORING (MarketingBudget);

CREATE TABLE Songs (
  SingerId  INT64 NOT NULL,
  AlbumId   INT64 NOT NULL,
  TrackId   INT64 NOT NULL,
  SongName  STRING(MAX),
  Duration  INT64,
  SongGenre STRING(25)
) PRIMARY KEY(SingerId, AlbumId, TrackId),
  INTERLEAVE IN PARENT Albums ON DELETE CASCADE;

CREATE INDEX SongsBySingerAlbumSongNameDesc ON Songs(SingerId, AlbumId, SongName DESC), INTERLEAVE IN Albums;

CREATE INDEX SongsBySongName ON Songs(SongName);

CREATE TABLE Concerts (
  VenueId      INT64 NOT NULL,
  SingerId     INT64 NOT NULL,
  ConcertDate  DATE NOT NULL,
  BeginTime    TIMESTAMP,
  EndTime      TIMESTAMP,
  TicketPrices ARRAY<INT64>
) PRIMARY KEY(VenueId, SingerId, ConcertDate);
次のデータ操作言語(DML)ステートメントを使用して、これらのテーブルにデータを追加できます。
INSERT INTO Singers (SingerId, FirstName, LastName, BirthDate)
VALUES (1, "Marc", "Richards", "1970-09-03"),
       (2, "Catalina", "Smith", "1990-08-17"),
       (3, "Alice", "Trentor", "1991-10-02"),
       (4, "Lea", "Martin", "1991-11-09"),
       (5, "David", "Lomond", "1977-01-29");

INSERT INTO Albums (SingerId, AlbumId, AlbumTitle)
VALUES (1, 1, "Total Junk"),
       (1, 2, "Go, Go, Go"),
       (2, 1, "Green"),
       (2, 2, "Forever Hold Your Peace"),
       (2, 3, "Terrified"),
       (3, 1, "Nothing To Do With Me"),
       (4, 1, "Play");

INSERT INTO Songs (SingerId, AlbumId, TrackId, SongName, Duration, SongGenre)
VALUES (2, 1, 1, "Let's Get Back Together", 182, "COUNTRY"),
       (2, 1, 2, "Starting Again", 156, "ROCK"),
       (2, 1, 3, "I Knew You Were Magic", 294, "BLUES"),
       (2, 1, 4, "42", 185, "CLASSICAL"),
       (2, 1, 5, "Blue", 238, "BLUES"),
       (2, 1, 6, "Nothing Is The Same", 303, "BLUES"),
       (2, 1, 7, "The Second Time", 255, "ROCK"),
       (2, 3, 1, "Fight Story", 194, "ROCK"),
       (3, 1, 1, "Not About The Guitar", 278, "BLUES");
ベンチマークの推奨事項
最も信頼性の高いパフォーマンス統計は、ターゲット インスタンスと同じリージョンにある Google Cloud 仮想マシン(VM)インスタンスから、異なるランダム化されたクエリ パラメータ値を使用する負荷テストを実行することで得られます。
Spanner Studio や QueryMode.PROFILE モードに依存してクエリのベンチマークを行うことは避けてください。これらのツールは、実際のプロダクション ネットワークやクライアント環境を複製しないためです。ただし、負荷テストでパフォーマンスの問題が特定された後、クエリプラン(Query Insights でサンプリングされたもの、または Spanner Studio でオンデマンドで実行されたもの)は、その特定の問題を調査するのに役立つツールです。
クエリ実行プランについて
クエリプランの可視化ツールでは、クエリ実行プランが演算子のツリーとして表示されます。各演算子は、子演算子から行を読み取り、処理して、結果を親演算子に渡します。
ビジュアル プランのほとんどの演算子では、報告されるレイテンシは加算されます(その演算子で費やされた時間のみが反映されます)。ただし、Distributed union 演算子と Distributed apply 演算子の場合、報告されるレイテンシは累積されます。これには、分散演算子自体に費やされた時間と、その子演算子に費やされた時間の両方が含まれます。これらの演算子の詳細については、分散ユニオンと分散適用をご覧ください。
たとえば、次の分散ユニオン プランでは、Distributed union カードは合計レイテンシ 8.46 ミリ秒を報告し、その子 Stream aggregate 演算子は 3.51 ミリ秒を報告し、Table scan は 1 ミリ秒を報告します。Distributed union レイテンシは累積されるため、Distributed union 演算子自体は 8 ミリ秒ではなく、約 5 ミリ秒のレイテンシのみを追加します。

次の例では、Distributed union カードは 13.69 ミリ秒のレイテンシを報告していますが、その子演算子(Stream aggregate は 1 ミリ秒未満、Cross apply は 1.14 ミリ秒、Albums の Table scan は 1 ミリ秒未満、Filter scan は 1 ミリ秒、Singers の Table scan は 10.85 ミリ秒)は約 13 ミリ秒を占めています。その結果、Distributed union 演算子自体は 13 ミリ秒ではなく、1 ミリ秒未満のレイテンシを追加します。

累積レイテンシ値は、演算子の概要パネルでも確認できます。
複数のインデックスを組み合わせる
クエリが OR 条件または AND 条件を使用して複数のインデックス付き列をフィルタする場合、Spanner は複数のセカンダリ インデックスを組み合わせて、ベーステーブル全体のスキャンを回避することがあります。このセクションの例では、ReleaseDate 列と AlbumsByReleaseDate セカンダリ インデックスを追加して、前の例のスキーマから Albums テーブルを拡張しています。
CREATE TABLE Albums (
  SingerId        INT64 NOT NULL,
  AlbumId         INT64 NOT NULL,
  AlbumTitle      STRING(MAX),
  ReleaseDate     DATE,
  MarketingBudget INT64
) PRIMARY KEY(SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);

CREATE INDEX AlbumsByReleaseDate ON Albums(ReleaseDate);
次のクエリについて考えてみましょう。このクエリでは、OR 条件を使用して、2 つの異なるセカンダリ インデックス(AlbumsByAlbumTitle と AlbumsByReleaseDate)の述語をフィルタします。
SELECT a.AlbumId, a.AlbumTitle, a.ReleaseDate
FROM Albums AS a
WHERE a.AlbumTitle = 'Play' OR a.ReleaseDate = '2023-09-07';
クエリに 2 つの異なるインデックスの述語に OR 条件がある場合、Spanner はコストベースの最適化を使用して両方のインデックスを読み取り、結果を結合(インデックス ユニオン)することがあります。クエリに INDEX_STRATEGY=FORCE_INDEX_UNION テーブルヒントを追加して、この最適化を強制することもできます。
SELECT a.AlbumId, a.AlbumTitle, a.ReleaseDate
FROM Albums@{INDEX_STRATEGY=FORCE_INDEX_UNION} AS a
WHERE a.AlbumTitle = 'Play' OR a.ReleaseDate = '2023-09-07';
テーブルヒントの詳細については、テーブルヒントをご覧ください。
次の実行プラン図は、Spanner が各ブランチを個別にスキャンし、Union all 演算子と Hash aggregate 演算子を使用して結果を結合することで、この OR 条件(選言)を評価する方法を示しています。

次に、AND 条件を使用して、インデックスに登録された両方の列をフィルタするクエリについて考えてみましょう。
SELECT a.AlbumId, a.ReleaseDate, a.AlbumTitle
FROM Albums AS a
WHERE a.AlbumTitle = 'Aardvark' AND a.ReleaseDate = '2023-09-07';
AND 条件を使用すると、Spanner はデフォルトで 1 つのインデックスを選択し、必要に応じてベーステーブルに結合して、AND 句の残りの条件を評価します。このベーステーブルのバック結合がパフォーマンスのボトルネックになっているかどうかを判断するには、ビジュアライザーでクエリ実行プランを調べます。Index scan 演算子が多くの行を返し、その後、ベーステーブルの Table scan 演算子と結合した後にフィルタリングされる場合(返される最終的な行数に対して Table scan ブランチのレイテンシまたは CPU 時間が長くなる場合)、バック結合がボトルネックになっています。
ベーステーブルのバック結合がクエリのボトルネックになっている場合は、AND 条件の追加列をセカンダリ インデックスの STORING 句に追加することをおすすめします。これにより、Spanner はベーステーブルを読み取ることなく、インデックスから直接両方の条件を評価できます。
CREATE INDEX AlbumsByAlbumTitleStoringReleaseDate
  ON Albums(AlbumTitle)
  STORING (ReleaseDate);
インデックスの変更が不可能な場合は、INTERSECT DISTINCT を使用して両方のインデックスの交差を実行するようにクエリを書き換え、一致する主キーを Albums ベーステーブルに結合します。
SELECT union_a.AlbumId, a.ReleaseDate, a.AlbumTitle FROM
  (SELECT a1.SingerId, a1.AlbumId
  FROM Albums @{force_index=AlbumsByReleaseDate} AS a1
  WHERE a1.ReleaseDate = '2023-09-07'
  INTERSECT DISTINCT
  SELECT a2.SingerId, a2.AlbumId
  FROM Albums @{force_index=AlbumsByAlbumTitle} AS a2
  WHERE a2.AlbumTitle = 'Aardvark') AS union_a
JOIN Albums AS a
  ON a.SingerId = union_a.SingerId AND a.AlbumId = union_a.AlbumId;
次の実行プラン図は、書き換えられたクエリを示しています。このプランでは、Albums ベーステーブルで Table scan を実行する前に、2 つの Index scan 演算子(on AlbumsByAlbumTitle と on AlbumsByReleaseDate)を使用して交差するキーを検索しています。

ワークロードで複数の列にわたるフィルタリングが頻繁に行われる場合は、セカンダリ インデックスではなく、複数列の全文検索を使用することを検討してください。詳細については、複数列検索を実行するをご覧ください。
結合を最適化する
Spanner が複数のテーブルを結合するクエリを実行すると、クエリ オプティマイザーは結合順序(テーブルが結合される順序)と結合方法(2 つの入力から行を結合するために使用されるアルゴリズム。たとえば、適用結合、ハッシュ結合、マージ結合など)の両方を選択します。結合を含むクエリが想定よりも遅い場合は、クエリヒントを使用して、別の結合順序または結合方法を使用するように Spanner に指示できます。これにより、実行プランは変更されますが、返される結果は変更されません。次に例を示します。
GoogleSQL
結合順序を強制する:
SELECT *
FROM Singers AS s JOIN@{FORCE_JOIN_ORDER=TRUE} Albums AS a
ON s.SingerId = a.SingerId
WHERE s.LastName LIKE '%x%' AND a.AlbumTitle LIKE '%love%';
参加方法を変更する:
SELECT *
FROM Singers AS s JOIN@{JOIN_METHOD=HASH_JOIN} Albums AS a
ON s.SingerId = a.SingerId;
PostgreSQL
結合順序を強制する:
SELECT *
FROM Singers AS s JOIN/*@ FORCE_JOIN_ORDER=TRUE */ Albums AS a
ON s.SingerId = a.SingerId
WHERE s.LastName LIKE '%x%' AND a.AlbumTitle LIKE '%love%';
参加方法を変更する:
SELECT *
FROM Singers AS s JOIN/*@ JOIN_METHOD=HASH_JOIN */ Albums AS a
ON s.SingerId = a.SingerId;
以降のセクションでは、クエリのパフォーマンスを向上させる結合順序と結合方法を判断する際に役立つ背景情報について説明します。
結合方法とスキャン
Spanner はいくつかの結合メソッドをサポートしています。結合メソッドの選択は、Spanner が基になるテーブルまたはインデックスをスキャンする方法に直接影響します。
- 適用結合(一部のシステムではルックアップ結合またはネストループ結合と呼ばれます): 左側(「入力」)の各行に対して右側(「マップ」)を 1 回実行します。右側の各ルックアップでは、左側の現在の行の値が使用されるため、左側の結合列を右側のシークキーとして使用できます。分散適用結合は、ローカル適用結合と同様に機能しますが、分散結合のスプリット間でより効率的に通信できるように、行をバッチ処理します。
- ハッシュ結合: 1 つの入力から行を読み取り、結合キーにインメモリ ハッシュ テーブルを構築します。その後、もう 1 つの入力をスキャンして、ハッシュ テーブルで一致するものを探します。
- マージ結合: 結合キーの並べ替え順で両方の入力を読み取り、一致する行を 1 回のパスでマージします。
たとえば、Singers と Albums を結合する次のクエリについて考えてみましょう。
SELECT s.*, a.AlbumTitle
FROM Singers AS s
JOIN Albums AS a ON s.SingerId = a.SingerId
WHERE s.SingerId = 2 AND a.AlbumId = 1;
apply 結合では、s.SingerId = a.SingerId は結合の右側のシーク条件として機能するため、クエリは Albums テーブルから 1 行のみを読み取る必要があります。
一方、ハッシュ結合またはマージ結合では、左側と右側の入力が互いに独立して読み取られるため、結合条件は一方から他方へのシークキーを提供しません。最悪の場合、ハッシュ結合またはマージ結合は各入力のフルテーブル スキャンを実行します。
インタラクティブなクエリとトランザクション クエリでは、ほとんどの結合でインデックスが使用されるため、Spanner で最も一般的な結合タイプは分散適用です。ただし、連続した行範囲の読み取りは、同じ数の分散した単一行シークを実行するよりも大幅に高速であるため、ハッシュ結合またはマージ結合の方が適している場合があります。トレードオフは、より少ない行をシークする(apply 結合を使用)方が高速か、より大きな連続した行範囲をスキャンする(ハッシュ結合またはマージ結合を使用)方が高速かです。このトレードオフの詳細については、シーケンシャル読み取りと分散シークをご覧ください。
数千行を読み取るクエリの場合、結合キーでインデックスを使用できる場合は、通常、分散適用結合を使用する方が安全です。これは、適用結合の費用が結合された行数に比例するのに対し、ハッシュ結合またはマージ結合では、費用がテーブルの合計サイズに比例する可能性があるためです。大規模なクエリ(数百万行を処理するクエリなど)では、ハッシュ結合またはマージ結合を使用すると、パフォーマンスが大幅に向上する可能性があります。
結合演算子とヒントの詳細については、次のリソースをご覧ください。
結合の順序
他のリレーショナル データベース管理システム(RDBMS)と同様に、中間結果のサイズをできるだけ小さく保つように結合を並べ替えます。つまり、できるだけ早い段階でデータをフィルタし、大規模な一致をできるだけ遅らせる必要があります。
FORCE_JOIN_ORDER=TRUE ヒントを指定すると、Spanner はクエリテキストに表示される順序で結合を実行します。選択性の高いフィルタを使用した結合をクエリの早い段階に移動し、一致数の多い結合をクエリの後の段階に移動します。
集計を最適化する
次の手法を使用すると、集計クエリ中にスキャンおよび並べ替えられる行数を減らすことができます。
キーの接頭辞ごとに 1 行を取得する
一般的な集計パターンは、キー接頭辞ごとに 1 行(バージョン番号またはタイムスタンプが最も大きい行など)を取得することです。GoogleSQL でこれを行う最も効率的な方法は、HAVING MAX で ANY_VALUE を使用することです。これにより、最大値を持つ行が検索され、自己結合や完全な並べ替えを必要とせずに、1 回の集計パスでリクエストされた列が返されます。たとえば、次のクエリは Concerts テーブルを ConcertDate でグループ化し、各日付の最新の EndTime を持つコンサートの BeginTime を返します。
SELECT ConcertDate, ANY_VALUE(BeginTime HAVING MAX(EndTime))
FROM Concerts
GROUP BY ConcertDate;
行の存在を確認する
テーブルに行があるかどうか、または特定の条件に一致する行があるかどうかを確認するには、COUNT ではなく LIMIT を使用します。次に例を示します。
SELECT 1 FROM Albums LIMIT 1;
並列処理を増やす
Spanner は、テーブルとインデックスをスプリットと呼ばれる連続した主キー範囲に分割します。スプリットは、複数のサーバーで並列処理できます。通常、Spanner はレイテンシと効率のバランスを取るためにクエリの並列処理を選択します。たとえば、クエリに LIMIT 句がある場合、上限によって破棄される作業の無駄を避けるために、並列処理を減らすことがあります。クエリによってスキャンされるスプリットの数によって、並列処理の最大数が制限されます。
制限付きのクエリや大規模なスキャンの場合は、USE_ADDITIONAL_PARALLELISM=TRUE ステートメント ヒントを設定して、主にレイテンシを最適化するように Spanner に指示できます。
GoogleSQL
@{USE_ADDITIONAL_PARALLELISM=TRUE}
SELECT *
FROM Singers
LIMIT 10;
PostgreSQL
/*@ USE_ADDITIONAL_PARALLELISM=TRUE */
SELECT *
FROM Singers
LIMIT 10;
このヒントにより、特定の分割で CPU が飽和状態になる可能性があります。クエリが長時間実行される場合は、他の優先度の高いクエリのレイテンシが増加しないように、中程度のリクエスト優先度で送信します。
上限を最適化する
クエリに LIMIT 句が含まれているが、上限値よりも多くの行をスキャンする場合は、次の原因が考えられます。
インデックスが見つからない
クエリにインデックスを使用して満たすことができないフィルタがある場合、クエリプランはベーステーブルまたは必要な並べ替え順序を提供しないインデックスをスキャンします。次に、クエリは一致するデータを完全に並べ替えてから、LIMIT 句を評価します。
この問題を解決するには、フィルタ列をカバーするセカンダリ インデックスを追加することを検討してください。インデックスが NULL_FILTERED として定義されている場合(インデックス付き列が NULL である行を除外することを意味します)、オプティマイザーがインデックスを使用できるように、クエリ述語に IS NOT NULL が含まれていることを確認します。セカンダリ インデックスの作成の詳細については、セカンダリ インデックスをご覧ください。
フルソート
フィルタされた列にインデックスが存在するものの、インデックスが ORDER BY 句で必要な並べ替え順序を提供しない場合、Spanner は一致するすべての行を読み取り、LIMIT を適用する前にクエリ実行プランの Sort 演算子に渡す必要があります。
完全な並べ替えを回避するには、CREATE INDEX ステートメントで列を次の順序で指定します。
- まず、クエリで等価(
=)またはIN条件を持つ列 - 次に、クエリの
ORDER BY句と同じ列を、同じ順序で、同じ並べ替え方向(ASCまたはDESC)で指定します。
たとえば、Users テーブル(上記のサンプル スキーマには示されていません)があり、次のクエリを最適化するとします。
SELECT * FROM Users
WHERE Name='Alex'
ORDER BY LastLogin DESC
LIMIT 10;
(Name, LastLogin DESC) にインデックスを作成して、Spanner が並べ替えを行わずにインデックス順に上位 10 行を直接読み取れるようにします。
CREATE INDEX UsersByNameLastLogin ON Users(Name, LastLogin DESC);
キーの接尾辞で並べ替える
インデックスにインデックスキーの接尾辞として ORDER BY 列が含まれている場合でも、インデックスの接頭辞列の 1 つに IN、OR、または範囲述語があると、クエリは余分な行をスキャンする可能性があります。
たとえば、前の完全並べ替えの例の (Name, LastLogin DESC) インデックスを使用する次のクエリについて考えてみましょう。このインデックスは、サンプルのスキーマの一部ではありません。
SELECT *
FROM Users
WHERE Name IN ('Alex','Amal')
ORDER BY LastLogin DESC
LIMIT 10;
Name は複数の値と一致するため、一致する行は LastLogin DESC によってグローバルに並べ替えられた単一の範囲に保存されません。UNNEST と結合を使用してクエリを再構成すると、Spanner は各 Name 値の上位行を個別に取得してから、それらを結合します。
SELECT *
FROM UNNEST(['Alex','Amal']) AS Name
JOIN Users AS u ON u.Name = Name
ORDER BY LastLogin DESC
LIMIT 10;
この書き換えにより、各バインドされたプレフィックス キー('Alex' と 'Amal')から最小数の行を読み取り、結合された結果を小さく並べ替えて最終的な LIMIT を生成することで、より効率的なスキャンが実現します。
このパターンの一般的な特殊なケースは、シャード接頭辞です。この場合、ShardId 列が先頭のキー列として追加され、書き込みがスプリット全体に分散されます。たとえば、次のクエリは 32 個のシャード(0 から 31)をスキャンします。
SELECT *
FROM Users
WHERE ShardId BETWEEN 0 AND 31
ORDER BY LastLogin DESC
LIMIT 10;
このクエリを最適化するには、シャード ID(0~31)を明示的に列挙し、GoogleSQL の GENERATE_ARRAY または PostgreSQL の generate_series を使用して Users テーブルに結合します。
GoogleSQL
SELECT *
FROM GENERATE_ARRAY(0, 31) AS id
JOIN Users AS u ON u.ShardId = id
ORDER BY LastLogin DESC
LIMIT 10;
PostgreSQL
SELECT *
FROM generate_series(0, 31) AS id
JOIN Users AS u ON u.ShardId = id
ORDER BY LastLogin DESC
LIMIT 10;
これらの配列とシリーズ生成関数の詳細については、GoogleSQL の GENERATE_ARRAY と PostgreSQL の generate_series をご覧ください。
スキャンのパフォーマンスを理解する
以降のセクションでは、テーブルまたはインデックスのスキャンが遅くなる最も一般的な原因と、それらを軽減する方法について説明します。
削除された行
デフォルトでは、Spanner は削除または上書きされた行を 1 時間保持して、履歴読み取りとポイントインタイム リカバリをサポートします。この保持期間は最大 7 日間まで延長できます。古い行バージョンが保持期間を過ぎると、バックグラウンド ストレージの圧縮中に削除の対象になります。これには最長で 7 日かかることがあります。古い行バージョンが圧縮されるまで、キー範囲をスキャンするクエリは、削除または上書きされた行バージョンを読み取り、除外する必要があります。データ保持の詳細については、ポイントインタイム リカバリ(PITR)をご覧ください。
クエリが削除された行をスキャンしたかどうかを確認するには、クエリプラン ビジュアライザの詳細パネルの [スキャン] 演算子の詳細ビューで、[スキャンされた削除済みの行] 指標を調べます。
最近削除された多数の行が原因でスキャンが遅くなるのを軽減するには、手動でデータ圧縮をトリガーします。詳細については、手動データ圧縮をご覧ください。
大きな行
小さな行(最大数百バイト)の場合、スキャンの費用は主にスキャンされた行数によって異なります。行サイズが大きくなると、行のバイトサイズが大きくなります。行指向ストレージでは、クエリによって投影される列のサイズだけでなく、行の合計サイズがスキャン パフォーマンスに影響します。
大規模なテーブルに対するスキャン負荷の高い分析クエリの場合は、カラム型エンジンの使用を検討してください。詳細については、カラム型エンジンをモニタリングするをご覧ください。
より狭い行セットに対するクエリの場合、テーブルに大きな列と、頻繁にクエリされる小さな列の両方がある場合は、次のオプションを検討してください。
- 大きな列をデフォルト以外の地域グループ(指定された列をテーブルの残りの部分とは別にディスクに保存する)または別の子テーブルに分割して、小さな列のスキャンで大きな列のデータが読み取られないようにします。詳細については、ローカリティ グループを作成して管理するをご覧ください。
- 読み取り時間をさらに最適化するには、
STORING句を使用して、ベーステーブルと同じ主キーを持つセカンダリ インデックスに、より小さい列を複製します。
たとえば、Documents テーブル(前述のサンプル スキーマの一部ではない)に、大きな Content JSON オブジェクトとともに小さな Metadata 文字列が格納されているとします。Metadata のみを格納するセカンダリ インデックスを作成すると、Content を必要としないクエリは、ベーステーブルではなく、より小さいインデックスをスキャンできます。
CREATE TABLE Documents (
  Id INT64,
  Metadata STRING(MAX),
  Content JSON
) PRIMARY KEY (Id);

CREATE INDEX DocumentMetadata ON Documents(Id) STORING (Metadata);
大規模なインターリーブ データ
テーブルがインターリーブされると、Spanner は各親行をインターリーブされた子行とともにキー順に物理的に格納します。親テーブルにインターリーブされた子行が多数ある場合、または子テーブルの行数が親テーブルや兄弟テーブルよりも大幅に少ない場合、スキャンは他のテーブルからインターリーブされた行をスキップする必要があるため、小さいテーブルの範囲スキャンはまばらで効率が低下します。
たとえば、次のスキーマ(上記のスキーマ例の一部ではありません)について考えてみましょう。このスキーマでは、Transaction と AuthorizedPerson の両方が Account にインターリーブされています。
CREATE TABLE Account (
  AccountId INT64,
  -- Additional columns omitted
) PRIMARY KEY (AccountId);

CREATE TABLE Transaction (
  AccountId INT64,
  TransactionId STRING(MAX),
  -- Additional columns omitted
) PRIMARY KEY (AccountId, TransactionId),
INTERLEAVE IN PARENT Account;

CREATE TABLE AuthorizedPerson (
  AccountId INT64,
  SignerId INT64,
  Name STRING(MAX),
  -- Additional columns omitted
) PRIMARY KEY (AccountId, SignerId),
INTERLEAVE IN PARENT Account;
すべての Account 行に数千の Transaction 行と数行の AuthorizedPerson 行がある場合、Account または AuthorizedPerson の範囲スキャンは、Transaction の範囲スキャンよりも行あたりのコストが高くなります(合計コストは低くなります)。これは、Transaction スキャンでは多くの連続する Transaction 行が一度に読み取られるのに対し、Account または AuthorizedPerson のスキャンでは同じテーブルの隣接する行が少なく、インターリーブされた Transaction 行をスキップする必要があるためです。
スパース テーブル(Account または AuthorizedPerson)の範囲スキャンを最適化するには、大きな行のアプローチと同様に、クエリに必要な列を複製するインターリーブされていないセカンダリ インデックスを作成します。
CREATE INDEX AuthorizedPersonByAccount
  ON AuthorizedPerson(AccountId, SignerId)
  STORING (Name);
バッチ指向の実行を使用する
Spanner は、行指向型の方法(一度に 1 行を処理する)またはバッチ指向型の方法(一度に複数の行を処理する)を使用して、クエリスキャンとクエリ演算子を実行できます。以降のセクションでは、バッチ指向のスキャンとバッチ指向のオペレーター実行を検査して構成する方法について説明します。
バッチ指向型スキャン
特定の Spanner クエリでは、一般的な行指向型の処理方法ではなく、データのスキャン時にバッチ指向型の処理方法を使用した方がメリットが得られます。スキャンを一括処理することで、大量のデータを一度に処理するためのより効率的な方法になり、クエリで CPU 使用率とレイテンシの低減を実現できます。
Spanner のスキャン オペレーションは、常に行指向メソッドで実行が開始されます。この間、Spanner はいくつかのランタイム指標を収集します。その後、Spanner はこれらの指標の結果に基づいて一連のヒューリスティックを適用し、最適なスキャン方法を決定します。適切なタイミングで、Spanner はバッチ指向型の処理方法に切り替えて、スキャンのスループットとパフォーマンスを向上させることができます。
一般的なユースケース
次の特性を持つクエリは通常、バッチ指向型の処理を使用することでメリットが得られます。
- 更新頻度の低いデータに対する大規模なスキャン
- 固定幅の列に対する述語を使用したスキャン
- シーク数が多いスキャン(シークはインデックスを使用してレコードを取得します)
パフォーマンスの向上がないユースケース
すべてのクエリがバッチ指向型の処理からメリットを得られるわけではありません。次のクエリタイプは、行指向型のスキャン処理の方がパフォーマンスが向上します。
- ポイント検索クエリ: 1 行のみをフェッチするクエリ。
- 小規模なスキャンクエリ: シーク数が多くない限り、数行のみをスキャンするテーブル スキャン。
LIMIT句を含むクエリ: 一定数の行を返した後にスキャンを停止するクエリ。- チャーンレートが高いデータを読み取るクエリ: データ読み取りの約 10% 以上が頻繁に更新されるクエリ。
- 大きな値を含む行でのクエリ: 1 つの列に 32,000 バイトを超える値(圧縮前)を含む行でのクエリ。
クエリで使用されるスキャン方法を確認する
クエリでバッチ指向型の処理、行指向型の処理が使用されるか、これらの 2 つのスキャン方法が自動的に切り替えられるかを確認するには、次の操作を行います。
Google Cloud コンソールで、[Spanner インスタンス] ページに移動します。
調査するクエリを含むインスタンスの名前をクリックします。
[データベース] テーブルで、調査するクエリを含むデータベースをクリックします。
Spanner のナビゲーション メニューで [Spanner Studio] をクリックします。
[新しい SQL エディタタブ] または [新しいタブ] をクリックします。
クエリエディタにクエリを入力します。
[実行] をクリックします。
Spanner がクエリを実行し、結果を表示します。
クエリエディタ ペインで、[説明] タブをクリックします。
Spanner にクエリ実行プランの可視化ツールが表示されます。グラフの各カードはイテレータを表します。実行プランの詳細については、クエリ実行プランをご覧ください。
イテレータ カード [テーブル スキャン] をクリックして、情報パネルを開きます。
情報パネルには、スキャン方法(方法)など、選択したスキャンに関するコンテキスト情報が表示されます。[自動] は、Spanner がスキャン方法を決定することを示します。その他の使用可能な値には、バッチ指向型の処理用の Batch や、行指向型の処理用の Row があります。
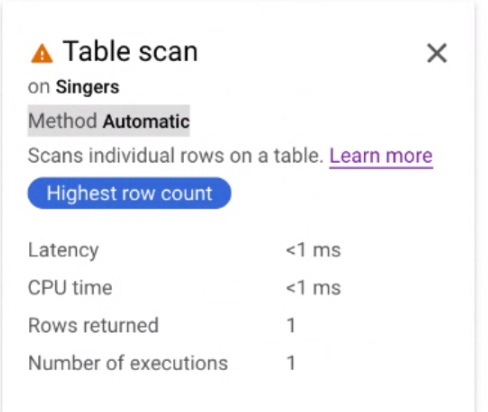
クエリで使用されるスキャン方法を適用する
クエリのパフォーマンスを最適化するために、Spanner はクエリに最適なスキャン方法を選択します。このデフォルトのスキャン方法を使用することをおすすめします。ただし、特定の種類のスキャン方法を適用する必要がある場合もあります。
バッチ指向型スキャンを適用する
バッチ指向型スキャンは、テーブルレベルとステートメント レベルで適用できます。
バッチ指向型スキャン方法をテーブルレベルで適用するには、クエリでテーブルヒントを使用します。
GoogleSQL
SELECT *
FROM (Singers@{SCAN_METHOD=BATCH} AS s
  JOIN Albums AS a ON s.SingerId = a.SingerId);
PostgreSQL
SELECT *
FROM (Singers/*@ scan_method=batch */ AS s
  JOIN Albums AS a ON s.SingerId = a.SingerId);
バッチ指向型スキャン方法をステートメント レベルで適用するには、クエリでステートメント ヒントを使用します。
GoogleSQL
@{SCAN_METHOD=BATCH}
SELECT *
FROM Singers;
PostgreSQL
/*@ scan_method=batch */
SELECT *
FROM Singers;
ステートメント レベルのヒントを使用すると、クエリ全体に適用されます。テーブルレベルでヒントを設定することをおすすめします。これにより、よりきめ細かく制御できます。
行指向型スキャンを強制する
Spanner によって設定された自動スキャン方法を無効にすることはおすすめしませんが、レイテンシの診断などのトラブルシューティングを目的として、自動スキャン方法を無効にして行指向型のスキャン方法を使用することもできます。
自動スキャン方法の選択を無効にして、テーブルレベルでの行処理を適用するには、クエリでテーブルヒントを使用します。
GoogleSQL
SELECT *
FROM (Singers@{SCAN_METHOD=ROW} AS s
  JOIN Albums AS a ON s.SingerId = a.SingerId);
PostgreSQL
SELECT *
FROM (Singers/*@ scan_method=row */ AS s
  JOIN Albums AS a ON s.SingerId = a.SingerId);
自動スキャン方法を無効にして、ステートメント レベルでの行処理を適用するには、クエリでステートメント ヒントを使用します。
GoogleSQL
@{SCAN_METHOD=ROW}
SELECT *
FROM Singers;
PostgreSQL
/*@ scan_method=row */
SELECT *
FROM Singers;
実行メソッド
バッチ指向型スキャンに加えて、ステートメント レベルで実行方法を適用してクエリ実行を最適化することもできます。これは一部の演算子に対してのみ機能し、スキャン演算子によってのみ使用されるスキャン方法とは独立しています。バッチ指向スキャンの詳細については、このドキュメントのバッチ指向スキャンをご覧ください。
デフォルトでは、ほとんどの演算子は行指向の方法で実行され、データを 1 行ずつ処理します。ベクトル化演算子はバッチ指向の方法で実行され、実行スループットとパフォーマンスが向上します。これらの演算子は、データを一度に 1 ブロックずつ処理します。演算子が多くの行を処理する必要がある場合は、通常、バッチ指向の実行方法の方が効率的です。
実行方法とスキャン方法
クエリの実行方法は、クエリのスキャン方法とは独立しています。クエリヒントでは、これらの方法を設定できるのは 1 つか両方、またはどちらも設定できません。
クエリ実行方法は、クエリ演算子が中間結果を処理する方法と演算子同士が相互作用する方法を指します。一方、スキャン方法は、スキャン演算子が Spanner のストレージ レイヤとやり取りする方法を指します。
クエリで使用される実行方法を適用する
クエリのパフォーマンスを最適化するために、Spanner はさまざまなヒューリスティクスに基づいてクエリの最適な実行方法を選択します。このデフォルトの実行方法を使用することをおすすめします。ただし、特定の種類の実行方法を適用する必要がある場合もあります。
実行方法はステートメント レベルで適用できます。EXECUTION_METHOD クエリヒントはディレクティブではなくアドバイスです。最終的には、クエリ オプティマイザーが個々の演算子に使用する方法を決定します。
バッチ指向の実行方法をステートメント レベルで適用するには、クエリでステートメント ヒントを使用します。
GoogleSQL
@{EXECUTION_METHOD=BATCH}
SELECT *
FROM Singers;
PostgreSQL
/*@ EXECUTION_METHOD=BATCH */
SELECT *
FROM Singers;
Spanner によって設定された自動実行方法を無効にすることはおすすめしませんが、レイテンシの診断などのトラブルシューティングを目的として、自動実行方法を無効にして行指向型のスキャン方法を使用することもできます。
自動実行方法を無効にして、ステートメント レベルで行指向の実行方法を適用するには、クエリでステートメント ヒントを使用します。
GoogleSQL
@{EXECUTION_METHOD=ROW}
SELECT *
FROM Singers;
PostgreSQL
/*@ EXECUTION_METHOD=ROW */
SELECT *
FROM Singers;
有効になっている実行方法を確認する
すべての Spanner 演算子が、バッチ指向と行指向の両方の実行方法をサポートしているわけではありません。クエリ実行プランの可視化ツールにより、演算子ごとにイテレータ カードに実行方法が表示されます。実行方法がバッチ指向の場合、[バッチ] と表示されます。行方向の場合は [行] と表示されます。ビジュアライザーの詳細については、クエリ実行プランをご覧ください。
クエリ内の演算子が異なる実行方法を使用して実行される場合、実行方法のアダプタ DataBlockToRowAdapter と RowToDataBlockAdapter が演算子の間に表示され、実行方法の変更が示されます。これらの演算子の詳細については、DataBlockToRowAdapter と RowToDataBlockAdapter をご覧ください。