


פיתוח AI בסביבת ייצור ב-Cloud TPU באמצעות JAX
מערך הכלים של JAX AI מרחיב את הליבה המספרית של JAX באמצעות אוסף של ספריות קומפוזביליות שנתמכות על ידי Google, והופך אותה לפלטפורמת קוד פתוח חזקה מקצה לקצה ללמידת מכונה בקנה מידה עצום. לכן, JAX AI Stack מורכב מסביבה עסקית מקיפה ויציבה שמתייחסת לכל מחזור החיים של למידת המכונה:
בסיס בקנה מידה תעשייתי: מערך הכלים JAX AI Stack מיועד לפעול בקנה מידה עצום, תוך שימוש ב-ML Pathways כדי לתזמר את האימון על פני עשרות אלפי שבבים, וב-Orbax כדי ליצור נקודות ביקורת אסינכרוניות גמישות עם תפוקה גבוהה, שמאפשרות אימון של מודלים מתקדמים ברמה שמתאימה לסביבת ייצור.
ערכת כלים מלאה שמוכנה לייצור: JAX AI Stack מספקת קבוצה מקיפה של ספריות לכל תהליך הפיתוח: Flax ליצירת מודלים גמישים, Optax לאסטרטגיות אופטימיזציה קומפוזביליות ו-Grain לפייפליינים דטרמיניסטיים של נתונים שחיוניים להרצות בקנה מידה גדול שניתן לשחזר.
ביצועים מיוחדים ברמה הגבוהה ביותר: כדי להפיק את המקסימום מהחומרה, ב-JAX AI Stack יש ספריות מיוחדות, כולל Tokamax לקרנלים מתקדמים בהתאמה אישית, Qwix לקוונטיזציה לא פולשנית שמגבירה את מהירות האימון וההסקה, ו-XProf ליצירת פרופילים של ביצועים ברמה עמוקה שמשולבים בחומרה.
מסלול מלא לייצור: JAX AI Stack מאפשר מעבר חלק ממחקר לפריסה. זה כולל את MaxText כקובץ עזר שניתן להתאים לעומס לאימון מודלים בסיסיים, את Tunix ללמידה מתחזקת (RL) והתאמה מתקדמות, ופתרון הסקה מאוחד עם vLLM-JAX וסביבת זמן הריצה של JAX להצגת מודעות.
הפילוסופיה של JAX AI Stack היא רכיבים בצימוד חלש, שכל אחד מהם עושה דבר אחד בצורה טובה. במקום להיות מסגרת מונוליתית של ML, JAX עצמו הוא בעל היקף מצומצם ומתמקד בפעולות יעילות של מערכים וטרנספורמציות של תוכניות. המערכת האקולוגית מבוססת על מסגרת הליבה הזו כדי לספק מגוון רחב של פונקציות שקשורות לאימון של מודלים של למידת מכונה ולסוגים אחרים של עומסי עבודה, כמו מחשוב מדעי.
המערכת הזו של רכיבים בצימוד חלש מאפשרת לכם לבחור ולשלב ספריות בצורה שהכי מתאימה לדרישות שלכם. מנקודת מבט של הנדסת תוכנה, הארכיטקטורה הזו גם מאפשרת לעדכן פונקציונליות שבדרך כלל נחשבת לרכיבי ליבה של ה-framework (לדוגמה, פייפליינים ונקודות ביקורת) באופן איטרטיבי, בלי להסתכן בערעור היציבות של ה-framework או להיתקע במחזורי הפצה. רוב הפונקציונליות מוטמעת בספריות ולא בשינויים במסגרת מונוליתית, ולכן ספריית המספרים המרכזית עמידה יותר וניתנת להתאמה לשינויים עתידיים בסביבה הטכנולוגית.
בקטעים הבאים מופיעה סקירה טכנית של JAX AI Stack, התכונות העיקריות שלו, החלטות העיצוב שמאחוריהן ואיך הן משתלבות כדי ליצור פלטפורמה עמידה לעומסי עבודה מודרניים של למידת מכונה.
JAX AI Stack ורכיבים אחרים של המערכת האקולוגית
| רכיב | פונקציה / תיאור |
|---|---|
| הרכיבים והליבה של JAX AI Stack1 | |
| JAX | חישוב מערכים וטרנספורמציה של תוכניות (JIT, grad, vmap, pmap) שמיועדים למאיצים. |
| Flax | ספרייה גמישה ליצירת רשתות נוירונים, שמאפשרת ליצור ולשנות מודלים באופן אינטואיטיבי. |
| Optax | ספרייה של טרנספורמציות לעיבוד גרדיאנטים ולאופטימיזציה שלהם, שאפשר לשלב ביניהן. |
| Orbax | ספריית נקודות ביקורת מבוזרת בכל קנה מידה, שמאפשרת לאמן מודלים גדולים בצורה גמישה. |
| גרגירים | ספרייה של פייפליין לנתוני קלט שניתן להרחיב, דטרמיניסטית ועם אפשרות לנקודות ביקורת. |
| JAX AI Stack – תשתית | |
| XLA | מהדר למידת מכונה בקוד פתוח ליחידות TPU, CPU ו-GPU. |
| Pathways | זמן ריצה מבוזר לתזמור חישובים על פני עשרות אלפי שבבים. |
| JAX AI stack - Adv. פיתוח | |
| Pallas | תוסף JAX לכתיבת ליבות מותאמות אישית ברמה נמוכה ובביצועים גבוהים, שמוטמעות ב-Python. |
| Tokamax | ספרייה של ליבות מותאמות אישית, מתקדמות ובעלות ביצועים גבוהים (לדוגמה, Attention). |
| Qwix | ספרייה מקיפה ולא פולשנית לכימות (PTQ, QAT, QLoRA). |
| JAX AI Stack – אפליקציה | |
| MaxText או MaxDiffusion | סביבות עבודה לדוגמה, מובילות וניתנות להתאמה, לאימון מודלים בסיסיים (לדוגמה, LLM ו-Diffusion). |
| Tunix | מסגרת לאימון המתקדם ביותר אחרי אימון ראשוני ולהתאמה (RLHF, DPO). |
| vLLM-JAX | פתרון להסקת מסקנות של LLM עם ביצועים גבוהים, באמצעות שילוב מובנה של מסגרת vLLM. |
| XProf | כלי מעמיק ליצירת פרופילים שמשולב בחומרה, לניתוח ביצועים ברמת המערכת. |
1כלול בחבילת jax-ai-stack Python.
איור 1: רכיבי המערכת האקולוגית ו-JAX AI Stack

הצורך הארכיטקטוני: ביצועים מעבר למסגרות
ככל שארכיטקטורות המודלים מתכנסות – למשל, בטרנספורמרים מולטי-מודאליים של שילוב מומחים (MoE) – השאיפה להגיע לביצועים שיא מובילה להופעת Megakernels. Megakernel הוא למעשה כל המעבר קדימה (או חלק גדול ממנו) של מודל ספציפי אחד, שמקודד ידנית באמצעות API ברמה נמוכה יותר כמו CUDA SDK במעבדי GPU של NVIDIA. הגישה הזו מאפשרת לנצל את החומרה בצורה מקסימלית על ידי חפיפה אגרסיבית של המחשוב, הזיכרון והתקשורת. עבודה שנעשתה לאחרונה על ידי קהילת המחקר הוכיחה שהגישה הזו יכולה להניב שיפורים משמעותיים בקצב העיבוד, במקרים מסוימים מעל 22%, להסקת מסקנות ב-GPU. המגמה הזו לא מוגבלת להסקת מסקנות. יש ראיות לכך שחלק ממאמצי האימון בקנה מידה גדול כללו שליטה בחומרה ברמה נמוכה כדי להשיג שיפורים משמעותיים ביעילות.
אם המגמה הזו תאיץ, כל מסגרות העבודה ברמה הגבוהה כפי שהן קיימות כיום עלולות להפוך לפחות רלוונטיות, כי גישה ברמה נמוכה לחומרה היא מה שחשוב בסופו של דבר לביצועים בארכיטקטורות בוגרות ויציבות. זה מציב אתגר לכל סטאק מודרני של ML: איך לספק שליטה בחומרה ברמה של מומחה בלי לפגוע בפרודוקטיביות ובגמישות של framework ברמה גבוהה.
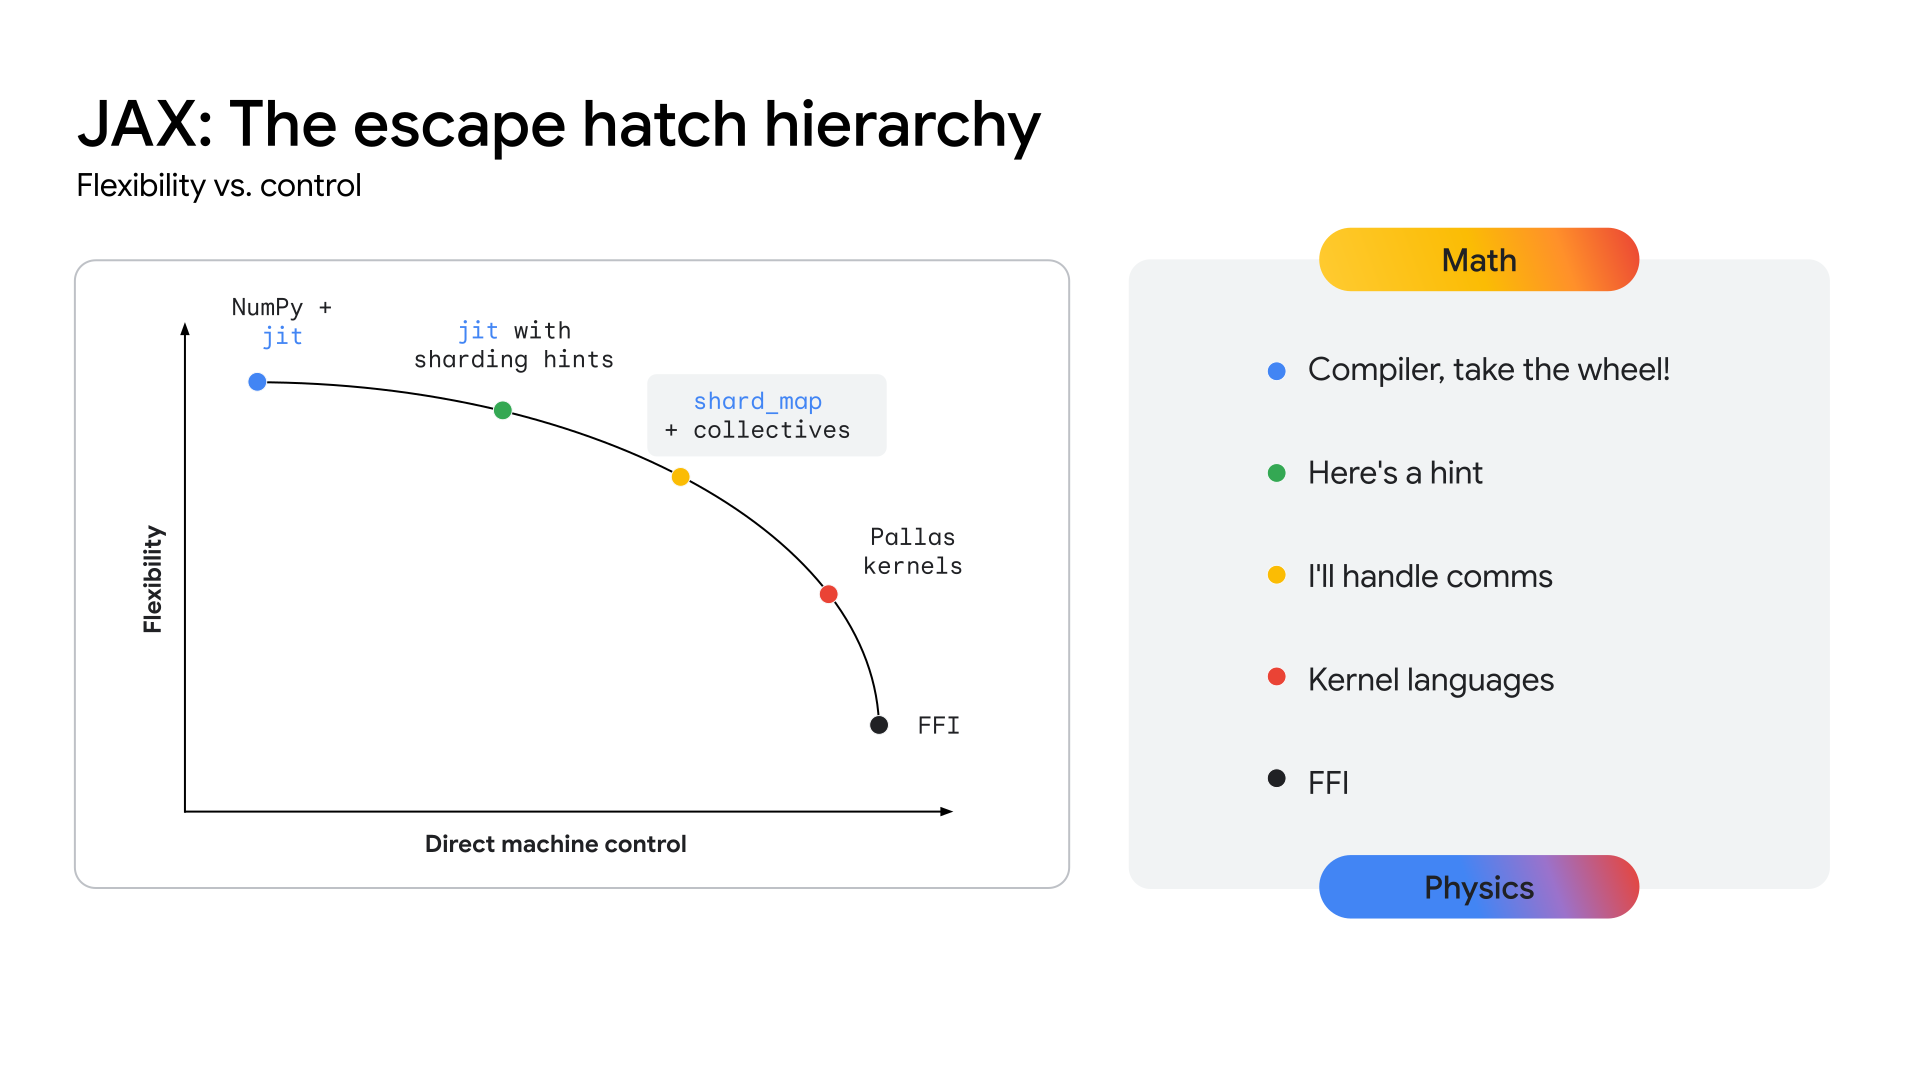
כדי שיחידות TPU יספקו נתיב ברור לרמת הביצועים הזו, המערכת צריכה לחשוף שכבת API שקרובה יותר לחומרה, וכך לאפשר פיתוח של הליבות המיוחדות האלה. מחסנית JAX נועדה לפתור את הבעיה הזו באמצעות רצף של הפשטה (ראו איור 2), החל מהאופטימיזציות האוטומטיות ברמה גבוהה של מהדר XLA ועד לשליטה הידנית המפורטת של ספריית יצירת הליבה של Pallas.
איור 2: רצף ההפשטה של JAX
JAX AI Stack העיקרי
JAX AI Stack הבסיסי מורכב מחמש ספריות עיקריות שמספקות את הבסיס לפיתוח מודלים:
JAX: בסיס לטרנספורמציה של תוכניות ניתנות להרכבה עם ביצועים גבוהים
JAX היא ספריית Python לחישוב מערכים ולטרנספורמציה של תוכניות שמיועדת למאיצים, ומיועדת למחשוב מספרי בעל ביצועים גבוהים וללמידת מכונה בקנה מידה גדול. עם מודל התכנות הפונקציונלי ו-API שדומה ל-NumPy, JAX מספק בסיס איתן לספריות ברמה גבוהה יותר.
העיצוב של JAX מבוסס על קומפיילר, ולכן הוא מקדם יכולת התרחבות באופן טבעי באמצעות XLA (ראו את הקטע בנושא XLA) לניתוח, אופטימיזציה וטירגוט חומרה אגרסיביים של כל התוכנית. ההתמקדות של JAX בתכנות פונקציונלי (לדוגמה, פונקציות טהורות) הופכת את הטרנספורמציות של תוכנית הליבה שלו ליותר נוחות לניהול, וחשוב מכך, ליותר קומפוזביליות.
אפשר לשלב בין הטרנספורמציות האלה כדי להשיג ביצועים גבוהים וסקיילינג של עומסי עבודה, בהתאם לגודל המודל, לגודל האשכול ולסוגי החומרה:
- jit: הידור (compilation) של פונקציות Python בזמן אמת לקובצי הפעלה ממוזגים ומותאמים של XLA.
- grad: דיפרנציאציה אוטומטית, תמיכה במצב קדימה ואחורה, וגם נגזרות מסדר גבוה יותר.
- vmap: וקטוריזציה אוטומטית, שמאפשרת עיבוד באצווה ועיבוד נתונים במקביל בלי לשנות את הלוגיקה של הפונקציה.
- pmap / shard_map: מקביליות אוטומטית בכמה מכשירים (לדוגמה, ליבות TPU), שיוצרת את הבסיס לאימון מבוזר.
השילוב החלק עם מודל GSPMD (General-purpose SPMD) של XLA מאפשר ל-JAX להריץ חישובים במקביל באופן אוטומטי על פני TPU Pods גדולים, עם שינויים מינימליים בקוד. ברוב המקרים, כדי לשנות את קנה המידה צריך רק הערות חלוקה לרמות גבוהות.
Flax: יצירה גמישה של רשתות נוירונים
Flax מפשט את היצירה, ניפוי הבאגים והניתוח של רשתות נוירונים ב-JAX, באמצעות גישה אינטואיטיבית מונחית-עצמים לבניית מודלים. למרות שה-API הפונקציונלי של JAX הוא חזק, הוא מציע למפתחים שרגילים למסגרות כמו PyTorch שכבת הפשטה מוכרת יותר שמבוססת על שכבות, בלי לפגוע בביצועים.
העיצוב הזה מאפשר לשנות או לשלב בקלות רכיבים של מודלים מאומנים.
טכניקות כמו LoRA וקוונטיזציה דורשות הגדרות מודל שניתן לשנות, ו-Flax מספק אותן באמצעות ממשק Pythonic ב-API של NNX. NNX כולל את מצב המודל, מפחית את העומס הקוגניטיבי על המשתמש ומאפשר מעבר ושינוי של היררכיית המודל באופן פרוגרמטי.
נקודות חוזק עיקריות:
- ממשק API אינטואיטיבי מונחה-אובייקטים: מפשט את בניית המודלים ומאפשר תרחישי שימוש מתקדמים כמו החלפת מודולי משנה ואתחול חלקי.
- עקביות עם Core JAX: Flax מספק טרנספורמציות מורמות שתואמות באופן מלא לפרדיגמה הפונקציונלית של JAX, ומציע את הביצועים המלאים של JAX עם ידידותיות משופרת למפתחים.
Optax: אסטרטגיות לאופטימיזציה ולעיבוד גרדיאנטים שניתן לשלב
Optax היא ספריית עיבוד ואופטימיזציה של גרדיאנטים ל-JAX. הוא נועד לספק למפתחי מודלים אבני בניין שאפשר לשלב מחדש בדרכים מותאמות אישית כדי לאמן מודלים של למידה עמוקה (Deep Learning) בין אפליקציות אחרות. היא מתבססת על היכולות של ספריית הליבה של JAX כדי לספק ספרייה שנבדקה היטב וכוללת פונקציות של אובדן ואופטימיזציה וטכניקות קשורות שאפשר להשתמש בהן כדי לאמן מודלים של למידת מכונה.
למה בחרנו לעשות זאת?
חישוב וצמצום של הפסדים הם הבסיס לאימון מודלים של למידת מכונה. ספריית הליבה של JAX תומכת בדיפרנציאציה אוטומטית, ומספקת את היכולות המספריות לאימון מודלים, אבל היא לא מספקת הטמעות סטנדרטיות של אופטימייזרים פופולריים (לדוגמה, RMSProp או Adam) או הפסדים (לדוגמה, CrossEntropy או MSE). אתם יכולים להטמיע את הפונקציות האלה (ומפתחים מתקדמים מסוימים יבחרו לעשות זאת), אבל באג בהטמעה של אופטימייזר יגרום לבעיות באיכות המודל שקשה לאבחן. במקום שהמשתמש יצטרך להטמיע את החלקים הקריטיים האלה, Optax מספקת הטמעות של האלגוריתמים האלה שנבדקו מבחינת נכונות וביצועים.
תחום תורת האופטימיזציה שייך לעולם המחקר, אבל התפקיד המרכזי שלו באימון הופך אותו לחלק חיוני באימון מודלים של למידת מכונה בסביבת הייצור. ספרייה שממלאת את התפקיד הזה צריכה להיות גמישה מספיק כדי להתאים לאיטרציות מחקר מהירות, וגם חזקה ובעלת ביצועים טובים מספיק כדי להיות אמינה לאימון מודלים בסביבת הייצור. הוא גם אמור לספק הטמעות שנבדקו היטב של אלגוריתמים מתקדמים שתואמים למשוואות הסטנדרטיות. ספריית Optax נועדה להשיג את המטרה הזו באמצעות ארכיטקטורה מודולרית שניתנת להרכבה, והדגש שלה על קוד קריא ונכון.
עיצוב
Optax נועד לשפר את מהירות המחקר ואת המעבר ממחקר לייצור, על ידי הטמעות קריאות, יעילות ונבדקות היטב של אלגוריתמים בסיסיים. ל-Optax יש שימושים מעבר להקשר של למידה עמוקה, אבל בהקשר הזה אפשר לראות אותה כאוסף של פונקציות אובדן, אלגוריתמים של אופטימיזציה וטרנספורמציות של גרדיאנטים, שמוטמעים באופן פונקציונלי טהור בהתאם לפילוסופיה של JAX. אוסף של הפסדים ואופטימיזציות מוכרים מאפשר למשתמשים להתחיל לעבוד בקלות ובביטחון.
הגישה המודולרית של Optax מאפשרת לשרשר כמה אופטימייזרים יחד, ואז להוסיף טרנספורמציות נפוצות אחרות (למשל, חיתוך גרדיאנט) ולעטוף אותם באמצעות שיטות נפוצות כמו MultiStep או Lookahead כדי להשיג אסטרטגיות אופטימיזציה יעילות עם כמה שורות קוד. הממשק הגמיש מאפשר לכם לחקור אלגוריתמים חדשים של אופטימיזציה ולהשתמש בטכניקות מתקדמות של אופטימיזציה מסדר שני, כמו Shampoo או Muon.
# Optax implementation of a RMSProp optimizer with a custom learning rate
#  schedule, gradient clipping and gradient accumulation.
optimizer = optax.chain(
  optax.clip_by_global_norm(GRADIENT_CLIP_VALUE),
  optax.rmsprop(learning_rate=optax.cosine_decay_schedule(init_value=lr,decay_steps=decay)),
  optax.apply_every(k=ACCUMULATION_STEPS)
)

# The same thing, in PyTorch
optimizer = optim.RMSprop(model_params, lr=LEARNING_RATE)
scheduler = optim.lr_scheduler.CosineAnnealingLR(optimizer, T_max=TOTAL_STEPS)
for i, (inputs, targets) in enumerate(data_loader):
    # ... Training loop body ...
    if (i + 1) % ACCUMULATION_STEPS == 0:
        torch.nn.utils.clip_grad_norm_(model.parameters(), GRADIENT_CLIP_VALUE)
        optimizer.step()
        scheduler.step()
 optimizer.zero_grad()
בקטע הקוד הקודם אפשר לראות איך מגדירים אופטימייזר עם קצב למידה בהתאמה אישית, חיתוך גרדיאנט וצבירת גרדיאנט.
נקודות החוזק העיקריות
- ספרייה מקיפה: ספרייה מקיפה של פונקציות הפסד, אופטימיזציות ואלגוריתמים, עם דגש על דיוק וקריאוּת.
- טרנספורמציות מודולריות שאפשר לשרשר: ה-API הגמיש הזה מאפשר לכם ליצור אסטרטגיות אופטימיזציה מורכבות ומשמעותיות באופן הצהרתי, בלי לשנות את לולאת האימון.
- פונקציונלי וניתן להתאמה: ההטמעות הפונקציונליות הטהורות משתלבות בצורה חלקה עם מנגנוני ההקבלה של JAX (לדוגמה, pmap), ומאפשרות לכם להשתמש באותו קוד כדי להתאים את קנה המידה ממארח יחיד לאשכולות גדולים.
Orbax / TensorStore – נקודות ביקורת מבוזרות בקנה מידה גדול
Orbax היא ספריית נקודות ביקורת ל-JAX שמיועדת לכל קנה מידה, ממכשיר יחיד ועד לאימון מבוזר בקנה מידה גדול. המטרה היא לאחד הטמעות מפוצלות של נקודות בדיקה ולספק תכונות קריטיות לביצועים, כמו נקודות בדיקה אסינכרוניות ורב-שכבתיות, לקהל רחב יותר. Orbax מאפשר את העמידות הנדרשת למשימות אימון מסיביות ומספק פורמט גמיש לפרסום נקודות ביקורת.
בניגוד למערכות כלליות של נקודות ביקורת ושחזור, שיוצרות תמונת מצב של כל המערכת, נקודות ביקורת של למידת מכונה באמצעות Orbax שומרות באופן סלקטיבי רק את המידע שחיוני להמשך האימון: משקלי המודל, מצב האופטימיזציה ומצב טעינת הנתונים. הגישה הממוקדת הזו מצמצמת את זמן ההשבתה של המאיץ. כדי לעשות את זה, Orbax חופף בין פעולות קלט/פלט לבין חישובים – תכונה חיונית לעומסי עבודה גדולים. הזמן שבו המאיצים לא פעילים מצטמצם למשך הזמן של העברת הנתונים מהמכשיר למארח, שאפשר לחפוף אותו עם שלב האימון הבא, כך שנקודות הבדיקה כמעט לא משפיעות על הביצועים.
בבסיס שלו, Orbax משתמש ב-TensorStore לקריאה וכתיבה מקבילות ויעילות של נתוני מערכים. Orbax API מפשט את המורכבות הזו ומציע ממשק ידידותי למשתמש לטיפול ב-PyTrees, שהם הייצוג הסטנדרטי של מודלים ב-JAX.
נקודות חוזק עיקריות:
- שימוש נרחב: עם מיליוני הורדות בחודש, Orbax משמש כאמצעי נפוץ לשיתוף פריטי מידע שנוצרו על ידי למידת מכונה.
- פישוט מורכבויות: Orbax מפשט את המורכבות של נקודות בקרה מבוזרות, כולל שמירה אסינכרונית, אטומיות ופרטים של מערכת הקבצים.
- גמישות: Orbax מציע ממשקי API לתרחישים נפוצים, אבל מאפשר לכם להתאים אישית את תהליך העבודה כדי לטפל בדרישות מיוחדות.
- ביצועים וסקלביליות: תכונות כמו נקודות בקרה אסינכרוניות, פורמט אחסון יעיל (OCDBT) ואסטרטגיות חכמות לטעינת נתונים מבטיחות ש-Orbax יתאים להרצות אימון שכוללות עשרות אלפי צמתים.
Grain: פייפליינים דטרמיניסטיים וניתנים להתאמה של נתוני קלט
Grain היא ספריית Python לקריאה ולעיבוד של נתונים לצורך אימון והערכה של מודלים של JAX. הוא גמיש, מהיר ודטרמיניסטי, ותומך בתכונות מתקדמות כמו נקודות ביקורת שחיוניות לאימון מוצלח של עומסי עבודה גדולים. הוא תומך בפורמטים פופולריים של נתונים ובקצוות עורפיים של אחסון, ומספק גם API גמיש להרחבת התמיכה בפורמטים ספציפיים למשתמשים ובקצוות עורפיים שלא נתמכים באופן מקורי. למרות ש-Grain מיועד בעיקר לעבודה עם JAX, הוא לא תלוי במסגרת, לא דורש JAX כדי לפעול ואפשר להשתמש בו גם עם מסגרות אחרות.
למה בחרנו לעשות זאת?
פייפליינים של נתונים הם חלק קריטי בתשתית האימון – הם צריכים להיות גמישים כדי שיהיה אפשר לבטא טרנספורמציות נפוצות ביעילות, ובעלי ביצועים גבוהים מספיק כדי שהמאיצים יהיו עסוקים כל הזמן. הם גם צריכים להיות מסוגלים להכיל כמה פורמטים של אחסון ורכיבי backend. בגלל זמני השלבים הארוכים יותר, אימון של מודלים גדולים בקנה מידה רחב מציב דרישות נוספות לפייפליין, מעבר לאלה שנדרשות בעומסי עבודה רגילים של אימון, שמתמקדים בעיקר בדטרמיניזם וביכולת השחזור2. הספרייה Grain מתוכננת עם ארכיטקטורה גמישה שנותנת מענה לצרכים האלה.
2בסעיף 5.1 של המאמר על PaLM, המחברים מציינים שהם הבחינו בעליות חדות מאוד באובדן, למרות שהם הפעילו חיתוך גרדיאנט. הפתרון היה להסיר את קבוצות הנתונים הבעייתיות ולהפעיל מחדש את האימון מנקודת בקרה לפני העלייה החדה בערך ההפסד. זה אפשרי רק עם הגדרת אימון דטרמיניסטית לחלוטין וניתנת לשחזור.
עיצוב
ברמה הגבוהה ביותר, יש שתי דרכים לבנות צינור עיבוד נתונים של קלט: כאשכול נפרד של עובדי נתונים, או על ידי מיקום משותף של עובדי הנתונים במארחים שמפעילים את המאיצים. ב-Grain בחרו באפשרות השנייה מכמה סיבות.
מאיצים משולבים עם מארחים חזקים שבדרך כלל לא פעילים במהלך שלבי האימון, ולכן הם בחירה טבעית להרצת פייפליין של נתוני הקלט. יש יתרונות נוספים להטמעה הזו – היא מפשטת את התצוגה של פיצול הנתונים על ידי הצגת תצוגה עקבית של הפיצול בקלט ובמחשוב. אפשר לטעון שהצבת ה-data worker במארח המאיץ עלולה להעמיס על המעבד (CPU) של המארח, אבל זה לא מונע העברה של טרנספורמציות שדורשות משאבי מחשוב רבים לאשכול אחר באמצעות RPC3.
ב-API, עם הטמעה של Python טהור שתומכת בכמה תהליכים וב-API גמיש, Grain מאפשר לכם להטמיע טרנספורמציות נתונים מורכבות באופן שרירותי על ידי הרכבת שלבי צינור עיבוד נתונים יחד על סמך פרדיגמות טרנספורמציה מובנות היטב.
Grain תומך בפורמטים יעילים של נתונים בגישה אקראית כמו ArrayRecord ו-Bagz, לצד פורמטים פופולריים אחרים של נתונים כמו Parquet ו-TFDS. כברירת מחדל, Grain כולל תמיכה בקריאה ממערכות קבצים מקומיות וגם מ-Cloud Storage. בנוסף לתמיכה בפורמטים פופולריים של אחסון ובקצה העורפי, הפשטה נקייה של שכבת האחסון מאפשרת לכם להוסיף תמיכה במקורות הנתונים הקיימים או לעטוף אותם כך שיהיו תואמים לספריית Grain.
3ככה פועלים פייפליינים מולטי-מודאליים – לדוגמה, כלי המרה לטוקנים של תמונות ואודיו הם מודלים בפני עצמם שפועלים באשכולות משלהם במאיצים משלהם, ופייפליינים של הקלט מבצעים קריאות RPC כדי להמיר דוגמאות של נתונים לסטרימינג של טוקנים.
נקודות החוזק העיקריות
- הזנת נתונים דטרמיניסטית: מיקום משותף של ה-data worker עם המאיץ, בשילוב עם ערבוב גלובלי יציב ואיטרטורים שניתן להגדיר להם נקודות ביקורת, מאפשרים להגדיר נקודות ביקורת למצב המודל ולמצב פייפליין הנתונים ביחד בתמונת מצב עקבית באמצעות Orbax, וכך לשפר את הדטרמיניזם של תהליך האימון.
- ממשקי API גמישים שמאפשרים טרנספורמציות נתונים מתקדמות: ממשק API גמיש של טרנספורמציות ב-Python טהור מאפשר לבצע טרנספורמציות נתונים נרחבות בתוך צינור עיבוד הנתונים של הקלט.
- תמיכה ניתנת להרחבה בכמה פורמטים ובקצוות עורפיים: API של מקורות נתונים שניתן להרחבה תומך בפורמטים פופולריים של אחסון ובקצוות עורפיים, ומאפשר להוסיף תמיכה בפורמטים חדשים ובקצוות עורפיים חדשים.
- ממשק יעיל לניפוי באגים: כלים להמחשה חזותית של פייפליין ומצב ניפוי באגים מאפשרים לכם לבחון, לנפות באגים ולשפר את הביצועים של פייפליינים.
JAX AI Stack המורחב
מעבר למחסנית הליבה, סביבה עשירה של ספריות ייעודיות מספקת את התשתית, הכלים המתקדמים והפתרונות לשכבת האפליקציה שנדרשים לפיתוח ML מקצה לקצה.
תשתית בסיסית: קומפיילרים וסביבות זמן ריצה
XLA: מנוע מבוסס-קומפיילר שלא תלוי בחומרה
למה בחרנו לעשות זאת?
XLA (או Accelerated Linear Algebra) הוא קומפיילר ספציפי לדומיין של Google, שמשולב היטב ב-JAX ותומך במכשירי חומרה מסוג TPU, CPU ו-GPU. XLA תוכנן כמחולל קוד שלא תלוי בחומרה, ומטרגט מעבדי TPU, GPU ו-CPU.
העיצוב של קומפיילר XLA, שמתמקד בקומפיילר, הוא בחירה ארכיטקטונית בסיסית שיוצרת יתרון משמעותי בתחום מחקר שמתפתח במהירות. לעומת זאת, הגישה הרווחת שמתמקדת בקרנל בסביבות אחרות מסתמכת על ספריות שעברו אופטימיזציה ידנית כדי לשפר את הביצועים. השיטה הזו יעילה מאוד לארכיטקטורות של מודלים יציבים ומבוססים, אבל היא יוצרת צוואר בקבוק לחדשנות. כשמחקר חדש מציג ארכיטקטורות חדשות, המערכת צריכה לחכות עד שייכתבו ליבות חדשות ויעברו אופטימיזציה. עם זאת, העיצוב שלנו שמתמקד בקומפיילר יכול בדרך כלל להכליל דפוסים חדשים, ולספק נתיב עם ביצועים גבוהים למחקר חדשני מהיום הראשון.
עיצוב
XLA פועל באמצעות הידור Just-In-Time (JIT) של תרשימי החישוב ש-JAX יוצר במהלך תהליך המעקב שלו (לדוגמה, כשפונקציה מעוטרת ב-@jax.jit).
ההידור הזה מתבצע בתהליך בכמה שלבים:
- תרשים חישוב של JAX
- High-Level Optimizer (HLO)
- אופטימיזציה ברמה נמוכה (LLO)
- קוד חומרה
- מגרף JAX ל-HLO: גרף החישוב של JAX מומר לייצוג HLO של XLA. ברמה הגבוהה הזו, מתבצעות אופטימיזציות יעילות שלא תלויות בחומרה, כמו מיזוג אופרטורים וניהול זיכרון יעיל. הדיאלקט StableHLO משמש כממשק עמיד עם גרסאות לשלב הזה.
- מ-HLO ל-LLO: אחרי אופטימיזציות ברמה גבוהה, קצוות עורפיים ספציפיים לחומרה משתלטים, ומורידים את ייצוג ה-HLO ל-LLO שמותאם למכונה.
- מ-LLO לקוד חומרה: בסופו של דבר, ה-LLO עובר קומפילציה לשפת מכונה יעילה מאוד. ב-TPU, הקוד הזה נארז בחבילות Very Long Instruction Word (VLIW) שנשלחות ישירות לחומרה.
כדי לאפשר התאמה לעומס, העיצוב של XLA מבוסס על מקביליות. הוא משתמש באלגוריתמים כדי להשתמש באופן מקסימלי ביחידות הכפל של המטריצה (MXU) בשבב. בין הצ'יפים, XLA משתמש ב-SPMD (תוכנית אחת, נתונים מרובים), טכניקת מקבילוּת מבוססת-קומפיילר שמשתמשת בתוכנית אחת בכל המכשירים. המודל העוצמתי הזה נחשף דרך ממשקי JAX API, ומאפשר לכם לנהל את הנתונים, המודל או המקביליות של צינור עיבוד הנתונים באמצעות הערות חלוקה ברמה גבוהה.
בתבניות מקביליות מורכבות יותר, אפשר גם להשתמש ב-Multiple Program Multiple Data (MPMD), וספריות כמו PartIR:MPMD מאפשרות למשתמשי JAX לספק גם הערות MPMD.
נקודות החוזק העיקריות
- קומפילציה: קומפילציה של תרשים החישוב בזמן אמת מאפשרת לבצע אופטימיזציה של פריסת הזיכרון, הקצאת מאגר הנתונים הזמני וניהול הזיכרון. בשיטות חלופיות, כמו שיטות שמבוססות על ליבה, הנטל הזה מוטל על המפתח. ברוב המקרים, XLA יכול להשיג ביצועים מצוינים בלי לפגוע במהירות הפיתוח.
- מקביליות: XLA מיישם כמה צורות של מקביליות עם SPMD, וזה נחשף ברמת JAX. כך אפשר להגדיר אסטרטגיות של פיצול נתונים, שמאפשרות לבצע ניסויים ולהרחיב את המודלים לאלפי שבבים.
Pathways: סביבת זמן ריצה מאוחדת לחישוב מבוזר בקנה מידה עצום
Pathways מציע הפשטות לאימון ולהיקש מבוזרים עם עמידות מובנית בכשלים ושחזור, ומאפשר לחוקרי ML לתכנת כאילו הם משתמשים במכונה אחת חזקה.
למה בחרנו לעשות זאת?
כדי לאמן ולפרוס מודלים גדולים, צריך מאות עד אלפי שבבים. השבבים האלה מפוזרים על פני מספר רב של ארונות שרתים ומכונות מארחות. משימת אימון היא תוכנית סינכרונית בקנה מידה גדול, שדורשת שכל הצ'יפים האלה והמארחים שלהם יעבדו במקביל על חישובי XLA שעברו מקבילוּת (sharding). במודלים של שפות גדולות (LLM), שבהם יכול להיות שיהיה צורך ביותר מעשרות אלפי שבבים, השירות הזה צריך להיות מסוגל להתפרס על פני כמה Pods במארג של מרכז נתונים, בנוסף לשימוש במארגים של חיבור בין שבבים (ICI) וחיבור על שבב (OCI) בתוך Pod.
עיצוב
ML Pathways היא המערכת שבה אנחנו משתמשים כדי לתאם חישובים מבוזרים בין מארחים ושבבי TPU. הוא מיועד למדרגיות וליעילות במאות אלפי מאיצים. לאימון בקנה מידה גדול, הוא מספק לקוח Python יחיד למספר משימות Pod, שילוב של Megascale XLA, שירות קומפילציה ו-Python מרחוק. הוא גם תומך בהקבלה בין פרוסות ובסבילות להפקעה, ומאפשר שחזור אוטומטי מהפקעות של משאבים.
Pathways משלב קבוצות אופטימליות של מארחים, שמאפשרות לתרשימי החישוב של XLA להתרחב מעבר ל-TPU Pod אחד. הוא מרחיב את התמיכה של XLA במקביליות של נתונים, מודלים וצינורות עיבוד נתונים, כדי לפעול מעבר לגבולות של פרוסות TPU באמצעות רשת מרכז הנתונים (DCN). לשם כך, הוא משלב סביבת זמן ריצה מבוזרת שמנהלת את התקשורת של DCN עם פרימיטיבים של תקשורת XLA.
נקודות החוזק העיקריות
הארכיטקטורה של בקר יחיד, שמשולבת עם JAX, היא הפשטה מרכזית. הוא מאפשר לחוקרים לבחון אסטרטגיות שונות של פיצול נתונים (sharding) ועיבוד מקבילי לאימון ולפריסה, תוך כדי התאמה לעשרות אלפי שבבים בקלות.
פיתוח מתקדם: ביצועים, נתונים ויעילות
Pallas: כתיבת ליבות מותאמות אישית עם ביצועים גבוהים ב-JAX
למרות ש-JAX הוא קומפיילר, יש מצבים שבהם כדאי לשלוט בחומרה באופן פרטני כדי להשיג ביצועים מקסימליים. Pallas הוא תוסף ל-JAX שמאפשר לכתוב ליבות בהתאמה אישית למעבדי GPU ו-TPU. הוא נועד לספק שליטה מדויקת בקוד שנוצר, בשילוב עם הארגונומיה ברמה גבוהה של מעקב JAX ו-API של jax.numpy.
Pallas חושף מודל מקביליות מבוסס-רשת, שבו פונקציית ליבה (kernel) שמוגדרת על ידי המשתמש מופעלת ברשת רב-ממדית של קבוצות עבודה מקבילות. הוא מאפשר ניהול מפורש של היררכיית הזיכרון, בכך שהוא מאפשר לכם להגדיר איך טנזורים מחולקים ומועברים בין זיכרון איטי וגדול יותר (לדוגמה, HBM) לבין זיכרון מהיר וקטן יותר על השבב (לדוגמה, VMEM ב-TPU, זיכרון משותף ב-GPU), באמצעות מפות אינדקס כדי לשייך מיקומים ברשת לבלוקים ספציפיים של נתונים. Pallas יכול להוריד את אותה הגדרת ליבה כדי לפעול ביעילות גם במעבדי TPU של Google וגם במעבדי GPU שונים, על ידי הידור של ליבות לייצוג ביניים שמתאים לארכיטקטורת היעד – Mosaic למעבדי TPU, או שימוש בטכנולוגיות כמו Triton למעבדי GPU. בעזרת Pallas, אתם יכולים לכתוב ליבות (kernels) עם ביצועים גבוהים שמתמחות בבלוקים כמו תשומת לב, כדי להשיג את ביצועי המודל הטובים ביותר בחומרת היעד בלי להסתמך על ערכות כלים ספציפיות של ספקים.
Tokamax: ספרייה של קרנלים מתקדמים
אם Pallas הוא כלי ליצירת ליבות, Tokamax הוא ספרייה של ליבות מאיצים מתקדמות בהתאמה אישית שתומכות גם ב-TPU וגם ב-GPU. Tokamax מבוסס על JAX ו-Pallas ומאפשר לכם להשתמש בכל היכולות של החומרה. הוא גם מספק כלים ליצירה ולכוונון אוטומטי של ליבות בהתאמה אישית.
למה בחרנו לעשות זאת?
JAX, שמבוסס על XLA, הוא פריימוורק שמתמקד בקומפיילר, אבל יש מקרים ספציפיים שבהם צריך לשלוט ישירות בחומרה כדי להגיע לביצועים מקסימליים4. קרנלים בהתאמה אישית הם קריטיים כדי להפיק את הביצועים הטובים ביותר ממשאבי מאיצים יקרים של למידת מכונה, כמו TPU ו-GPU. למרות שהם נמצאים בשימוש נרחב כדי לאפשר ביצוע יעיל של אופרטורים מרכזיים כמו Attention, ההטמעה שלהם דורשת הבנה מעמיקה של המודל ושל ארכיטקטורת החומרה של היעד. Tokamax מספק מקור מהימן אחד של ליבות שנבדקו היטב, בעלות ביצועים גבוהים, בשילוב עם תשתית משותפת חזקה לפיתוח, לתחזוקה ולניהול מחזור החיים שלהן. ספרייה כזו יכולה גם לשמש כהטמעה לדוגמה, שאפשר להרחיב ולהתאים אישית לפי הצורך. כך תוכלו להתמקד במאמצי המודלים בלי לדאוג לתשתית.
4זוהי פרדיגמה מבוססת היטב ויש לה תקדים בעולם המעבדים, שבו קוד מקומפל מהווה את עיקר התוכנית, ומפתחים משתמשים בפונקציות פנימיות או ב-inline assembly כדי לבצע אופטימיזציה של קטעים קריטיים לביצועים.
עיצוב
לכל ליבה נתונה, Tokamax מספק ממשק API נפוץ שיכול להיות מגובה על ידי מספר הטמעות. לדוגמה, אפשר להטמיע ליבות TPU באמצעות הורדת XLA רגילה, או באופן מפורש באמצעות Pallas/Mosaic-TPU. אפשר להטמיע ליבות GPU באמצעות הפחתת XLA רגילה, עם Mosaic-GPU או Triton. כברירת מחדל, ה-API של Tokamax בוחר את ההטמעה הכי מוכרת להגדרה נתונה, שנקבעת לפי תוצאות שנשמרו במטמון מהרצות תקופתיות של כוונון אוטומטי והשוואה לשוק, אבל אתם יכולים לבחור הטמעות ספציפיות אם צריך. יכול להיות שנוסיף הטמעות חדשות עם הזמן כדי לנצל טוב יותר תכונות ספציפיות בדורות חדשים של חומרה, וכך לשפר עוד יותר את הביצועים.
רכיב מרכזי בספריית Tokamax, מעבר לקרנלים עצמם, הוא התשתית התומכת שמאפשרת לכתוב קרנלים בהתאמה אישית. לדוגמה, תשתית הכוונון האוטומטי מאפשרת להגדיר קבוצה של פרמטרים (למשל, גודלי משבצות) ש-Tokamax יכול לבצע עליהם סריקה מקיפה, כדי לקבוע את ההגדרות המכווננות הטובות ביותר ולשמור אותן במטמון. רגרסיות ליליות מגינות עליכם מפני בעיות מספריות ובעיות ביצועים בלתי צפויות שנגרמות כתוצאה משינויים בתשתית הבסיסית של המהדר או ביחסי תלות אחרים.
נקודות החוזק העיקריות
- חוויית פיתוח חלקה: ספרייה מאוחדת ואוצרת מספקת הטמעות ידועות וטובות עם ביצועים גבוהים של ליבות מפתח, עם ביטויים ברורים של דורות חומרה נתמכים וביצועים צפויים, באופן פרוגרמטי ובתיעוד. כך מצמצמים את הפיצול ואת שיעור הנטישה.
- גמישות וניהול מחזור החיים: אתם יכולים לבחור הטמעות שונות, ואפילו לשנות אותן לאורך זמן לפי הצורך. לדוגמה, אם מהדר ה-XLA משפר את התמיכה בפעולות מסוימות, וכבר לא צריך ליבות בהתאמה אישית, יש דרך להוצאה משימוש ולהעברה.
- יכולת הרחבה: אתם יכולים להטמיע ליבות משלכם, תוך שימוש בתשתית משותפת עם תמיכה טובה, וכך להתמקד ביכולות ובאופטימיזציות שמוסיפות ערך. הטמעות סטנדרטיות שכתובות בצורה ברורה משמשות כנקודת התחלה למשתמשים, כדי שיוכלו ללמוד מהן ולהרחיב אותן.
Qwix: קוונטיזציה מקיפה ולא פולשנית
Qwix היא ספריית קוונטיזציה מקיפה ל-JAX AI Stack, שתומכת גם במודלי LLM וגם בסוגי מודלים אחרים בכל השלבים, כולל אימון (אימון מודע לקוונטיזציה (QAT), טכניקת קוונטיזציה (QT), התאמה קוונטית בדרגה נמוכה (QLoRA)) והסקת מסקנות אחרי אימון קוונטיזציה (PTQ), שמטרגטת גם את XLA וגם את זמני הריצה במכשיר.
למה בחרנו לעשות זאת?
ספריות קוונטיזציה קיימות, במיוחד בסביבה העסקית של PyTorch, משמשות לעיתים קרובות למטרות מוגבלות (לדוגמה, רק PTQ או רק QLoRA). הפיצול הזה מאלץ אתכם להחליף כלים, וזה פוגע בשימוש עקבי בקוד ובהתאמה מספרית מדויקת בין האימון לבין ההסקה. בנוסף, פתרונות רבים דורשים שינויים משמעותיים במודל, ויוצרים צימוד חזק בין הלוגיקה של המודל לבין הלוגיקה של הקוונטיזציה.
עיצוב
פילוסופיית העיצוב של Qwix מדגישה פתרון מקיף, וחשוב מכך, שילוב מודלים לא פולשני. הוא בנוי בצורה היררכית וניתנת להרחבה, שמבוססת על ממשקי API פונקציונליים לשימוש חוזר.
השילוב הלא פולשני הזה מתבצע באמצעות מנגנון יירוט שתוכנן בקפידה, שמפנה פונקציות JAX למקבילות המכומתות שלהן. כך אפשר לשלב את המודלים בלי לבצע שינויים, ולהפריד לחלוטין בין קוד הקוונטיזציה לבין הגדרות המודל.
בדוגמה הבאה מוצגת הפעלה של קוונטיזציה מסוג w4a4 (משקל של 4 ביטים, הפעלה של 4 ביטים) לשכבות ה-MLP של מודל LLM, וקוונטיזציה מסוג w8 (משקל של 8 ביטים) למטמיע. כדי לשנות את מתכון הקוונטיזציה, צריך רק לעדכן את רשימת הכללים.
fp_model = ModelWithoutQuantization(...)
rules = [
    qwix.QuantizationRule(
        module_path=r'embedder',
        weight_qtype='int8',
    ),
    qwix.QuantizationRule(
        module_path=r'layers_\d+/mlp',
        weight_qtype='int4',
        act_qtype='int4',
        tile_size=128,
        weight_calibration_method='rms,7',
    ),
]
quantized_model = qwix.quantize_model(fp_model, qwix.PtqProvider(rules))
נקודות החוזק העיקריות
- פתרון מקיף: אפשר להשתמש ב-Qwix במגוון רחב של תרחישי קוונטיזציה, וכך להבטיח שימוש עקבי בקוד בין האימון לבין ההסקה.
- שילוב מודלים לא פולשני: כמו שמוצג בדוגמה, אתם יכולים לשלב מודלים באמצעות שורת קוד אחת. כך אפשר להשתמש בהיפר-פרמטרים בהרבה סכימות קוונטיזציה כדי למצוא את האיזון הטוב ביותר בין איכות לביצועים.
- שילוב חלק עם ספריות אחרות: Qwix משתלב בצורה חלקה עם JAX AI Stack. לדוגמה, Tokamax מתאים את עצמו באופן אוטומטי לשימוש בגרסאות מכווננות של ליבות, בלי קוד משתמש נוסף, כשהמודל מכוונן באמצעות Qwix.
- מתאים למחקר: ממשקי ה-API הבסיסיים והארכיטקטורה הניתנת להרחבה של Qwix מאפשרים לחוקרים לבחון אלגוריתמים חדשים ולבצע השוואות פשוטות באמצעות כלי השוואה והערכה משולבים.
שכבת האפליקציות: אימון והתאמה
אימון מודלים בסיסיים: MaxText ו-MaxDiffusion
MaxText ו-MaxDiffusion הם מסגרות האימון המובילות של Google למודלים של LLM ודיפוזיה, בהתאמה. המאגרים האלה מכילים מבחר של הטמעות שעברו אופטימיזציה גבוהה של מודלים פופולריים עם משקלים פתוחים. יש להם מטרה כפולה: הם משמשים גם כבסיס קוד מוכן לאימון מודלים וגם כקובץ עזר שמפתחי מודלים בסיסיים יכולים להשתמש בו כדי לבנות עליו.
למה בחרנו לעשות זאת?
העניין באימון מודלים של GenAI גדל במהירות בכל התעשייה. הפופולריות של מודלים פתוחים האיצה את המגמה הזו, והם מספקים ארכיטקטורות מוכחות. כדי לאמן את המודלים האלה ולהתאים אותם, נדרשים ביצועים גבוהים, יעילות, יכולת התאמה למספר גדול של שבבים וקוד ברור ומובן. MaxText ו-MaxDiffusion הם פתרונות מקיפים שאפשר להשתמש בהם ב-TPU או ב-GPU, והם נועדו לענות על הצרכים האלה.
עיצוב
MaxText ו-MaxDiffusion הם בסיסי קוד של מודלים בסיסיים שנועדו להיות קריאים ובעלי ביצועים גבוהים. הם בנויים מרכיבים שנבדקו היטב וניתנים לשימוש חוזר: הגדרות מודל שמשתמשות בקרנלים מותאמים אישית (כמו Tokamax) לביצועים מקסימליים, רתמת אימון לתזמור ולמעקב, ומערכת הגדרות חזקה שמאפשרת לשלוט בפרטים כמו פיצול וכימות (באמצעות Qwix) דרך ממשק אינטואיטיבי. תכונות מתקדמות לאמינות, כמו נקודות בקרה בכמה רמות, משולבות כדי להבטיח קצב העברת נתונים תקין ומתמשך.
כדי לספק יכולות ליבה, MaxText ו-MaxDiffusion משתמשים בספריות JAX הטובות מסוגן: Qwix, Tunix, Orbax ו-Optax. הספריות האלה מספקות תשתית חזקה וניתנת להתאמה, שמפחיתה את התקורה של הפיתוח ומאפשרת לכם להתמקד במשימת המודלים. לצורך הסקת מסקנות, קוד המודל משותף כדי לאפשר הצגה יעילה וניתנת להתאמה.
נקודות החוזק העיקריות
- ביצועים גבוהים: עם תשתית אימון שמוגדרת ל-goodput גבוה (תפוקה שימושית) והטמעות של מודלים שעברו אופטימיזציה ל-MFU גבוה (Model Flops Utilization), MaxText ו-MaxDiffusion מספקים ביצועים גבוהים בהרחבה אופקית, בלי צורך בהגדרות נוספות.
- מיועדים לשינוי קנה מידה: בעזרת JAX AI Stack (במיוחד Pathways), אפשר לשנות את קנה המידה בצורה חלקה מעשרות שבבים לעשרות אלפי שבבים.
- בסיס יציב למפתחים של מודלים בסיסיים: ההטמעות הקריאות והאיכותיות משמשות כנקודת התחלה יציבה למפתחים, שיכולים להשתמש בהן כפתרון מקצה לקצה או כהטמעת עזר להתאמות אישיות משלהם.
אימון והתאמה לאחר האימון: Tunix Framework
Tunix מציע אלגוריתמים מתקדמים בקוד פתוח ללמידת חיזוק (RL), לצד מסגרת ותשתית חזקות, ומספק למפתחים דרך יעילה להתנסות בטכניקות של אחרי אימון של LLM, כולל כוונון מפוקח (SFT) והתאמה באמצעות JAX ו-TPU.
למה בחרנו לעשות זאת?
השלב שאחרי האימון הוא שלב קריטי במימוש הפוטנציאל האמיתי של מודלים מסוג LLM. שלב הלמידה באמצעות חיזוקים (RL) חשוב במיוחד לפיתוח יכולות התאמה וחשיבה. הפיתוח בקוד פתוח בתחום הזה התבסס כמעט אך ורק על PyTorch ו-GPU, מה שיוצר פער משמעותי בפתרונות JAX ו-TPU. Tunix (Tune-in-JAX) היא ספריית Native של JAX עם ביצועים גבוהים, שנועדה לגשר על הפער הזה.
עיצוב

מבחינת framework, Tunix מאפשר הגדרה המתקדם ביותר (SOTA) שמפרידה באופן ברור בין אלגוריתמים של למידת חיזוק לבין התשתית. הוא מציע API קל משקל דמוי לקוח שמסתיר את המורכבות של תשתית ה-RL, ומאפשר לכם לפתח אלגוריתמים חדשים. Tunix מספק פתרונות מוכנים לשימוש לאלגוריתמים פופולריים, כולל Proximal Policy Optimization (PPO), Direct Preference Optimization (DPO) ועוד.
בצד התשתית, Tunix משולב עם Pathways, מה שמאפשר ארכיטקטורה של בקר יחיד שהופכת את אימון ה-RL מרובה הצמתים לנגיש. בצד האימון, Tunix תומך באופן מקורי באימון יעיל של פרמטרים (לדוגמה, LoRA) ומשתמש ב-JAX sharding וב-XLA (תרשים חישוב של ML עם מקביליות כללית וניתנת להתאמה (GSPMD)) כדי ליצור תרשים חישוב יעיל. הוא תומך במודלים פופולריים של קוד פתוח כמו Gemma ו-Llama.
נקודות החוזק העיקריות
- פשטות: הוא מספק API ברמה גבוהה, שדומה ללקוח, ומסתיר את המורכבות של התשתית המבוזרת שמתחתיו.
- יעילות למפתחים: Tunix מאיץ את מחזור החיים של המחקר והפיתוח באמצעות אלגוריתמים ו"מתכונים" מובְנים, ומספק מודל עבודה שמאפשר לבצע איטרציות במהירות.
- ביצועים וסקלביליות: Tunix מאפשר תשתית אימון יעילה מאוד וסקלבילית אופקית, על ידי שימוש ב-Pathways כבקר יחיד בקצה העורפי.
שכבת האפליקציות: הפקה והסקה
אחד האתגרים ההיסטוריים באימוץ JAX היה המעבר ממחקר לייצור. עכשיו JAX AI Stack מספקת סיפור הפקה בשל בשני חלקים, שמציע גם תאימות לסביבה העסקית וגם ביצועים של JAX.
הסקת מסקנות ב-LLM עם ביצועים גבוהים: הפתרון של vLLM-JAX
vLLM-JAX הוא קצה עורפי להסקת מסקנות בביצועים גבוהים של Google, שנועד להריץ מודלי שפה גדולים (LLM) של JAX ביעילות ב-Cloud TPU. הוא משלב את מסגרת vLLM בקוד פתוח עם הסביבה העסקית של JAX ו-TPU של Google. כדי להציג מודלים של PyTorch באמצעות vLLM ביחידות TPU, קראו את המאמר PyTorch ב-Cloud TPU.
למה בחרנו לעשות זאת?
התחום מתפתח במהירות, ויש ביקוש הולך וגובר לפתרונות הסקת מסקנות חלקים, בעלי ביצועים גבוהים וקלים לשימוש. מפתחים נתקלים לעיתים קרובות באתגרים משמעותיים בגלל כלים מורכבים ולא עקביים, ביצועים נמוכים ותאימות מוגבלת למודלים. מערך הכלים של vLLM נותן מענה לבעיות האלה באמצעות פלטפורמה אחידה, יעילה ואינטואיטיבית.
עיצוב
הפתרון הזה מרחיב את מסגרת ה-vLLM, במקום להמציא אותה מחדש. vLLM-JAX הוא מנוע להצגת LLM בקוד פתוח שעבר אופטימיזציה, וידוע בנפח העיבוד הגבוה שלו, שמושג באמצעות תכונות עיקריות כמו PagedAttention (שמנהלת מטמונים של KV כמו זיכרון וירטואלי כדי למזער את הפרגמנטציה) ו-Continuous Batching (שמוסיפה בקשות לאצווה באופן דינמי כדי לשפר את הניצול).
vLLM-JAX מתבסס על הבסיס הזה ומפתח רכיבי ליבה לטיפול בבקשות, לתזמון ולניהול זיכרון. הוא מציג קצה עורפי מבוסס-JAX שמשמש כגשר, ומתרגם את התרשים החישובי ואת פעולות הזיכרון של vLLM לקוד שניתן להפעיל ב-TPU. ה-backend הזה מטפל באינטראקציות עם המכשיר, בהפעלת מודל JAX ובפרטים של ניהול מטמון ה-KV בחומרת TPU. הוא כולל אופטימיזציות ספציפיות ל-TPU, כמו מנגנוני קשב יעילים (לדוגמה, שימוש בקרנלים של JAX Pallas ל-Ragged Paged Attention) וקוונטיזציה, שכולם מותאמים לארכיטקטורת ה-TPU.
נקודות החוזק העיקריות
- אין עלות להוספה או להסרה של משתמשים: המשתמשים יכולים לאמץ את הפתרון הזה בלי קשיים משמעותיים. מבחינת חוויית המשתמש, עיבוד בקשות להסקת מסקנות ב-TPU אמור להיות זהה לעיבוד ב-GPU. ממשק שורת הפקודה (CLI) להפעלת השרת, לאישור ההנחיות ולהחזרת הפלט משותף לכולם.
- אימוץ מלא של הסביבה העסקית: הגישה הזו משתמשת בממשק ובחוויית המשתמש של vLLM ותורמת להם, וכך מבטיחה תאימות וקלות שימוש.
- יכולת המרה בין TPU ל-GPU: הפתרון פועל ביעילות גם ב-TPU וגם ב-GPU, ומעניק לכם גמישות.
- משתלם (הביצועים הכי טובים ביחס לעלות): אופטימיזציה של הביצועים כדי לספק את היחס הטוב ביותר בין ביצועים לעלות במודלים פופולריים.
JAX serving: Orbax serialization and Neptune serving engine
למודלים שהם לא LLM, או למשתמשים שרוצים צינור עיבוד נתונים שמותאם באופן מלא ל-JAX, ספריית הסריאליזציה Orbax ומערכת Neptune serving engine (NSE) מספקות פתרון להצגת מודעות מקצה לקצה עם ביצועים גבוהים.
למה בחרנו לעשות זאת?
בעבר, מודלים של JAX הסתמכו לעיתים קרובות על נתיב עקיף לייצור, כמו אריזה בתרשימים של TensorFlow ופריסה באמצעות TensorFlow Serving. הגישה הזו יצרה מגבלות משמעותיות וחוסר יעילות, כי המפתחים נאלצו להשתמש בסביבה נפרדת, וזה האט את תהליך הפיתוח. מערכת ייעודית להצגת מודעות שמותאמת ל-JAX חיונית לקיימוּת, להפחתת המורכבות ולביצועים אופטימליים.
עיצוב
הפתרון הזה מורכב משני רכיבים עיקריים, כמו שמוצג בתרשים הבא.

- ספריית הסריאליזציה של Orbax: מספקת ממשקי API ידידותיים למשתמש לסריאליזציה של מודלים של JAX לפורמט סריאליזציה חדש ויציב של Orbax. הפורמט הזה מותאם לפריסה בסביבת ייצור. הוא מייצג ישירות חישובים של מודל JAX באמצעות StableHLO, ומאפשר לייצג את תרשים החישוב באופן מקורי. הוא גם משתמש ב-TensorStore כדי לאחסן משקלים, וכך מאפשר טעינה מהירה של נקודות ביקורת לצורך הצגת מודעות.
- Neptune Serving Engine (NSE): מנוע להצגת מודעות, גמיש ובעל ביצועים גבוהים (בדרך כלל נפרס כקובץ בינארי של C++), שנועד להריץ מודלים של JAX בפורמט Orbax באופן מקורי. NSE מציע יכולות חיוניות לייצור, כמו טעינת מודלים מהירה, הצגה בו-זמנית עם תפוקה גבוהה באמצעות אצווה מובנית, תמיכה בכמה גרסאות של מודלים והצגה במארח יחיד ובכמה מארחים (באמצעות PJRT ו-Pathways). אפשר להשתמש ב-Neptune Serving Engine כדי:
- מודלים שהם לא LLM: פתרון לשימוש כללי שמתאים לעומסי עבודה כמו מערכות המלצות, מודלי דיפוזיה ומודלי AI אחרים.
- מודלים קטנים של LLM והצגה "חד-פעמית": המודל מיועד למודלים לא אוטורגרסיביים או למודלים קטנים יותר שמוצגים באופן "אונרי", שבו כל הפלט נוצר במעבר אחד בלי צורך בניהול מצב מורכב כמו מטמון KV.
בקיצור, Neptune Serving Engine ממלא את הפער בהכניס לשימוש בסביבת הייצור מגוון רחב של מודלים שהם לא מודלים גדולים של שפה עם רגרסיה עצמית, ומספק פתרון מקורי ל-TPU עם ביצועים גבוהים לסביבה העסקית הרחבה יותר של ML.
נקודות החוזק העיקריות
- הצגה מקורית של JAX: הפתרון מבוסס באופן מקורי על JAX, וכך אין צורך בתקורה בין-מסגרתית בסריאליזציה ובהצגה של המודל. כך המודל נטען מהר ופועל בצורה אופטימלית במעבדי CPU, GPU ו-TPU.
- פריסה קלה בסביבת הייצור: מודלים שעברו סריאליזציה מספקים נתיב פריסה הרמטי שלא מושפע משינויים ביחסי התלות של Python, ומאפשרים בדיקות תקינות של המודל בזמן הריצה. כך אפשר להעביר מודלים של JAX לייצור בצורה חלקה ואינטואיטיבית.
- חוויית פיתוח משופרת: הפתרון הזה מבטל את הצורך במעטפת מסורבלת של מסגרת, וכך מפחית באופן משמעותי את התלות ואת מורכבות המערכת, ומאיץ את האיטרציה למפתחי JAX.
ניתוח ופרופיילינג בכל המערכת
XProf: פרופיילינג מעמיק של ביצועים שמשולב בחומרה
XProf הוא כלי ליצירת פרופילים ולניתוח ביצועים, שמאפשר לכם לראות לעומק היבטים שונים של ביצוע עומסי עבודה של ML, כדי שתוכלו לנפות באגים ולשפר את הביצועים. הוא משולב באופן עמוק בסביבות JAX ו-TPU.
למה בחרנו לעשות זאת?
מצד אחד, עומסי העבודה של למידת המכונה הופכים ליותר ויותר מורכבים. מצד שני, יש עלייה חדה ביכולות של חומרה ייעודית שמטרגטת את עומסי העבודה האלה. התאמה יעילה בין השניים כדי להבטיח ביצועים ויעילות שיא היא קריטית, בהתחשב בעלויות העצומות של תשתית ML. לשם כך נדרשת תצוגה מעמיקה של עומס העבודה ושל החומרה, שמוצגת באופן שניתן להבין במהירות. XProf מצטיין בזה.
עיצוב
XProf מורכב משני רכיבים עיקריים: איסוף וניתוח.
- איסוף: הכלי XProf אוסף מידע ממקורות שונים: הערות בקוד JAX, מודלים של עלויות לפעולות בתוך מהדר ה-XLA ותכונות ייעודיות ליצירת פרופילים של חומרה בתוך ה-TPU. אפשר להפעיל את האיסוף הזה באופן פרוגרמטי או על פי דרישה, וליצור פריט מידע מקיף על האירוע.
- ניתוח: כלי XProf מעבד את הנתונים שנאספו ויוצר חבילה של תצוגות חזותיות מתקדמות, שאפשר לגשת אליהן באמצעות דפדפן.
נקודות החוזק העיקריות
הכוח האמיתי של XProf נובע מהשילוב העמוק שלו עם כל המערכת, שמספק ניתוח רחב ומעמיק – יתרון מוחשי של הסביבה העסקית המשותפת של JAX/TPU.
- תוכנן במשותף עם ה-TPU: הכלי XProf מנצל את תכונות החומרה שתוכננו במיוחד לאיסוף פרופילים חלק, ומאפשר תקורה של איסוף בשיעור של פחות מ-1%. כך אפשר להפוך את יצירת הפרופילים לחלק קל ואיטרטיבי בתהליך הפיתוח.
- רוחב ועומק הניתוח: XProf מספק ניתוח מעמיק בכמה צירים. הכלים של Gemini כוללים:
- Trace Viewer: תצוגת ציר זמן של הרצת פעולות ביחידות חומרה שונות (לדוגמה, TensorCores).
- HLO Op Profile: פירוט של הזמן הכולל לפי קטגוריות שונות של פעולות.
- Memory Viewer: פירוט של הקצאות הזיכרון לפי פעולות שונות במהלך חלון הפרופיילינג.
- ניתוח Roofline: עוזר לזהות אם פעולות ספציפיות מוגבלות על ידי המחשוב או הזיכרון, ועד כמה הן רחוקות מיכולות השיא של החומרה.
- Graph Viewer: מציג את תרשים ה-HLO המלא שהחומרה מריצה.
נקודת מבט השוואתית: למה כדאי לבחור במחסנית JAX/TPU
בתחום המודרני של למידת מכונה יש הרבה שרשראות כלים מצוינות ומתקדמות. JAX AI Stack מציע יתרונות ייחודיים ומשמעותיים למפתחים שמתמקדים בלמידת מכונה בקנה מידה גדול ובביצועים גבוהים, שנובעים ישירות מהעיצוב המודולרי שלו ומהעיצוב המשותף של החומרה.
יש הרבה מסגרות עבודה שמציעות מגוון רחב של תכונות, אבל JAX AI Stack מספקת יתרונות ספציפיים ומשמעותיים בתחומים מרכזיים של מחזור החיים של הפיתוח:
- חוויית פיתוח פשוטה ויעילה יותר: פרדיגמת הטרנספורמציה של גרדיאנטים שניתן לשרשר ב-Optax מאפשרת אסטרטגיות אופטימיזציה יעילות וגמישות יותר, שמוצהרות פעם אחת, במקום לנהל אותן באופן אימפרטיבי בלולאת האימון. ברמת המערכת, ממשק הבקר היחיד והפשוט יותר של Pathways מסתיר את המורכבות של אימון ריבוי-פרוסות, וזה פישוט משמעותי לחוקרים.
- עמידות בקנה מידה עצום: מחסנית JAX מיועדת לאימון בקנה מידה עצום. Orbax מספק תכונות של "עמידות באימון בקנה מידה גדול", כמו נקודות ביקורת למקרי חירום ונקודות ביקורת בכמה רמות. הוא משלים את Grain, שמציע תמיכה מלאה בשחזור עם ערבובים גלובליים דטרמיניסטיים וטעינת נתונים עם נקודות ביקורת. היכולת ליצור נקודת שחזור אטומית של מצב פייפליין הנתונים (Grain) עם מצב המודל (Orbax) היא יכולת קריטית להבטחת יכולת השחזור במשימות שנמשכות זמן רב.
- סביבה עסקית מלאה מקצה לקצה: ה-stack מספק פתרון מקיף מקצה לקצה. מפתחים יכולים להשתמש ב-MaxText כקובץ עזר של SOTA לאימון, ב-Tunix להתאמה, ולפעול לפי נתיב כפול וברור לייצור באמצעות vLLM-JAX (לתאימות ל-vLLM) ו-NSE (לביצועי JAX).
הרבה סטאקים דומים מבחינת תוכנה ברמה גבוהה, אבל הגורם המכריע הוא בדרך כלל ביצועים/עלות בעלות כוללת (TCO), וזה המקום שבו העיצוב המשותף של JAX ו-TPU מספק יתרון ברור. היתרון הזה בביצועים ובעלות הבעלות הכוללת הוא תוצאה ישירה של השילוב האנכי בין התוכנה לחומרת ה-TPU. היכולת של המקמפל XLA למזג פעולות במיוחד לארכיטקטורת TPU, או של כלי הפרופיילינג XProf להשתמש ב-hardware hooks לפרופיילינג עם תקורה של פחות מ-1%, הן יתרונות מוחשיים של השילוב העמוק הזה.
בארגונים שמאמצים את ה-stack הזה, העובדה ש-JAX AI stack כולל את כל התכונות ממזערת את עלות ההעברה. ללקוחות שמשתמשים בארכיטקטורות פופולריות של מודלים פתוחים, המעבר ממסגרות אחרות ל-MaxText הוא בדרך כלל רק עניין של הגדרת קובצי תצורה. בנוסף, היכולת של המערכת לקלוט פורמטים פופולריים של נקודות ביקורת כמו safetensors מאפשרת להעביר נקודות ביקורת קיימות בלי צורך באימון מחדש ויקר.
בטבלה הבאה מפורטים הרכיבים של JAX AI Stack והרכיבים המקבילים להם בספריות או בסביבות פיתוח אחרות.
| פונקציה | JAX | חלופות/מקבילות במסגרות אחרות5 |
| קומפיילר / זמן ריצה | XLA | סליל השראה, נלהב |
| אימון MultiPod | Pathways | אסטרטגיות של Torch Lightning, Ray Train, Monarch (חדש). |
| מסגרת ליבה | JAX | PyTorch |
| יצירת מודלים | דגמי Flax, Max* | torch.nn.*,
NVidia TransformerEngine, HuggingFace Transformers
|
| אופטימיזציות והפסדים | Optax | torch.optim.*, torch.nn.*Loss |
| טועני נתונים | גרעיניות | Ray Data, טעינת נתונים של HuggingFace |
| נקודת ביקורת | Orbax | נקודות ביקורת מבוזרות של PyTorch, נקודות ביקורת של NeMo |
| קוונטיזציה | Qwix | TorchAO, bitsandbytes |
| יצירת ליבה והטמעות מוכרות | Pallas / Tokamax | Triton/Helion, Liger-kernel, TransformerEngine |
| אחרי אימון או כוונון | Tunix | VERL, NeMoRL |
| יצירת פרופילים | XProf | PyTorch profiler, NSight systems, NSight Compute |
| אימון מודל בסיס | MaxText, MaxDiffusion | NeMo-Megatron, DeepSpeed, TorchTitan |
| הסקת מסקנות באמצעות LLM | vLLM | SGLang |
| הסקה שלא מבוססת על LLM | NSE | Triton Inference Server, RayServe |
5חלק מהמקבילות כאן לא תמיד נכונות, כי מסגרות אחרות מגדירות את גבולות ה-API בצורה שונה מ-JAX. הרשימה של הספריות המקבילות היא חלקית, וספריות חדשות מופיעות לעיתים קרובות.
סיכום: פלטפורמה עמידה ומוכנה לייצור לעתיד של ה-AI
הנתונים בטבלה הקודמת ממחישים מסקנה ברורה – לכל אחת מהחבילות האלה יש יתרונות וחסרונות משלה במספר קטן של תחומים, אבל באופן כללי הן דומות מאוד מבחינת התוכנה. שני המערכים מספקים פתרונות מוכנים לאימון מוקדם, להתאמה לאחר האימון ולפריסה של מודלים בסיסיים.
מערך הכלים JAX AI מציע פתרון יעיל ומשכנע לאימון ולפריסה של מודלים של למידת מכונה בכל קנה מידה. הוא משלב בצורה עמוקה בין תוכנה לחומרת TPU כדי לספק ביצועים מובילים ועלות בעלות כוללת (TCO) נמוכה.
ה-stack מבוסס על מערכות פנימיות שנבדקו בשטח, והוא התפתח כדי לספק אמינות וסקלאביליות מובנות, שמאפשרות למשתמשים לפתח ולפרוס בביטחון אפילו את המודלים הגדולים ביותר. העיצוב המודולרי והקומפוזבילי, שמבוסס על הפילוסופיה של JAX AI Stack, מעניק למשתמשים חופש ושליטה חסרי תקדים, ומאפשר להם להתאים את ה-Stack לצרכים הספציפיים שלהם בלי המגבלות של מסגרת מונוליתית.
XLA ו-Pathways מספקים בסיס שניתן להתאמה ועמיד בפני תקלות, JAX מספק ספריית מספרים יעילה וברורה, ספריות פיתוח ליבה חזקות כמו Flax, Optax, Grain ו-Orbax, כלי ביצועים מתקדמים כמו Pallas, Tokamax ו-Qwix, ושכבת אפליקציה וייצור חזקה ב-MaxText, vLLM ו-NSE. כל אלה הופכים את JAX AI Stack לבסיס עמיד שעליו המשתמשים יכולים לבנות ולהעביר במהירות מחקרים מתקדמים לייצור.