


O Pathways é um ambiente de execução distribuído para o JAX que usa um modelo de execução de controlador único para orquestrar cargas de trabalho de machine learning (ML) em grande escala, multitarefa e ativadas de forma esparsa em uma ou mais frações de TPU. Ele permite que um único processo do Python (o controlador) coordene computações em milhares ou dezenas de milhares de chips de TPU e aloque dinamicamente a computação entre as tarefas.
Em vez de executar uma cópia separada do programa Python em cada VM de TPU, a carga de trabalho do JAX é executada em um processo de CPU do cliente (o controlador) e se comunica por gRPC com um plano de controle do Pathways em um nó principal de CPU, que é uma VM dedicada somente à CPU no cluster que hospeda os serviços de coordenação e compilação do Pathways. O plano de controle compila o código e envia computações para os workers do Pathways em execução nas VMs de TPU.
O Google usa o Pathways internamente para treinar modelos grandes, como o Gemini. O Pathways no Cloud oferece a mesma arquitetura aos clientes do Google Cloud .
Antes de começar
É possível executar o Pathways no Google Kubernetes Engine (GKE) ou em um cluster do Cluster Director com o Slurm. Selecione a guia da sua plataforma para conferir os pré-requisitos.
GKE
Siga os seguintes pré-requisitos:
Este documento pressupõe que você já sabe usar TPUs no GKE, incluindo TPUs de fração única e várias frações no GKE, e tem experiência geral com TPUs de várias frações.
Para criar um cluster, consulte Criar um cluster do GKE com Pathways.
Cluster Director
Siga os seguintes pré-requisitos:
Neste documento, presumimos que você já conhece o Cluster Director, as máquinas de TPU no Cluster Director e a execução de jobs com o Slurm, além de ter experiência geral com TPUs de várias frações.
Para criar um cluster, consulte Criar um cluster do Cluster Director com Pathways.
Controlador único e vários controladores
As cargas de trabalho de ML distribuídas em TPUs usam um modelo de execução de vários controladores (o padrão no JAX) ou um modelo de execução de controlador único (usado pelo Pathways). Os dois modelos diferem em relação ao local em que o código Python é executado, como o programa visualiza os aceleradores e como as cargas de trabalho são coordenadas entre as frações de TPU.
Cargas de trabalho de vários controladores (padrão do JAX)
No modelo de vários controladores, cada VM de TPU nas frações de TPU executa o mesmo script Python. Cada VM de TPU atua como um controlador independente para os chips de TPU conectados diretamente a esse host. As cargas de trabalho de vários controladores têm as seguintes características:
- Controle distribuído: cada VM de TPU executa uma cópia do script Python em lockstep e coordena operações coletivas entre processos.
- Visualização de dispositivo localizada: cada processo do Python gerencia diretamente apenas os chips de TPU
anexados à VM local (
jax.local_devices()), enquantojax.devices()lista todos os dispositivos no cluster. - Execução de programa único e vários dados (SPMD): como cada host executa o mesmo script simultaneamente, as cargas de trabalho de vários controladores seguem principalmente o paradigma SPMD. A orquestração de operações diferentes em subconjuntos distintos de frações de TPU requer uma lógica de coordenação personalizada de vários hosts.
- Ciclo de vida acoplado ao host: como os controladores do Python são executados diretamente nas VMs de TPU, se alguma VM de TPU for interrompida ou falhar, todos os processos do controlador precisarão ser interrompidos e reiniciados juntos.
Cargas de trabalho de controlador único (Pathways)
No modelo de controlador único do Pathways, um único processo do Python atua como o controlador central de toda a carga de trabalho. Seu programa JAX (o controlador) é executado em um host de CPU, como um contêiner em lote em um nó principal de CPU ou uma VM de cliente externa, e se comunica com o ambiente de execução do Pathways por gRPC em vez de ser executado diretamente nas VMs de TPU. As cargas de trabalho de controlador único têm as seguintes características:
- Controle centralizado: você executa e monitora um processo de controlador do Python que envia cálculos para o ambiente de execução do Pathways, que gerencia a execução em todas as VMs de TPU.
- Visualização unificada do dispositivo: seu programa JAX vê todas as frações de TPU como um único
sistema unificado. No código,
jax.process_index()é sempre0, ejax.devices()ejax.local_devices()retornam todos os chips de TPU em todas as frações alocadas como se estivessem conectados a uma máquina grande. - Padrões de computação flexíveis: além do treinamento SPMD padrão, um único controlador pode programar diferentes computações em subconjuntos distintos de aceleradores, oferecendo suporte a paralelismo de pipeline assimétrico, cargas de trabalho multitarefa e esparsidade computacional.
- Ciclo de vida do controlador desacoplado: como o programa Python é executado fora das VMs de TPU, o processo do controlador pode continuar em execução enquanto o gerenciador de recursos do Pathways recupera ou substitui frações de TPU preemptivas. Quando você precisar executar código Python local do host nas VMs de TPU, como carregamento de dados de alta capacidade, pré-processamento ou checkpoint, use o Python colocalizado para executar funções específicas do Python nas CPUs do host de TPU por meio de um servidor sidecar.
Componentes do Pathways
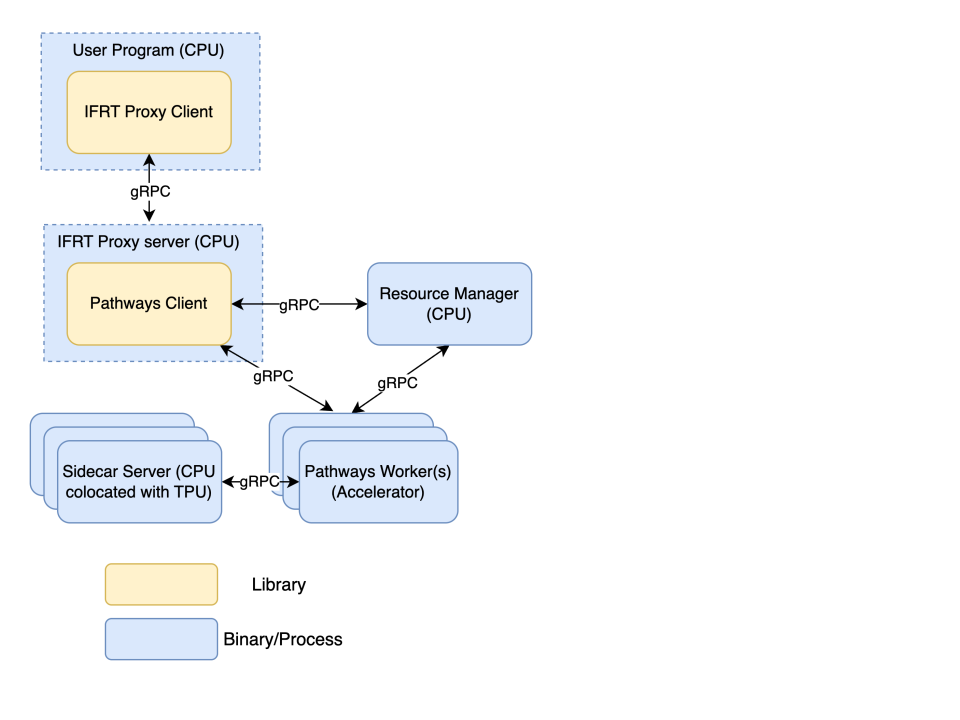
A arquitetura do Pathways distribui componentes em três ambientes: o ambiente de CPU do cliente, um nó principal de CPU e as VMs de worker da TPU. O diagrama a seguir ilustra como esses componentes interagem e onde cada um é executado:
Ambiente de CPU do cliente
É executado em um contêiner de carga de trabalho no nó principal da CPU (típico para jobs em lote no GKE) ou em um contêiner de cliente separado, job do Slurm ou VM de CPU externa (para cargas de trabalho interativas ou Cluster Director):
- Programa do usuário (controlador): seu processo JAX do Python, que define o modelo, o loop de treinamento e a fragmentação de dispositivos e vê todos os chips de TPU nas frações como dispositivos locais.
- Cliente proxy do IFRT: uma biblioteca de código aberto do
Interim Framework Runtime (IFRT)
incorporada ao processo do JAX. Quando você importa
pathwaysutilse defineJAX_PLATFORMS=proxy, ele separa o código do ambiente de execução subjacente e envia solicitações por gRPC para o servidor proxy do IFRT.
Nó principal da CPU
É executado em uma VM dedicada somente para CPU no cluster (um nó de pool de nós de CPU no GKE ou um nó de computação de CPU no Cluster Director):
- Servidor proxy do IFRT: um contêiner de servidor gRPC que recebe solicitações do cliente proxy do IFRT e as encaminha para a biblioteca de cliente do Pathways incorporada.
- Cliente do Pathways: uma biblioteca de ambiente de execução do IFRT incorporada ao contêiner do servidor proxy do IFRT. Ele envia programas do High-Level Optimizer (HLO) para o serviço de compilação no gerenciador de recursos do Pathways e coordena o posicionamento por gRPC. Em seguida, ele envia solicitações de execução e dados de tensor para os workers do Pathways e apresenta uma visualização unificada do dispositivo para o JAX.
- Gerenciador de recursos do Pathways: o contêiner central do plano de controle. Ele gerencia
frações de acelerador, monitora a integridade do worker, programa jobs e hospeda o
serviço de compilação do Pathways, que compila programas HLO em executáveis XLA
armazenados no cache de compilação em
--gcs_scratch_location.
VMs de worker do Cloud TPU
Cada VM de worker de TPU gerencia os chips do Cloud TPU anexados (que executam cálculos XLA compilados) por meio de contêineres de CPU do host:
- Worker do Pathways: carrega executáveis compilados do cache de compilação e recebe solicitações de execução e dados de tensor do cliente do Pathways por gRPC. Ele executa cálculos nos chips do Cloud TPU anexados, troca dados com outros workers por interconexões de alta velocidade e informa a integridade ao gerenciador de recursos.
- Servidor sidecar (opcional, somente GKE): um contêiner gRPC
(
colocated-python-sidecar) que executa funções Python especificadas pelo usuário (como carregamento de dados e checkpoint) na VM de TPU. Ele troca buffers de tensor com o worker local do Pathways usando a memória de host compartilhada de cópia zero. Consulte Executar o Python colocalizado com o Pathways.
Componentes do Pathways no GKE
No GKE, o pod pathways-head é executado em um pool de nós de CPU e hospeda
pathways-rm e pathways-proxy (além do contêiner de carga de trabalho em lote, quando
aplicável). Cada pod de worker da TPU executa worker (ou pathways-worker) e, quando
o Python colocalizado está ativado, colocated-python-sidecar.
As imagens de contêiner do Pathways estão disponíveis nos seguintes locais:
| Tipo de contêiner | Local |
|---|---|
Servidor proxy IFRT |
|
Gerenciador de recursos e worker do Pathways |
|
Sidecar Python colocalizado (opcional) |
|
Gerente de recursos do Pathways
Depois de
criar um cluster do GKE,
use o seguinte containerSpec para implantar o gerenciador de recursos
do Pathways:
  - name: pathways-rm
    image: us-docker.pkg.dev/cloud-tpu-v2-images/cloud-pathways/server:latest
    imagePullPolicy: Always
    env:
    - name: HOST_ADDRESS
      valueFrom:
        fieldRef:
          fieldPath: "metadata.labels['jobset.sigs.k8s.io/coordinator']"
    - name: TPU_SKIP_MDS_QUERY
      value: "true"
    args:
    - --server_port=29001
    - --node_type=resource_manager
    - --instance_count=WORKLOAD_NODEPOOL_COUNT
    - --instance_type=SLICE_TOPOLOGY
    - --gcs_scratch_location=gs://BUCKET_NAME
Substitua:
WORKLOAD_NODEPOOL_COUNT: o número de frações de TPU.SLICE_TOPOLOGY: o tipo de TPU e a topologia da fração, no formatotpuTPU_TYPE:TOPOLOGY, por exemplo,tpuv5e:4x4.BUCKET_NAME: o bucket do Cloud Storage usado para arquivos temporários.
O contêiner também usa os seguintes argumentos:
--server_port: a porta que o gerenciador de recursos do Pathways usa para se comunicar com outros componentes do Pathways (29001neste exemplo).--node_type: o tipo de nó. Defina esse argumento comoresource_managerpara o gerenciador de recursos do Pathways. Ele não é necessário para os outros contêineres.
Servidor proxy IFRT
Use o containerSpec a seguir para implantar um servidor proxy IFRT:
  - name: pathways-proxy
    image: us-docker.pkg.dev/cloud-tpu-v2-images/cloud-pathways/proxy_server:latest
    imagePullPolicy: Always
    env:
    - name: PATHWAYS_HEAD
      valueFrom:
        fieldRef:
          fieldPath: "metadata.labels['jobset.sigs.k8s.io/coordinator']"
    args:
    - --resource_manager_address=$(PATHWAYS_HEAD):29001
    - --server_port=29000
    - --gcs_scratch_location=gs://BUCKET_NAME
    ports:
    - containerPort: 29000
Substitua BUCKET_NAME pelo nome do
bucket do Cloud Storage usado para arquivos temporários.
O contêiner também usa os seguintes argumentos:
--resource_manager_address: o nome do host e a porta que o servidor proxy usa para se comunicar com o gerenciador de recursos do Pathways. A porta precisa corresponder ao valor--server_portusado para o contêiner do gerenciador de recursos do Pathways.--server_port: a porta que o servidor proxy do IFRT usa para se comunicar com o cliente proxy do IFRT (29000neste exemplo).--gcs_scratch_location: o caminho do Cloud Storage usado para arquivos temporários.
Trabalhador do Pathways
Use o seguinte containerSpec para implantar workers do Pathways:
- name: worker
  image: us-docker.pkg.dev/cloud-tpu-v2-images/cloud-pathways/server:latest
  imagePullPolicy: Always
  env:
  - name: PATHWAYS_HEAD
    valueFrom:
      fieldRef:
        fieldPath: "metadata.labels['jobset.sigs.k8s.io/coordinator']"
  - name: MEGASCALE_NUM_SLICES
    valueFrom:
      fieldRef:
        fieldPath: "metadata.labels['jobset.sigs.k8s.io/replicatedjob-replicas']"
  - name: MEGASCALE_SLICE_ID
    valueFrom:
      fieldRef:
        fieldPath: "metadata.labels['jobset.sigs.k8s.io/job-index']"
  - name: MEGASCALE_COORDINATOR_ADDRESS
    value: "$(PATHWAYS_HEAD)"
  args:
  - --server_port=29001
  - --resource_manager_address=$(PATHWAYS_HEAD):29001
  - --gcs_scratch_location=gs://BUCKET_NAME
  ports:
  - containerPort: 29001
  resources:
    limits:
      google.com/tpu: "4"
Substitua BUCKET_NAME pelo nome do
bucket do Cloud Storage usado para arquivos temporários.
O contêiner também usa os seguintes argumentos:
--server_port: a porta que os workers usam para se comunicar com o servidor proxy e o gerenciador de recursos do Pathways (29001neste exemplo).--resource_manager_address: o nome do host e a porta que os workers da TPU usam para se comunicar com o gerenciador de recursos do Pathways. A porta precisa corresponder ao valor--server_portusado para o contêiner do gerenciador de recursos do Pathways.--gcs_scratch_location: o caminho do Cloud Storage usado para arquivos temporários.
O gerenciador de recursos do Pathways, o servidor proxy do IFRT e os workers do Pathways podem ter portas diferentes, mas, neste exemplo, o gerenciador de recursos do Pathways e o worker do Pathways compartilham a mesma porta.
Componentes do Pathways no Cluster Director
Nesta seção, mapeamos os componentes do Pathways para jobs do Slurm em um cluster do Cluster Director.
Os scripts do Pathways executam os componentes do Pathways com o Enroot. O script setup_env.sh
usa as seguintes imagens de contêiner, que correspondem à versão do JAX
(0.11.1) do ambiente Python que ele cria:
| Tipo de contêiner | Local |
|---|---|
Servidor proxy IFRT |
|
Gerenciador de recursos e worker do Pathways |
|
Para iniciar os componentes do Pathways, envie o script start_pathways.sh
como o job de serviço do Pathways. Você não precisa escrever os comandos a seguir.
Os scripts derivam os argumentos das variáveis de ambiente que você define
ao enviar start_pathways.sh, como SLICE_SHAPE, MIN_SLICES,
MAX_SLICES e GCS_BUCKET.
Gerente de recursos do Pathways
O job de serviço do Pathways executa o gerenciador de recursos do Pathways em um nó de CPU. Ele executa o seguinte comando no contêiner do servidor do Pathways:
/pathways/server \
    --server_port=29001 \
    --node_type=resource_manager \
    --instance_type=tpuTPU_TYPE:TOPOLOGY \
    --instance_count=MAX_SLICES \
    --gcs_scratch_location=gs://BUCKET_NAME/pathways-scratch/shared \
    --enable_gcs_olm=false
O script preenche os seguintes marcadores de posição no comando:
TPU_TYPEeTOPOLOGY: o tipo de TPU e a topologia de cada fração, derivados deSLICE_SHAPE. Por exemplo,SLICE_SHAPE=2x4definetpuv6e:2x4.MAX_SLICES: o número máximo de frações de TPU, deMAX_SLICES.BUCKET_NAME: o nome do bucket do Cloud Storage, deGCS_BUCKET.
O comando usa os seguintes argumentos:
--server_port: a porta em que o gerenciador de recursos do Pathways detecta. O servidor proxy do IFRT e os workers do Pathways se conectam a essa porta.--node_type: o tipo de nó,resource_manager. Somente o gerenciador de recursos do Pathways define esse argumento.--instance_type: o tipo de TPU e a topologia de cada fração.--instance_count: o número de frações de TPU.--gcs_scratch_location: o caminho do Cloud Storage usado para arquivos temporários, como o cache de compilação.--enable_gcs_olm: se o Pathways cria regras de ciclo de vida de objetos do Cloud Storage para limpar entradas antigas do cache de compilação. O script desativa isso porque requer permissões adicionais no bucket.
Servidor proxy IFRT
O job de serviço do Pathways executa o servidor proxy do IFRT no mesmo nó de CPU que o gerenciador de recursos do Pathways. Ele executa o seguinte comando no contêiner do servidor proxy do IFRT:
/pathways/proxy_server \
    --server_port=29000 \
    --resource_manager_address=RM_IP:29001 \
    --gcs_scratch_location=gs://BUCKET_NAME/pathways-scratch/shared \
    --num_elastic_instances=MAX_SLICES
O script preenche os seguintes marcadores de posição no comando:
RM_IP: o endereço IP interno do nó de CPU que executa o gerenciador de recursos do Pathways.BUCKET_NAME: o nome do bucket do Cloud Storage, deGCS_BUCKET.MAX_SLICES: o número máximo de frações de TPU, deMAX_SLICES.
O comando usa os seguintes argumentos:
--server_port: a porta em que o servidor proxy do IFRT detecta conexões. Seu programa JAX se conecta a essa porta.--resource_manager_address: o endereço e a porta do gerenciador de recursos do Pathways.--gcs_scratch_location: o mesmo caminho do Cloud Storage que o gerenciador de recursos do Pathways.--num_elastic_instances: o número de frações que podem ficar indisponíveis sem interromper a sessão de proxy do IFRT, deMAX_SLICES. Sua carga de trabalho aplicaMIN_SLICES.
Quando pelo menos MIN_SLICES frações estão em execução, o job de serviço grava o endereço do servidor proxy IFRT em ~/pathways/cluster.env. Seu programa JAX, o cliente proxy do IFRT, lê esse arquivo para se conectar ao Pathways. O programa JAX é executado como
sua carga de trabalho, por exemplo, run_maxtext.sh, ou em um notebook do Jupyter.
Trabalhador do Pathways
O job de serviço do Pathways envia uma matriz de jobs do Slurm (run_worker_slice.sh) com
uma tarefa de matriz para cada fração de TPU. Cada tarefa de matriz executa o seguinte comando
no contêiner do servidor Pathways em cada VM de TPU na fração:
/pathways/server \
    --server_port=29001 \
    --resource_manager_address=RM_IP:29001 \
    --gcs_scratch_location=gs://BUCKET_NAME/pathways-scratch/shared \
    --enable_gcs_olm=false
O script preenche RM_IP com o endereço IP interno
do nó de CPU e BUCKET_NAME com o
nome do bucket do Cloud Storage.
O comando usa os seguintes argumentos:
--server_port: a porta que o worker do Pathways detecta. O gerenciador de recursos do Pathways e o servidor proxy do IFRT se conectam a essa porta.--resource_manager_address: o endereço do gerenciador de recursos do Pathways, o mesmo do servidor proxy do IFRT.--gcs_scratch_locatione--enable_gcs_olm: o mesmo que para o gerenciador de recursos do Pathways.
O script também define a topologia da TPU e as variáveis de ambiente MEGASCALE_*
para cada worker dos nós da fração e o índice de tarefas da matriz.
Se uma fração de TPU for interrompida ou falhar, o Slurm vai colocar a tarefa de matriz na fila novamente. Se você
tiver sudo sem senha
nos nós do cluster, o job de serviço também vai desligar os nós da fração para que
o Slurm possa recriá-los. O gerenciador de recursos do Pathways e o servidor proxy do IFRT
continuam em execução, então o programa JAX não precisa se conectar a um novo endereço.
A seguir
- Criar um cluster do GKE com Pathways
- Criar um cluster do Cluster Director com Pathways
- Executar uma carga de trabalho em lote com o Pathways
- Executar uma carga de trabalho interativa com o Pathways
- Treinamento resiliente com o Pathways
- Portar cargas de trabalho do JAX para o Pathways
- Executar o Python colocalizado com o Pathways
- Resolver problemas de Pathways no Cloud
- Executar cargas de trabalho com o Pathways no Cluster Toolkit