


Pathways ist eine verteilte Laufzeit für JAX, die ein Single-Controller-Ausführungsmodell verwendet, um umfangreiche, Multitasking- und dünnbesetzte ML-Arbeitslasten (Machine Learning) über einen oder mehrere TPU-Slices hinweg zu orchestrieren. Damit kann ein einzelner Python-Prozess (der Controller) Berechnungen auf Tausenden oder Zehntausenden von TPU-Chips koordinieren und die Rechenleistung dynamisch auf Aufgaben verteilen.
Anstatt eine separate Kopie Ihres Python-Programms auf jeder TPU-VM auszuführen, wird Ihre JAX-Arbeitslast in einem Client-CPU-Prozess (dem Controller) ausgeführt und kommuniziert über gRPC mit einer Pathways-Steuerungsebene auf einem CPU-Head-Knoten. Dies ist eine dedizierte reine CPU-VM in Ihrem Cluster, die die Pathways-Koordinations- und Kompilierungsdienste hostet. Die Steuerungsebene kompiliert Ihren Code und sendet Berechnungen an Pathways-Worker, die auf Ihren TPU-VMs ausgeführt werden.
Google verwendet Pathways intern, um große Modelle wie Gemini zu trainieren. Pathways on Cloud bietet Google Cloud -Kunden dieselbe Architektur.
Hinweis
Sie können Pathways in der Google Kubernetes Engine (GKE) oder in einem Cluster Director-Cluster mit Slurm ausführen. Wählen Sie den Tab für Ihre Plattform aus, um die Voraussetzungen zu sehen.
GKE
Erfüllen Sie die folgenden Voraussetzungen:
- Kubernetes-Tools installieren
- Installieren Sie die Google Cloud CLI.
- Aktivieren Sie die Kubernetes Engine API.
In diesem Dokument wird davon ausgegangen, dass Sie bereits mit der Verwendung von TPUs in GKE vertraut sind, einschließlich Single-Slice- und Multi-Slice-TPUs in GKE, und dass Sie allgemeine Erfahrung mit Multi-Slice-TPUs haben.
Informationen zum Erstellen eines Clusters finden Sie unter GKE-Cluster mit Pathways erstellen.
Cluster Director
Erfüllen Sie die folgenden Voraussetzungen:
In diesem Dokument wird davon ausgegangen, dass Sie bereits mit Cluster Director, TPU-Maschinen in Cluster Director und dem Ausführen von Jobs mit Slurm vertraut sind und allgemeine Erfahrung mit Multislice-TPUs haben.
Informationen zum Erstellen eines Clusters finden Sie unter Cluster Director-Cluster mit Pathways erstellen.
Einzelner Controller und mehrere Controller
Verteilte ML-Arbeitslasten auf TPUs verwenden entweder ein Ausführungsmodell mit mehreren Controllern (Standard in JAX) oder ein Ausführungsmodell mit einem einzelnen Controller (von Pathways verwendet). Die beiden Modelle unterscheiden sich darin, wo Ihr Python-Code ausgeführt wird, wie Ihr Programm Beschleuniger sieht und wie Arbeitslasten über TPU-Slices hinweg koordiniert werden.
Arbeitslasten mit mehreren Controllern (JAX-Standard)
Im Multi-Controller-Modell wird auf jeder TPU-VM in Ihren TPU-Slices dasselbe Python-Skript ausgeführt. Jede TPU-VM fungiert als unabhängiger Controller für die TPU-Chips, die direkt mit diesem Host verbunden sind. Arbeitslasten mit mehreren Controllern haben die folgenden Merkmale:
- Verteilte Steuerung: Jede TPU-VM führt eine Kopie Ihres Python-Skripts im Lockstep aus und koordiniert kollektive Vorgänge über Prozesse hinweg.
- Lokalisierte Geräteansicht: Jeder Python-Prozess verwaltet nur die TPU-Chips, die an die lokale VM (
jax.local_devices()) angehängt sind, währendjax.devices()alle Geräte im Cluster auflistet. - SPMD-Ausführung (Single Program, Multiple Data): Da jeder Host dasselbe Skript gleichzeitig ausführt, folgen Multi-Controller-Arbeitslasten hauptsächlich dem SPMD-Paradigma. Für die Orchestrierung verschiedener Vorgänge auf verschiedenen Teilmengen von TPU-Slices ist eine benutzerdefinierte Koordinationslogik für mehrere Hosts erforderlich.
- Hostgekoppelter Lebenszyklus: Da die Python-Controller direkt auf den TPU-VMs ausgeführt werden, müssen alle Controller-Prozesse gemeinsam beendet und neu gestartet werden, wenn eine TPU-VM vorzeitig beendet wird oder ausfällt.
Arbeitslasten mit einem Controller (Pathways)
Im Pathways-Modell mit einem einzelnen Controller fungiert ein einzelner Python-Prozess als zentraler Controller für Ihre gesamte Arbeitslast. Ihr JAX-Programm (der Controller) wird auf einem CPU-Host ausgeführt, z. B. einem Batchcontainer auf einem CPU-Head-Knoten oder einer externen Client-VM, und kommuniziert über gRPC mit der Pathways-Laufzeit, anstatt direkt auf Ihren TPU-VMs ausgeführt zu werden. Arbeitslasten mit einem einzelnen Controller haben die folgenden Merkmale:
- Zentrale Steuerung: Sie führen einen Python-Controller-Prozess aus und überwachen ihn. Dieser Prozess sendet Berechnungen an die Pathways-Laufzeit, die die Ausführung auf allen TPU-VMs verwaltet.
- Einheitliche Geräteansicht: Ihr JAX-Programm sieht alle TPU-Slices als ein einziges einheitliches System. In Ihrem Code ist
jax.process_index()immer0und sowohljax.devices()als auchjax.local_devices()geben alle TPU-Chips in allen zugewiesenen Slices zurück, als wären sie an eine große Maschine angeschlossen. - Flexible Berechnungsmuster: Zusätzlich zum SPMD-Standardtraining kann ein einzelner Controller verschiedene Berechnungen für unterschiedliche Teilmengen von Beschleunigern planen. Dies unterstützt asymmetrische Pipeline-Parallelität, Multitasking-Arbeitslasten und dünnbesetzte Berechnungen.
- Entkoppelter Controller-Lebenszyklus: Da Ihr Python-Programm außerhalb der TPU-VMs ausgeführt wird, kann der Controller-Prozess weiterlaufen, während der Pathways-Ressourcenmanager TPU-Slices, die vorzeitig beendet wurden, wiederherstellt oder ersetzt. Wenn Sie hostlokalen Python-Code auf den TPU-VMs ausführen müssen, z. B. für das Laden von Daten mit hohem Durchsatz, die Vorverarbeitung oder das Erstellen von Prüfpunkten, können Sie colocated Python verwenden, um bestimmte Python-Funktionen über einen Sidecar-Server auf den TPU-Host-CPUs auszuführen.
Pathways-Komponenten
Die Pathways-Architektur verteilt Komponenten auf drei Umgebungen: Ihre Client-CPU-Umgebung, einen CPU-Hauptknoten und die TPU-Worker-VMs. Das folgende Diagramm veranschaulicht, wie diese Komponenten interagieren und wo die einzelnen Komponenten ausgeführt werden:
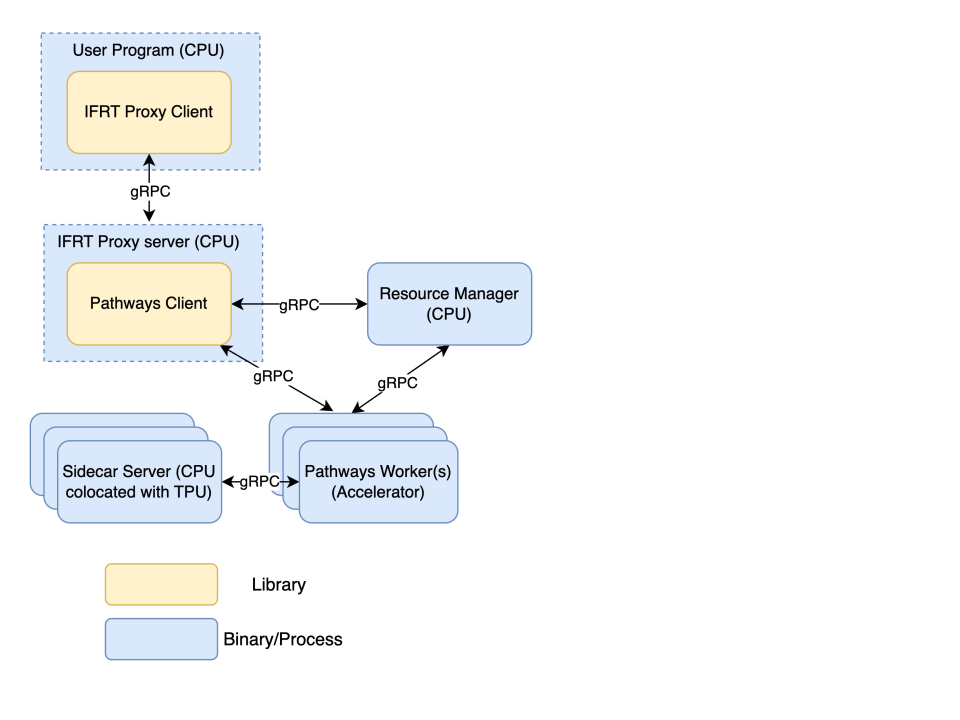
CPU-Umgebung des Clients
Wird in einem Arbeitslastcontainer auf dem CPU-Head-Knoten (typisch für Batchjobs in GKE) oder in einem separaten Clientcontainer, Slurm-Job oder einer externen CPU-VM (für interaktive Arbeitslasten oder Cluster Director) ausgeführt:
- Nutzerprogramm (Controller): Ihr Python-JAX-Prozess, der Ihr Modell, Ihre Trainingsschleife und Ihr Geräte-Sharding definiert und alle TPU-Chips in allen Slices als lokale Geräte sieht.
- IFRT-Proxy-Client: Eine Open-Source-Bibliothek der Interim Framework Runtime (IFRT), die in Ihren JAX-Prozess eingebettet ist. Wenn Sie
pathwaysutilsimportieren undJAX_PLATFORMS=proxyfestlegen, wird Ihr Code von der zugrunde liegenden Laufzeit entkoppelt und Anfragen werden über gRPC an den IFRT-Proxyserver gesendet.
CPU-Hauptknoten
Wird auf einer dedizierten CPU-VM in Ihrem Cluster ausgeführt (ein CPU-Knotenpoolknoten in GKE oder ein CPU-Rechenknoten in Cluster Director):
- IFRT-Proxyserver: Ein gRPC-Servercontainer, der Anfragen vom IFRT-Proxyclient empfängt und an die eingebettete Pathways-Clientbibliothek weiterleitet.
- Pathways-Client: Eine IFRT-Laufzeitbibliothek, die im IFRT-Proxyserver-Container eingebettet ist. Es sendet HLO-Programme (High-Level Optimizer) an den Kompilierungsdienst im Pathways-Ressourcenmanager und koordiniert die Platzierung über gRPC. Anschließend werden Ausführungsanfragen und Tensordaten an Pathways-Worker gesendet und eine einheitliche Geräteansicht für JAX bereitgestellt.
- Pathways-Ressourcenmanager: Der zentrale Container der Steuerungsebene. Er verwaltet Beschleuniger-Slices, überwacht den Zustand von Workern, plant Jobs und hostet den Pathways-Kompilierungsdienst, der HLO-Programme in XLA-Ausführbare Dateien kompiliert, die im Kompilierungs-Cache unter
--gcs_scratch_locationgespeichert werden.
Cloud TPU-Worker-VMs
Jede TPU-Worker-VM verwaltet ihre angehängten Cloud TPU-Chips (die kompilierte XLA-Berechnungen ausführen) über Host-CPU-Container:
- Pathways-Worker: Lädt kompilierte ausführbare Dateien aus dem Kompilierungscache und empfängt Ausführungsanfragen und Tensordaten vom Pathways-Client über gRPC. Er führt Berechnungen auf den angehängten Cloud TPU-Chips aus, tauscht Daten mit anderen Workern über Hochgeschwindigkeits-Interconnect-Verbindungen aus und meldet den Zustand an den Ressourcenmanager.
- Sidecar-Server (optional, nur GKE): Ein gRPC-Container (
colocated-python-sidecar), der benutzerdefinierte Python-Funktionen (z. B. Datenladen und Prüfpunkte) auf der TPU-VM ausführt. Es tauscht Tensorpuffer mit dem lokalen Pathways-Worker über den gemeinsam genutzten Hostspeicher ohne Kopieren aus. Weitere Informationen finden Sie unter Colocated Python mit Pathways ausführen.
Pathways-Komponenten in GKE
In GKE wird der Pod pathways-head in einem CPU-Knotenpool ausgeführt und hostet pathways-rm und pathways-proxy (sowie gegebenenfalls Ihren Batcharbeitslast-Container). Auf jedem TPU-Worker-Pod wird worker (oder pathways-worker) ausgeführt und, wenn collocated Python aktiviert ist, colocated-python-sidecar.
Pathways-Container-Images finden Sie an den folgenden Speicherorten:
| Containertyp | Standort |
|---|---|
IFRT-Proxyserver |
|
Pathways-Ressourcenmanager und -Worker |
|
Colocated Python-Sidecar (optional) |
|
Pathways-Ressourcenmanager
Nachdem Sie einen GKE-Cluster erstellt haben, können Sie den Pathways-Ressourcenmanager mit dem folgenden containerSpec bereitstellen:
  - name: pathways-rm
    image: us-docker.pkg.dev/cloud-tpu-v2-images/cloud-pathways/server:latest
    imagePullPolicy: Always
    env:
    - name: HOST_ADDRESS
      valueFrom:
        fieldRef:
          fieldPath: "metadata.labels['jobset.sigs.k8s.io/coordinator']"
    - name: TPU_SKIP_MDS_QUERY
      value: "true"
    args:
    - --server_port=29001
    - --node_type=resource_manager
    - --instance_count=WORKLOAD_NODEPOOL_COUNT
    - --instance_type=SLICE_TOPOLOGY
    - --gcs_scratch_location=gs://BUCKET_NAME
Ersetzen Sie Folgendes:
WORKLOAD_NODEPOOL_COUNT: die Anzahl der TPU-Slices.SLICE_TOPOLOGY: der TPU-Typ und die Topologie des Slice im FormattpuTPU_TYPE:TOPOLOGY, z. B.tpuv5e:4x4.BUCKET_NAME: der Cloud Storage-Bucket, der für temporäre Dateien verwendet wird.
Der Container verwendet außerdem die folgenden Argumente:
--server_port: der Port, den der Pathways-Ressourcenmanager für die Kommunikation mit anderen Pathways-Komponenten verwendet (29001in diesem Beispiel).--node_type: der Knotentyp. Legen Sie dieses Argument für den Pathways-Ressourcenmanager aufresource_managerfest. Für die anderen Container ist er nicht erforderlich.
IFRT-Proxyserver
Sie können den folgenden containerSpec verwenden, um einen IFRT-Proxyserver bereitzustellen:
  - name: pathways-proxy
    image: us-docker.pkg.dev/cloud-tpu-v2-images/cloud-pathways/proxy_server:latest
    imagePullPolicy: Always
    env:
    - name: PATHWAYS_HEAD
      valueFrom:
        fieldRef:
          fieldPath: "metadata.labels['jobset.sigs.k8s.io/coordinator']"
    args:
    - --resource_manager_address=$(PATHWAYS_HEAD):29001
    - --server_port=29000
    - --gcs_scratch_location=gs://BUCKET_NAME
    ports:
    - containerPort: 29000
Ersetzen Sie BUCKET_NAME durch den Namen des Cloud Storage-Bucket, der für temporäre Dateien verwendet wird.
Der Container verwendet außerdem die folgenden Argumente:
--resource_manager_address: Der Hostname und der Port, die der Proxyserver für die Kommunikation mit dem Pathways-Ressourcenmanager verwendet. Der Port muss mit dem--server_port-Wert übereinstimmen, der für den Pathways-Ressourcenmanager-Container verwendet wird.--server_port: Der Port, den der IFRT-Proxyserver für die Kommunikation mit dem IFRT-Proxyclient verwendet (29000in diesem Beispiel).--gcs_scratch_location: der Cloud Storage-Pfad, der für temporäre Dateien verwendet wird.
Pathways-Mitarbeiter
Sie können die folgenden containerSpec verwenden, um Pathways-Worker bereitzustellen:
- name: worker
  image: us-docker.pkg.dev/cloud-tpu-v2-images/cloud-pathways/server:latest
  imagePullPolicy: Always
  env:
  - name: PATHWAYS_HEAD
    valueFrom:
      fieldRef:
        fieldPath: "metadata.labels['jobset.sigs.k8s.io/coordinator']"
  - name: MEGASCALE_NUM_SLICES
    valueFrom:
      fieldRef:
        fieldPath: "metadata.labels['jobset.sigs.k8s.io/replicatedjob-replicas']"
  - name: MEGASCALE_SLICE_ID
    valueFrom:
      fieldRef:
        fieldPath: "metadata.labels['jobset.sigs.k8s.io/job-index']"
  - name: MEGASCALE_COORDINATOR_ADDRESS
    value: "$(PATHWAYS_HEAD)"
  args:
  - --server_port=29001
  - --resource_manager_address=$(PATHWAYS_HEAD):29001
  - --gcs_scratch_location=gs://BUCKET_NAME
  ports:
  - containerPort: 29001
  resources:
    limits:
      google.com/tpu: "4"
Ersetzen Sie BUCKET_NAME durch den Namen des Cloud Storage-Bucket, der für temporäre Dateien verwendet wird.
Der Container verwendet außerdem die folgenden Argumente:
--server_port: der Port, den die Worker für die Kommunikation mit dem Proxyserver und dem Pathways-Ressourcenmanager verwenden (29001in diesem Beispiel).--resource_manager_address: der Hostname und der Port, über den die TPU-Worker mit dem Pathways-Ressourcenmanager kommunizieren. Der Port muss mit dem--server_port-Wert übereinstimmen, der für den Pathways-Ressourcenmanager-Container verwendet wird.--gcs_scratch_location: der Cloud Storage-Pfad, der für temporäre Dateien verwendet wird.
Der Pathways-Ressourcenmanager, der IFRT-Proxyserver und die Pathways-Worker können alle unterschiedliche Ports haben. In diesem Beispiel verwenden der Pathways-Ressourcenmanager und der Pathways-Worker jedoch denselben Port.
Pathways-Komponenten in Cluster Director
In diesem Abschnitt werden Pathways-Komponenten Slurm-Jobs in einem Cluster Director-Cluster zugeordnet.
Die Pathways-Skripts führen die Pathways-Komponenten mit Enroot aus. Das Script setup_env.sh verwendet die folgenden Container-Images, die der JAX-Version (0.11.1) der von ihm erstellten Python-Umgebung entsprechen:
| Containertyp | Standort |
|---|---|
IFRT-Proxyserver |
|
Pathways-Ressourcenmanager und -Worker |
|
Sie starten die Pathways-Komponenten, indem Sie das Skript start_pathways.sh als Pathways-Dienstjob senden. Sie schreiben die folgenden Befehle nicht selbst.
Die Skripts leiten die Argumente von den Umgebungsvariablen ab, die Sie beim Senden von start_pathways.sh festlegen, z. B. SLICE_SHAPE, MIN_SLICES, MAX_SLICES und GCS_BUCKET.
Pathways-Ressourcenmanager
Der Pathways-Dienstjob führt den Pathways-Ressourcenmanager auf einem CPU-Knoten aus. Im Pathways-Servercontainer wird der folgende Befehl ausgeführt:
/pathways/server \
    --server_port=29001 \
    --node_type=resource_manager \
    --instance_type=tpuTPU_TYPE:TOPOLOGY \
    --instance_count=MAX_SLICES \
    --gcs_scratch_location=gs://BUCKET_NAME/pathways-scratch/shared \
    --enable_gcs_olm=false
Das Skript füllt die folgenden Platzhalter im Befehl aus:
TPU_TYPEundTOPOLOGY: der TPU-Typ und die Topologie jedes Slices, abgeleitet vonSLICE_SHAPE. Beispielsweise wird mitSLICE_SHAPE=2x4tpuv6e:2x4festgelegt.MAX_SLICES: die maximale Anzahl von TPU-Slices, vonMAX_SLICES.BUCKET_NAME: der Name Ihres Cloud Storage-Bucket ausGCS_BUCKET.
Der Befehl verwendet die folgenden Argumente:
--server_port: der Port, den der Pathways-Ressourcenmanager überwacht. Der IFRT-Proxyserver und die Pathways-Worker stellen eine Verbindung zu diesem Port her.--node_type: der Knotentyp,resource_manager. Dieses Argument wird nur vom Pathways-Ressourcenmanager festgelegt.--instance_type: der TPU-Typ und die Topologie der einzelnen Slices.--instance_count: die Anzahl der TPU-Slices.--gcs_scratch_location: der Cloud Storage-Pfad, der für temporäre Dateien wie den Kompilierungscache verwendet wird.--enable_gcs_olm: Gibt an, ob Pathways Cloud Storage-Objektlebenszyklusregeln erstellt, um alte Kompilierungscache-Einträge zu bereinigen. Das Skript deaktiviert diese Funktion, da zusätzliche Berechtigungen für den Bucket erforderlich sind.
IFRT-Proxyserver
Der Pathways-Dienstjob führt den IFRT-Proxyserver auf demselben CPU-Knoten wie den Pathways-Ressourcenmanager aus. Im IFRT-Proxyserver-Container wird der folgende Befehl ausgeführt:
/pathways/proxy_server \
    --server_port=29000 \
    --resource_manager_address=RM_IP:29001 \
    --gcs_scratch_location=gs://BUCKET_NAME/pathways-scratch/shared \
    --num_elastic_instances=MAX_SLICES
Das Skript füllt die folgenden Platzhalter im Befehl aus:
RM_IP: die interne IP-Adresse des CPU-Knotens, auf dem der Pathways-Ressourcenmanager ausgeführt wird.BUCKET_NAME: der Name Ihres Cloud Storage-Bucket ausGCS_BUCKET.MAX_SLICES: die maximale Anzahl von TPU-Slices, vonMAX_SLICES.
Der Befehl verwendet die folgenden Argumente:
--server_port: der Port, den der IFRT-Proxyserver überwacht. Ihr JAX-Programm stellt eine Verbindung zu diesem Port her.--resource_manager_address: die Adresse und der Port des Pathways-Ressourcenmanagers.--gcs_scratch_location: derselbe Cloud Storage-Pfad wie der Pathways-Ressourcenmanager.--num_elastic_instances: die Anzahl der Slices, die nicht verfügbar sein können, ohne die IFRT-Proxy-Sitzung zu beenden, vonMAX_SLICES. Ihre Arbeitslast erzwingtMIN_SLICES.
Wenn mindestens MIN_SLICES Slices ausgeführt werden, schreibt der Dienstjob die Adresse des IFRT-Proxyservers in ~/pathways/cluster.env. Ihr JAX-Programm, der IFRT-Proxy-Client, liest diese Datei, um eine Verbindung zu Pathways herzustellen. Das JAX-Programm wird als Arbeitslast ausgeführt, z. B. run_maxtext.sh, oder in einem Jupyter-Notebook.
Pathways-Mitarbeiter
Der Pathways-Dienstjob sendet ein Slurm-Job-Array (run_worker_slice.sh) mit einer Array-Aufgabe für jedes TPU-Slice. Jede Array-Aufgabe führt den folgenden Befehl im Pathways-Servercontainer auf jeder TPU-VM in ihrem Slice aus:
/pathways/server \
    --server_port=29001 \
    --resource_manager_address=RM_IP:29001 \
    --gcs_scratch_location=gs://BUCKET_NAME/pathways-scratch/shared \
    --enable_gcs_olm=false
Das Script füllt RM_IP mit der internen IP-Adresse des CPU-Knotens und BUCKET_NAME mit dem Namen Ihres Cloud Storage-Bucket.
Der Befehl verwendet die folgenden Argumente:
--server_port: der Port, den der Pathways-Worker überwacht. Der Pathways-Ressourcenmanager und der IFRT-Proxyserver stellen eine Verbindung zu diesem Port her.--resource_manager_address: die Adresse des Pathways-Ressourcenmanagers, die mit der des IFRT-Proxyservers übereinstimmt.--gcs_scratch_locationund--enable_gcs_olm: wie beim Pathways-Ressourcenmanager.
Das Script legt außerdem die TPU-Topologie und die Umgebungsvariablen MEGASCALE_* für jeden Worker aus den Knoten des Slice und dem Array-Aufgabenindex fest.
Wenn ein TPU-Slice vorzeitig beendet wird oder fehlschlägt, stellt Slurm die Array-Aufgabe wieder in die Warteschlange. Wenn Sie passwortloses sudo auf den Clusterknoten haben, fährt der Dienstjob auch die Knoten des Slice herunter, damit Slurm sie neu erstellen kann. Der Pathways-Ressourcenmanager und der IFRT-Proxyserver laufen weiter, sodass Ihr JAX-Programm keine Verbindung zu einer neuen Adresse herstellen muss.
Nächste Schritte
- GKE-Cluster mit Pathways erstellen
- Cluster Director-Cluster mit Pathways erstellen
- Batcharbeitslast mit Pathways ausführen
- Interaktive Arbeitslast mit Pathways ausführen
- Ausfallsicheres Training mit Pathways
- JAX-Arbeitslasten zu Pathways portieren
- Colocated Python mit Pathways ausführen
- Fehlerbehebung für Pathways in der Cloud
- Arbeitslasten mit Pathways im Cluster Toolkit ausführen