


עקרון האמינות ב-Google Cloud Well-Architected Framework מספק עקרונות והמלצות שיעזרו לכם לתכנן, לפרוס ולנהל עומסי עבודה אמינים ב- Google Cloud.
המסמך הזה מיועד לאדריכלי ענן, למפתחים, למהנדסי פלטפורמות, לאדמינים ולמהנדסי אמינות אתר (SRE).
אמינות היא היכולת של המערכת לבצע באופן עקבי את הפונקציות המיועדות לה בתנאים שהוגדרו, ולשמור על שירות ללא הפרעות. שיטות מומלצות לאמינות כוללות יתירות, תכנון עמיד בכשלים, מעקב ותהליכי שחזור אוטומטיים.
כחלק מהאמינות, עמידות היא היכולת של המערכת לעמוד בכשלים או בשיבושים בלתי צפויים ולהתאושש מהם, תוך שמירה על הביצועים. תכונות שלGoogle Cloud , כמו פריסות בכמה אזורים, גיבויים אוטומטיים ופתרונות להתאוששות מאסון, יכולות לעזור לכם לשפר את עמידות המערכת.
אמינות היא חלק חשוב באסטרטגיית הענן שלכם, מכמה סיבות:
- זמן השבתה מינימלי: זמן השבתה עלול לגרום לאובדן הכנסות, לירידה בפריון ולפגיעה במוניטין. ארכיטקטורות עמידות יכולות לעזור להבטיח שהמערכות ימשיכו לפעול בזמן תקלות, או להתאושש מהן ביעילות.
- חוויית משתמש משופרת: המשתמשים מצפים לאינטראקציות חלקות עם הטכנולוגיה. מערכות עמידות יכולות לעזור לשמור על ביצועים וזמינות עקביים, והן מספקות שירות אמין גם בזמן ביקוש גבוה או בעיות בלתי צפויות.
- תקינות הנתונים: כשלים עלולים לגרום לאובדן נתונים או לפגיעה בנתונים. במערכות עמידות מיושמים מנגנונים כמו גיבויים, יתירות ושכפול כדי להגן על הנתונים ולוודא שהם נשארים מדויקים ונגישים.
- המשכיות עסקית: העסק שלכם מסתמך על טכנולוגיה לפעולות קריטיות. ארכיטקטורות גמישות יכולות לעזור להבטיח המשכיות אחרי כשל קטסטרופלי, מה שמאפשר לפונקציות העסקיות להמשיך בלי הפרעות משמעותיות ותומך בהתאוששות מהירה.
- תאימות: בתחומים רבים יש דרישות רגולטוריות לגבי זמינות המערכת והגנה על נתונים. ארכיטקטורות גמישות יכולות לעזור לכם לעמוד בתקנים האלה, כי הן מבטיחות שהמערכות יישארו פעילות ומאובטחות.
- עלויות נמוכות יותר לטווח הארוך: ארכיטקטורות עמידות דורשות השקעה מראש, אבל העמידות יכולה לעזור להפחית את העלויות לאורך זמן על ידי מניעת זמני השבתה יקרים, הימנעות מתיקונים תגובתיים ושימוש יעיל יותר במשאבים.
הלך הרוח הארגוני
כדי שהמערכות שלכם יהיו אמינות, אתם צריכים תוכנית ואסטרטגיה מבוססת. האסטרטגיה הזו צריכה לכלול הדרכה וסמכות לתעדף את האמינות לצד יוזמות אחרות.
חשוב להבהיר שכל הארגון אחראי על האמינות, כולל צוותי הפיתוח, ניהול המוצר, התפעול, הנדסת הפלטפורמה והנדסת האמינות של האתר (SRE). אפילו קבוצות שמתמקדות בעסקים, כמו שיווק ומכירות, יכולות להשפיע על האמינות.
כל צוות צריך להבין את יעדי האמינות והסיכונים של האפליקציות שלו. הצוותים צריכים להיות אחראים לעמידה בדרישות האלה. אם יש התנגשות בין האמינות לבין פיתוח תכונות רגילות של המוצר, צריך לתעדף ולהעביר את הבעיה לטיפול בהתאם.
לתכנן ולנהל את האמינות באופן הוליסטי, בכל הפונקציות והצוותים. כדאי להקים Cloud Centre of Excellence (CCoE) שכולל עמוד תווך של אמינות. למידע נוסף, קראו את המאמר ייעול השימוש בענן בארגון באמצעות מרכז המצוינות בענן.
תחומי ההתמקדות באמינות
אפשר לסווג את הפעילויות שאתם מבצעים כדי לתכנן, לפרוס ולנהל מערכת אמינה לתחומי המיקוד הבאים. כל אחד מהעקרונות וההמלצות בנושא אמינות בעמוד הזה רלוונטי לאחד מתחומי המיקוד האלה.
- הגדרת היקף: כדי להבין את המערכת, צריך לבצע ניתוח מפורט של הארכיטקטורה שלה. אתם צריכים להבין את הרכיבים, איך הם פועלים ומתקשרים, איך הנתונים והפעולות זורמים במערכת ומה יכול להשתבש. לזהות כשלים, צווארי בקבוק וסיכונים פוטנציאליים, כדי שתוכלו לפעול לצמצום הבעיות האלה.
- תצפית: כדי למנוע כשלים במערכת, כדאי להטמיע תצפית ומעקב מקיפים ורציפים. כך תוכלו להבין מגמות ולזהות בעיות פוטנציאליות באופן יזום.
- תגובה: כדי לצמצם את ההשפעה של כשלים, צריך להגיב בצורה מתאימה ולהתאושש ביעילות. תגובות אוטומטיות יכולות גם לעזור לצמצם את ההשפעה של כשלים. גם אם מתכננים ומפעילים אמצעי בקרה, עדיין יכולות להיות תקלות.
- למידה: כדי למנוע הישנות של כשלים, לומדים מכל חוויה ונוקטים פעולות מתאימות.
הערכת עומסי עבודה באמצעות סקיל אג'נטי
כדי לאפשר לסוכני AI להעריך את עומסי העבודה בענן בהתאם לעקרונות ולהמלצות שבעמוד התווך הזה, אתם יכולים להשתמש במיומנות google-cloud-waf-reliability שזמינה במאגר Google Agent Skills ב-GitHub.
כדי להתקין את המיומנות, מריצים את הפקודה הבאה בטרמינל או בלקוח של הנציג:
npx skills add google/skills --skill google-cloud-waf-reliability
כשמוצגת בקשה, מציינים את סוכני ה-AI שרוצים להתקין בשבילם את המיומנות ומגדירים את היקף ההתקנה (פרויקט או גלובלי).
אם כבר התקנתם את המיומנות, אתם יכולים לעדכן אותה לגרסה העדכנית ביותר על ידי הפעלת הפקודה הבאה:
npx skills update
עקרונות הליבה
ההמלצות בעמוד התווך של האמינות ב-Well-Architected Framework ממופות לעקרונות הליבה הבאים:
- הגדרת אמינות על סמך יעדים של חוויית המשתמש
- הגדרת יעדים ריאליים לאמינות
- פיתוח מערכות עם זמינות גבוהה באמצעות יתירות של משאבים
- ניצול היתרונות של מדרגיות אופקית
- זיהוי כשלים פוטנציאליים באמצעות ניטור
- תכנון להפחתה חיננית (graceful degradation)
- בדיקת התאוששות מתקלות
- בדיקת התאוששות מאובדן נתונים
- ביצוע ניתוחים מקיפים לאחר אירועים
שותפים ביצירת התוכן
מחברים:
- Laura Hyatt | Customer Engineer, FSI
- חוסה אנדרדה | מהנדס לקוחות, מומחה SRE
- ג'ינו פליצ'ה | אדריכל ראשי
תורמים אחרים:
- אנדרס-לאונרדו מרטינז-אורטיז | מנהל תוכנית טכנית
- Brian Kudzia | מהנדס לקוחות בתחום תשתיות ארגוניות
- דניאל ליס | ארכיטקט אבטחה בענן
- Filipe Gracio, PhD | Customer Engineer, AI/ML Specialist
- גארי הרמסון | אדריכל ראשי
- קומאר דהנגופאל | מפתח פתרונות חוצי-מוצרים
- Marwan Al Shawi | Partner Customer Engineer
- ניקולס פינטו | מהנדס לקוחות, מומחה למודרניזציה של אפליקציות
- Radhika Kanakam | מובילת תוכנית, Google Cloud Well-Architected Framework
- ריאן קוקס | אדריכל ראשי
- סמנתה הי | כותבת טכנית
- Wade Holmes | Global Solutions Director
- זאק סיילס | מומחה רשתות
הגדרת אמינות על סמך יעדים של חוויית המשתמש
העיקרון הזה, שמופיע בעמוד התווך של האמינות ב-Google Cloud Well-Architected Framework, עוזר לכם להעריך את חוויית המשתמשים ולמפות את הממצאים ליעדים ולמדדים של אמינות.
העיקרון הזה רלוונטי לתחום ההתמקדות היקף של אמינות.
סקירה כללית של העקרונות
כלי תצפית מספקים כמויות גדולות של נתונים, אבל לא כל הנתונים קשורים ישירות להשפעות על המשתמשים. לדוגמה, יכול להיות שתבחינו בשימוש גבוה במעבד (CPU), בפעולות איטיות בשרת או אפילו במשימות שקרסו. עם זאת, אם הבעיות האלה לא משפיעות על חוויית המשתמש, הן לא נחשבות להפסקה.
כדי למדוד את חוויית המשתמש, צריך להבחין בין התנהגות המערכת הפנימית לבין בעיות שגלויות למשתמשים. התמקדו במדדים כמו שיעור ההצלחה של בקשות המשתמשים. אל תסתמכו רק על מדדים שמתמקדים בשרת, כמו שימוש במעבד (CPU), כי הם עלולים להוביל למסקנות מטעות לגבי האמינות של השירות. אמינות אמיתית פירושה שהמשתמשים יכולים להשתמש באפליקציה או בשירות באופן עקבי ויעיל.
המלצות
כדי למדוד את חוויית המשתמש בצורה יעילה, כדאי לפעול לפי ההמלצות שמפורטות בקטעים הבאים.
מדידה של חוויית המשתמש
כדי להבין באמת את האמינות של השירות, תנו עדיפות למדדים שמשקפים את חוויית המשתמשים בפועל. לדוגמה, למדוד את שיעור ההצלחה של שאילתות המשתמשים, את זמן האחזור של האפליקציה ואת שיעורי השגיאות.
מומלץ לאסוף את הנתונים האלה ישירות מהמכשיר או מהדפדפן של המשתמש. אם איסוף הנתונים הישיר הזה לא אפשרי, צריך להעביר את נקודת המדידה בהדרגה רחוק יותר מהמשתמש במערכת. לדוגמה, אפשר להשתמש במאזן העומסים או בשירות החזיתי כנקודת המדידה. הגישה הזו עוזרת לזהות בעיות ולטפל בהן לפני שהן משפיעות באופן משמעותי על המשתמשים.
ניתוח התהליכים שעוברים המשתמשים
כדי להבין איך המשתמשים משתמשים במערכת, אתם יכולים להשתמש בכלי מעקב כמו Cloud Trace. מעקב אחרי המסלול של המשתמש באפליקציה מאפשר לכם למצוא צווארי בקבוק ובעיות של זמן אחזור שעלולות לפגוע בחוויית המשתמש. Cloud Trace מתעד נתוני ביצועים מפורטים לכל דילוג בארכיטקטורת השירות. הנתונים האלה עוזרים לכם לזהות בעיות בביצועים ולטפל בהן בצורה יעילה יותר, וכך לשפר את חוויית המשתמש.
הגדרת יעדים ריאליים לאמינות
העיקרון הזה, שמופיע בעמוד התווך של האמינות ב-Google Cloud Well-Architected Framework, עוזר לכם להגדיר יעדי אמינות שאפשר להשיג מבחינה טכנית בעומסי העבודה ב- Google Cloud.
העיקרון הזה רלוונטי לתחום ההתמקדות היקף של אמינות.
סקירה כללית של העקרונות
תכננו את המערכות כך שיהיו אמינות מספיק כדי שהמשתמשים יהיו מרוצים. זה אולי נשמע מוזר, אבל יעד של 100% אמינות הוא בדרך כלל לא האסטרטגיה הכי יעילה. אמינות גבוהה יותר עלולה לגרום לעלות גבוהה משמעותית, גם מבחינת ההשקעה הכספית וגם מבחינת מגבלות פוטנציאליות על החדשנות. אם המשתמשים כבר מרוצים מרמת השירות הנוכחית, מאמצים להגביר את שביעות הרצון שלהם עשויים להניב החזר נמוך על ההשקעה. במקום זאת, אתם יכולים להשקיע את המשאבים במקומות אחרים.
אתם צריכים לקבוע את רמת האמינות שבה המשתמשים שלכם מרוצים, ולקבוע את הנקודה שבה העלות של שיפורים מצטברים מתחילה לעלות על היתרונות. כשקובעים את הרמה הזו של אמינות מספקת, אפשר להקצות משאבים באופן אסטרטגי ולהתמקד בתכונות ובשיפורים שמספקים ערך רב יותר למשתמשים.
המלצות
כדי להגדיר יעדי אמינות ריאליים, כדאי להביא בחשבון את ההמלצות בסעיפי המשנה הבאים.
קבלת כשלים מסוימים ותעדוף רכיבים
כדאי לשאוף לזמינות גבוהה, כמו זמן פעולה תקינה של 99.99%, אבל לא להגדיר יעד של 100%. חשוב להבין שחלק מהכישלונות הם בלתי נמנעים.
הפער בין 100% זמן פעולה תקינה לבין יעד של 99.99% הוא המרווח המותר לכשלים. הפער הזה נקרא בדרך כלל תקציב שגיאות. תקציב השגיאות יכול לעזור לכם לקחת סיכונים ולחדש, וזה חיוני לכל עסק שרוצה להישאר תחרותי.
תנו עדיפות לאמינות של הרכיבים הכי קריטיים במערכת. הבינו שרכיבים פחות קריטיים יכולים להיות פחות עמידים לתקלות.
איזון בין אמינות ועלות
כדי לקבוע את רמת האמינות האופטימלית למערכת, צריך לבצע ניתוח עלות-תועלת יסודי.
כדאי להביא בחשבון גורמים כמו דרישות המערכת, ההשלכות של כשלים ורמת הסיכון שהארגון מוכן לקחת על עצמו באפליקציה הספציפית. חשוב לזכור להביא בחשבון את המדדים של תוכנית התאוששות מאסון (DR), כמו היעד לזמן התאוששות (RTO) והיעד לנקודת התאוששות (RPO). מחליטים איזו רמת אמינות מקובלת במסגרת התקציב ואילוצים אחרים.
חפשו דרכים לשפר את היעילות ולהפחית את העלויות בלי להתפשר על תכונות חיוניות של אמינות.
פיתוח מערכות עם זמינות גבוהה באמצעות יתירות של משאבים
העיקרון הזה בעמוד התווך של האמינות ב-Google Cloud Well-Architected Framework מספק המלצות לתכנון, לבנייה ולניהול של יתירות משאבים, שיכולה לעזור לכם להימנע מכשלים.
העיקרון הזה רלוונטי לתחום ההתמקדות היקף של אמינות.
סקירה כללית של העקרונות
אחרי שתחליטו מהי רמת האמינות שאתם צריכים, תצטרכו לתכנן את המערכות כך שלא יהיו בהן נקודות כשל בודדות. כל רכיב קריטי במערכת צריך להיות משוכפל בכמה מכונות, אזורים ואזורים גיאוגרפיים. לדוגמה, מסד נתונים קריטי לא יכול להיות ממוקם באזור אחד בלבד, ואי אפשר לפרוס שרת מטא-נתונים באזור אחד בלבד. בדוגמאות האלה, אם יש הפסקה זמנית בשירות באזור היחיד, יש הפסקה זמנית בשירות בכל המערכת.
המלצות
כדי לבנות מערכות מיותרות, כדאי להביא בחשבון את ההמלצות בסעיפי המשנה הבאים.
זיהוי דומיינים של כשל ושכפול שירותים
ממפים את דומייני הכשל של המערכת, ממכונות וירטואליות נפרדות ועד לאזורים, ומתכננים יתירות בדומייני הכשל.
כדי להבטיח זמינות גבוהה, כדאי להפיץ ולשכפל את השירותים והאפליקציות בכמה אזורים ותחומים. כדי לוודא שהשירותים והאפליקציות ימשיכו להיות זמינים במקרה של הפסקות חשמל באזור או במחוז, הגדירו את המערכת ליתירות כשל אוטומטית.
במאמר תכנון תשתית אמינה לעומסי העבודה ב- Google Cloud תוכלו למצוא דוגמאות לארכיטקטורות בכמה אזורים ובכמה תחומים.
זיהוי בעיות וטיפול בהן במהירות
כדאי לעקוב באופן קבוע אחרי הסטטוס של דומייני הכשל כדי לזהות בעיות ולטפל בהן במהירות.
בלוח הבקרה של Google Cloud Service Health אפשר לעקוב אחרי הסטטוס הנוכחי של שירותי Google Cloud בכל האזורים. אתם יכולים גם להשתמש ב-Service Health בהתאמה אישית כדי לראות אירועים שרלוונטיים לפרויקט שלכם. אתם יכולים להשתמש במאזני עומסים כדי לזהות את תקינות המשאבים ולהפנות את התנועה באופן אוטומטי לקצוות עורפיים תקינים. מידע נוסף זמין במאמר סקירה כללית על בדיקות תקינות.
תרחישים לבדיקת יתירות כשל
כמו בתרגיל כיבוי אש, כדאי לדמות כשלים באופן קבוע כדי לוודא שהאסטרטגיות של הרפליקציה ויתירות הכשל יעילות.
למידע נוסף, קראו את המאמרים הדמיה של הפסקת חשמל באזור מסוים ב-MIG אזורי והדמיה של כשל באזור מסוים באשכולות אזוריים של GKE.
ניצול היתרונות של מדרגיות אופקית
העיקרון הזה בעמוד התווך של האמינות ב-Google Cloud Well-Architected Framework מספק המלצות שיעזרו לכם להשתמש במדרגיות אופקית. באמצעות יכולת התאמה אופקית, תוכלו לוודא שעומסי העבודה ב-Google Cloud יכולים להשתנות ביעילות ולשמור על הביצועים.
העיקרון הזה רלוונטי לתחום ההתמקדות היקף של אמינות.
סקירה כללית של העקרונות
תכנון מחדש של המערכת לארכיטקטורה אופקית. כדי להתאים את עצמכם לגידול בתנועה או בנתונים, אתם יכולים להוסיף עוד משאבים. אפשר גם להסיר משאבים כשלא משתמשים בהם.
כדי להבין את הערך של התאמה אופקית לעומס, כדאי להביא בחשבון את המגבלות של התאמה אנכית לעומס.
תרחיש נפוץ של התאמה אנכית הוא שימוש במסד נתונים של MySQL כמסד הנתונים הראשי עם נתונים קריטיים. ככל שהשימוש במסד הנתונים גדל, נדרשים יותר זיכרון RAM ו-CPU. בסופו של דבר, מסד הנתונים מגיע למגבלת הזיכרון במחשב המארח וצריך לשדרג אותו. יכול להיות שתצטרכו לחזור על התהליך הזה כמה פעמים. הבעיה היא שיש מגבלות קשיחות על הגודל המקסימלי של מסד נתונים. הגודל של המכונות הווירטואליות מוגבל. מסד הנתונים יכול להגיע למצב שבו אי אפשר להוסיף עוד משאבים.
גם אם המשאבים היו בלתי מוגבלים, מכונה וירטואלית גדולה יכולה להפוך לנקודת כשל בודדת. כל בעיה במכונה הווירטואלית של מסד הנתונים הראשי יכולה לגרום לתגובות שגיאה או להפסקה זמנית של השירות בכל המערכת, שמשפיעה על כל המשתמשים. הימנעו מנקודות כשל בודדות, כפי שמתואר במאמר בניית מערכות בזמינות גבוהה באמצעות יתירות משאבים.
בנוסף למגבלות האלה, התאמה אנכית של קנה המידה בדרך כלל יקרה יותר. העלות יכולה לגדול באופן משמעותי ככל שרוכשים מכונות עם יותר כוח מחשוב וזיכרון.
לעומת זאת, התאמה אופקית יכולה לעלות פחות. הפוטנציאל להרחבה אופקית הוא כמעט בלתי מוגבל במערכת שמיועדת להרחבה.
המלצות
כדי לעבור מארכיטקטורה של מכונה וירטואלית אחת לארכיטקטורה אופקית של כמה מכונות, צריך לתכנן בקפידה ולהשתמש בכלים הנכונים. כדי לעזור לכם להשיג התאמה אופקית לעומס, כדאי לשקול את ההמלצות בסעיפי המשנה הבאים.
שימוש בשירותים מנוהלים
שירותים מנוהלים מייתרים את הצורך לנהל באופן ידני את ההתאמה לעומס (scaling) האופקית. לדוגמה, באמצעות קבוצות של מופעי מכונה מנוהלים (MIG) ב-Compute Engine, אתם יכולים להוסיף או להסיר מכונות וירטואליות כדי לשנות את קנה המידה של האפליקציה באופן אופקי. לאפליקציות בקונטיינרים, Cloud Run היא פלטפורמה ללא שרת (serverless) שיכולה לשנות באופן אוטומטי את קנה המידה של הקונטיינרים ללא שמירת מצב (stateless) בהתאם לתנועה הנכנסת.
לקדם עיצוב מודולרי
רכיבים מודולריים וממשקים ברורים עוזרים לשנות את קנה המידה של רכיבים בודדים לפי הצורך, במקום לשנות את קנה המידה של האפליקציה כולה. מידע נוסף זמין במאמר קידום עיצוב מודולרי בעמוד התווך של אופטימיזציית הביצועים.
הטמעת עיצוב ללא שמירת מצב (stateless)
תכננו אפליקציות ללא שמירת מצב (stateless), כלומר ללא נתונים שמאוחסנים באופן מקומי. כך אפשר להוסיף או להסיר מכונות בלי לדאוג לעקביות הנתונים.
זיהוי כשלים פוטנציאליים באמצעות יכולת תצפית
העיקרון הזה, שמופיע בעמוד התווך של האמינות ב-Google Cloud Well-Architected Framework, מספק המלצות שיעזרו לכם לזהות באופן יזום אזורים שבהם עלולות להתרחש שגיאות וכשלים.
העיקרון הזה רלוונטי לתצפית, תחום המיקוד של אמינות.
סקירה כללית של העקרונות
כדי לשמור על האמינות של עומסי העבודה ב-Google Cloudולשפר אותה, צריך להטמיע יכולת תצפית אפקטיבית באמצעות מדדים, יומנים ויומני מעקב.
- מדדים הם מדידות מספריות של פעילויות שאתם רוצים לעקוב אחריהן באפליקציה במרווחי זמן ספציפיים. לדוגמה, יכול להיות שתרצו לעקוב אחרי מדדים טכניים כמו קצב הבקשות ושיעור השגיאות, שיכולים לשמש כמדדי רמת שירות (SLI). יכול להיות שתצטרכו גם לעקוב אחרי מדדים עסקיים ספציפיים לאפליקציה, כמו הזמנות שבוצעו ותשלומים שהתקבלו.
- יומנים הם רשומות עם חותמות זמן של אירועים נפרדים שמתרחשים באפליקציה או במערכת. האירוע יכול להיות כשל, שגיאה או שינוי במצב. היומנים יכולים לכלול מדדים, ואפשר גם להשתמש ביומנים בשביל SLI.
- מעקב מייצג את התהליך שעובר משתמש יחיד או את התהליך של טרנזקציה אחת, דרך מספר אפליקציות נפרדות או רכיבים של אפליקציה. לדוגמה, הרכיבים האלה יכולים להיות מיקרו-שירותים (microservices). בעזרת המעקבים אפשר לראות באילו רכיבים נעשה שימוש בתהליכים, איפה יש צווארי בקבוק וכמה זמן התהליכים נמשכו.
מדדים, יומנים ומעקבים עוזרים לכם לעקוב אחרי המערכת באופן רציף. מעקב מקיף עוזר לכם לגלות איפה ולמה אירעו שגיאות. אתם יכולים גם לזהות כשלים פוטנציאליים לפני שמתרחשות שגיאות.
המלצות
כדי לזהות כשלים פוטנציאליים ביעילות, כדאי לפעול לפי ההמלצות בסעיפי המשנה הבאים.
תובנות מקיפות
כדי לעקוב אחרי מדדים חשובים כמו זמני תגובה ושיעורי שגיאות, השתמשו ב-Cloud Monitoring וב-Cloud Logging. הכלים האלה גם עוזרים לוודא שהמדדים עונים באופן עקבי על הצרכים של עומס העבודה.
כדי לקבל החלטות שמבוססות על נתונים, נתחו את מדדי ברירת המחדל של השירות כדי להבין את התלות בין הרכיבים ואת ההשפעה שלהם על הביצועים הכוללים של עומס העבודה.
כדי להתאים אישית את אסטרטגיית המעקב, אתם יכולים ליצור ולפרסם מדדים משלכם באמצעות Google Cloud SDK.
פתרון בעיות יזום
מטמיעים טיפול חזק בשגיאות ומפעילים רישום ביומן בכל הרכיבים של עומסי העבודה ב- Google Cloud. מפעילים יומנים כמו יומני הגישה של Cloud Storage ויומני הזרימה של VPC.
כשמגדירים רישום ביומן, חשוב להביא בחשבון את העלויות הנלוות. כדי לשלוט בעלויות הרישום ביומן, אתם יכולים להגדיר מסנני החרגה ב-sink של היומנים, כדי להחריג יומנים מסוימים מהאחסון.
אופטימיזציה של ניצול המשאבים
עוקבים אחרי צריכת המעבד (CPU), מדדי קלט/פלט ברשת ומדדי קלט/פלט בדיסק כדי לזהות משאבים עם הקצאת יתר ומשאבים עם הקצאת חסר בשירותים כמו GKE, Compute Engine ו-Managed Service for Apache Spark. בסקירה הכללית על Cloud Monitoring מופיעה רשימה מלאה של השירותים הנתמכים.
תעדוף התראות
כדאי שההתראות יהיו ממוקדות למדדים קריטיים, מוגדרות לפי ערכי סף מתאימים כדי למזער את התשישות מהתראות ולוודא שבעיות משמעותיות יקבלו מענה בזמן מתאים. הגישה הממוקדת מאפשרת לשמור על האמינות של עומסי העבודה באופן יזום. מידע נוסף מופיע בסקירה הכללית על התראות.
תכנון להפחתה חיננית (graceful degradation)
העיקרון הזה, שמופיע בעמוד התווך של האמינות ב-Google Cloud Well-Architected Framework, מספק המלצות שיעזרו לכם לתכנן את עומסי העבודה ב- Google Cloud כך שייכשלו בצורה חלקה.
העיקרון הזה רלוונטי לתחום המיקוד תגובה של אמינות.
סקירה כללית של העקרונות
הפחתה חיננית (graceful degradation) היא גישת תכנון שבה מערכת שחווה עומס גבוה ממשיכה לפעול, אולי עם ביצועים או דיוק מופחתים. הפחתה חיננית מבטיחה שהמערכת תמשיך להיות זמינה ומונעת כשל מוחלט, גם אם המערכת לא פועלת בצורה אופטימלית. כשהעומס חוזר לרמה שאפשר לנהל, המערכת חוזרת לפעול באופן מלא.
לדוגמה, בתקופות של עומס גבוה, חיפוש Google נותן עדיפות לתוצאות מדפי אינטרנט בדירוג גבוה יותר, וייתכן שזה יפגע במידת הדיוק. כשהעומס יורד, חיפוש Google מחשב מחדש את תוצאות החיפוש.
המלצות
כדי לתכנן את המערכות שלכם להפחתה חיננית, כדאי להביא בחשבון את ההמלצות בסעיפי המשנה הבאים.
הטמעת ויסות נתונים (throttle)
חשוב לוודא שהרפליקות יכולות לטפל בעומסי יתר באופן עצמאי, ושהן יכולות לווסת את הבקשות הנכנסות בתרחישים של תנועה גבוהה. הגישה הזו עוזרת למנוע כשלים מדורגים שנגרמים כתוצאה ממעבר של תנועה עודפת בין אזורים.
כדי לשלוט בקצב של בקשות ה-API בזמנים של תנועה גבוהה, אפשר להשתמש בכלים כמו Apigee. אתם יכולים להגדיר כללי מדיניות שישקפו את האופן שבו אתם רוצים לצמצם את הבקשות.
ביטול מוקדם של בקשות עודפות
כדי להגן על רכיבי הקצה העורפי, כדאי להגדיר את המערכות כך שיבטלו בקשות עודפות בשכבת הקצה הקדמי. ביטול של חלק מהבקשות מונע כשלים גלובליים ומאפשר למערכת להתאושש בצורה חלקה יותר.בגישה הזו, יכול להיות שחלק מהמשתמשים ייתקלו בשגיאות. עם זאת, אתם יכולים למזער את ההשפעה של הפסקות, בניגוד לגישה כמו מפסק זרם, שבה כל התנועה נמחקת בזמן עומס יתר.
טיפול בשגיאות חלקיות ובניסיונות חוזרים
כדאי לבנות את האפליקציות כך שיטפלו בשגיאות חלקיות ובניסיונות חוזרים בצורה חלקה. העיצוב הזה עוזר להבטיח שבתרחישים של עומס גבוה, המערכת תטפל בכמה שיותר תנועה.
בדיקת תרחישים של עומס יתר
כדי לוודא שמנגנוני הוויסות וההשמטה של בקשות פועלים ביעילות, כדאי לדמות באופן קבוע תנאי עומס יתר במערכת. הבדיקות עוזרות לוודא שהמערכת מוכנה לעליות חדות בתנועה בעולם האמיתי.
מעקב אחרי עלייה חדה בתנועה
כדי לחזות עליות חדות בתנועה ולהגיב להן לפני שהן הופכות לעומסי יתר, השתמשו בכלי ניתוח ומעקב. זיהוי מוקדם ותגובה מהירה יכולים לעזור לשמור על זמינות השירות בתקופות של ביקוש גבוה.
ביצוע בדיקות להתאוששות מכשלים
העיקרון הזה בעמוד התווך של האמינות ב-Google Cloud Well-Architected Framework מספק המלצות שיעזרו לכם לתכנן ולהריץ בדיקות לשחזור במקרה של כשלים.
העיקרון הזה רלוונטי לתחום ההתמקדות למידה של אמינות.
סקירה כללית של העקרונות
כדי לוודא שהמערכת יכולה להתאושש מכשלים, צריך להריץ מדי פעם בדיקות שכוללות יתירות כשל אזורית, החזרות של גרסאות קודמות ושחזור נתונים מגיבויים.
הבדיקות האלה עוזרות לכם לתרגל תגובות לאירועים שמהווים סיכונים משמעותיים לאמינות, כמו הפסקה של שירות באזור שלם. הבדיקה הזו גם עוזרת לוודא שהמערכת פועלת כמצופה בזמן שיבוש.
במקרה הנדיר שבו אזור שלם מושבת, צריך להעביר את כל התנועה לאזור אחר. במהלך הפעולה הרגילה של עומס העבודה, כשמשנים נתונים צריך לסנכרן אותם מהאזור הראשי לאזור של יתירות הכשל. אתם צריכים לוודא שהנתונים המשוכפלים תמיד עדכניים מאוד, כדי שהמשתמשים לא יחוו אובדן נתונים או ניתוק של הסשן. מערכת איזון העומסים צריכה גם להיות מסוגלת להעביר את התנועה לאזור יתירות הכשל בכל שלב, בלי הפרעות בשירות. כדי לצמצם את זמן ההשבתה אחרי הפסקה אזורית, מהנדסי התפעול צריכים גם להיות מסוגלים להעביר באופן ידני ויעיל את תנועת המשתמשים מאזור מסוים, בזמן הקצר ביותר. הפעולה הזו נקראת לפעמים ניקוז אזור, כלומר עצירת התנועה הנכנסת לאזור והעברת כל התנועה למקום אחר.
המלצות
כשמתכננים ומריצים בדיקות להתאוששות מכשל, כדאי להביא בחשבון את ההמלצות בסעיפי המשנה הבאים.
הגדרת היעדים וההיקף של הבדיקה
הגדירו בבירור מה אתם רוצים להשיג מהבדיקה. לדוגמה, היעדים יכולים לכלול:
- מאמתים את היעד לזמן התאוששות (RTO) ואת היעד להתאוששות מאסון (RPO). לפרטים נוספים, קראו את היסודות של תכנון התאוששות מאסון.
- הערכת העמידות של המערכת והעמידות שלה בכשלים בתרחישי כשל שונים.
- בודקים את היעילות של מנגנוני יתירות כשל אוטומטיים.
מחליטים אילו רכיבים, שירותים או אזורים נכללים בהיקף הבדיקה. ההיקף יכול לכלול שכבות ספציפיות של אפליקציות כמו ממשק קצה, ממשק לקוח ומסד נתונים, או לכלול משאבי Google Cloud ספציפיים כמו מכונות Cloud SQL או אשכולות GKE. ההיקף צריך לכלול גם את כל התלויות החיצוניות, כמו ממשקי API של צד שלישי או Cloud Interconnect.
הכנת הסביבה לבדיקה
בוחרים סביבה מתאימה, רצוי סביבת Staging או סביבת Sandbox שמשכפלת את הגדרת הייצור. אם אתם מבצעים את הבדיקה בסביבת הייצור, ודאו שיש לכם אמצעי בטיחות מוכנים, כמו מעקב אוטומטי והליכי חזרה ידנית למצב הקודם.
יוצרים תוכנית גיבוי. כדי למנוע אובדן נתונים במהלך הבדיקה, כדאי ליצור תמונות מצב או גיבויים של מסדי נתונים ושירותים קריטיים. חשוב לוודא שהצוות שלכם מוכן להתערב באופן ידני אם מנגנוני יתירות הכשל האוטומטיים נכשלים.
כדי למנוע שיבושים בבדיקה, חשוב לוודא שהגדרתם נכון את התפקידים ב-IAM, את כללי המדיניות ואת הגדרות יתירות הכשל. מוודאים שיש את ההרשאות הנדרשות לכלים ולסקריפטים של הבדיקה.
מודיעים לבעלי העניין, כולל בעלי האפליקציות, התפעול ו-DevOps, על לוח הזמנים של הבדיקה, ההיקף שלה וההשפעה הפוטנציאלית שלה. ספקו לבעלי העניין לוח זמנים משוער ואת ההתנהגויות הצפויות במהלך הבדיקה.
הדמיה של תרחישי כשל
תכנון וביצוע של כשלים באמצעות כלים כמו Chaos Monkey. אתם יכולים להשתמש בסקריפטים בהתאמה אישית כדי לדמות כשלים בשירותים קריטיים, כמו השבתה של צומת ראשי באשכול GKE בכמה אזורים או השבתה של מכונה ב-Cloud SQL. אתם יכולים גם להשתמש בסקריפטים כדי לדמות הפסקת חשמל ברשת בכל האזור, באמצעות כללי חומת אש או הגבלות API בהתאם להיקף הבדיקה. להגביר בהדרגה את תרחישי הכשל כדי לבחון את התנהגות המערכת בתנאים שונים.
להריץ בדיקות עומס לצד תרחישי כשל כדי לשחזר שימוש בעולם האמיתי במהלך הפסקות זמניות בשירות. בודקים את ההשפעות של כשלים משורשרים, למשל איך המערכות של ממשק המשתמש מתנהגות כששירותי הקצה העורפי לא זמינים.
כדי לאמת שינויים בהגדרות ולהעריך את עמידות המערכת בפני טעויות אנוש, כדאי לבדוק תרחישים שכוללים הגדרות שגויות. לדוגמה, אפשר להריץ בדיקות עם הגדרות שגויות של יתירות כשל ב-DNS או עם הרשאות IAM שגויות.
מעקב אחרי התנהגות המערכת
מעקב אחרי האופן שבו מאזני עומסים, בדיקות תקינות ומנגנונים אחרים מנתבים מחדש את תעבורת הנתונים. משתמשים בכלים של Google Cloud כמו Cloud Monitoring ו-Cloud Logging כדי לתעד מדדים ואירועים במהלך הבדיקה.
בודקים את השינויים בזמן האחזור, בשיעורי השגיאות ובתפוקה במהלך סימולציית הכשל ואחריה, ועוקבים אחרי ההשפעה הכוללת על הביצועים. מזהים פגיעה או חוסר עקביות בחוויית המשתמש.
לוודא שנוצרים יומנים ומופעלות התראות לאירועים מרכזיים, כמו הפסקות שירות או יתירות כשל. אתם יכולים להשתמש בנתונים האלה כדי לוודא שהמערכות שלכם להתראות ולתגובה לאירועים פועלות ביעילות.
אימות השחזור בהתאם ל-RTO ול-RPO
מודדים כמה זמן לוקח למערכת לחזור לפעילות רגילה אחרי תקלה, משווים את הנתונים האלה ל-RTO שהוגדר ומתעדים את הפערים.
חשוב לוודא שתקינות הנתונים והזמינות שלהם תואמות ל-RPO. כדי לבדוק את עקביות מסד הנתונים, משווים בין קובצי Snapshot או גיבויים של מסד הנתונים לפני ואחרי הכשל.
מעריכים את שחזור השירות ומוודאים שכל השירותים שוחזרו למצב תקין עם הפרעה מינימלית למשתמשים.
תיעוד וניתוח של התוצאות
תעדו כל שלב בבדיקה, תרחיש כשל והתנהגות המערכת בהתאם. כדאי לכלול חותמות זמן, יומנים ומדדים לניתוחים מפורטים.
מדגישים צווארי בקבוק, נקודות כשל בודדות או התנהגויות לא צפויות שנצפו במהלך הבדיקה. כדי לתעדף את התיקונים, כדאי לסווג את הבעיות לפי חומרה והשפעה.
הצעת שיפורים לארכיטקטורת המערכת, למנגנוני יתירות כשל או להגדרות המעקב. לעדכן את המדיניות והפלייבוקים הרלוונטיים של יתירות כשל על סמך ממצאי הבדיקה. הצגת דוח ניתוח לאחר מעשה לבעלי העניין. הדוח צריך לסכם את התוצאות, הלקחים שהופקו והשלבים הבאים. מידע נוסף זמין במאמר ביצוע ניתוחים מקיפים לאחר אירוע.
חזרה ושיפור
כדי לאמת את האמינות והעמידות לאורך זמן, תכננו בדיקות תקופתיות (לדוגמה, מדי רבעון).
כדאי להריץ בדיקות בתרחישים שונים, כולל שינויים בתשתית, עדכוני תוכנה ועומסי תנועה מוגברים.
כדי לשלב בדיקות אמינות במחזור החיים של הפיתוח, אתם יכולים להפוך את בדיקות יתירות הכשל לאוטומטיות באמצעות צינורות עיבוד נתונים של CI/CD.
במהלך הניתוח שלאחר המוות, השתמשו במשוב מבעלי העניין וממשתמשי הקצה כדי לשפר את תהליך הבדיקה ואת עמידות המערכת.
בדיקת התאוששות מאובדן נתונים
העיקרון הזה, שמופיע בעמוד התווך "אמינות" של Google Cloud Well-Architected Framework, מספק המלצות שיעזרו לכם לתכנן ולהריץ בדיקות לשחזור נתונים שאבדו.
העיקרון הזה רלוונטי לתחום ההתמקדות למידה של אמינות.
סקירה כללית של העקרונות
כדי לוודא שהמערכת יכולה להתאושש ממצבים שבהם נתונים אובדים או נפגמים, צריך להריץ בדיקות לתרחישים האלה. מקרים של אובדן נתונים יכולים להיגרם כתוצאה מבאג בתוכנה או מאסון טבע כלשהו. אחרי אירועים כאלה, צריך לשחזר את הנתונים מהגיבויים ולהפעיל מחדש את כל השירותים באמצעות הנתונים ששוחזרו.
מומלץ להשתמש בשלושה קריטריונים כדי להעריך את ההצלחה או הכישלון של בדיקת שחזור מהסוג הזה: תקינות הנתונים, יעד זמן ההתאוששות (RTO) ויעד נקודת ההתאוששות (RPO). לפרטים על המדדים RTO ו-RPO, קראו את המאמר היסודות של תכנון התאוששות מאסון.
המטרה של בדיקת שחזור הנתונים היא לוודא מדי פעם שהארגון יכול להמשיך לעמוד בדרישות של המשכיות עסקית. בנוסף למדידת RTO ו-RPO, בדיקת שחזור נתונים צריכה לכלול בדיקה של כל מחסנית האפליקציות וכל שירותי התשתית הקריטיים עם הנתונים ששוחזרו. כך אפשר לוודא שכל האפליקציה שנפרסה פועלת כמו שצריך בסביבת הבדיקה.
המלצות
כשמתכננים ומריצים בדיקות להתאוששות מאובדן נתונים, כדאי להביא בחשבון את ההמלצות שבסעיפי המשנה הבאים.
אימות העקביות של הגיבוי ובדיקת תהליכי השחזור
אתם צריכים לוודא שהגיבויים מכילים תמונות מצב עקביות ושימושיות של נתונים, שאפשר לשחזר כדי להחזיר את האפליקציות לפעולה באופן מיידי. כדי לאמת את תקינות הנתונים, הגדירו בדיקות עקביות אוטומטיות שיפעלו אחרי כל גיבוי.
כדי לבדוק את הגיבויים, שחזרו אותם בסביבה שאינה סביבת ייצור. כדי לוודא שאפשר לשחזר את הגיבויים ביעילות ושהנתונים המשוחזרים עומדים בדרישות של האפליקציה, כדאי לדמות באופן קבוע תרחישים של שחזור נתונים. תעדו את השלבים לשחזור הנתונים, והדריכו את הצוותים שלכם איך לבצע את השלבים בצורה יעילה בזמן תקלה.
תזמון גיבויים קבועים ותכופים
כדי לצמצם את אובדן הנתונים במהלך השחזור ולעמוד ביעדי ה-RPO, חשוב לתזמן גיבויים באופן קבוע. הגדירו תדירות גיבוי שתואמת ליעד נקודת השחזור (RPO). לדוגמה, אם ה-RPO הוא 15 דקות, צריך לתזמן את הגיבויים כך שיפעלו לפחות כל 15 דקות. כדי להפחית את הסיכון לאובדן נתונים, כדאי לבצע אופטימיזציה של מרווחי הזמן בין הגיבויים.
כדי לתזמן ולנהל גיבויים, השתמשו בכלים של Google Cloud כמו Cloud Storage, גיבויים אוטומטיים של Cloud SQL או גיבויים של Spanner. באפליקציות קריטיות, כדאי להשתמש בפתרונות גיבוי כמעט רציפים כמו שחזור מערכת מנקודה מסוימת בזמן (PITR) ב-Cloud SQL או בגיבויים מצטברים למערכי נתונים גדולים.
הגדרה ומעקב אחרי RPO
הגדירו RPO ברור בהתאם לצרכים העסקיים שלכם, ועקבו אחרי העמידה ב-RPO. אם מרווחי הגיבוי חורגים מה-RPO שהוגדר, אפשר להגדיר התראות באמצעות Cloud Monitoring.
מעקב אחרי תקינות הגיבוי
כדי לעקוב אחרי התקינות של הגיבויים ולוודא שהם מאוחסנים במיקומים מאובטחים ואמינים, אתם יכולים להשתמש בGoogle Cloud שירות Backup and DR או בכלים דומים. כדי לשפר את העמידות, חשוב לוודא שהגיבויים משוכפלים בכמה אזורים.
תכנון לתרחישים מעבר לגיבוי
כדי לשפר את זמן ההתאוששות במקרים קיצוניים, כדאי לשלב גיבויים עם אסטרטגיות של תוכנית התאוששות מאסון, כמו הגדרות של יתירות כשל פעילה-פעילה או רפליקציה בין אזורים. כדי לקבל מידע נוסף, קראו את המדריך לתכנון התאוששות מאסון.
ביצוע ניתוח מעמיק של אירועים לאחר שהתרחשו
העיקרון הזה בעמוד התווך של האמינות ב-Google Cloud Well-Architected Framework מספק המלצות שיעזרו לכם לבצע ניתוחים יעילים לאחר כשלים ואירועים.
העיקרון הזה רלוונטי לתחום ההתמקדות למידה של אמינות.
סקירה כללית של העקרונות
דוח הפקת לקחים הוא תיעוד בכתב של אירוע, ההשפעה שלו, הפעולות שננקטו כדי לצמצם או לפתור את האירוע, הגורמים הבסיסיים והפעולות הבאות למניעת הישנות האירוע. המטרה של ניתוח לאחר מעשה היא ללמוד מטעויות ולא להאשים.
התרשים הבא מציג את תהליך העבודה של ניתוח לאחר מעשה:
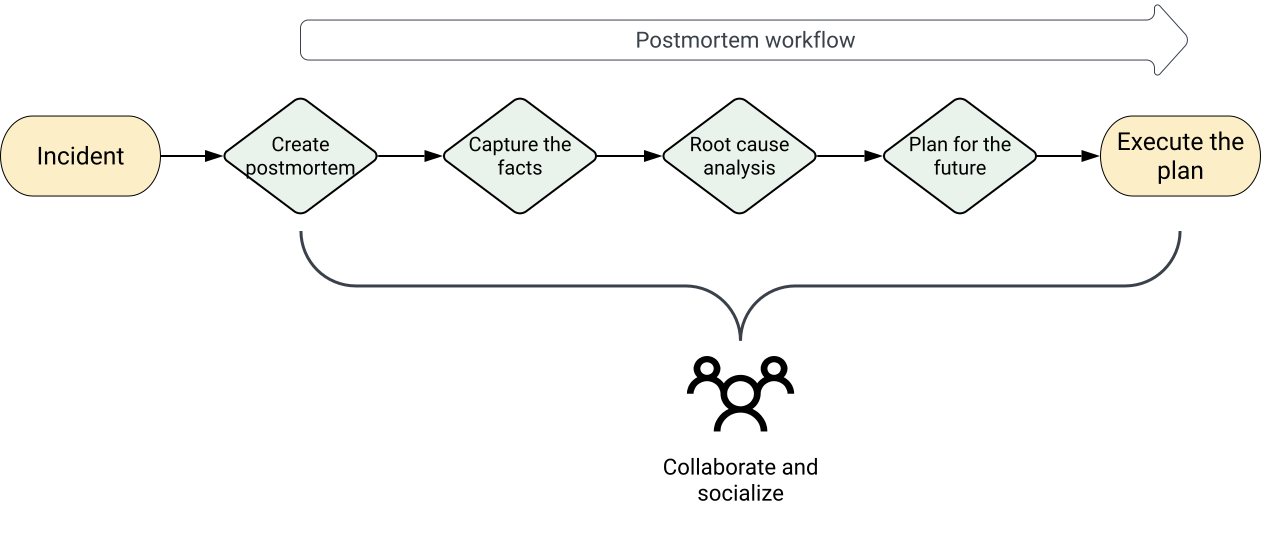
תהליך העבודה של דוח הפקת הלקחים כולל את השלבים הבאים:
- יצירת דוח הסקת מסקנות לאחר האירוע
- תיעוד העובדות
- זיהוי וניתוח של שורש הבעיה
- תכנון לעתיד
- ביצוע התוכנית
כדאי לבצע ניתוחים לאחר מעשה אחרי אירועים משמעותיים ואירועים לא משמעותיים, כמו:
- זמני השבתה או פגיעה בביצועים שגלויים למשתמשים וחורגים מסף מסוים.
- אובדן נתונים מכל סוג שהוא.
- התערבות של מהנדסים בכוננות, כמו חזרה לגרסה קודמת או ניתוב מחדש של תנועה.
- זמני פתרון שחורגים מסף מוגדר.
- כשלים במעקב, שבדרך כלל מרמזים על גילוי ידני של אירועים.
המלצות
הגדירו קריטריונים לפוסט-מורטם לפני שמתרחש אירוע, כדי שכולם ידעו מתי צריך לבצע פוסט-מורטם.
כדי לערוך ניתוחים יעילים לאחר אירוע, כדאי לפעול לפי ההמלצות בסעיפי המשנה הבאים.
ביצוע ניתוחים לאחר מעשה ללא האשמות
דוחות יעילים של הפקת לקחים מתמקדים בתהליכים, בכלים ובטכנולוגיות, ולא מאשימים אנשים או צוותים. המטרה של ניתוח לאחר מעשה היא לשפר את הטכנולוגיה ואת העתיד, ולא למצוא מי אשם. כולם טועים לפעמים. המטרה היא לנתח את הטעויות וללמוד מהן.
בדוגמאות הבאות אפשר לראות את ההבדל בין משוב שכולל האשמה לבין משוב ללא האשמה:
- משוב שמאשים מישהו: "אנחנו צריכים לשכתב את כל המערכת המסובכת של הקצה העורפי! הוא מתקלקל כל שבוע בשלושת הרבעונים האחרונים, ואני בטוח שכולנו עייפים מלתקן דברים כל פעם קצת. ברצינות, אם אקבל עוד התראה אחת, אכתוב אותו מחדש בעצמי…"
- משוב ללא האשמות: "פעולה לביצוע של שכתוב כל המערכת העורפית עשויה למנוע את המשך ההתרחשות של הדפים האלה. מדריך התחזוקה של הגרסה הזו ארוך מאוד וקשה מאוד ללמוד אותו לעומק. אין לי ספק שהמהנדסים שלנו שיעבדו בכוננות בעתיד יודו לנו על זה!"
הדוח צריך להיות קריא לכל קהלי היעד
לגבי כל פריט מידע שאתם מתכננים לכלול בדוח, בדקו אם הוא חשוב ונחוץ כדי לעזור לקהל להבין מה קרה. אפשר להעביר נתונים והסברים משלימים לנספח של הדוח. בודקים שצריכים מידע נוסף יכולים לבקש אותו.
הימנעו מפתרונות מורכבים או מתוכננים מדי
לפני שמתחילים לחפש פתרונות לבעיה, צריך להעריך את חשיבות הבעיה ואת הסבירות שהיא תחזור על עצמה. הוספת מורכבות למערכת כדי לפתור בעיות שלא סביר שיקרו שוב עלולה להגביר את חוסר היציבות.
שיתוף הדוח עם כמה שיותר אנשים
כדי לוודא שהבעיות לא יישארו ללא פתרון, פרסמו את תוצאות הניתוח שלאחר המוות לקהל רחב וקבלו תמיכה מההנהלה. הערך של ניתוח לאחר מעשה הוא פרופורציונלי ללמידה שמתרחשת אחרי הניתוח. ככל שיותר אנשים לומדים מהאירועים, כך פוחת הסיכוי שתקלות דומות יחזרו על עצמן.