


本文說明多雲端資料庫管理的部署架構、用途和最佳做法。適用對象為在多個雲端內和跨多個雲端設計及實作有狀態應用程式的架構師和工程師。
存取資料庫的多雲端應用程式架構取決於用途。沒有任何一種有狀態應用程式架構能支援所有多雲端用途。舉例來說,雲端 bursting 用途的最佳資料庫解決方案,與在多個雲端環境中同時執行的應用程式的最佳資料庫解決方案不同。
對於 Google Cloud等公有雲,有多種資料庫技術適合特定多雲端用途。如要在單一公有雲的多個區域部署應用程式,其中一個選項是使用公有雲、供應商代管的多區域資料庫,例如 Spanner。如要部署可在公有雲之間轉移的應用程式,建議使用與平台無關的資料庫,例如 AlloyDB Omni 或 PostgreSQL。
本文件將介紹有狀態資料庫應用程式的定義,並分析多雲端資料庫用途。接著,根據用途,針對多雲端部署架構提供詳細的資料庫系統分類。
這份文件也介紹了選取資料庫的決策樹狀圖,概述選取適當資料庫技術的重要決策點。最後,我們將討論多雲端資料庫管理的最佳做法。
重要詞彙和定義
本節提供術語,並定義本文件使用的通用有狀態資料庫應用程式。
術語
- 公有雲。公有雲提供多租戶基礎架構 (通常為全球性) 和服務,客戶可用來執行正式環境工作負載。 Google Cloud 是公有雲,提供多項代管服務,包括 GKE 和代管資料庫。
- 混合雲:混合雲結合了公有雲和一或多個地端部署資料中心。混合雲客戶可以將地端部署服務與公有雲提供的其他服務結合。
- 多雲端:多雲端架構結合了多個公有雲和地端部署資料中心。混合雲是多雲端架構的子集。
- 部署位置。基礎架構位置是可部署及執行工作負載 (包括應用程式和資料庫) 的實體位置。例如,在 Google Cloud中,部署位置是可用區和區域。從抽象層面來看,公有雲區域或可用區和地端部署資料中心都是部署位置。
有狀態資料庫應用程式
為定義多雲端用途,本文件採用一般有狀態資料庫應用程式架構,如下圖所示。

圖中顯示下列元件:
- 資料庫。資料庫可以是單一執行個體、多執行個體或分散式資料庫,部署在運算節點上,或以雲端代管服務的形式提供。
- 應用程式服務:這些服務會組合成一個實作商業邏輯的應用程式。應用程式服務可以是下列任一項:
- Kubernetes 中的微服務。
- 在一或多部虛擬機器上執行的粗略程序。
- 在大型虛擬機器上執行的單體式應用程式。
- Cloud Run functions 或 Cloud Run 中的無伺服器程式碼。部分應用程式服務可以存取資料庫。您可以多次部署各項應用程式服務。每次部署應用程式服務,都是該應用程式服務的執行個體。
- 應用程式用戶端。應用程式用戶端會存取應用程式服務提供的功能。應用程式用戶端可以是下列其中之一:
- 已部署的用戶端,程式碼會在機器、筆電或手機上執行。
- 未部署的用戶端,用戶端程式碼在瀏覽器中執行。應用程式用戶端執行個體一律會存取一或多個應用程式服務執行個體。
在多雲端資料庫討論中,有狀態應用程式的架構抽象化包含資料庫、應用程式服務和應用程式用戶端。在應用程式的實作中,使用的作業系統或程式設計語言等因素可能有所不同。不過,這些細節不會影響多雲端資料庫管理。
佇列和檔案做為資料儲存服務
應用程式服務可使用多種持續性資源來保存資料。這些資源包括資料庫、佇列和檔案。每項永久性資源都會提供儲存資料模型,以及專為這些模型設計的存取模式。雖然應用程式會使用佇列、訊息系統和檔案系統,但下一節將著重於資料庫。
雖然多雲端資料庫的部署位置、狀態共用、同步和非同步複製等因素的考量也適用於佇列和檔案,但這項討論不在本文範圍內。
網路
在一般有狀態應用程式的架構中 (如下圖所示),元件之間的每個箭頭都代表透過網路連線的通訊關係,例如應用程式用戶端存取應用程式服務。
連線可以位於單一可用區內,也可以跨可用區、區域或雲端。連線可以存在於任何部署位置組合之間。在多雲端環境中,跨雲端網路是重要的考量因素,您可以使用多種選項。如要進一步瞭解跨雲端網路,請參閱「分散式應用程式適用的 Cross-Cloud Network」和「連線至 Google Cloud:網路選項說明」。
本文中的應用實例假設如下:
- 雲端之間有安全的網路連線。
- 資料庫及其元件可以相互通訊。
從非功能性的角度來看,網路大小 (即處理量和延遲時間) 可能會影響資料庫延遲時間和處理量。從功能角度來看,網路通常不會造成影響。
多雲端資料庫用途
本節介紹多雲端資料庫管理最常見的幾種用途。在這些用途中,我們假設雲端和資料庫節點之間有安全的網路連線。
遷移應用程式
在多雲端資料庫管理中,應用程式遷移是指將應用程式、所有應用程式服務和資料庫,從目前的雲端遷移至目標雲端。企業可能基於多種原因決定遷移應用程式,例如避免與雲端服務供應商競爭、翻新技術,或降低總持有成本 (TCO)。
在應用程式遷移中,目的是停止目前雲端中的正式環境,並在遷移完成後繼續在目標雲端中執行正式環境。應用程式服務必須在目標雲端中執行。如要導入服務,可採用平移做法。在這個方法中,相同的程式碼會部署在目標雲端中。如要重新實作服務,可以使用目標雲端中提供的現代雲端技術。
從資料庫的角度來看,請考慮下列應用程式遷移替代方案:
- 資料庫 lift-and-shift:如果目標雲端提供相同的資料庫引擎,則可 lift-and-shift 資料庫,在目標雲端建立相同的部署作業。
- 資料庫 lift-and-move 至對等的代管服務:如果目標雲端服務供應商提供相同資料庫引擎的代管版本,則可將自行管理的資料庫遷移至該版本。
- 資料庫翻新:不同雲端提供不同的資料庫技術。由雲端服務供應商管理的資料庫可能具有優勢,例如更嚴格的服務水準協議 (SLA)、擴充性和自動災難復原。
無論採用何種部署策略,資料庫遷移都是一項耗時的程序,因為必須將資料從目前的雲端移至目標雲端。雖然可以採用會導致停機的匯出和匯入方法,但最好還是採用停機時間極短或不停機的遷移方式。這種做法可盡量縮短應用程式停機時間,對企業和客戶的影響也最小。不過,這項作業通常需要更複雜的遷移設定,因為涉及初始載入、持續複製、監控、精細驗證,以及切換時的同步處理。如要支援備用情境,您必須實作反向複製機制,以便在切換至目標資料庫後,將變更同步回來源資料庫。
災難復原
災難復原是指應用程式在區域服務中斷期間,仍能繼續為應用程式用戶端提供服務的能力。為確保災難復原,應用程式必須部署至至少兩個區域,並隨時準備執行。在正式環境中,應用程式會在主要區域執行。不過,如果發生服務中斷,次要區域會變成主要區域。以下是災難復原準備度的不同模式:
- 熱待命。應用程式會部署至兩個以上的區域 (主要和次要),且在每個區域都能完整運作。如果主要區域故障,次要區域中的應用程式可以立即接管應用程式用戶端流量。
- 冷待命。應用程式在主要區域中執行,但已準備好在次要區域中啟動 (但尚未執行)。如果主要區域故障,應用程式會在次要區域啟動。應用程式會中斷運作,直到能夠執行並向用戶端提供所有服務為止。
- 不待命。在這個模式中,應用程式程式碼已準備好部署,但尚未部署到次要區域 (因此不會使用任何已部署的資源)。如果主要區域發生服務中斷,應用程式的第一個部署作業必須位於次要區域。這項部署作業會將應用程式置於與冷待命相同的狀態,也就是必須啟動。相較於冷備援,這種做法的應用程式中斷時間較長,因為必須先部署應用程式,包括建立雲端資源。
從資料庫的角度來看,上述清單中討論的就緒模型對應於下列資料庫方法:
- 交易同步資料庫。這個資料庫對應至熱備援模型。主要區域中的每筆交易,都會在次要區域中同步協調修訂。服務中斷期間,次要區域會成為主要區域,資料庫會保持一致並立即可用。在這個模型中,復原點目標 (RPO) 和復原時間目標 (RTO) 皆為零。
- 非同步複製資料庫。這個資料庫也對應至熱待命模式。由於資料庫從主要區域複製到次要區域是非同步的,因此如果主要區域發生故障,部分交易可能會複製到次要區域。雖然次要區域中的資料庫已準備好處理正式環境負載,但可能沒有最新資料。因此,應用程式可能會遺失無法復原的交易。由於存在這項風險,這種方法的 RTO 為零,但 RPO 大於零。
- 閒置資料庫。這個資料庫對應至冷待命模式。建立的資料庫不含任何資料。當主要區域故障時,資料必須載入閒置的資料庫。如要啟用這項動作,必須在主要區域定期備份,並將備份資料轉移至次要區域。備份可以是完整或增量備份,具體取決於資料庫引擎支援的功能。無論是哪種情況,資料庫都會還原至上次備份的狀態,而且從應用程式的角度來看,與主要區域相比,可能會遺失許多交易。雖然這種做法可能符合成本效益,但由於資料庫狀態並非最新,因此自上次可用備份以來的所有交易都可能遺失,進而降低價值。
- 沒有資料庫。這個模型等同於無待命情況。次要區域未安裝資料庫,如果主要區域故障,則必須建立資料庫。資料庫建立後,與閒置資料庫的情況一樣,必須先載入資料,應用程式才能使用。
如果使用主要和次要雲端,而非主要和次要區域,則本文討論的災難復原方法也適用。主要差異在於,由於雲端之間的網路異質性,雲端之間的延遲時間可能會比雲端內區域之間的網路距離更長。其他差異可能來自不同雲端服務供應商的代管資料庫,其功能和預設設定不同。
整個雲端故障的可能性低於區域故障。不過,企業可能仍會需要在兩個雲端中部署應用程式。這種做法有助於保護企業免於故障,或協助企業符合業務或產業法規。
另一個災難復原方法是設定主要和次要區域,以及主要和次要雲端。這種做法可讓企業選擇最合適的災難復原程序,因應故障情況。視服務中斷的嚴重程度而定,您可以使用次要區域或次要雲端來執行應用程式。
雲端 bursting
「雲端 bursting」是指一種設定,可讓應用程式用戶端流量在不同部署位置之間擴充。當容量需求增加,且待命位置提供額外容量時,應用程式就會高載。主要位置支援一般流量,而待命位置則可在應用程式用戶端流量增加,超出主要位置可支援的範圍時,提供額外容量。主要和待命位置都部署了應用程式服務執行個體。
雲端 bursting 是跨雲端實作,其中一個雲端是主要雲端,第二個雲端是待命雲端。在混合雲環境中,這項技術可利用公有雲中的彈性雲端運算資源,擴充地端部署資料中心內有限的運算資源。
如需資料庫支援,可使用下列選項:
- 主要位置部署作業。在這個部署作業中,資料庫只會部署在主要位置,不會部署在待命位置。當應用程式爆量時,待命位置的應用程式會存取主要位置的資料庫。
- 主要和待命位置部署。這項部署作業支援主要和待命位置。資料庫執行個體會部署在兩個位置,並由該位置的應用程式服務執行個體存取,尤其是在高載的情況下。如「雲端內和跨雲端的災難復原」一文所述,這兩個資料庫可以透過交易同步處理,也可以非同步同步處理。非同步同步處理可能會有延遲。如果更新是在備用位置進行,則必須將這些更新傳播回主要位置。如果兩個位置都可能同時更新,就必須實作衝突解決機制。
雲端 bursting 是混合雲的常見用途,可增加地端部署資料中心的容量。如果資料必須保留在某個國家/地區,也可以在公有雲中採用這種做法。如果公有雲在某個國家/地區只有一個區域,則可高載至同一國家/地區內其他公有雲的區域。這種做法可確保資料留在國內,同時解決公有雲區域的資源限制。
使用業界頂尖的雲端服務
部分應用程式需要專門的雲端服務和產品,而這些服務和產品無法在單一雲端中取得。舉例來說,應用程式可能會在一個雲端中對業務資料執行業務邏輯處理,並在另一個雲端中對業務資料進行分析。在這個用途中,應用程式的商業邏輯處理部分和數據分析部分會部署至不同的雲端。
從資料管理角度來看,用途如下:
- 分區資料。應用程式的每個部分都有自己的資料庫 (獨立分區),且資料庫之間不會直接連結。管理資料的應用程式會將需要同時在兩個資料庫 (分區) 中提供的資料寫入兩次。
- 非同步複製資料庫。如果某個雲端的資料必須在另一個雲端中可用,則可能適合採用非同步複製關係。舉例來說,如果數據分析應用程式需要與業務應用程式相同的資料集或資料集子集,則後者可以在雲端之間複製。
- 交易同步資料庫。這類資料庫可讓您將資料提供給應用程式的兩個部分。每個應用程式的每次更新都具有交易一致性,且可立即用於兩個資料庫 (分區)。交易同步資料庫實際上會做為單一分散式資料庫。
分散式服務
分散式服務會在兩個以上的部署位置部署及執行。您可以將所有服務執行個體部署到所有部署位置。或者,您也可以根據硬體可用性或預期有限負載等因素,在所有位置部署部分服務,並在其中一個位置部署部分服務。
在交易同步資料庫中,所有位置的資料都一致。因此,這類資料庫是將服務執行個體部署到所有部署位置的最佳選擇。
使用非同步複製資料庫時,可能會在兩個部署位置同時修改同一個資料項目。如要判斷兩項不一致的變更中,哪一項是最終一致狀態,就必須實施衝突解決策略。雖然可以實施衝突解決策略,但這並非總是簡單明瞭,有時需要手動介入,才能將資料還原至一致狀態。
分散式服務重新定位和容錯移轉
如果整個雲端區域故障,系統會啟動災難復原程序。如果具狀態資料庫應用程式中的單一服務失敗 (而非區域或整個應用程式),則必須復原並重新啟動該服務。
災難復原的初步做法是在原始部署位置重新啟動失敗的服務 (就地重新啟動做法)。Kubernetes 等技術會根據設定自動重新啟動服務。
不過,如果這種就地重新啟動的方法不成功,另一種方法是在次要位置重新啟動服務。服務會從主要位置容錯移轉至次要位置。如果應用程式是以一組分散式服務的形式部署,則單一服務的容錯移轉可以動態進行。
從資料庫的角度來看,在原始部署位置重新啟動服務,不需要特定的資料庫部署。當服務移至替代部署位置,且服務存取資料庫時,則適用本文件稍早「分散式服務」一節中討論的相同就緒模型。
如果服務只是暫時遷移,且企業在遷移期間可接受較高的延遲時間,則服務可以跨部署位置存取資料庫。雖然服務已重新部署,但仍會以與原始部署位置相同的方式存取資料庫。
依情境部署
一般來說,為所有應用程式用戶端提供服務的單一應用程式部署作業,會包含所有應用程式服務和資料庫。不過,也有例外情況。單一應用程式部署作業只能為一部分用戶端提供服務 (依據特定條件),這表示需要多個應用程式部署作業。每個部署作業會為不同的用戶端子集提供服務,所有部署作業則會為所有用戶端提供服務。
以下是情境相關部署作業的應用實例:
- 部署多租戶應用程式時,一個應用程式會部署給所有小型租戶,另一個應用程式會部署給每 10 個中型租戶,而一個應用程式會部署給每個付費租戶。
- 需要區分客戶時,例如企業客戶和政府客戶。
- 需要區隔開發、測試和正式環境時。
從資料庫的角度來看,您可以在一對一部署策略中,為每個應用程式部署作業部署一個資料庫。如下圖所示,這項策略是建立分區資料的直接方法,因為每個部署作業都有自己的資料集。

上圖顯示下列內容:
- 設定包含三個應用程式部署作業。
- 每個資料集都有各自的資料庫。
- 部署作業之間不會共用任何資料。
在許多情況下,一對一部署是最合適的策略,但也有其他替代方案。
在多租戶的情況下,租戶可能會重新分配。小型租戶可能會變成中型租戶,必須重新分配到其他應用程式。在這種情況下,個別資料庫部署作業需要資料庫遷移。如果部署分散式資料庫,且所有部署作業同時使用該資料庫,則所有租戶資料都會位於單一資料庫系統中。因此,在資料庫之間移動租戶時,不需要遷移資料庫。下圖顯示這類資料庫的範例:

上圖顯示下列內容:
- 應用程式的三項部署作業。
- 所有部署項目都共用單一分散式資料庫。
- 應用程式可以存取每個部署作業中的所有資料。
- 未實作資料分區。
如果企業經常在生命週期作業中遷移租戶,資料庫複製可能是實用的替代方案。在這種方法中,租戶資料會在遷移前,在資料庫之間複製。在這種情況下,不同的應用程式部署作業會使用獨立的資料庫,且只會在租戶遷移之前和期間設定複製作業。下圖顯示在租戶遷移期間,兩個應用程式部署項目之間的暫時複製作業。

上圖顯示應用程式的三個部署項目,其中三個獨立資料庫保存與各個部署項目相關聯的資料。如要將資料從一個資料庫遷移至另一個資料庫,可以設定暫時資料庫遷移。
應用程式可攜性
應用程式可攜性可確保應用程式能部署到不同的部署位置,尤其是不同的雲端。這種可攜性可確保應用程式隨時都能遷移,不必為了準備應用程式遷移而進行遷移專屬的重新工程或額外的應用程式開發。
為確保應用程式可攜性,您可以使用下列其中一種方法,本節稍後會說明:
- 系統層級可攜性
- API 相容性
- 功能可攜性
系統式可攜性在所有可能的部署作業中,使用相同的技術元件。為確保系統層級的可攜性,每項技術都必須在所有可能的部署位置可用。舉例來說,如果 PostgreSQL 等資料庫是候選項目,則必須在預期時間範圍內,驗證其在所有潛在部署位置的可用性。所有其他技術也是如此,例如程式設計語言和基礎架構技術。如下圖所示,這種方法會根據技術,在所有部署位置建立一組通用功能。

上圖顯示可攜式應用程式部署作業,其中應用程式預期在部署的每個位置都有完全相同的資料庫系統。由於每個位置都使用相同的資料庫系統,因此應用程式可攜。應用程式可以預期整個部署作業都會使用完全相同的資料庫系統。因此,可以假設資料庫系統介面和行為完全相同。
在資料庫方面,在 API 相容性系統中,用戶端會使用特定的資料庫存取程式庫 (例如 MySQL 用戶端程式庫),確保能連線至雲端環境中可能提供的任何相容實作。下圖說明 API 相容性。

上圖顯示以資料庫系統 API 為基礎的應用程式可攜性,而非資料庫系統。雖然每個位置的資料庫系統可能不同,但 API 相同,且提供相同的功能。應用程式具有可攜性,因為它可以在每個位置假設相同的 API,即使基礎資料庫系統是不同的資料庫技術。
在功能型可攜性中,不同雲端中的不同技術可能會提供相同的功能。舉例來說,您可以限制資料庫只能使用關聯模型。由於任何關聯式資料庫系統都能支援應用程式,因此您可以在不同的雲端中使用不同版本的資料庫系統,而不會影響應用程式的可攜性。功能可攜性的缺點是,只能使用所有關聯式資料庫系統都支援的資料庫模型部分。您必須使用資料庫模型,而非與所有雲端相容的資料庫系統。下圖顯示功能型可攜性的架構範例。
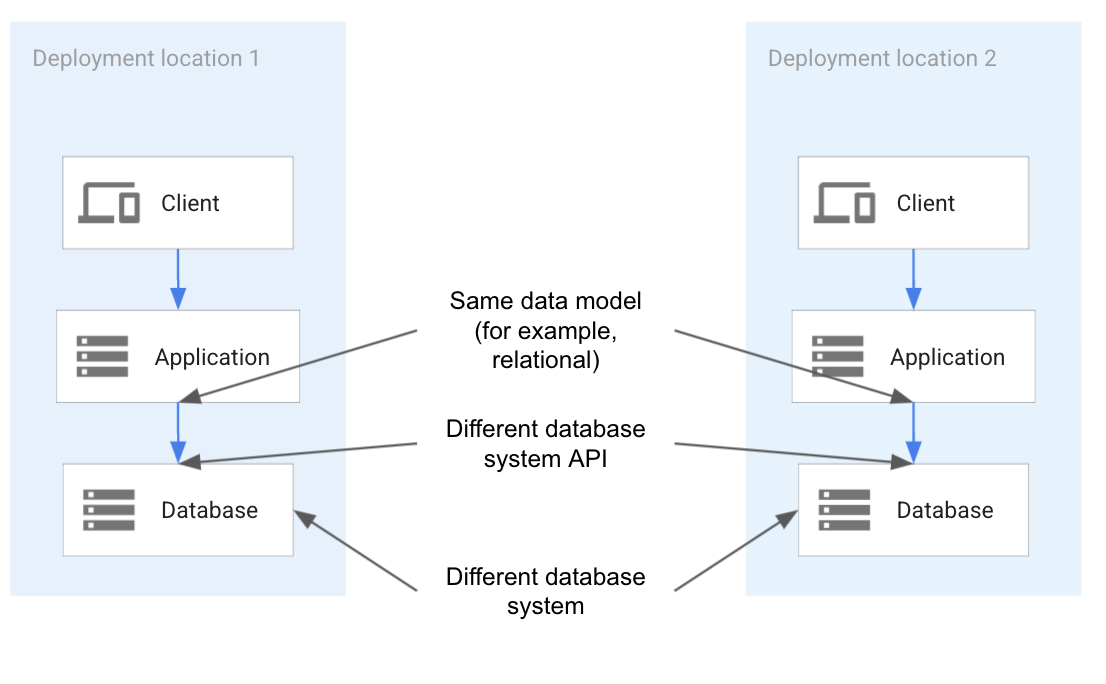
如上圖所示,每個位置的資料庫系統 API 和資料庫系統可能不同。為確保可攜性,應用程式只能使用每個資料庫系統和每個 API 中,在各個位置都可用的部分。由於每個位置通常只能使用各資料庫系統的一部分,因此應用程式必須限制其使用範圍。
為確保本節所有選項的可攜性,完整架構必須持續部署到所有目標位置。所有單元和系統測試案例都必須針對這些部署作業執行。這些是及早偵測並解決基礎架構和技術變更的必要條件。
避免依賴特定供應商
避免受制於特定供應商,有助於降低依賴特定技術和供應商的風險。這與應用程式可攜性表面上相似。避免供應商依賴的做法適用於所有使用的技術,不限於雲端服務。舉例來說,如果 MySQL 做為資料庫系統,並安裝在雲端虛擬機器上,則從雲端角度來看,沒有依附關係,但對 MySQL 有依附關係。可在雲端之間轉移的應用程式,仍可能依賴雲端以外的其他供應商提供的技術。
為避免依賴特定供應商,所有技術都必須可替換。因此,您必須對所有應用程式功能進行徹底且結構化的抽象化,以便將每個應用程式服務重新實作到不同的技術基礎,而不會影響應用程式的實作方式。從資料庫的角度來看,您可以將資料庫模型的使用與特定資料庫管理系統分開,藉此完成這項抽象化作業。
現有的正式環境資料庫管理系統
雖然許多多雲端應用程式在開發時就將資料庫系統納入設計,但許多企業開發多雲端應用程式是為了翻新應用程式。開發這些應用程式時,假設新設計和實作的應用程式會存取現有資料庫。
不將現有資料庫納入現代化作業的原因有很多。您可能正在使用其他資料庫系統不支援的特定功能。企業可能擁有具備複雜且完善管理程序的資料庫,因此改用其他系統不切實際或不符合經濟效益。或者,企業可能會選擇在第一階段翻新應用程式,並在第二階段翻新資料庫。
如果企業使用現有的資料庫系統,多雲端應用程式的設計人員必須決定是否只使用該資料庫,還是要為不同的部署位置新增其他資料庫系統。舉例來說,如果資料庫是在地端部署,且應用程式 也需要在 Google Cloud中執行,則必須考量部署在 Google Cloud 上的 應用程式服務是否會存取地端部署的資料庫 。或者,是否應在Google Cloud 和本機執行的應用程式服務中部署第二個資料庫。
如果第二個資料庫部署在 Google Cloud,則用途可能與「雲端 bursting」或「分散式服務」中討論的用途相同。無論是哪一種情況,都適用這些章節中的資料庫討論。不過,這項功能僅限於地端部署現有資料庫可支援的跨位置功能,例如同步處理和複製。
部署模式
本文討論的用途從資料庫的角度提出了一個常見問題:如果資料庫位於多個部署位置,它們之間的關係為何?
主要關係類型 (部署模式) 如下,我們會在下一節討論:
- 已分區,沒有跨資料庫依附關係
- 非同步單向複製
- 雙向複製與衝突解決
- 完全主動-主動同步分散式系統
您可以將本文件中的每個用途對應至四種部署模式中的一或多種。
在以下討論中,我們假設用戶端直接存取應用程式服務。視用途而定,您可能需要負載平衡器,以動態方式將用戶端存取權導向應用程式,如下圖所示。

在上圖中,雲端負載平衡器會將用戶端呼叫導向其中一個可用位置。負載平衡器可確保強制執行負載平衡政策,並將用戶端導向應用程式及其資料庫的正確位置。
已分區,沒有跨資料庫依附關係
這種部署模式是本文討論的所有模式中最簡單的一種:每個位置或雲端都有一個資料庫,且資料庫包含彼此不相依的分區資料集。資料項目只會儲存在一個資料庫中。每個資料分區都位於專屬資料庫中。這種模式的例子是多租戶應用程式,其中資料集位於其中一個資料庫。下圖顯示兩個完全分區的應用程式。

如上圖所示,應用程式部署在兩個位置,每個位置負責整個資料集的一個分區。每個資料項目只會位於其中一個位置,確保資料集已分區,且兩者之間沒有任何複製。
分區資料庫的另一種部署模式是將資料集完全分區,但仍儲存在同一個資料庫中。只有一個資料庫包含所有資料集。雖然資料集儲存在同一個資料庫中,但資料集完全獨立 (分區),變更其中一個資料集不會導致另一個資料集發生變更。下圖顯示兩個應用程式共用一個資料庫。

上圖顯示下列內容:
- 兩個應用程式部署作業共用一個資料庫,該資料庫位於第一個位置。
- 由於資料集未分區,因此每個應用程式都可以存取部署作業中的所有資料。
非同步單向複製
這種部署模式有一個主要資料庫,會複製到一或多個次要資料庫。次要資料庫可用於讀取存取權,但應用程式必須考量潛在的複製延遲。舉例來說,如果某個用途的最佳資料庫是主要資料庫,而次要資料庫用於分析,就適用這種模式。下圖顯示兩個應用程式存取單向複製的資料庫。

如上圖所示,兩個資料庫中,其中一個是另一個的副本。圖中的箭頭表示複製方向:位置 1 資料庫系統中的資料會複製到位置 2 的資料庫系統。
雙向複製與衝突解決
這種部署模式有兩個主要資料庫,會以非同步方式相互複製。如果同時將相同資料寫入每個資料庫 (例如相同的主鍵),可能會導致寫入衝突。為避免這種風險,必須有衝突解決機制,才能判斷複製期間的最終狀態。如果寫入衝突的機率很低,就可以使用這個模式。下圖顯示兩個應用程式存取雙向複製的資料庫。

如上圖所示,每個資料庫都會複製到另一個資料庫。這兩個複製作業彼此獨立,如圖中兩個獨立的藍色箭頭所示。由於這兩個複製作業彼此獨立,如果兩個應用程式碰巧變更相同的資料項目,並同時複製,就可能發生衝突。在這種情況下,必須解決衝突。
完全主動-主動同步分散式系統
這種部署模式只有一個資料庫,採用主動-主動 (也稱為主-主) 設定。在主動-主動設定中,任何主要資料庫中的資料更新都會保持交易一致性,並同步複製。這種模式的應用實例之一是分散式運算。下圖顯示兩個應用程式存取完全同步的主要資料庫。

如上圖所示,這種安排可確保每個應用程式一律存取最後一個一致狀態,不會延遲或有衝突風險。一個資料庫中的變更會立即反映在另一個資料庫中。當變更交易提交時,任何變更都會反映在兩個資料庫中。
資料庫系統分類
並非所有資料庫管理系統都同樣適用於本文討論的部署模式。視用途而定,可能只能實作一種部署模式,或僅使用一部分資料庫系統組合部署模式。
在下一節中,不同的資料庫系統會分類並對應至四種部署模式。
資料庫可依不同維度分類,例如資料模型、內部架構、部署模型和交易類型。在下一節中,為了進行多雲端資料庫管理,我們將使用兩個維度:
- 部署架構。將資料庫管理系統部署至雲端資源 (例如 Compute Engine 或雲端代管) 的架構。
- 發行模式。資料庫系統支援的分散模式 (例如單一執行個體或完全分散)。
這兩個維度與多雲端用途最相關,可支援從多雲端資料庫用途衍生的四種部署模式。常見的分類方式是根據資料庫管理系統支援的資料模型。有些系統僅支援一種模型 (例如圖形模型),其他系統則同時支援多種資料模型 (例如關聯和文件模型)。不過,在多雲端資料庫管理的情境中,這項分類並不適用,因為多雲端應用程式可以針對多雲端部署作業使用任何資料模型。
依部署架構分類的資料庫系統
多雲端資料庫管理包含下列四種主要的資料庫管理系統部署架構:
- 內建雲端資料庫。內建雲端資料庫是專為搭配雲端技術而設計、建構及最佳化。舉例來說,部分資料庫系統會使用 Kubernetes 做為實作平台,並使用 Kubernetes 功能。CockroachDB 和 YugaByte 就是這類資料庫的例子。可部署至任何支援 Kubernetes 的雲端。
- 雲端服務供應商代管的資料庫。雲端服務供應商代管的資料庫是以雲端服務供應商專屬技術建構,並由特定雲端服務供應商代管。Spanner、Bigtable、Firestore 和 AlloyDB for PostgreSQL 都是這類資料庫。雲端服務供應商代管的資料庫只能在雲端服務供應商的雲端中使用,無法在其他地方安裝及執行。不過,AlloyDB for PostgreSQL 與 PostgreSQL 完全相容。
- 雲端前資料庫。雲端前資料庫在雲端技術發展前就已存在 (有時甚至存在很久),通常在裸機硬體和虛擬機器 (VM) 上執行。PostgreSQL、MySQL 和 SQL Server 都是這類資料庫。這些系統可在任何支援所需 VM 或裸機硬體的雲端上執行。
- 雲端合作夥伴代管資料庫。部分公有雲有資料庫合作夥伴,可在公有雲中安裝及管理客戶的資料庫。因此,客戶不必自行管理這些資料庫。MongoDB Atlas、MariaDB 和 ScyllaDB 都是這類資料庫。
這些主要類別有一些變化形式。舉例來說,資料庫供應商在實作專為雲端建構的資料庫時,也可能提供專為雲端建構的技術安裝,以及在供應商提供的雲端中為客戶提供代管服務。這種做法等同於供應商提供公有雲,但僅支援其資料庫做為單一服務。
雲端前資料庫也可能位於容器中,且可部署至 Kubernetes 叢集。不過,這些資料庫不會使用 Kubernetes 專屬功能,例如擴充、多服務或多 Pod 部署。
資料庫供應商可能同時與多個公有雲服務供應商合作,在多個公有雲中提供資料庫,做為雲端合作夥伴代管資料庫。
依分布模型劃分的資料庫系統
不同的資料庫管理系統會根據資料庫架構中的分布模型實作。資料庫模型如下:
- 單一執行個體。單一資料庫執行個體會在一個 VM 或一個容器上執行,並做為集中式系統。這個系統會管理所有資料庫存取權。由於單一執行個體無法連線至任何其他執行個體,因此資料庫系統不支援複製功能。
- 多實體主動-被動。在這個常見的架構中,多個資料庫執行個體會連結在一起。最常見的連結是主動-被動關係,其中一個執行個體是主動資料庫執行個體,支援兩個執行個體以及寫入和讀取。一或多個被動系統為唯讀,並以同步或非同步方式接收主要系統的所有資料庫變更。被動系統可提供讀取權限。主動-被動也稱為主要-次要或來源-副本。
- 多實體主動-主動。在這種相對不常見的架構中,每個執行個體都是有效執行個體。在這種情況下,每個執行個體都能執行讀取和寫入交易,並提供資料一致性。因此,為避免資料不一致,所有執行個體一律會同步處理。
- 多實體雙主動模式,並具備衝突解決功能。這種系統也相對不常見。每個執行個體都可供寫入和讀取,但資料庫會以非同步模式同步。系統允許同時更新同一資料項目,這會導致狀態不一致。衝突解決政策必須決定哪個狀態是最後一個一致的狀態。
- 多實體資料分割。資料分割是以管理 (不相交) 資料分區為基礎。每個分區都由獨立的資料庫執行個體管理。這種分配方式具有擴充性,因為隨著時間推移,可以動態新增更多 shard。不過,並非所有系統都支援這項功能,因此可能無法執行跨 shard 查詢。
本節討論的所有分布模型都支援 sharding,且可做為 sharded 系統。不過,並非所有系統都提供資料分割選項。資料分割是擴充性概念,通常與多雲端環境中的架構資料庫選擇無關。
雲端和合作夥伴代管資料庫的發布模式不同。由於這些資料庫與雲端服務供應商的架構綁定,因此這些系統會根據下列部署位置實作架構:
- 分區系統。可用區代管資料庫系統會繫結至可用區。只要可用區可用,資料庫系統就可用。不過,如果可用區無法使用,就無法存取資料庫。
- 區域系統。區域代管資料庫會繫結至區域,只要至少有一個可用區可供存取,就能存取資料庫。任何可用區組合都可能無法存取。
- 跨區域系統。跨區域系統與兩個以上的區域連結,只要至少有一個區域可用,就能正常運作。
如果資料庫可以安裝在企業打算使用的所有雲端中,跨區域系統也可以支援跨雲端系統。
本節討論的代管資料庫架構還有其他替代方案。區域系統可能會在兩個可用區之間共用磁碟。如果兩個可用區中有一個無法存取,資料庫系統可以在其餘可用區中繼續運作。不過,如果服務中斷影響了這兩個可用區,即使其他可用區可能仍完全正常運作,資料庫系統也無法使用。
將資料庫系統對應至部署模式
下表說明本文討論的部署模式和部署架構之間的關係。這些欄位會根據部署模式和部署架構,說明組合可能需要的條件。
| 部署架構 | 部署模式 | ||||
|---|---|---|---|---|---|
| 已分區,沒有跨資料庫依附關係 | 非同步單向複製 | 雙向複製與衝突解決 | 完全主動-主動同步分散式系統 | ||
| 內建雲端資料庫 | 所有提供資料庫系統所用內建雲端技術的雲端,都可能採用這種模式。 如果無法使用相同的資料庫,則可使用不同的資料庫系統。 |
提供複製功能的雲端資料庫。 | 提供雙向複製功能的雲端資料庫。 | 提供主資料庫對主資料庫同步功能的雲端資料庫。 | |
| 雲端服務供應商代管的資料庫 | 不同雲端的資料庫系統可能有所差異。 | 副本不一定要是雲端服務供應商代管的資料庫 (請參閱「資料庫遷移技術在部署模式中的角色」)。 | 如果資料庫提供雙向複製功能,則只能在雲端內複製,無法跨雲端複製。 | 如果資料庫提供主對主同步功能,則只能在雲端內進行,不能跨雲端進行。 | |
| 雲端前資料庫 | 不同雲端中的資料庫系統可以相同或不同。 | 可在多個雲端之間進行複製。 | 資料庫系統提供雙向複製和衝突解決功能。 | 資料庫系統提供主要對主要同步處理功能。 | |
| 雲端合作夥伴代管資料庫 | 不同雲端中的資料庫系統可能有所差異。
如果合作夥伴在所有必要雲端中提供代管資料庫系統,則可使用相同的資料庫。 |
副本不一定要是雲端服務供應商代管的資料庫。 如果合作夥伴在所有必要雲端中提供代管資料庫系統,則可使用相同的資料庫。 |
資料庫系統提供雙向複製和衝突解決功能。 | 資料庫系統提供主資料庫與主資料庫之間的同步處理功能。 | |
如果資料庫系統未提供內建複製功能,則可改用資料庫複製技術。詳情請參閱「資料庫遷移技術在部署模式中的角色」。
下表列出部署模式與發布模式的關係。這些欄位會說明在特定部署模式和發布模式下,可能組合的條件。
| 發布模式 | 部署模式 | ||||
|---|---|---|---|---|---|
| 已分區,沒有跨資料庫依附關係 | 非同步單向複製 | 雙向複製與衝突解決 | 完全主動-主動同步分散式系統 | ||
| 單一執行個體 | 相關雲端中可使用相同或不同的資料庫系統。 | 不適用 | 不適用 | 不適用 | |
| 多實體主動-被動 | 在相關雲端中,可以使用相同或不同的資料庫系統。 | 可跨雲端複製。 | 可跨雲端複製。 | 不適用 | |
| 多實體主動-主動 | 相關雲端中可能使用相同或不同的資料庫系統。 | 不適用 | 不適用 | 可跨雲端同步。 | |
| 多實體雙主動模式,可解決衝突 | 相關雲端中可使用相同或不同的資料庫系統。 | 不適用 | 不適用 | 如果可以跨雲端進行雙向複製,則適用。 | |
某些發布模式的實作方式會根據基礎資料庫技術新增額外的抽象層,但並未內建這類發布模式,例如主動-主動系統 Postgres-BDR。這類系統會列在上述表格的相應類別中。從多雲端的角度來看,發布模型的實作方式並不重要。
資料庫遷移和複製
視用途而定,企業可能需要將資料庫從一個部署位置遷移到另一個位置。或者,為了進行下游處理,可能需要將資料庫的資料複製到其他位置。下一節將詳細說明資料庫遷移和資料庫複製。
資料庫遷移
資料庫遷移是指將資料庫從一個部署位置移至另一個位置。舉例來說,將地端部署資料中心內執行的資料庫,改為在雲端執行。遷移完成後,地端部署資料中心的資料庫就會關閉。
資料庫遷移的主要方法如下:
- 隨即轉移。VM 和執行資料庫執行個體的磁碟會照原樣複製到目標環境。複製完成後,系統會啟動這些 VM,並完成遷移作業。
- 匯出、匯入、備份和還原。這兩種方法都使用資料庫系統功能,將資料庫外部化,並在目標位置重新建立資料庫。匯出/匯入通常是以 ASCII 格式為基礎,而備份和還原是以二進位格式為基礎。
- 零停機時間遷移。這種方法會在應用程式系統存取來源系統時,遷移資料庫。初始載入後,系統會使用變更資料擷取 (CDC) 技術,將變更從來源資料庫傳輸至目標資料庫。從來源資料庫系統停止應用程式,到遷移完成後在目標資料庫系統重新啟動應用程式,這段期間應用程式會停機。
在多雲端用途中,當資料庫從一個雲端移至另一個雲端,或從一種資料庫引擎移至另一種資料庫引擎時,資料庫遷移就會變得重要。
資料庫遷移程序包含多個面向。詳情請參閱「資料庫遷移:概念與原則 (第 1 部分)」和「資料庫遷移:概念與原則 (第 2 部分)」。
內建資料庫技術可用於執行資料庫遷移,例如匯出和匯入、備份和還原,或內建複製通訊協定。如果來源和目標系統是不同的資料庫系統,遷移技術是資料庫遷移的最佳選擇。資料庫遷移服務、Striim 和 Debezium 都是資料庫遷移技術。
資料庫複製
資料庫複製與資料庫遷移類似。不過,在資料庫複製期間,來源資料庫系統會保持不變,而每項變更都會傳輸至目標資料庫。
資料庫複製是一項持續程序,會將變更從來源資料庫傳送至目標資料庫。如果這個程序是非同步,變更會在短暫延遲後抵達目標資料庫。如果程序是同步的,則來源系統的變更會同時套用至目標系統和相同的交易。
除了將來源複製到目標資料庫,常見的做法是將資料從來源資料庫複製到目標數據分析系統。
與資料庫遷移一樣,如果可以使用複製通訊協定,則可以使用內建資料庫技術進行資料庫複製。如果沒有內建的複製通訊協定,可以使用 Datastream、Striim 或 Debezium 等複製技術。
資料庫遷移技術在部署模式中的角色
在部署模式中使用不同的資料庫系統時 (例如非同步 (異質) 複製),通常無法使用內建的資料庫技術來啟用複製功能。而是可以部署資料庫遷移技術,來啟用這類複製功能。部分遷移系統也會實作雙向複製。
如果資料庫遷移或複製技術適用於「將資料庫系統對應至部署模式」一節中表 1 或表 2 標示為「不適用」的資料庫系統組合,則可能可以使用該技術進行資料庫複製。下圖顯示使用遷移技術複製資料庫的方法。

在上圖中,位置 1 的資料庫會複製到位置 2 的資料庫。系統會部署遷移伺服器來執行複製作業,而非直接複製資料庫系統。如果資料庫系統未內建資料庫複製功能,且需要依賴與資料庫系統分開的系統來實作複製功能,則會採用這種方法。
多雲端資料庫選項
多雲端資料庫用途與資料庫系統分類,可協助您決定最適合特定用途的資料庫。舉例來說,如要實作「應用程式可攜性」中的用途,有兩種做法。第一種做法是確保所有雲端都提供相同的資料庫引擎。這種做法可確保系統可攜性。第二種做法是確保所有雲端都能使用相同的資料模型和查詢介面。雖然資料庫系統可能不同,但可攜性是透過功能介面提供。
下列各節的決策樹,顯示本文中多雲端資料庫用途的決策條件。決策樹會根據各用途建議最適合的資料庫。
現有資料庫系統的最佳做法
如果資料庫系統已在實際工作環境中,則必須決定要保留或更換。下圖顯示決策過程中應考量的問題:

決策樹中的問題和答案如下:
- 資料庫系統是否已在正式環境中運作?
- 如果沒有正式環境資料庫系統,請選取資料庫系統 (跳至「多雲端資料庫管理決策」)。
- 如果資料庫系統處於正式環境,請評估是否應保留。
- 如果資料庫系統已在正式環境中,請評估是否應保留。
- 如果應保留資料庫系統,則決策已完成,決策程序也已完成。
- 如果需要變更資料庫系統,或尚未做出決定,請選取資料庫系統 (跳至「多雲端資料庫管理決策」)。
多雲端資料庫管理決策
下列決策樹適用於需要多位置資料庫 (包括多雲端資料庫部署) 的用途。並以部署模式做為決策標準的依據。

決策樹中的問題和答案如下:
- 資料是否分區儲存在不同資料庫中,且沒有任何跨資料庫依附關係?
- 如果是,則可為每個位置選取相同或不同的資料庫系統。
- 如果沒有,請繼續回答下一個問題。
- 是否需要非同步單向複製?
- 如果是,請評估是否能接受資料庫複製系統。
- 如果是,請選取與複製系統相容的相同或不同資料庫系統。
- 如果否,請選取可實作主動-被動分布模型的資料庫系統。
- 如果沒有,請繼續回答下一個問題。
- 如果是,請評估是否能接受資料庫複製系統。
- 選取已同步處理執行個體的資料庫系統。
- 是否可以接受衝突解決方案?
- 如果是,請選取雙向複製資料庫系統或主動-主動資料庫系統。
- 如果否,請選取主動-主動系統。
- 是否可以接受衝突解決方案?
如果實作多個多雲端用途,企業必須決定要使用一個資料庫系統支援所有用途,還是使用多個資料庫系統。
如果企業想使用單一資料庫系統支援所有用途,則同步處理效果最佳的系統是最佳選擇。舉例來說,如果需要單向複製和同步處理執行個體,則同步處理執行個體是最佳選擇。
同步品質的階層結構 (從無到最佳) 如下:分區、單向複製、雙向複製和完全同步複製。
部署最佳做法
本節重點說明選擇資料庫來遷移或開發多雲端應用程式時,應遵循的最佳做法。
現有資料庫管理系統
建議您保留資料庫,除非特定用途需要,否則不要變更資料庫系統。如果企業已建立資料庫管理系統,且具備有效的開發、營運和維護程序,最好避免進行變更。
如果雲端 bursting 的用途不需要雲端資料庫系統,則可能不需要變更資料庫。另一個用途是非同步複製到相同雲端中的不同部署位置,或複製到其他雲端。針對這些用途,建議您實作基準,並確認跨位置通訊和延遲時間符合存取資料庫時的應用程式需求。
Kubernetes 服務形式的資料庫系統
如果企業考慮在 Kubernetes 中,以 StatefulSets 為基礎的服務執行資料庫系統,則必須考量下列因素:
- 資料庫是否提供應用程式所需的資料庫模型。
- 非功能性因素,決定如何在資料庫系統中實作作業化,做為 Kubernetes 服務,例如如何進行擴充 (向上和向下擴充)、如何管理備份和還原,以及系統如何提供監控功能。為了協助他們瞭解 Kubernetes 資料庫系統的需求,企業應以資料庫經驗做為比較基準。
- 高可用性和災難復原。為提供高可用性,系統必須在區域內某個可用區故障時繼續運作。資料庫必須能快速從一個可用區容錯移轉至另一個可用區。在最理想的情況下,資料庫在每個可用區都有一個執行個體,且完全同步,RTO 和 RPO 為零。
- 災難復原,解決區域 (或雲端) 故障問題。在理想情況下,資料庫會繼續在第二個區域運作,RPO 和 RTO 為零。在較不理想的情況下,次要區域中的資料庫可能無法完全跟上主要資料庫的所有交易。
如要判斷在 Kubernetes 中執行資料庫的最佳方式,建議您進行完整的資料庫評估,尤其是當系統需要與 Kubernetes 以外的實際工作環境系統相當。
獨立於 Kubernetes 的資料庫系統
在 Kubernetes 中以服務形式實作的應用程式,不一定需要同時在 Kubernetes 中執行資料庫。資料庫系統必須在 Kubernetes 外部執行的原因有很多,例如既定程序、企業內部的產品知識,或無法使用。雲端服務供應商和雲端合作夥伴代管的資料庫都屬於這個類別。
在 Compute Engine 上執行資料庫同樣可行。選取資料庫系統時,建議您進行完整的資料庫評估,確保應用程式符合所有需求。
從應用程式設計的角度來看,連線集區是重要的設計考量。存取資料庫的應用程式服務可能會在內部使用連線集區。使用連線集區有助於提高效率並縮短延遲時間。要求會直接從集區中擷取,不需要啟動,也不必等待連線建立。如果透過新增應用程式服務執行個體來擴充應用程式,每個執行個體都會建立連線集區。如果遵循最佳做法,每個集區都會預先建立一組最少的連線。每次為應用程式擴充功能建立另一個應用程式服務執行個體時,系統都會將連線新增至資料庫。從設計的角度來看,由於資料庫無法支援無限連線,因此必須管理連線的新增,以免超載。
最佳資料庫系統與資料庫系統可攜性
企業在選擇資料庫系統時,通常會選擇最能滿足應用程式需求的資料庫系統。在多雲端環境中,您可以選擇各雲端中最合適的資料庫,並根據用途將這些資料庫相互連結。如果這些系統不同,任何單向或雙向複製作業都需要投入大量資源。如果使用最佳系統的好處大於實作所需的心力,這種做法可能就合理。
不過,建議您同時考慮並評估適用於所有必要雲端的資料庫系統方法。雖然這類資料庫可能不如最佳選項理想,但實作、操作及維護這類系統可能容易得多。
同時評估兩個資料庫系統,可瞭解各自的優缺點,為選擇提供可靠的依據。
內建與外部資料庫系統複製
如果用途需要在所有部署位置 (可用區、區域或雲端) 建立資料庫系統,複製功能就非常重要。複製作業可以是非同步、雙向或完全同步的主動-主動複製。並非所有資料庫系統都支援上述所有複製形式。
如果系統不支援複製功能,則可使用 Striim 等系統來補充架構 (如「資料庫遷移」一文所述)。
最佳做法是評估替代資料庫管理系統,判斷內建複製功能的系統或需要複製技術的系統有哪些優缺點。
第三類技術也在此案例中發揮作用。這個類別提供現有資料庫系統的外掛程式,可提供複製功能。MariaDB Galera Cluster 就是一個例子。如果評估程序允許,建議您評估這些系統。
多模型資料庫
多模型資料庫可在雲端和即時應用程式中,提供彈性且可擴充的資料管理功能。多模型資料庫支援多種資料模型,例如文件、圖形、鍵/值、資料欄系列和關聯式,並提供統一的查詢介面和儲存引擎。這些功能可帶來下列優勢:
- 簡化管理作業:開發人員可在單一資料庫系統中管理各種資料類型,有助於降低作業複雜度和負擔。
- 加快開發速度:多模型資料庫可讓您靈活運用最適合不同需求的資料模型。這種彈性可加快開發速度,並協助您更快因應不斷變化的需求。
- 整合更輕鬆:統一的查詢介面和儲存引擎,可大幅降低連結及同步處理不同資料庫的複雜度。
- 強化查詢功能:開發人員可以查詢及合併不同模型的資料,取得更豐富的洞察資訊,並開發更精細的應用程式功能。
- 節省成本:資料庫系統減少,授權、硬體和營運費用也會降低。
- 最佳化效能:為特定工作選擇最合適的資料模型,可望提升應用程式效能。
例如,Spanner 提供多模型功能,並支援 PostgreSQL 方言。這項功能可讓您使用關聯式和 NoSQL 資料建構智慧型 AI 輔助應用程式、透過 Spanner Graph 查詢複雜關係,以及使用向量搜尋進行語意搜尋。
後續步驟
- 瞭解混合雲和多雲端架構模式。
- 瞭解將其他雲端服務供應商與 Google Cloud 連結的模式。
- 瞭解 Google Cloud上混合雲和多雲端部署項目的監控和記錄架構。
- 如要查看更多參考架構、圖表和最佳做法,請瀏覽 Cloud Architecture Center。
貢獻者
作者:Alex Cârciu | 解決方案架構師