


סקירה כללית על הכנת נתונים ב-BigQuery
אתם יכולים להשתמש בהכנת נתונים מבוססת-AI ב-BigQuery כדי לצמצם משמעותית את הזמן והמאמץ שנדרשים לביצוע משימות ידניות שקשורות לנתונים. הכלי להכנת נתונים משתמש ב-Gemini ב-BigQuery כדי לנתח את הנתונים ולספק הצעות חכמות לניקוי, לטרנספורמציה ולהעשרה שלהם. Dataform מתזמן את תהליכי הכנת הנתונים האלה.
יתרונות
- אתם יכולים לצמצם את הזמן שאתם משקיעים בפיתוח פייפליין נתונים בעזרת הצעות טרנספורמציה תלויות-הקשר שנוצרות על ידי Gemini.
- אתם יכולים לאמת את התוצאות שנוצרו בתצוגה מקדימה, ולקבל הצעות לניקוי ולהעשרה של איכות הנתונים באמצעות מיפוי סכימה אוטומטי.
- ב-Dataform אתם יכולים להשתמש בתהליך של אינטגרציה רציפה (CI) ופיתוח רציף (CD), שתומך בשיתוף פעולה בין צוותים לצורך סקירות קוד וניהול גרסאות קוד מקור.
נקודות כניסה לתהליך הכנת הנתונים
אתם יכולים ליצור ולנהל הכנות של נתונים בדף BigQuery Studio (ראו התחלת סשן של הכנת נתונים).
כשפותחים טבלה בהכנת נתונים ב-BigQuery, מופעלת משימה ב-BigQuery באמצעות פרטי הכניסה שלכם. ההרצה יוצרת שורות לדוגמה מהטבלה שנבחרה וכותבת את התוצאות בטבלה זמנית באותו פרויקט. Gemini משתמש בנתונים לדוגמה ובסכימה כדי ליצור הצעות להכנת נתונים שמוצגות בכלי לעריכת הכנת הנתונים.
תצוגות בכלי לעריכת הכנת הנתונים
הכנות הנתונים מופיעות ככרטיסיות בדף BigQuery. בכל כרטיסייה יש סדרה של כרטיסיות משנה, או תצוגות של הכנת נתונים, שבהן אתם מפתחים ומנהלים את הכנות הנתונים.
תצוגת נתונים
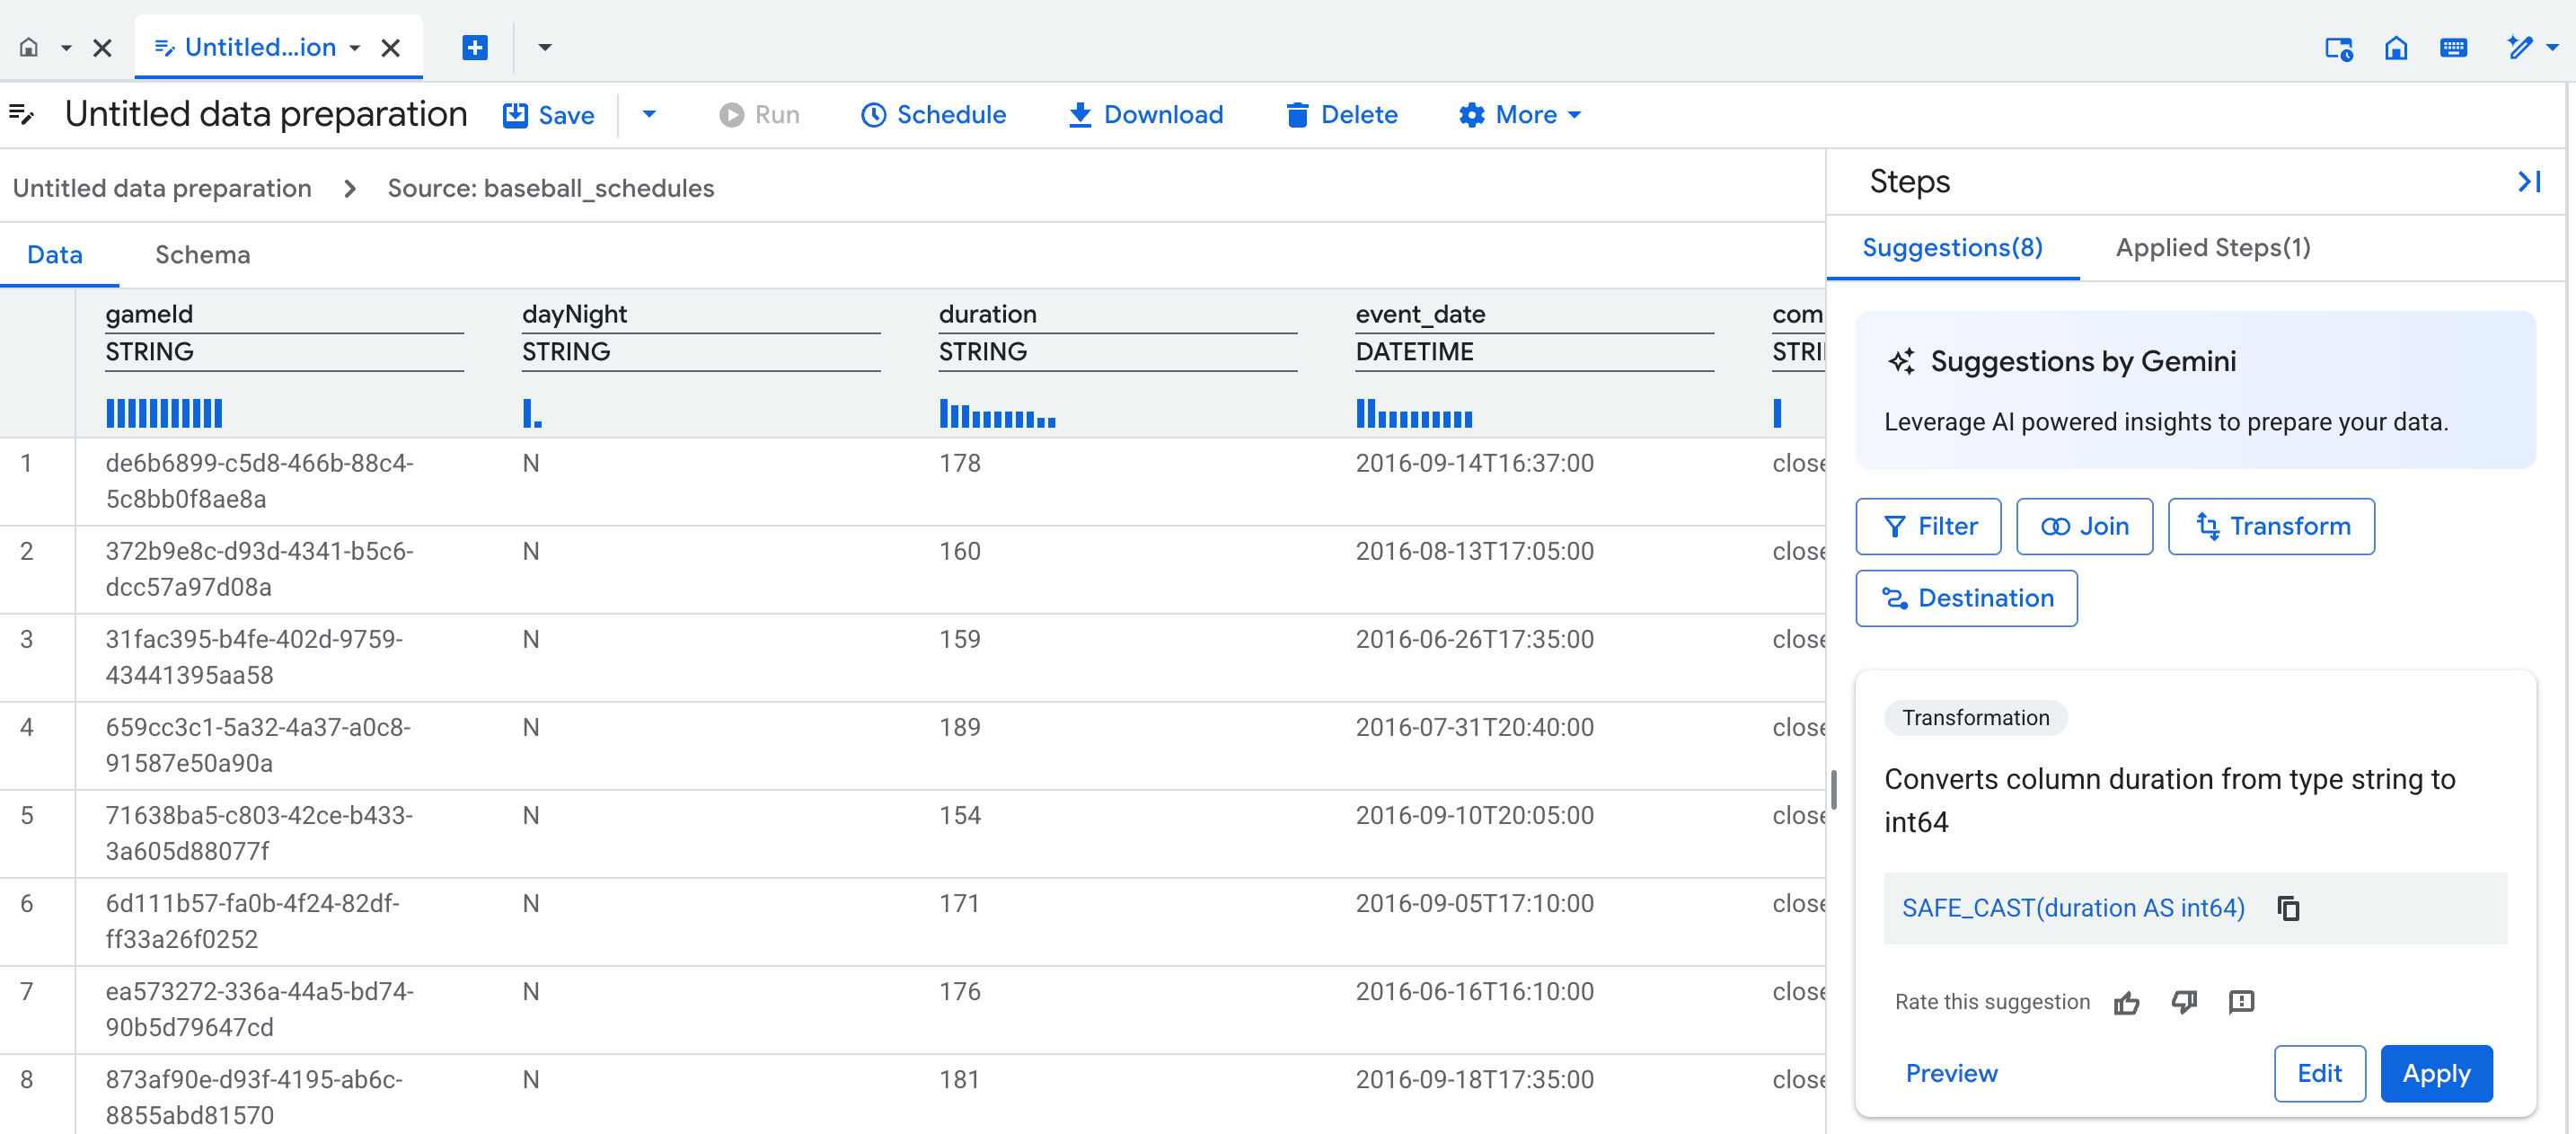
כשיוצרים הכנת נתונים חדשה, נפתחת כרטיסיית עריכה של הכנת הנתונים, שבה מוצגת תצוגת הנתונים שמכילה דגימה מייצגת של הטבלה. בהכנות נתונים קיימות, אפשר לנווט לתצוגת הנתונים בלחיצה על צומת בתצוגת התרשים של צינור עיבוד הנתונים להכנת הנתונים.
תצוגת הנתונים מאפשרת לכם:
- אתם יכולים לבצע פעולות על הנתונים כדי ליצור שלבים להכנת הנתונים.
- ליישם הצעות מ-Gemini.
- כדי לשפר את איכות ההצעות של Gemini, הזינו ערכים לדוגמה בתאים.
מעל כל עמודה בטבלה, פרופיל סטטיסטי (היסטוגרמה) מציג את הספירה של הערכים המובילים בכל עמודה בשורות התצוגה המקדימה.
תצוגת תרשים
תצוגת התרשים היא סקירה חזותית של הכנת הנתונים. הוא מופיע ככרטיסייה בדף BigQuery במסוף, כשפותחים הכנת נתונים. בתרשים מוצגים צמתים לכל השלבים בצינור עיבוד הנתונים. אתם יכולים לבחור צומת בתרשים כדי להגדיר את שלבי הכנת הנתונים שהוא מייצג.

תצוגת סכימה
בתצוגת הסכימה של הכנת הנתונים מוצגת הסכימה הנוכחית של שלב הכנת הנתונים הפעיל. הסכימה שמוצגת תואמת לעמודות בתצוגת הנתונים.
בתצוגת הסכימה, אתם יכולים לבצע פעולות ייעודיות לסכימה, כמו הסרת עמודות, שגם יוצרות שלבים ברשימה Applied steps.

הצעות של Gemini
Gemini מספק הצעות מותאמות להקשר כדי לעזור במשימות הבאות של הכנת הנתונים:
- החלת טרנספורמציות וכללים לאיכות הנתונים
- סטנדרטיזציה והעשרה של נתונים
- אוטומציה של מיפוי סכימה
כל הצעה מופיעה בכרטיס ברשימת ההצעות של עורך הכנת הנתונים. הכרטיס מכיל את הפרטים הבאים:
- הקטגוריה הכללית של השלב, כמו שמירת שורות או טרנספורמציה
- תיאור של השלב, למשל שמירת שורות אם
COLUMN_NAMEהוא לאNULL - ביטוי ה-SQL התואם ששימש לביצוע השלב
אתם יכולים לראות תצוגה מקדימה של כרטיס ההצעה, לערוך אותו, להחיל אותו או לשנות את ההצעה. אפשר גם להוסיף שלבים באופן ידני. מידע נוסף זמין במאמר הכנת נתונים באמצעות Gemini.
כדי לשפר את ההצעות של Gemini, תנו לו דוגמה למה שאתם רוצים לשנות בעמודה.
דגימת נתונים
BigQuery משתמש בדגימת נתונים כדי לספק תצוגה מקדימה של הכנת הנתונים. אפשר לראות את הדגימה בתצוגת הנתונים של כל צומת.
כשמוסיפים טבלאות רגילות של BigQuery כמקור, הנתונים מוכנים באמצעות פונקציית TABLESAMPLE של BigQuery. הפונקציה הזו יוצרת דגימה של 10,000 רשומות.
כשמוסיפים תצוגה או טבלה חיצונית כמקור, המערכת קוראת את מיליון הרשומות הראשונות. מתוך הרשומות האלה, המערכת בוחרת מדגם מייצג של 10,000 רשומות.
הנתונים בדגימה לא מתרעננים באופן אוטומטי. טבלאות לדוגמה נשמרות כתוצאות של שאילתות במטמון ופגות התוקף אחרי כ-24 שעות. כדי לרענן ידנית את טבלת הדוגמה, קראו את המאמר רענון דוגמאות להכנת נתונים.
מצב כתיבה
כדי לייעל את העלויות ואת זמן העיבוד, אתם יכולים לשנות את הגדרות מצב הכתיבה כך שהמערכת תעבד נתונים חדשים מהמקור באופן מצטבר. לדוגמה, אם יש לכם טבלה ב-BigQuery שרשומות מוכנסות אליה מדי יום, ומרכז בקרה של Looker שצריך לשקף את הנתונים שהשתנו, אתם יכולים לתזמן את הכנת הנתונים ב-BigQuery כדי לקרוא באופן מצטבר את הרשומות החדשות מטבלת המקור ולהפיץ אותן לטבלת היעד.
כדי להגדיר את האופן שבו הכנת הנתונים נכתבת בטבלת היעד, קראו את המאמר אופטימיזציה של הכנת הנתונים באמצעות עיבוד נתונים מצטבר.
אלה מצבי הכתיבה שנתמכים:
| אפשרות למצב כתיבה | תיאור |
|---|---|
| רענון מלא | מבצע את שלבי הכנת הנתונים בכל נתוני המקור, ואז בונה מחדש את טבלת היעד במלואה. הטבלה נוצרת מחדש, ולא נחתכת. רענון מלא הוא מצב ברירת המחדל כשכותבים בטבלת יעד. |
| הוספה | הוספת כל הנתונים מהכנת הנתונים כשורה נוספת בטבלת היעד. |
| מצטבר | הוספה רק של הנתונים החדשים או הנתונים שהשתנו בטבלת היעד, בהתאם לבחירה שלכם בעמודה המצטברת. בהתאם לעמודה המצטברת שבחרתם, הכנת הנתונים תבחר את המנגנון האופטימלי לזיהוי רשומות השינויים. היא בוחרת ערכים מקסימליים לסוגי נתונים מספריים וסוגי נתונים של תאריך ושעה, וערכים ייחודיים לנתונים קטגוריים. האפשרות Maximum מוסיפה רק רשומות שבהן הערך בעמודה שצוינה גדול מהערך המקסימלי באותה עמודה בטבלת היעד. הפעולה Unique מוסיפה רק רשומות שבהן ערכי העמודות שצוינו לא קיימים בערכים הקיימים של אותה עמודה בטבלת היעד. |
| עדכון או הוספה (upsert) | מיזוג שורות באמצעות מפתחות המיזוג שצוינו. אם שורה קיימת בטבלת היעד תואמת למפתחות המיזוג שצוינו ברשומת הקלט, הערכים בשורה הזו מתעדכנים בטבלת היעד. אחרת, תתווסף שורה חדשה לטבלת היעד. |
שלבים נתמכים בהכנת נתונים
ב-BigQuery יש תמיכה בסוגים הבאים של שלבים להכנת נתונים:
| סוג השלב | תיאור |
|---|---|
| מקור | מוסיף מקור כשבוחרים טבלה ב-BigQuery לקריאה או כשמוסיפים שלב של צירוף. |
| שינוי | מנקה נתונים ומשנה אותם באמצעות ביטוי SQL. כרטיסי ההצעות מופיעים לביטויים הבאים:
אפשר גם להשתמש בכל ביטוי SQL תקין של BigQuery בשלבי הטרנספורמציה הידנית. לדוגמה:
מידע נוסף זמין בקטע הוספת טרנספורמציה. |
| מסנן | הסרת שורות באמצעות תחביר הסעיף WHERE. כשמוסיפים שלב סינון, אפשר להפוך אותו לשלב אימות.
מידע נוסף זמין במאמר סינון שורות. |
| ביטול כפילויות | הסרת שורות כפולות מהנתונים על סמך מפתחות וסדר שנבחרו.
מידע נוסף זמין במאמר ביטול כפילויות של נתונים. |
| אימות | שליחת שורות שלא עומדות בקריטריונים של כלל האימות לטבלת שגיאות. אם הנתונים לא עומדים בכלל האימות ולא מוגדרת טבלת שגיאות, הכנת הנתונים נכשלת במהלך ההפעלה.
מידע נוסף זמין במאמר הגדרת טבלת השגיאות והוספת כלל אימות. |
| הצטרפות | מצרף ערכים משני מקורות. הטבלאות צריכות להיות באותו מיקום.
עמודות של מפתחות איחוד חייבות להיות מאותו סוג נתונים. הכנות הנתונים תומכות בפעולות הצירוף הבאות:
מידע נוסף זמין במאמר הוספת פעולת איחוד. |
| יעד | מגדיר יעד לפלט של שלבי הכנת הנתונים. אם תזינו טבלת יעד שלא קיימת, הכנת הנתונים תיצור טבלה חדשה באמצעות פרטי הסכימה הנוכחיים. מידע נוסף זמין במאמר הוספה או שינוי של טבלת יעד. |
| מחיקת עמודות | מוחק עמודות מהסכימה. מבצעים את השלב הזה בתצוגת הסכימה.
מידע נוסף זמין במאמר מחיקת עמודה. |
תזמון הרצות של הכנת נתונים
כדי לבצע את השלבים של הכנת הנתונים ולטעון את הנתונים המוכנים לטבלת היעד, יוצרים תזמון. אפשר לתזמן הכנות של נתונים מעורך הכנת הנתונים, ולנהל אותן מהדף Scheduling ב-BigQuery. מידע נוסף זמין במאמר תזמון הכנות של נתונים.
בניית צינורות עיבוד נתונים עם משימות להכנת נתונים
אתם יכולים ליצור צינורות עיבוד נתונים ב-BigQuery שמורכבים ממשימות של הכנת נתונים, שאילתות SQL ו-Notebook. לאחר מכן תוכלו להריץ את צינורות עיבוד הנתונים האלה לפי לוח זמנים. מידע נוסף זמין במאמר מבוא לצינורות עיבוד נתונים ב-BigQuery.
שליטה בגישה
שליטה בגישה להכנות של נתונים באמצעות תפקידים של ניהול זהויות והרשאות גישה (IAM), הצפנה באמצעות מפתחות Cloud KMS של BigQuery ו-Dataform, ו-VPC Service Controls.
תפקידים והרשאות של IAM
המשתמשים שמכינים את הנתונים וחשבונות השירות של Dataform שמריצים את המשימות צריכים הרשאות IAM. למידע נוסף, קראו את המאמרים התפקידים הנדרשים והגדרת Gemini ל-BigQuery.
הצפנה באמצעות מפתחות Cloud KMS
הצפנת נתונים ברמת מערך הנתונים או ברמת הפרויקט באמצעות מפתחות Cloud KMS שמוגדרים כברירת מחדל ומנוהלים על ידי הלקוח ב-BigQuery. מידע נוסף זמין במאמרים הגדרת מפתח ברירת מחדל לקבוצת נתונים והגדרת מפתח ברירת מחדל לפרויקט.
כברירת מחדל, אתם יכולים להצפין את קוד צינור עיבוד הנתונים ברמת הפרויקט באמצעות מפתח Cloud KMS של Dataform.
היקפי האבטחה של VPC Service Controls
אם אתם משתמשים ב-VPC Service Controls, אתם צריכים להגדיר את גבולות הגזרה כדי להגן על Dataform ועל BigQuery. מידע נוסף זמין במגבלות של VPC Service Controls ל-BigQuery ול-Dataform.
התפקיד שמוקצה כשיוצרים תהליך להכנת נתונים
כשאתם יוצרים הכנת נתונים, BigQuery נותן לכם את התפקיד אדמין ב-Dataform (roles/dataform.admin) בהכנת הנתונים הזו. לכל המשתמשים עם התפקיד "אדמין ב-Dataform" בפרויקט Google Cloud יש גישת בעלים לכל הכנות הנתונים שנוצרו בפרויקט. כדי לשנות את ההתנהגות הזו, קראו את המאמר הקצאת תפקיד ספציפי בזמן יצירת המשאב.
מגבלות
הכנת הנתונים זמינה עם המגבלות הבאות:
- כל מערכי הנתונים של המקור והיעד של הכנת הנתונים ב-BigQuery צריכים להיות באותו מיקום. מידע נוסף זמין במאמר מיקומים.
- במהלך עריכת צינור עיבוד הנתונים, הנתונים והאינטראקציות נשלחים למרכז נתונים של Gemini לצורך עיבוד. מידע נוסף זמין במאמר מיקומים.
- Gemini ב-BigQuery לא נתמך ב-Assured Workloads.
- בהכנות של נתונים ב-BigQuery אי אפשר להציג, להשוות או לשחזר גרסאות של הכנת נתונים.
- התשובות של Gemini מבוססות על דגימה של מערך הנתונים שאתם מספקים כשאתם מפתחים את צינור עיבוד הנתונים. מידע נוסף זמין במאמר איך Gemini for Google Cloud משתמש בנתונים שלכם ובתנאים של תוכנית הבודקים הנאמנים של Gemini for Google Cloud .
- להכנת נתונים ב-BigQuery אין API משלה. איך מגדירים את Gemini ב-BigQuery
מיקומים
המשימות של עיבוד הנתונים מבוצעות ומאוחסנות במיקום של מערכי הנתונים במקור. אם צוין מיקום מאגר, הוא חייב להיות זהה למיקום של מערכי הנתונים של המקור.
האזור שבו מאוחסן הקוד של הכנת הנתונים יכול להיות שונה מהאזור שבו מבוצעת המשימה.
כל נכסי הקוד החדשים בפרויקט Google Cloud משתמשים באזור ברירת המחדל. אחרי שיוצרים את הנכס, אי אפשר לשנות את האזור שלו.
כדי להגדיר את אזור ברירת המחדל לנכסי קוד חדשים:
נכנסים לדף BigQuery.
בחלונית השמאלית, לוחצים על Files כדי לפתוח את דפדפן הקבצים:

ליד שם הפרויקט, לוחצים על View files panel actions > Switch code region.
בוחרים את אזור הקוד שרוצים להשתמש בו כברירת מחדל.
לוחצים על Save.
רשימת האזורים הנתמכים ב-BigQuery Studio
עיבוד הנתונים ב-BigQuery במהלך הפיתוח וההרצה תמיד מתבצע במיקום של מערכי הנתונים במקור. איפה Gemini ב-BigQuery מעבד את הנתונים שלכם?
תמחור
הפעלת הכנות של נתונים ויצירת דוגמאות של תצוגה מקדימה של נתונים משתמשות במשאבים של BigQuery, שמחויבים לפי התעריפים שמוצגים בתמחור של BigQuery.
הכנת הנתונים כלולה בתמחור של Gemini ב-BigQuery. מידע נוסף זמין במאמר הגדרת Gemini ב-BigQuery.