


(Descontinuado) Guia do usuário da malha de dados
A malha de dados do Cortex Framework amplia a base de dados para permitir a governança de dados, a facilidade de descoberta e o controle de acesso por meio de metadados do BigQuery e do Knowledge Catalog. Isso é implementado com um conjunto básico de recursos de metadados e anotações de recursos do BigQuery que podem ser personalizados e, opcionalmente, implantados com a base de dados. Essas especificações básicas fornecem uma configuração personalizada que é a base de metadados para complementar o Cortex Framework Data Foundation. Consulte os conceitos de malha de dados antes de continuar com este guia.
As etapas descritas nesta página foram projetadas especificamente para configurar a malha de dados para o Cortex Framework. Encontre os arquivos de configuração do Data Mesh nas pastas específicas de cada carga de trabalho na seção de diretórios do Data Mesh.
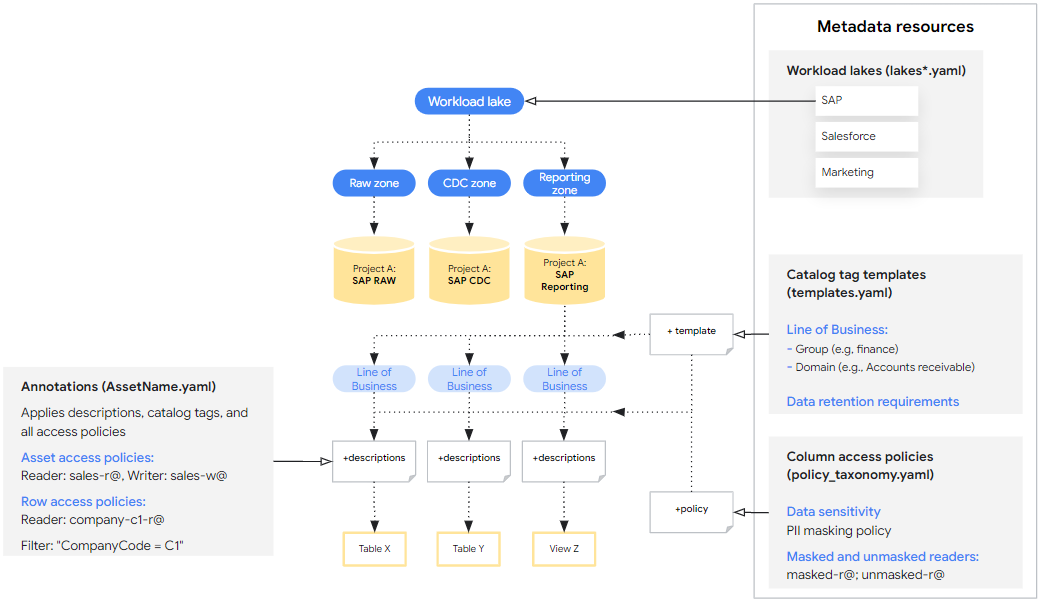
Design
A malha de dados do Cortex foi projetada de forma semelhante à base de dados geral e consiste em três fases com diferentes subcomponentes gerenciados pelo Cortex ou pelos usuários:
- Atualização das especificações de recursos básicos: a cada lançamento, o Cortex atualiza as especificações de recursos básicos, fornecendo uma base de metadados padronizada para a malha de dados.
- Personalização de especificações de recursos: antes da implantação, os usuários podem adaptar as especificações de recursos para se alinhar aos casos de uso e requisitos específicos.
- Implantação e atualizações da malha de dados:os usuários podem ativar a malha de dados no arquivo de configuração do Cortex. Ele é implantado após os recursos de dados durante a implantação do Cortex. Além disso, os usuários têm a flexibilidade de implantar a malha de dados de forma independente para outras atualizações.

Diretórios da malha de dados
Encontre os arquivos de configuração base da malha de dados para cada carga de trabalho e fonte de dados
nos locais a seguir. Considere que os diretórios contêm uma estrutura de arquivos
diferente, mas todas as especificações estão localizadas de forma semelhante na pasta
config.
| Carga de trabalho | Fonte de dados | Caminho do diretório |
| Operacional | SAP ECC | src/SAP/SAP_REPORTING/config/ecc |
| SAP S/4 HANA | src/SAP/SAP_REPORTING/config/s4 |
|
| Salesforce Sales Cloud (SFDC) | src/SFDC/config
|
|
| Oracle EBS | src/OracleEBS/config
|
|
| Marketing | CM360 | src/marketing/src/CM360/config |
| Google Ads | src/marketing/src/GoogleAds/config
|
|
| Meta | src/marketing/src/Meta/config
|
|
| Salesforce Marketing Cloud (SFMC) | src/marketing/src/SFMC/config
|
|
| TikTok | src/marketing/src/TikTok/config
|
|
| YouTube (com o DV360) | src/marketing/src/DV360/config
|
|
| Google Analytics 4 | src/marketing/src/GA4/config
|
Os recursos de metadados são definidos no nível da fonte de dados com um único arquivo YAML por projeto do Google Cloud e contêm uma lista de todos os recursos. Os usuários podem estender o arquivo atual ou criar outros arquivos YAML com especificações de recursos adicionais nesse diretório, se necessário.
As anotações de recursos são definidas no nível do recurso e contêm muitos arquivos YAML no diretório com uma única anotação por arquivo.
Ativar APIs e verificar permissões
Ao modificar os valores padrão da malha de dados, é possível implementar recursos além das descrições. Se você precisar modificar os valores padrão da malha de dados no
config.json
para implementar recursos além das descrições, verifique se as APIs
necessárias e as permissões de confirmação estão definidas conforme descrito na tabela a seguir.
Ao implantar a malha de dados com a base de dados, conceda permissões ao
usuário que está fazendo a implantação ou à conta do Cloud Build. Se a implantação envolver
projetos de origem e de destino diferentes, verifique se essas APIs e permissões
estão ativadas nos dois projetos em que esses recursos são usados.
| Recurso | Papéis de permissão | Documentação |
| Acesso a recursos e linhas do BigQuery | Proprietário de dados do BigQuery | Para mais informações, consulte Papéis necessários para os papéis de recursos e Permissões necessárias para os papéis de linha. |
| Acesso à coluna do BigQuery | Administrador de tag de política | Para mais informações, consulte a documentação sobre papéis usados com controle de acesso no nível da coluna e como restringir o acesso com o controle de acesso no nível da coluna. |
| Tags do catálogo | Proprietário do Data Catalog TagTemplate | Para mais informações, consulte Marcar uma tabela do BigQuery usando o Data Catalog e a documentação do IAM do Data Catalog. |
| Lakes do Knowledge Catalog | Editor do Dataplex | Para mais informações, consulte a documentação Criar um lake. |
Noções básicas sobre as especificações de recursos de base
A interface principal para configurar a malha de dados do Cortex é por meio das especificações de recursos de base, que são um conjunto de arquivos YAML prontos para uso que definem os recursos de metadados e as anotações implantadas. As especificações básicas fornecem recomendações iniciais e exemplos de sintaxe, mas devem ser personalizadas para atender às necessidades do usuário. Essas especificações se enquadram em duas categorias:
- Recursos de metadados que podem ser aplicados a vários recursos de dados. Por exemplo, modelos de tag do catálogo que definem como os recursos podem ser marcados com domínios de negócios.
- Anotações que especificam como os recursos de metadados são aplicados a um recurso de dados específico. Por exemplo, uma tag do catálogo que associa uma tabela específica ao domínio de vendas.
As seções a seguir mostram exemplos básicos de cada tipo de especificação e explicam como personalizá-los. As especificações de base são marcadas com
## CORTEX-CUSTOMER, onde devem ser modificadas para se adequar a uma implantação se a
opção de implantação associada estiver ativada.
Para usos avançados, consulte a definição canônica desses esquemas de especificação em src/common/data_mesh/src/data_mesh_types.py.
Recursos de metadados
Os recursos de metadados são entidades compartilhadas que existem em um projeto e
podem ser aplicadas a muitos recursos de dados. A maioria das especificações inclui um campo display_name
sujeito aos seguintes critérios:
- Contém apenas letras Unicode, números (0-9), sublinhados (_), traços (-) e espaços ( ).
- Não pode começar nem terminar com espaços.
- O tamanho máximo é de 200 caracteres.
Em alguns casos, o display_name também é usado como um ID, o que pode introduzir
outros requisitos. Nesses casos, são incluídos links para a documentação canônica.
Se a implantação fizer referência a recursos de metadados em projetos de origem e de destino diferentes, será necessário definir uma especificação para cada projeto. Por exemplo, Cortex Salesforce (SFDC) contém duas especificações de Lake. Uma para as zonas bruta e de CDC e outra para relatórios.
Lakes do Knowledge Catalog
Os lakes, as zonas e os recursos do Knowledge Catalog são usados para organizar os dados de uma perspectiva de engenharia. Os lakes têm um region e as zonas têm um location_type, ambos relacionados ao local do Cortex (config.json > location). O local do Cortex define onde os conjuntos de dados do BigQuery são armazenados e pode ser uma região única ou multirregional. A zona
location_type precisa ser definida como SINGLE_REGION | MULTI_REGION para corresponder a isso.
No entanto, as regiões do Lake precisam ser sempre uma única região. Se o local e a zona location_type do Cortex forem multirregionais, selecione uma única região dentro desse grupo para a região do lake.
- Requisitos
- O lago
display_nameé usado comolake_ide precisa obedecer aos requisitos oficiais. Isso também acontece com a zona e o recursodisplay_name. Os IDs de zona precisam ser exclusivos em todos os lakes do projeto. - As especificações do lake precisam ser associadas a uma única região.
- O
asset_nameprecisa corresponder ao ID do conjunto de dados do BigQuery, mas odisplay_namepode ser um rótulo mais fácil de usar.
- O lago
- Limitações
- O Knowledge Catalog só aceita o registro de conjuntos de dados do BigQuery, não de tabelas individuais, como recursos do Knowledge Catalog.
- Um recurso só pode ser registrado em uma única zona.
- O Knowledge Catalog só está disponível em alguns locais. Para mais informações, consulte Locais do Knowledge Catalog.
Confira o exemplo a seguir em
lakes.yaml.
Esses recursos são definidos em arquivos YAML que especificam
data_mesh_types.Lakes.
Modelos de tags de catálogo
Os modelos de tag do Data Catalog podem ser usados para adicionar contexto a tabelas do BigQuery ou colunas individuais. Eles ajudam a categorizar e entender seus dados de uma perspectiva técnica e de negócios de uma maneira integrada à ferramenta de pesquisa do Knowledge Catalog. Eles definem os campos específicos que você pode usar para rotular seus dados e o tipo de informação que cada campo pode conter (por exemplo, texto, número, data). As tags do catálogo são instâncias dos modelos com valores de campo reais.
O campo de modelo display_name é usado como o ID do campo e precisa seguir os
requisitos de TagTemplate.fields especificados em
Class TagTemplate.
Para mais informações sobre os tipos de campo compatíveis, consulte Tipos de campo do Data Catalog.
O Cortex Data Mesh cria todos os modelos de tag como legíveis publicamente. Ele também
introduz um conceito adicional de level às especificações do modelo de tag, que define
se uma tag precisa ser aplicada a um recurso inteiro, a campos individuais em um
recurso ou a ambos, com os valores possíveis: ASSET | FIELD | ANY. Embora isso
não seja estritamente obrigatório agora, as verificações de validação futuras podem garantir que as tags
sejam aplicadas no nível apropriado durante a implantação.
Veja o exemplo a seguir.
Os modelos são definidos em arquivos YAML que especificam
data_mesh_types.CatalogTagTemplates.
As tags do catálogo são instâncias dos modelos e são discutidas abaixo nas anotações de recursos.
Controle de acesso no nível do recurso e da coluna com modelos de tag
O Cortex Framework permite ativar o controle de acesso no nível do recurso ou da coluna em todos os artefatos associados a um modelo de tag de catálogo.
Por exemplo, se os usuários quiserem conceder acesso a recursos com base na linha de
negócios, eles poderão criar asset_policies para o modelo de tag do catálogo
line_of_business com diferentes principais especificados para cada domínio de negócios.
Cada política aceita filters que podem ser usados para corresponder apenas a tags com valores
específicos. Nesse caso, podemos corresponder os valores de domain. Esses
filters só são compatíveis com a correspondência de igualdade e nenhum outro operador. Se
vários filtros forem listados, os resultados precisarão atender a todos os filtros
(por exemplo, filter_a AND filter_b). O conjunto final de políticas de recursos é
a união das definidas diretamente nas anotações e das
políticas de modelo.
O controle de acesso no nível da coluna com tags do Catalog se comporta de maneira semelhante ao aplicar tags de política em campos correspondentes. No entanto, como apenas uma tag de política pode ser aplicada a uma coluna, a precedência é:
- Tag de política direta:se uma tag de política for definida diretamente na anotação da coluna, ela terá prioridade.
- Política de correspondência de modelo de tag: caso contrário, o acesso é determinado pela primeira política de correspondência definida em um campo no modelo de tag do catálogo associado.
Ao usar esse recurso, recomendamos ativar ou desativar a implantação de tags de catálogo e listas de controle de acesso (ACLs) juntas. Isso garante que as ACLs sejam implantadas corretamente.
Para entender as especificações desse recurso avançado, consulte as definições dos parâmetros asset_policies e field_policies em data_mesh_types.CatalogTagTemplate.
Glossário do catálogo
O glossário é uma ferramenta que pode ser usada para fornecer um dicionário de termos usados por colunas específicas em recursos de dados que podem não ser universalmente compreendidos. Os usuários podem adicionar termos manualmente no console, mas não há suporte pelas especificações de recursos.
Taxonomias e tags de política
As taxonomias e tags de política permitem o controle de acesso no nível da coluna em recursos de dados confidenciais de maneira padronizada. Por exemplo, pode haver uma taxonomia para tags que controlam dados de PII em uma linha de negócios específica, em que apenas determinados grupos podem ler dados mascarados, dados não mascarados ou não têm acesso de leitura.
Para mais detalhes sobre as taxonomias e tags de política, consulte a documentação de introdução à máscara de dados de coluna. As seções a seguir são particularmente relevantes:
- Interação de papéis
- Herança de autorização
- Regras de mascaramento e hierarquia
- Práticas recomendadas para tags de política
O Cortex Framework fornece exemplos de tags de política para demonstrar como elas são especificadas e os possíveis usos. No entanto, os recursos que afetam o controle de acesso não são ativados na implantação do Data Mesh por padrão.
Veja o exemplo a seguir.
As taxonomias de política são definidas em arquivos YAML que especificam
data_mesh_types.PolicyTaxonomies.
Anotações de recursos
As anotações especificam metadados aplicáveis a um recurso específico e podem fazer referência aos recursos de metadados compartilhados que foram definidos. As anotações incluem:
- Descrições de recursos
- Descrições de campo
- Tags do catálogo
- Controle de acesso no nível do recurso, da linha e da coluna
A base de dados do Cortex Framework oferece anotações (descrições) pré-configuradas para as seguintes cargas de trabalho.
- SAP ECC (bruto, CDC e relatórios)
- SAP S4 HANA (bruto, CDC e relatórios)
- SFDC (somente relatórios)
- Oracle EBS (somente relatórios)
- CM360 (somente relatórios)
- Google Ads (somente relatórios)
- Meta (somente relatórios)
- SFMC (somente relatórios)
- TikTok (somente relatórios)
- YouTube (com DV360) (somente relatórios)
- Google Analytics 4 (somente relatórios)
Veja o exemplo a seguir.
As anotações são definidas em arquivos YAML que especificam
data_mesh_types.BqAssetAnnotation.
Tags do catálogo
As tags de catálogo são instâncias dos modelos definidos em que os valores de campo são atribuídos ao recurso específico. Atribua valores que correspondam aos tipos de campo declarados no modelo associado.
Os valores de TIMESTAMP precisam estar em um dos seguintes formatos:
  "%Y-%m-%d %H:%M:%S%z"
  "%Y-%m-%d %H:%M:%S"
  "%Y-%m-%d"
Veja o exemplo a seguir.
Consulte a definição de especificação em
data_mesh_types.CatalogTag.
Como especificar leitores e principais da política de acesso
Controle o acesso aos dados do BigQuery no Cortex Framework usando políticas de acesso. Essas políticas definem quem (principais) pode acessar recursos de dados específicos, linhas em um recurso ou até mesmo colunas individuais. Os principais precisam seguir um formato específico definido pelo membro de vinculação de política do IAM.
Acesso no nível do recurso
É possível conceder acesso a recursos inteiros do BigQuery com várias permissões:
READER: visualizar dados no recurso.WRITER: modificar e adicionar dados ao recurso.OWNER: controle total sobre o recurso, incluindo o gerenciamento de acesso.
Essas permissões são equivalentes à instrução GRANT DCL em SQL.
Ao contrário do comportamento da maioria dos recursos e anotações, a
flag de substituição não remove os
principais com o papel OWNERS.
Ao adicionar novos proprietários com a substituição ativada, eles são apenas anexados aos
proprietários atuais. Essa é uma proteção para evitar a perda não intencional de acesso.
Para remover proprietários de recursos, use o console. A substituição remove os principais
com o papel READER ou WRITER.
Veja o exemplo a seguir.
Consulte a definição de especificação em
data_mesh_types.BqAssetPolicy.
Acesso no nível da linha
É possível conceder acesso a conjuntos de linhas com base em determinados filtros de valor de coluna.
Ao especificar a política de acesso de linha, a string de filtro fornecida será inserida em um
CREATE DDL statement. Se a sinalização overwrite estiver ativada, ela vai descartar todas as políticas de acesso de linha atuais
antes de aplicar as novas.
Considere o seguinte sobre o acesso no nível da linha:
- Adicionar políticas de acesso de linha significa que os usuários não especificados nessas políticas não terão acesso para ver as linhas.
- As políticas de linha só funcionam com tabelas, não com visualizações.
- Evite usar colunas particionadas nos filtros de política de acesso de linha. Consulte o arquivo YAML de configurações de relatórios associado para ver informações sobre o tipo de recurso e as colunas particionadas.
Para mais informações sobre políticas de acesso no nível da linha, consulte Práticas recomendadas de segurança no nível da linha.
Veja o exemplo a seguir.
Consulte a definição de especificação em
data_mesh_types.BqRowPolicy.
Acesso no nível da coluna
Para ativar o acesso no nível da coluna, adicione uma tag de política a campos individuais, identificada pelo nome da tag de política e pelo nome da taxonomia. Atualize o recurso de metadados da tag de política para configurar o controle de acesso.
Veja o exemplo a seguir.
Consulte a definição de especificação em
data_mesh_types.PolicyTagId.
Como implantar a malha de dados
A malha de dados pode ser implantada como parte da implantação da base de dados
ou por conta própria. Em ambos os casos, ele usa o arquivo config.json do Cortex para determinar variáveis relevantes, como nomes de conjuntos de dados do BigQuery e opções de implantação. Por padrão, a implantação da malha de dados não remove
nem substitui recursos ou anotações para evitar perdas
não intencionais. No entanto, também é possível substituir
recursos atuais quando implantados por conta própria.
Opções de implantação
As opções de implantação a seguir podem ser ativadas ou desativadas com base nas necessidades do usuário e nas restrições de gastos em config.json > DataMesh.
| Opção | Observações |
deployDescriptions
|
Essa é a única opção ativada por padrão e implanta anotações do BigQuery com descrições de recursos e colunas. Não é necessário ativar outras APIs ou permissões. |
deployLakes
|
Implanta lakes e zonas. |
deployCatalog
|
Implanta recursos do modelo de catálogo e as tags associadas em anotações de recursos. |
deployACLs
|
Implanta recursos de taxonomia de políticas e políticas de controle de acesso no nível do recurso, da linha e da coluna usando anotações de recursos. Os registros contêm mensagens que indicam como as políticas de acesso foram alteradas. |
Implantação com a base de dados
Por padrão, config.json > deployDataMesh permite implantar as
descrições de recursos do Data Mesh no final de cada etapa de build da carga de trabalho. Essa
configuração padrão não exige a ativação de outras APIs ou papéis.
É possível implantar outros recursos da malha de dados com a base de dados.
Para isso, ative as opções de implantação, as APIs e os papéis necessários e
modifique as especificações de recursos associadas.
Implantação independente
Para implantar apenas a malha de dados, os usuários podem usar o arquivo common/data_mesh/deploy_data_mesh.py. Esse utilitário é usado durante os processos de build para implantar a malha de dados
uma carga de trabalho por vez, mas, quando chamado diretamente, também pode ser usado para
implantar várias cargas de trabalho de uma só vez. As cargas de trabalho das especificações a serem
implantadas precisam ser ativadas no arquivo config.json. Por exemplo, verifique se
deploySAP=true se estiver implantando a malha de dados para SAP.
Para garantir que você está implantando com os pacotes e as versões necessários, execute o utilitário na mesma imagem usada pelo processo de implantação do Cortex com os seguintes comandos:
  # Run container interactively
  docker container run -it gcr.io/kittycorn-public/deploy-kittycorn:v2.0

  # Clone the repo
  git clone https://github.com/GoogleCloudPlatform/cortex-data-foundation

  # Navigate into the repo
  cd cortex-data-foundation
Para receber ajuda com os parâmetros disponíveis e o uso deles, execute o seguinte comando:
python src/common/data_mesh/deploy_data_mesh.py -h
Veja a seguir um exemplo de invocação para o SAP ECC:
  python src/common/data_mesh/deploy_data_mesh.py \
    --config-file config/config.json \
    --lake-directories \
        src/SAP/SAP_REPORTING/config/ecc/lakes \
    --tag-template-directories \
        src/SAP/SAP_REPORTING/config/ecc/tag_templates \
    --policy-directories \
        src/SAP/SAP_REPORTING/config/ecc/policy_taxonomies \
    --annotation-directories \
        src/SAP/SAP_REPORTING/config/ecc/annotations
Consulte a seção Diretórios da malha de dados para informações sobre os locais dos diretórios.
Substituir
Por padrão, a implantação da malha de dados não substitui recursos ou anotações atuais. No entanto, a flag --overwrite pode ser ativada ao implantar a malha de dados sozinha para mudar a implantação das seguintes maneiras.
A substituição de recursos de metadados, como lagos, modelos de tags de catálogo e tags de política, exclui todos os recursos que compartilham os mesmos nomes, mas não modifica os recursos com nomes diferentes. Isso significa que, se uma especificação de recurso for removida totalmente do arquivo YAML e, em seguida, a malha de dados for reimplantada com a substituição ativada, essa especificação de recurso não será excluída, porque não haverá colisão de nomes. Isso é para que a implantação da malha de dados do Cortex não afete os recursos atuais que podem estar em uso.
Para recursos aninhados, como Lakes e Zones, a substituição de um recurso remove todos os filhos dele. Por exemplo, substituir um lake também remove as zonas e referências de recursos atuais. Para modelos de tag de catálogo e tags de política que são substituídos, as referências de anotação associadas também são removidas dos recursos. A substituição de tags de catálogo em uma anotação de recurso só substitui as instâncias atuais de tags de catálogo que compartilham o mesmo modelo.
As substituições de descrição de recursos e campos só vão entrar em vigor se houver uma nova descrição válida e não vazia que entre em conflito com a descrição atual.
Por outro lado, as ACLs se comportam de maneira diferente. A substituição de ACLs remove todos os participantes atuais (exceto os proprietários no nível do recurso). Isso ocorre porque os principais omitidos das políticas de acesso são tão importantes quanto os principais que recebem acesso.
Como analisar a malha de dados
Depois de implantar a malha de dados, os usuários podem pesquisar e visualizar os recursos de dados com o Data Catalog. Isso inclui a capacidade de descobrir recursos com base nos valores de tag do catálogo que foram aplicados. Os usuários também podem criar e aplicar manualmente termos do Glossário do catálogo, se necessário.
As políticas de acesso implantadas podem ser visualizadas na página "Esquema do BigQuery" para conferir as políticas aplicadas a um recurso específico em cada nível.
Linhagem de dados
Os usuários podem achar útil ativar e visualizar a linhagem entre os recursos do BigQuery. A linhagem também pode ser acessada de maneira programática pela API. A linhagem de dados só é compatível com a linhagem no nível do recurso. A linhagem de dados não está interligada com a malha de dados do Cortex, mas novos recursos que usam a linhagem podem ser introduzidos no futuro.
Para solicitações do Cortex Data Mesh ou do Cortex Framework, acesse a seção de suporte.