


Les espaces de travail de conversion vous aident à convertir le schéma et les objets de votre base de données source dans la syntaxe SQL compatible avec votre base de données de destination. Cette page présente les espaces de travail de conversion de Database Migration Service :
La section Options d'initialisation du schéma source explique comment remplir votre espace de travail en vous connectant directement à votre base de données ou en important des fichiers de schéma dans Cloud Storage.
Les aperçus de conversion fournissent une vue d'ensemble de la progression de la conversion de votre schéma.
Objets compatibles avec la conversion déterministe de code et de schéma liste les objets Oracle compatibles avec la conversion déterministe de schéma.
Éditeur SQL interactif décrit les objets que vous pouvez modifier directement dans l'éditeur de l'espace de travail de conversion.
Fonctionnalités de conversion optimisées par Gemini explique comment intégrer l'assistance de l'IA générative pour accélérer le processus de conversion de schéma.
La section Fichiers de mappage de conversion présente les directives de personnalisation que vous pouvez utiliser pour remplacer les règles de conversion de schéma déterministe.
Anciens espaces de travail de conversion décrit les anciens espaces de travail qui ne sont pas compatibles avec l'éditeur SQL interactif.
Certains types de données ne sont pas compatibles avec les migrations Oracle. Pour en savoir plus, consultez Limites connues pour les types de données.
Options d'initialisation du schéma source
Pour convertir le schéma de votre base de données, Database Migration Service a besoin d'un instantané initial des objets de votre base de données source. Vous pouvez fournir cet instantané de deux manières :
- Connexion directe à la base de données : Database Migration Service se connecte directement à votre base de données source en cours d'exécution via un profil de connexion et récupère le schéma via une connexion réseau.
- Fichiers de schéma dans Cloud Storage : vous pouvez extraire les métadonnées de votre schéma localement à l'aide de scripts d'extraction fournis par Google, importer les fichiers obtenus dans un bucket Cloud Storage et préparer votre espace de travail sans vous connecter à la base de données source.
Pour savoir comment créer l'espace de travail de conversion avec une connexion directe à la base de données ou avec des fichiers de schéma dans Cloud Storage, consultez Créer un espace de travail de conversion.
Présentation de la progression de la conversion
Informations générales détaillées sur les espaces de travail de conversion, où vous pouvez obtenir des insights sur le nombre total de problèmes de conversion en attente ou résolus, les augmentations assistées par Gemini et l'état général de votre processus de conversion.
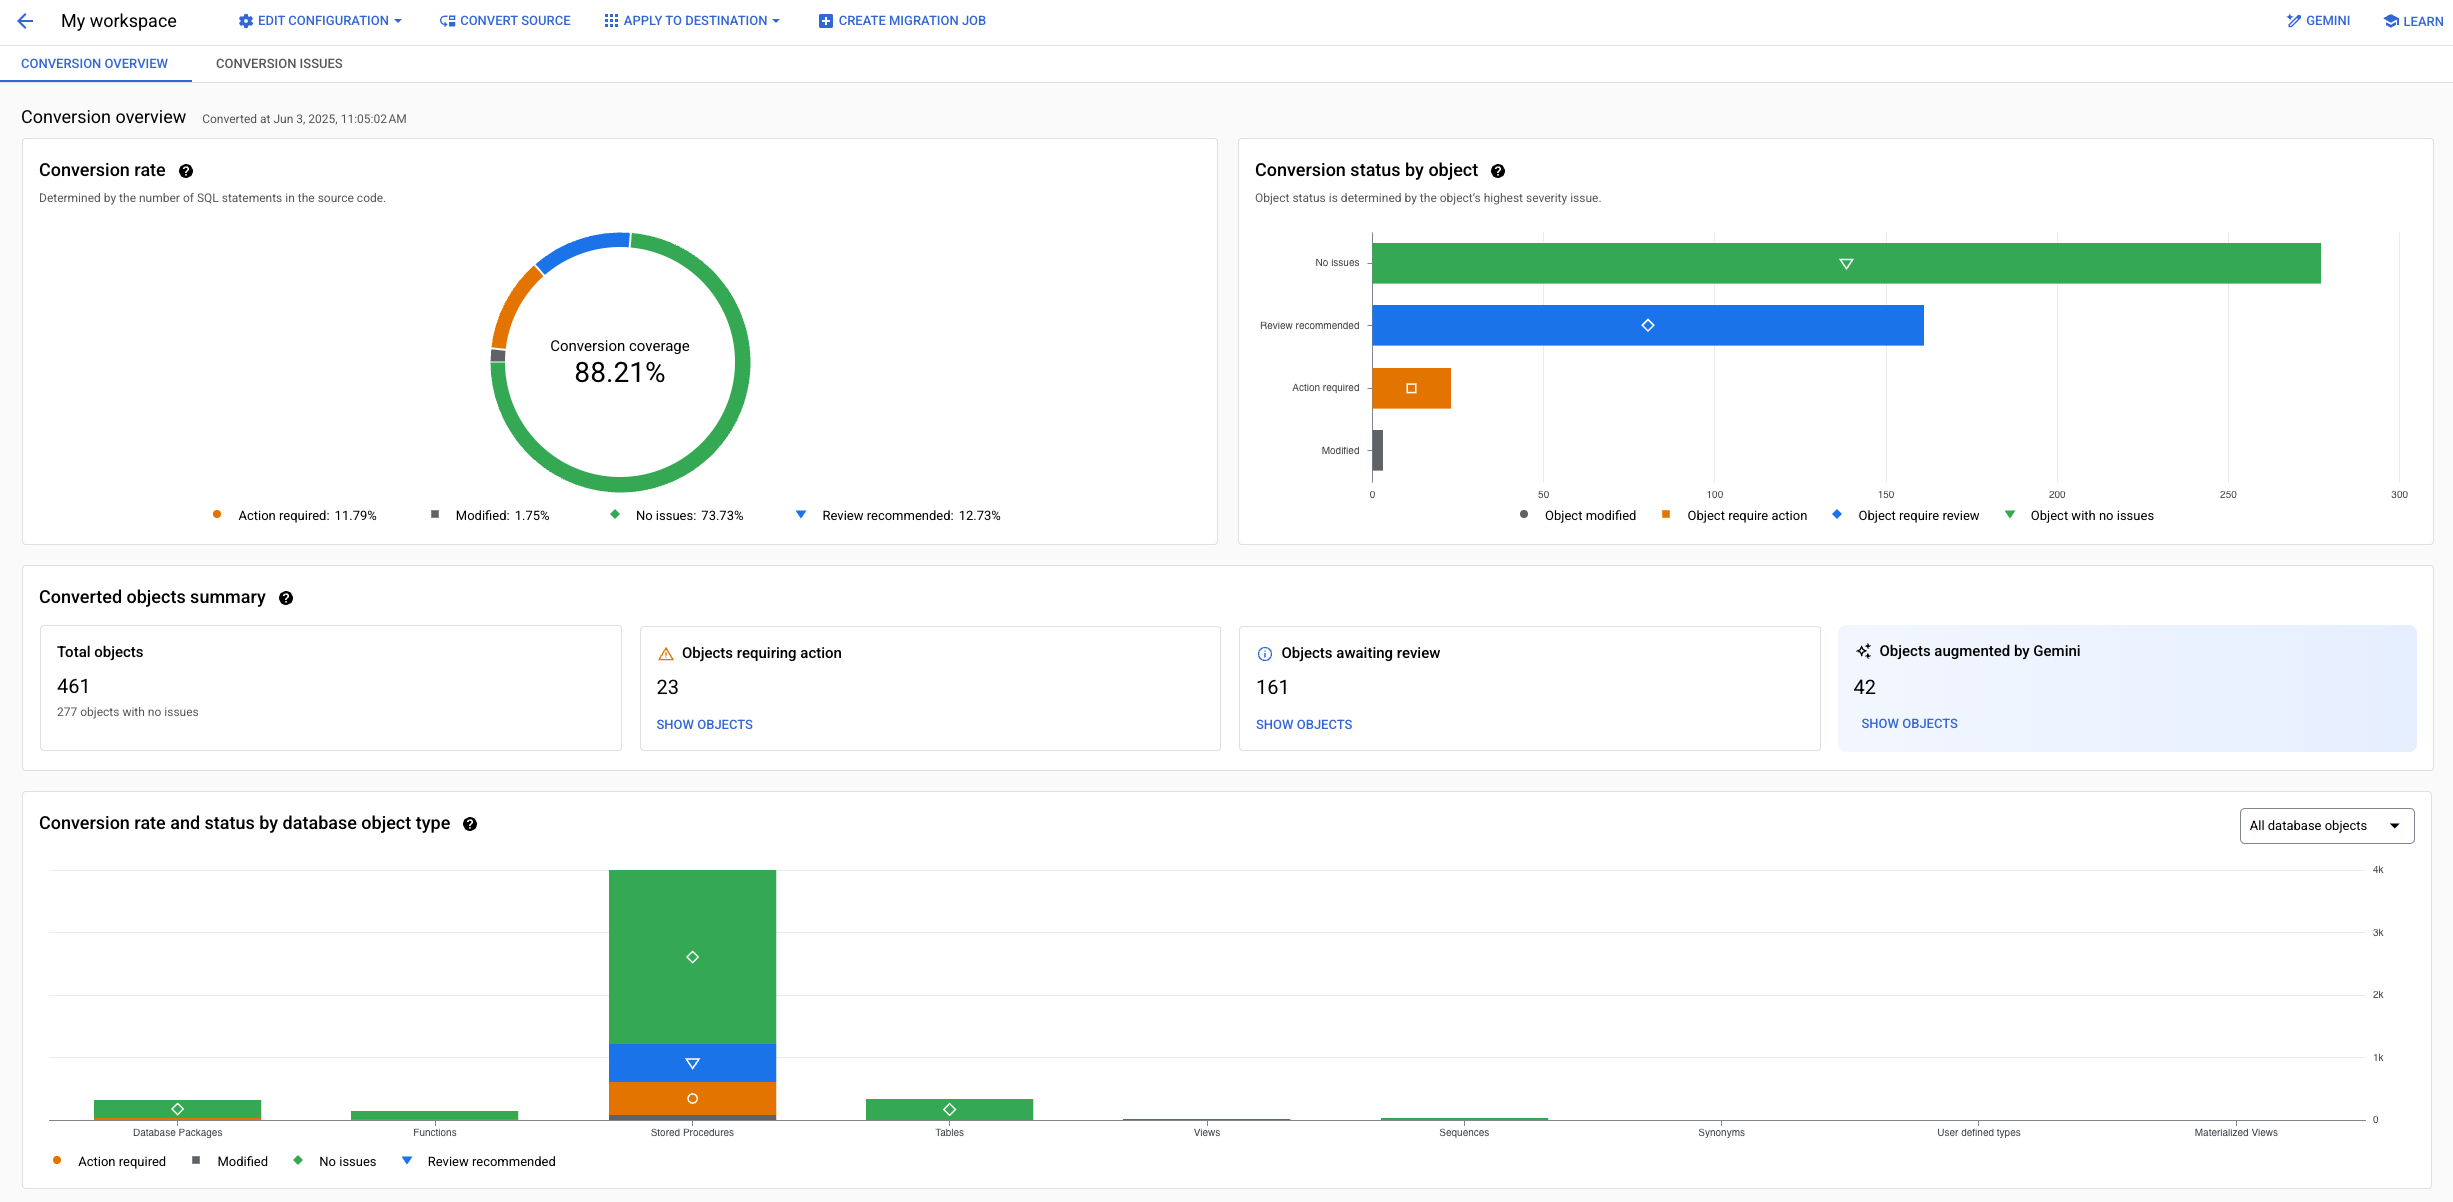
Cette vue vous permet de filtrer les objets de votre schéma par type, gravité du problème, actions requises ou état de conversion.

Pour en savoir plus sur l'utilisation des aperçus de conversion pour inspecter les résultats de conversion, consultez Utiliser des espaces de travail de conversion.
Conversion déterministe du code et du schéma
Lorsque vous créez un espace de travail de conversion, Database Migration Service effectue immédiatement la conversion de schéma initiale à l'aide d'un ensemble de règles de conversion déterministes, où des types de données et des objets Oracle spécifiques sont mappés à des types de données et des objets PostgreSQL spécifiques. Ce processus est compatible avec un sous-ensemble très spécifique d'objets de base de données Oracle disponibles.
La conversion de code déterministe est compatible avec les objets de base de données Oracle suivants :
Éléments de schéma Oracle compatibles
- Contraintes
- Index (uniquement les index créés dans le même schéma que leur table)
- Vues matérialisées
- Types d'objets (compatibilité partielle)
- Séquences
- Synonymes
- Tables
- Vues
Éléments de code Oracle compatibles
- Déclencheurs (au niveau de la table uniquement)
- Packages
- Fonctions
- Procédures stockées
Éditeur SQL interactif
L'éditeur SQL interactif vous permet de modifier la syntaxe PostgreSQL convertie directement dans Database Migration Service. Vous pouvez l'utiliser pour résoudre les problèmes de conversion ou ajuster le schéma pour mieux l'adapter à vos besoins. Certains objets ne peuvent pas être modifiés dans l'éditeur intégré.
Objets Oracle modifiables
Après avoir converti le code et le schéma de la base de données source, vous pouvez utiliser l'éditeur interactif pour modifier le code SQL généré pour certains types d'objets. Les objets Oracle suivants sont compatibles avec l'éditeur :
- Déclencheurs de table (autorisation requise)
- Vues matérialisées
- Packages
- Fonctions, procédures stockées
- Synonymes
- Vues
- Contraintes
- Index
- Séquences
De plus, certains objets sont convertis, mais ne peuvent pas être modifiés directement dans Database Migration Service. Pour modifier ces objets, vous devez effectuer les mises à jour directement sur la base de données de destination après avoir appliqué le schéma et le code convertis.
Objets ne pouvant pas être modifiés :
- Types d'objets définis par l'utilisateur
- Tables
- Schémas
Accélérer la conversion du code et des schémas avec Gemini
Database Migration Service intègre Gemini pour Google Cloud dans les espaces de travail de conversion pour vous aider à accélérer et à améliorer le processus de conversion dans les domaines suivants :
Améliorez les résultats de la conversion déterministe avec la conversion automatique optimisée par Gemini pour utiliser la puissance de l'IA afin de réduire considérablement le nombre d'ajustements manuels nécessaires dans votre code PostgreSQL.
Assurez la qualité et l'équivalence fonctionnelle de votre code converti grâce aux évaluations de qualité optimisées par Gemini. Ces évaluations analysent le code converti et fournissent des commentaires sur son exactitude et ses fonctionnalités par rapport au code source.
Fournir des fonctionnalités d'explicabilité du code avec l'assistant de conversion : un ensemble de prompts dédiés qui peuvent vous aider à mieux comprendre la logique de conversion, à proposer des correctifs pour les problèmes de conversion ou à optimiser le code converti.
Accélérez l'application de correctifs pour les problèmes de conversion grâce aux suggestions de conversion de code de Gemini : un mécanisme qui permet au modèle Gemini d'apprendre à mesure que vous corrigez les problèmes de conversion et de suggérer des modifications pour d'autres objets défectueux dans l'espace de travail.
Pour en savoir plus sur la conversion optimisée par Gemini, consultez les pages suivantes :
Convertir le code et les schémas Oracle avec l'aide de Gemini
Évaluer le code avec les évaluations de la qualité de Gemini
Exemple de workflow pour corriger les objets de code présentant des problèmes de conversion
Fichiers de mise en correspondance des conversions
Vous pouvez personnaliser la logique de conversion à l'aide d'un fichier de mappage de conversion. Le fichier de mappage de conversion est un fichier texte contenant des instructions précises (appelées instructions de conversion) sur la manière dont vos objets Oracle doivent être convertis en objets PostgreSQL.
Directives de conversion compatibles
Database Migration Service accepte les directives de conversion suivantes pour les fichiers de mappage de conversion :
EXPORT_SCHEMA
EXPORT_SCHEMA est une directive obligatoire pour tous les fichiers de mappage de conversion. Database Migration Service nécessite cette instruction pour s'assurer que vos schémas sources sont convertis en schémas de destination corrects.
Assurez-vous que vos fichiers de mappage de conversion incluent cette ligne :
EXPORT_SCHEMA 1
SCHEMA
Database Migration Service doit pouvoir déterminer quel schéma contient les objets à modifier avec vos instructions de conversion.
La directive SCHEMA entraîne l'application de toutes les autres directives de personnalisation fournies dans votre fichier aux objets de ce schéma particulier.
- Lorsque vous utilisez cette directive, les autres schémas contenus dans votre base de données sont également convertis, mais leurs objets ne sont soumis à aucune modification.
- Si vous incluez cette directive dans le fichier de mappage de conversion, toutes les personnalisations ne sont appliquées qu'aux objets contenus dans ce schéma spécifique.
- Si vous ignorez cette directive, vous devez fournir des noms d'objets complets incluant le nom de schéma des objets modifiés par d'autres directives de conversion.
Par exemple, au lieu d'utiliser
SOURCE_TABLE_NAMEpour la directiveREPLACE_TABLES, vous devez utiliser"SCHEMA_NAME.SOURCE_TABLE_NAME". - Pour personnaliser des objets dans différents schémas, procédez comme suit :
- Créez des fichiers de mappage de conversion distincts pour les autres schémas, puis importez-les dans l'espace de travail de conversion.
- Utilisez des noms d'objets complets incluant le nom du schéma pour les objets qui résident dans des schémas différents de celui que vous fournissez à la directive
SCHEMA.
Utilisez le format suivant :
SCHEMA SCHEMA_NAME
Où SCHEMA_NAME est le nom de votre schéma dans la base de données source.
CASE_HANDLING
Par défaut, Database Migration Service convertit tous les noms d'objets en minuscules.
Vous pouvez utiliser l'instruction CASE_HANDLING pour modifier ce comportement.
- Cette directive n'est pas affectée par la directive
SCHEMA. Il fonctionne de manière globale et affecte tous les objets de l'espace de travail de conversion. - Les directives
RENAME_*,MOVE_*etREPLACE_*sont prioritaires sur la directiveCASE_HANDLINGet renomment vos objets exactement, quelle que soit la propriétéCASE_HANDLING. - Si cette directive existe dans plusieurs fichiers de configuration avec des valeurs en conflit, Database Migration Service génère une erreur lors de l'importation du schéma.
Utilisez le format suivant :
CASE_HANDLING OPTION
Où OPTION peut avoir l'une des valeurs suivantes :
UPPERCASE: convertit tous les noms d'objets en majuscules.LOWERCASE: convertit tous les noms d'objets en minuscules (comportement par défaut).PRESERVE_ORIGINAL: conserve la casse d'origine du schéma source. Cette option est utile si vos applications utilisent des identifiants sensibles à la casse.
Exemple :
CASE_HANDLING PRESERVE_ORIGINAL
GENERATE_MISSING_PK
Les tables sans clé primaire ne garantissent pas une réplication cohérente. Database Migration Service ne migre que les tables qui possèdent des clés primaires. Par défaut, les espaces de travail de conversion Database Migration Service créent automatiquement les clés primaires manquantes dans les tables de destination lorsque vous convertissez votre code source et votre schéma.
Vous pouvez contrôler la génération automatique de clés primaires avec l'instruction GENERATE_MISSING_PK. Pour désactiver la génération automatique de clés, définissez cette directive sur 0.
Exemple :
GENERATE_MISSING_PK 0
Cette directive affecte tous les objets d'un espace de travail de conversion spécifique. Il n'est pas possible de désactiver la génération automatique de clés primaires uniquement pour une table spécifique.
Database Migration Service ne peut migrer que les tables qui ont des contraintes de clé primaire dans leurs versions PostgreSQL converties. Si vous désactivez la génération automatique de clés primaires, vous devez créer manuellement des clés primaires ou des contraintes uniques dans les tables converties de la base de données de destination après avoir appliqué le schéma converti. Développez les sections suivantes pour obtenir des exemples de commandes SQL.
Créer des clés primaires à l'aide de colonnes existantes
Votre table possède peut-être déjà une clé primaire logique basée sur une colonne ou une combinaison de colonnes. Par exemple, il peut y avoir des colonnes avec une contrainte ou un index uniques configurés. Utilisez ces colonnes pour générer une nouvelle clé primaire pour les tables de votre base de données source. Exemple :
ALTER TABLE TABLE_NAME
ADD PRIMARY KEY (COLUMN_NAME);
Créer une clé primaire à l'aide de toutes les colonnes
Si vous ne disposez pas d'une contrainte préexistante pouvant servir de clé primaire, créez des clés primaires à l'aide de toutes les colonnes de la table. Assurez-vous de ne pas dépasser la longueur maximale de la clé primaire autorisée par votre cluster PostgreSQL. Exemple :
ALTER TABLE TABLE_NAME
ADD PRIMARY KEY (COLUMN_NAME_1, COLUMN_NAME_2, COLUMN_NAME_3, ...);
Lorsque vous créez une clé primaire composite de ce type, vous devez lister explicitement tous les noms de colonnes que vous souhaitez utiliser. Il n'est pas possible d'utiliser une instruction pour récupérer tous les noms de colonnes à cette fin.
Créer une contrainte unique avec la pseudo-colonne ROWID
Les bases de données Oracle utilisent la
pseudocolonne ROWID pour stocker l'emplacement de chaque ligne d'une table. Pour migrer des tables Oracle sans clé primaire, vous pouvez ajouter une colonne ROWID dans la base de données PostgreSQL de destination. Database Migration Service remplit la colonne avec les valeurs numériques correspondantes de la pseudo-colonne Oracle ROWID source.
Pour ajouter la colonne et la définir comme clé primaire, exécutez la commande suivante :
ALTER TABLE TABLE_NAME ADD COLUMN rowid numeric(33,0) NOT NULL;
CREATE SEQUENCE TABLE_NAME_rowid_seq INCREMENT BY -1 START WITH -1 OWNED BY TABLE_NAME.rowid;
ALTER TABLE TABLE_NAME ALTER COLUMN rowid SET DEFAULT nextval('TABLE_NAME_rowid_seq');
ALTER TABLE TABLE_NAME ADD CONSTRAINT CONSTRAINT_DISPLAY_NAME PRIMARY KEY (rowid);
Renommer des objets (RENAME_*)
Vous pouvez renommer différents objets de base de données lors de la conversion. Database Migration Service met automatiquement à jour toutes les références de code (dans les vues, les procédures stockées, les fonctions, etc.) pour utiliser les nouveaux noms.
Syntaxe générale
RENAME_OBJECT_TYPE SOURCE_NAME1:DESTINATION_NAME1 SOURCE_NAME2:DESTINATION_NAME2 ...
Remarques importantes
-
Les directives
RENAME_*sont sensibles à la casse pour le nom de l'objet de destination et prévalent sur la directiveCASE_HANDLING. Par exemple, si vous utilisez les deux directives :SCHEMA MySchema CASE_HANDLING PRESERVE_ORIGINAL # Destination objects are renamed exactly # to 'SoMe_tAbLe' and 'RenamedView', respecting the case # despite the CASE_HANDLING directive RENAME_TABLES some_table:SoMe_tAbLe RENAME_VIEWS MyView:RenamedView
-
Pour
SOURCE_NAME, faites toujours référence au nom de l'objet d'origine, même si vous utilisez d'autres directives telles queMOVE_*. Par exemple, si vous souhaitez renommer l'un de vos objets de vue et le déplacer vers un nouveau schéma, reportez-vous au nom de la vue d'origine pour les deux directives :RENAME_VIEWS MyView:MyRenamedView MOVE_VIEWS MyView:MyOtherSchema
- La directive
RENAME_TABLESremplace la directiveREPLACE_TABLESdans un seul fichier. Si vous souhaitez renommer et déplacer une table, nous vous recommandons d'utiliser la directiveMOVE_*à la place. -
Le format complet de la variable
SOURCE_NAMEdépend de l'utilisation ou non de la directiveSCHEMA:- Avec la directive
SCHEMA: utilisez des noms non qualifiés, par exempleMyTable. - Sans la directive
SCHEMA: Utilisez des noms entièrement qualifiés, par exempleMySchema.MyTable.
- Avec la directive
Directives RENAME_* acceptées
RENAME_SCHEMA: renomme un schéma.
Un fichier de configuration ne peut contenir qu'une seule directiveRENAME_SCHEMA. Si l'instructionSCHEMAest fournie,RENAME_SCHEMAne peut renommer que ce schéma particulier.RENAME_TABLES: renomme les tables. Remplace l'élémentREPLACE_TABLESdans le même fichier.RENAME_COLUMNS: renomme les colonnes des tables. Remplace la directiveREPLACE_COLSdans le même fichier. Utilisez le format suivant :RENAME_COLUMNS TABLE1.SRC_COL:DEST_COL TABLE2.SRC_COL:DEST_COL
Si vous utilisez la directive
SCHEMA, utilisez des noms de table non qualifiés. Si vous n'utilisez pas la directiveSCHEMA, incluez les noms de table complets, par exemple SCHEMA.TABLE1.RENAME_VIEWSRENAME_MATERIALIZED_VIEWSRENAME_SEQUENCESRENAME_FUNCTIONSRENAME_STORED_PROCEDURESRENAME_TRIGGERS-
RENAME_PACKAGES: Database Migration Service convertit les packages Oracle en schémas PostgreSQL. Si votre schéma contient des packages qui partagent des noms, le code PostgreSQL peut rencontrer des conflits de noms lorsqu'il tente de créer deux schémas portant le même nom. Vous pouvez utiliser cette directive pour éviter de tels conflits.Par exemple, si vous avez des packages tels que
SALES.REPORTING_PKGetHR.REPORTING_PKG, vous pouvez les renommer avec des noms distincts :RENAME_PACKAGES SALES.UTILS:SALES_UTILS RENAME_PACKAGES HR.UTILS:HR_UTILS
RENAME_USER_DEFINED_TYPESAlias disponible :
RENAME_UDTS.
Objets en mouvement (MOVE_*)
Vous pouvez déplacer des objets vers différents schémas dans la base de données de destination. Cela est utile pour réorganiser la structure de votre base de données pendant la migration. Database Migration Service met automatiquement à jour toutes les références de code dans les vues, les procédures stockées, les fonctions, etc.
Syntaxe générale
MOVE_OBJECT_TYPE SOURCE_NAME1:DESTINATION_SCHEMA1 SOURCE_NAME2:DESTINATION_SCHEMA2 ...
Remarques importantes
-
Pour
SOURCE_NAME, faites toujours référence au nom de l'objet d'origine, même si vous utilisez d'autres directives telles queRENAME_*. Par exemple, si vous souhaitez renommer l'un de vos objets de vue et le déplacer vers un nouveau schéma, reportez-vous au nom de la vue d'origine pour les deux directives :RENAME_VIEWS MyView:MyRenamedView MOVE_VIEWS MyView:MyOtherSchema
- La directive n'attend que le nom de l'objet
DESTINATION_SCHEMA, et non le nom complet de l'objet. -
Le format complet de la variable
SOURCE_NAMEdépend de l'utilisation ou non de la directiveSCHEMA:- Avec la directive
SCHEMA: utilisez des noms non qualifiés, par exempleMyTable. - Sans la directive
SCHEMA: utilisez des noms complets, par exempleMySchema.MyTable.
- Avec la directive
Directives MOVE_* acceptées
MOVE_TABLES: déplace les tables vers un autre schéma. Prend le pas surREPLACE_TABLESpour les modifications de schéma dans un seul fichier de configuration.MOVE_VIEWSMOVE_MATERIALIZED_VIEWSMOVE_SEQUENCESMOVE_FUNCTIONSMOVE_STORED_PROCEDURESMOVE_USER_DEFINED_TYPESAlias disponible :
MOVE_UDTS.
Exemple : Réorganiser des schémas
SCHEMA LegacyApp

# Moves the 'LegacyApp.Users' and 'LegacyApp.Orders' tables
# to the 'data' schema.
MOVE_TABLES Users:data Orders:data

# Moves the 'LegacyApp.CreateUser' and 'LegacyApp.ProcessOrder'
# stored procedures to the 'api' schema
MOVE_STORED_PROCEDURES CreateUser:api ProcessOrder:api

# Moves the 'LegacyApp.SalesSummary' views to the 'reporting' schema
MOVE_VIEWS SalesSummary:reporting
DATA_TYPE
Vous pouvez utiliser cette directive pour mapper explicitement n'importe quel type de données compatible entre la syntaxe Oracle et la syntaxe PostgreSQL. Cette directive attend une liste de mappages séparés par des virgules. La définition complète doit être fournie sur une seule ligne, mais vous pouvez inclure plusieurs directives DATA_TYPE dans votre fichier de configuration. Utilisez le format suivant :
DATA_TYPE ORACLE_DATA_TYPE1:PGSQL_DATA_TYPE1
DATA_TYPE ORACLE_DATA_TYPE2:PGSQL_DATA_TYPE2...
Où ORACLE_DATA_TYPE et PGSQL_DATA_TYPE sont des types de données compatibles avec leurs versions Oracle et PostgreSQL respectives que vous utilisez dans votre migration. Pour en savoir plus sur les versions compatibles, consultez la section Présentation du scénario.
Exemple :
DATA_TYPE REAL:double precision,SMALLINT:integer
Pour en savoir plus sur les types de données Oracle et PostgreSQL, consultez les pages suivantes :
- Types de données Oracle dans la documentation Oracle.
- Types de données PostgreSQL dans la documentation PostgreSQL.
MODIFY_TYPE
La directive MODIFY_TYPE vous permet de contrôler le type de données vers lequel Database Migration Service convertit une colonne spécifique de votre table source.
Cette directive attend une liste de mappages séparés par des virgules.
La définition complète doit être fournie sur une seule ligne, mais vous incluez plusieurs directives MODIFY_TYPE dans votre fichier de configuration.
Utilisez le format suivant :
MODIFY_TYPE SOURCE_TABLE_NAME1:COLUMN_NAME:EXPECTED_END_RESULT_DATA_TYPE
MODIFY_TYPE SOURCE_TABLE_NAME2:COLUMN_NAME:EXPECTED_END_RESULT_DATA_TYPE...
Où :
- SOURCE_TABLE_NAME est le nom de la table contenant la colonne dont vous souhaitez modifier le type de données.
- COLUMN_NAME est le nom de la colonne pour laquelle vous souhaitez personnaliser le mappage de conversion.
- EXPECTED_END_RESULT_DATA_TYPE est le type de données PostgreSQL que vous souhaitez que la colonne convertie utilise.
Exemple :
MODIFY_TYPE events:dates_and_times:DATETIME,users:pseudonym:TEXT
PG_INTEGER_TYPE
Par défaut,Database Migration Service convertit les types NUMBER(p,s) en type PostgreSQL DECIMAL(p,s).
Vous pouvez modifier ce comportement avec la directive PG_INTEGER_TYPE. Définissez sa valeur sur 1 et forcez la conversion de tous vos types NUMBER avec précision et échelle (NUMBER(p,s)) en types PostgreSQL smallint, integer ou bigint en fonction du nombre de chiffres de précision.
Incluez le paramètre suivant dans votre fichier de mappage des conversions :
PG_INTEGER_TYPE 1
PG_NUMERIC_TYPE
Définissez cette directive sur 1 si vous souhaitez convertir tous vos types NUMBER avec précision et échelle (NUMBER(p,s)) en types PostgreSQL real ou float (en fonction de leur nombre de chiffres de précision).
Si vous définissez cette directive sur 0, vos valeurs NUMBER(p,s) conservent leur valeur d'origine exacte et utilisent le type de données PostgreSQL interne.
Incluez le paramètre suivant dans votre fichier de mappage des conversions :
PG_NUMERIC_TYPE 1
DEFAULT_NUMERIC
La conversion par défaut pour les NUMBER sans précision change selon que vous utilisez ou non la
directive PG_INTEGER_TYPE :
- Si vous utilisez l'instruction
PG_INTEGER, lesNUMBERsans précision sont convertis en valeursDECIMAL. - Si vous n'utilisez pas la directive
PG_INTEGER, lesNUMBERsans précision sont convertis en valeursBIGINT.
Vous pouvez modifier ce comportement et utiliser la directive DEFAULT_NUMERIC pour spécifier le type de données à utiliser pour les types NUMBER sans points de précision spécifiés.
Utilisez le format suivant :
DEFAULT_NUMERIC POSTGRESQL_NUMERIC_DATA_TYPE
Où POSTGRESQL_NUMERIC_DATA_TYPE est l'un des éléments suivants : integer, smallint, bigint.
Exemple :
DEFAULT_NUMERIC integer
REPLACE_COLS
Vous pouvez utiliser l'instruction REPLACE_COLS pour renommer des colonnes dans votre schéma converti. Cette directive attend une liste de mappages séparés par des virgules.
Utilisez le format suivant :
REPLACE_COLS SOURCE_TABLE_NAME1(SOURCE1_TABLE1_COLUMN_NAME1:DESTINATION_TABLE1_COLUMN_NAME1,SOURCE_TABLE1_COLUMN_NAME2:DESTINATION_TABLE1_COLUMN_NAME2),SOURCE_TABLE_NAME2(SOURCE_TABLE2_COLUMN_NAME1:DESTINATION_TABLE2_COLUMN_NAME1,SOURCE_TABLE2_COLUMN_NAME2:DESTINATION_TABLE2_COLUMN_NAME2)...
Où :
- SOURCE_TABLE_NAME est le nom de la table contenant la colonne que vous souhaitez renommer. Si vous n'utilisez pas la directive SCHEMA, veillez à utiliser le nom complet de la table :
SCHEMA_NAME.SOURCE_TABLE_NAME. - SOURCE_COLUMN_NAME est le nom de la colonne de votre source que vous souhaitez modifier.
- DESTINATION_COLUMN_NAME est le nouveau nom de la colonne que vous souhaitez utiliser dans le schéma converti.
Exemple :
REPLACE_COLS events(dates_and_times:event_dates),users(pseudonym:nickname)
REPLACE_TABLES
Vous pouvez utiliser l'instruction REPLACE_TABLES pour renommer des tables ou les déplacer vers un nouveau schéma. Cette directive attend une liste de mappages séparés par des espaces. Pour en savoir plus sur la syntaxe de chaque cas d'utilisation, développez les sections suivantes.
Si vous n'utilisez pas la directive SCHEMA, veillez à utiliser les noms de table complets entre guillemets pour les variables source et de destination :
"SCHEMA_NAME.SOURCE_TABLE_NAME""SCHEMA_NAME.DESTINATION_TABLE_NAME"
Renommer des tables
Pour renommer des tables dans votre schéma converti, utilisez le format suivant :
REPLACE_TABLES SOURCE_TABLE_NAME1:DESTINATION_TABLE_NAME1 SOURCE_TABLE_NAME2:DESTINATION_TABLE_NAME2
Où :
- SOURCE_TABLE_NAME est le nom de la table source que vous souhaitez renommer dans le schéma converti.
- DESTINATION_TABLE_NAME est le nouveau nom de la table que vous souhaitez utiliser dans le schéma converti.
Exemple :
REPLACE_TABLES "events:login_events" "users:platform_users"
Déplacer des tables entre des schémas
Vous pouvez utiliser cette directive pour déplacer des tables entre des schémas en ajoutant le préfixe du schéma au nouveau nom de la table. Ce mécanisme peut être utilisé, quelle que soit la manière dont vous utilisez l'instruction SCHEMA pour l'ensemble du fichier de conversion. Exemple :
REPLACE_TABLES "events:NEW_SCHEMA_NAME.login_events"
Alias pour personnaliser les types de données
Lorsque vous utilisez des instructions de conversion pour modifier la façon dont Database Migration Service convertit différents types de données (par exemple, avec les instructions
DATA_TYPE,
MODIFY_TYPE ou
PG_NUMERIC_TYPE), vous pouvez utiliser des alias au lieu de vos types de données SQL sources.
Développez la section suivante pour afficher la liste des alias de types de données compatibles avec Database Migration Service.
Alias de types de données
| Alias | Converti en type PostgreSQL |
|---|---|
bigint, int8 |
BIGINT |
bool, boolean |
BOOLEAN |
bytea |
BYTEA |
char, character |
CHAR |
character varying, varchar |
VARCHAR |
date |
DATE |
decimal, numeric |
DECIMAL |
double precision, float8 |
DOUBLE PRECISION |
real float4 |
REAL |
int, integer, int4 |
INTEGER |
int2 |
SMALLINT |
interval |
INTERVAL |
json |
JSON |
smallint |
SMALLINT |
text |
TEXT |
time |
TIME |
timestamp |
TIMESTAMP |
timestamptz |
TIMESTAMPTZ |
timetz |
TIMETZ |
uuid |
UUID |
XML |
XML |
Exemple de fichier de mappage de conversion
Consultez l'exemple de fichier de mappage de conversion suivant, qui utilise certaines des directives de conversion de schéma compatibles :
EXPORT_SCHEMA 1
SCHEMA root

# Preserve original casing for all objects
CASE_HANDLING PRESERVE_ORIGINAL

# Data type conversions
PG_NUMERIC_TYPE 0
PG_INTEGER_TYPE 1
DEFAULT_NUMERIC integer
DATA_TYPE NUMBER(4\,0):integer
MODIFY_TYPE events:dates_and_times:TIMESTAMP

# Renaming objects using the RENAME_* directives
# These allow case-sensitive destination names
RENAME_TABLES events:LoginEvents users:PlatformUsers
RENAME_COLUMNS events.dates_and_times:EventDates users.pseudonym:Nickname
RENAME_VIEWS InternalReport:FinInternalReport

# Moving objects to new schemas using the MOVE_* directives
MOVE_TABLES audit_log:archive
MOVE_VIEWS InternalReport:reporting
Les résultats de l'utilisation de ce fichier sont les suivants :
EXPORT_SCHEMA 1est une directive obligatoire.SCHEMA rootentraîne l'application des autres directives aux objets du schémaroot, sauf si des noms complets sont utilisés.CASE_HANDLING PRESERVE_ORIGINALgarantit que tous les noms d'objets du schémarootsource conservent leur casse d'origine dans la destination (sauf s'ils sont remplacés par une directiveRENAME_*).PG_INTEGER_TYPE 1permet à Database Migration Service de convertir tous les types de données numériques Oracle trouvés dans les tables du schémarooten types spécifiques à PostgreSQL au lieu de types numériques portables ANSI.DEFAULT_NUMERIC integeramène Database Migration Service à convertir les valeursNUMBERqui n'ont pas de point de précision spécifié en type PostgreSQLINTEGER.DATA_TYPE NUMBER(4\,0):integerforce Database Migration Service à convertir des valeursNUMBER(4,0)spécifiques enINTEGERPostgreSQL.- La directive
MODIFY_TYPE events:dates_and_times:TIMESTAMPindique à Database Migration Service de convertir les données de la colonnedates_and_timesde la table sourceeventsspécifiquement au type PostgreSQLTIMESTAMP. RENAME_TABLES events:LoginEvents users:PlatformUsersrenomme les tables en conservant la casse spécifiée :- La table
eventsest renomméeLoginEvents. - La table
usersest renomméePlatformUsers.
- La table
RENAME_COLUMNS events.dates_and_times:EventDates user.pseudonym:Nicknamerenomme les colonnes en conservant la casse spécifiée dans la destination :- Dans la table
LoginEvents(nom d'origine :events), la colonnedates_and_timesest renomméeEventDates. - Dans
PlatformUsers(nom d'origineusers), la colonnepseudonymest renomméeNickname.
- Dans la table
RENAME_VIEWS InternalReport:FinInternalReportrenomme la vueInternalReportenFinInternalReport.MOVE_TABLES audit_log:archivedéplace la tableaudit_logdu schémarootvers le schémaarchive.MOVE_VIEWS InternalReport:reportingdéplace la vueInternalReportvers le schémareporting. Cette vue est également renomméeFinInternalReporten raison de la directiveRENAME_VIEWS. Database Migration Service gère la dépendance : l'objet est d'abord renommé, puis déplacé.
Anciens espaces de travail de conversion
Les anciens espaces de travail de conversion sont un type d'espace de travail de conversion plus ancien et plus limité. Les anciens espaces de travail de conversion ne sont pas compatibles avec les fonctionnalités de conversion améliorées par Gemini ni avec l'éditeur SQL interactif. Vous ne pouvez les utiliser que pour convertir votre schéma source avec l'outil de migration Ora2Pg.
Nous vous déconseillons d'utiliser l'ancien type d'espace de travail de conversion pour vos migrations. Si votre scénario nécessite l'utilisation d'anciens espaces de travail de conversion, consultez Utiliser d'anciens espaces de travail de conversion.
Étapes suivantes
Pour en savoir plus sur l'utilisation des espaces de travail de conversion, consultez les pages suivantes :