


本頁面說明使用 MLTransform 功能的原因和方法,協助您準備資料,用於訓練機器學習 (ML) 模型。具體來說,本頁面說明如何使用 MLTransform 生成嵌入,藉此處理資料。
只要在一個類別中合併多個資料處理轉換,MLTransform 就能簡化將 Apache Beam ML 資料處理作業套用至工作流程的程序。
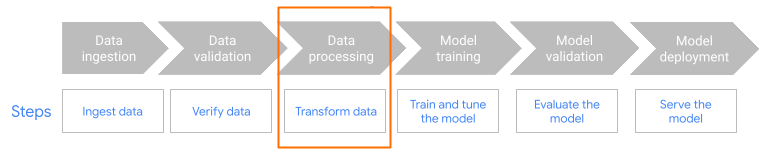
MLTransform。嵌入總覽
嵌入功能是現代語意搜尋和檢索增強生成 (RAG) 應用程式不可或缺的一環。嵌入可讓系統在更深層的概念層級理解資訊並與之互動。在語意搜尋中,嵌入會將查詢和文件轉換為向量表示法。這些表示法可擷取其潛在意義和關係。因此,即使關鍵字不直接相符,您也能找到相關結果。這項技術大幅超越標準的關鍵字搜尋。您也可以使用嵌入功能推薦產品。包括使用圖片和文字的多模態搜尋、記錄分析,以及簡化等工作。
在 RAG 中,嵌入扮演著重要角色,可從知識庫中檢索最相關的情境,為大型語言模型 (LLM) 的回覆提供依據。RAG 系統會嵌入使用者的查詢和知識庫中的資訊片段,有效率地找出並擷取語意最相似的片段。這種語意比對可確保 LLM 能夠存取必要資訊,生成準確且實用的答案。
擷取及處理資料以建立嵌入

對於核心嵌入用途,考量重點是知識的擷取和處理方式。擷取方式可以是批次或串流。這類知識的來源可能大不相同。例如,這項資訊可能來自儲存在 Cloud Storage 的檔案,或來自 Pub/Sub 或 Google Cloud Managed Service for Apache Kafka 等串流來源。
如果是串流來源,資料本身可能是原始內容 (例如純文字),或指向文件的 URI。無論來源為何,第一階段通常涉及預先處理資訊。如果是原始文字,可能只需要進行基本資料清理等少量處理。不過,如果文件較大或內容較複雜,分塊就是關鍵步驟。分塊是指將來源資料拆解成易於管理的小型單元。最佳分塊策略並非標準化,而是取決於特定資料和應用程式。Dataflow 等平台提供內建功能,可處理各種分塊需求,簡化這項重要的預先處理階段。
優點
MLTransform 類別具有下列優點:
- 生成嵌入,用於將資料推送至向量資料庫或執行推論。
- 轉換資料,不必編寫複雜的程式碼或管理基礎程式庫。
- 透過單一介面有效率地鏈結多種處理作業。
支援與限制
MLTransform 類別有下列限制:
- 適用於使用 Apache Beam Python SDK 2.53.0 以上版本的管道。
- 管道必須使用預設視窗。
文字嵌入轉換:
- 支援 Python 3.8、3.9、3.10、3.11 和 3.12。
- 支援批次和串流管道。
- 支援 Gemini Enterprise Agent Platform 文字嵌入 API 和 Hugging Face Sentence Transformers 模組。
用途
範例筆記本會示範如何將 MLTransform 用於特定用途。
- 我想使用 Agent Platform Pipelines 為 LLM 生成文字嵌入
- 使用 Apache Beam
MLTransform類別和 Agent Platform Pipelines 文字嵌入 API,生成文字嵌入。文字嵌入是將文字表示為數值向量的方法,許多自然語言處理 (NLP) 任務都需要用到這項技術。 - 我想使用 Hugging Face 為 LLM 生成文字嵌入
- 搭配使用 Apache Beam
MLTransform類別和 Hugging Face Hub 模型,生成文字嵌入。Hugging FaceSentenceTransformers框架使用 Python 生成句子、文字和圖片嵌入。 - 我想生成文字嵌入,並擷取至 AlloyDB for PostgreSQL
- 使用 Apache Beam,特別是其
MLTransform類別和 Hugging Face Hub 模型,生成文字嵌入。接著,使用VectorDatabaseWriteTransform將這些嵌入和相關聯的中繼資料載入 AlloyDB for PostgreSQL。本筆記本示範如何建構可擴充的批次和串流 Beam 資料管道,將資料填入 AlloyDB for PostgreSQL 向量資料庫。包括處理 Pub/Sub 或現有資料庫資料表等各種來源的資料、建立自訂結構定義,以及更新資料。 - 我想生成文字嵌入並擷取至 BigQuery
- 搭配使用 Apache Beam
MLTransform類別和 Hugging Face Hub 模型,從應用程式資料 (例如產品目錄) 生成文字嵌入。Apache BeamHuggingfaceTextEmbeddings轉換就是用於這項作業。這項轉換作業使用 Hugging Face SentenceTransformers 框架,該框架提供生成句子和文字嵌入的模型。接著,系統會使用 Apache BeamVectorDatabaseWriteTransform,將這些生成的嵌入和中繼資料擷取至 BigQuery。筆記本也會進一步示範如何使用 Enrichment 轉換,在 BigQuery 中執行向量相似度搜尋。
如需可用轉換的完整清單,請參閱 Apache Beam 說明文件中的「轉換」。
使用 MLTransform 生成嵌入
如要使用 MLTransform 類別區塊資訊並生成嵌入,請在管道中加入下列程式碼:
  def create_chunk(product: Dict[str, Any]) -> Chunk:
    return Chunk(
        content=Content(
            text=f"{product['name']}: {product['description']}"
        ),
        id=product['id'],  # Use product ID as chunk ID
        metadata=product,  # Store all product info in metadata
    )

  [...]
  with beam.Pipeline() as p:
    _ = (
            p
            | 'Create Products' >> beam.Create(products)
            | 'Convert to Chunks' >> beam.Map(create_chunk)
            | 'Generate Embeddings' >> MLTransform(
  write_artifact_location=tempfile.mkdtemp())
  .with_transform(huggingface_embedder)
            | 'Write to AlloyDB' >> VectorDatabaseWriteTransform(alloydb_config)
        )
上述範例會為每個元素建立一個區塊,但您也可以使用 LangChain 建立區塊:
splitter = CharacterTextSplitter(chunk_size=100, chunk_overlap=20)
provider = beam.ml.rag.chunking.langchain.LangChainChunker(
document_field='content', metadata_fields=[], text_splitter=splitter)

with beam.Pipeline() as p:
_ = (
p
| 'Create Products' >> beam.io.textio.ReadFromText(products)
| 'Convert to Chunks' >> provider.get_ptransform_for_processing()
後續步驟
- 閱讀網誌文章「How to enable real time semantic search and RAG applications with Dataflow ML」(如何使用 Dataflow ML 啟用即時語意搜尋和 RAG 應用程式)。
- 如要進一步瞭解
MLTransform,請參閱 Apache Beam 說明文件中的「預先處理資料」。 - 如需更多範例,請參閱 Apache Beam 轉換目錄中的「
MLTransformfor 資料處理」。 - 在 Colab 中執行互動式筆記本。