


Questo documento descrive come implementare i 14 controlli chiave delle funzionalità di gestione dei dati cloud (CDMC) in un data warehouse BigQuery per proteggere e gestire i dati sensibili. Le organizzazioni eseguono il deployment di data warehouse cloud per archiviare informazioni sensibili per l'analisi aziendale, richiedendo una governance rigorosa e la conformità normativa.
Il framework CDMC Key Controls è stato pubblicato principalmente per i fornitori di servizi cloud e i fornitori di tecnologia. Il framework descrive 14 controlli chiave che i fornitori possono implementare per consentire ai propri clienti di gestire e governare in modo efficace i dati sensibili nel cloud. I controlli sono stati scritti dal gruppo di lavoro CDMC, con la partecipazione di oltre 300 professionisti di più di 100 aziende. Durante la stesura del framework, il gruppo di lavoro CDMC ha preso in considerazione molti dei requisiti legali e normativi esistenti.
Questa architettura di riferimento di BigQuery e Knowledge Catalog è stata valutata e certificata in base al CDMC Key Controls Framework come soluzione cloud certificata CDMC. L'architettura di riferimento utilizza vari servizi e funzionalitàGoogle Cloud , nonché librerie pubbliche per implementare i controlli chiave e l'automazione consigliata di CDMC. Questo documento spiega come implementare i controlli chiave per proteggere i dati sensibili in un data warehouse BigQuery.
Architettura
La seguente architettura di riferimento Google Cloud è in linea con le specifiche di test del framework Key Controls di CDMC v1.1.1. I numeri nel diagramma rappresentano i controlli chiave gestiti con i servizi Google Cloud .

L'architettura di riferimento si basa sul progetto base del data warehouse protetto, che fornisce un'architettura che ti aiuta a proteggere un data warehouse BigQuery che include informazioni sensibili. Nel diagramma precedente, i progetti nella parte superiore del diagramma (in grigio) fanno parte del progetto base per il data warehouse protetto. Il progetto di governance dei dati (in blu) include i servizi aggiunti per soddisfare i requisiti del framework CDMC Key Controls. Per implementare il framework dei controlli chiave CDMC, l'architettura estende il progetto di governance dei dati. Il progetto di governance dei dati fornisce controlli come classificazione, gestione del ciclo di vita e gestione della qualità dei dati. Il progetto fornisce anche un modo per controllare l'architettura e segnalare i risultati.
Per esempi di modelli di deployment e script di automazione, consulta l'implementazione di riferimento open source dell'Google Cloud architettura di riferimento CDMCarchiviata su GitHub.
Alternativa all'architettura: data mesh decentralizzato
L'architettura descritta in questo documento utilizza un progetto di governance dei dati centralizzato per monitorare e gestire un data warehouse BigQuery centralizzato. Se la tua organizzazione richiede un modello basato sul dominio, puoi implementare i 14 controlli chiave CDMC utilizzando un'architettura data mesh con governance federata. In questo modello, i singoli domini sono proprietari dei propri prodotti di dati, mentre le norme CDMC, gli standard di classificazione e i report di controllo sono gestiti in modo centralizzato.
Un'architettura data mesh consente di implementare i controlli chiave CDMC nel seguente modo:
- Raggruppa domini logici:utilizza data lake e zone dati per organizzare i dati in più Google Cloud progetti, set di dati BigQuery e bucket Cloud Storage in domini aziendali distinti senza spostare i dati. Per la tracciabilità e la catalogazione, utilizza Knowledge Catalog.
- Convalida la qualità dei dati:definisci e pianifica le scansioni automatiche della qualità dei dati di Knowledge Catalog per convalidare i contratti di dati senza fare affidamento su una pipeline di tagging centrale.
- Gestisci il ciclo di vita dei dati:configura la scadenza della partizione della tabella BigQuery, la scadenza della tabella e la gestione del ciclo di vita degli oggetti Cloud Storage sugli asset di dominio.
- Monitora la tracciabilità dei dati tra domini:utilizza la tracciabilità dei dati di Knowledge Catalog per monitorare lo spostamento e le trasformazioni dei dati tra i limiti di domini e progetti.
- Supporta ambienti ibridi e multi-cloud: utilizza BigQuery Omni per analizzare i dati sul posto.
Per implementare un data mesh aziendale che integri i controlli CDMC, consulta Implementare una piattaforma aziendale di gestione e analisi dei dati e il blueprint Terraform per il data mesh aziendale complementare. Questo progetto implementa un modello federato accoppiando ambienti di produzione e consumo di domini decentralizzati con un progetto di governance dei dati centrale in una cartella condivisa.
Panoramica del framework dei controlli chiave CDMC
La seguente tabella riepiloga il framework CDMC Key Controls.
| # | Controllo delle chiavi CDMC | Requisito di controllo CDMC |
|---|---|---|
| 1 | Conformità del controllo dati | I casi aziendali di gestione dei dati nel cloud sono definiti e regolamentati. Tutti gli asset di dati che contengono dati sensibili devono essere monitorati per verificare la conformità ai controlli chiave del CDMC, utilizzando metriche e notifiche automatiche. |
| 2 | La proprietà dei dati è stabilita sia per i dati migrati sia per quelli generati nel cloud | Il campo Proprietà in un catalogo di dati deve essere compilato per tutti i dati sensibili o altrimenti segnalato a un flusso di lavoro definito. |
| 3 | L'origine e il consumo dei dati sono regolati e supportati dall'automazione | Un registro delle origini dati autorevoli e dei punti di provisioning deve essere compilato per tutti gli asset di dati che contengono dati sensibili o che altrimenti devono essere segnalati a un workflow definito. |
| 4 | La sovranità dei dati e il trasferimento transfrontaliero dei dati vengono gestiti | La sovranità dei dati e il movimento transfrontaliero di dati sensibili devono essere registrati, controllati e controllati in base a criteri definiti. |
| 5 | I cataloghi di dati vengono implementati, utilizzati e sono interoperabili | La catalogazione deve essere automatizzata per tutti i dati al momento della creazione o dell'importazione, con coerenza in tutti gli ambienti. |
| 6 | Le classificazioni dei dati vengono definite e utilizzate | La classificazione deve essere automatizzata per tutti i dati al momento della
creazione o dell'importazione e deve essere sempre attiva. La classificazione è
automatica per i seguenti elementi:
|
| 7 | I diritti sui dati vengono gestiti, applicati e monitorati | Questo controllo richiede quanto segue:
|
| 8 | L'accesso, l'utilizzo e i risultati etici dei dati vengono gestiti | Lo scopo del consumo dei dati deve essere fornito per tutti gli accordi di condivisione dei dati che coinvolgono dati sensibili. Lo scopo deve specificare il tipo di dati richiesti e, per le organizzazioni globali, l'ambito del paese o della persona giuridica. |
| 9 | I dati sono protetti e i controlli sono documentati | Questo controllo richiede quanto segue:
|
| 10 | Un framework per la privacy dei dati è definito e operativo | Le valutazioni di impatto sulla protezione dei dati (DPIA) devono essere attivate automaticamente per tutti i dati personali in base alla giurisdizione. |
| 11 | Il ciclo di vita dei dati è pianificato e gestito | La conservazione, l'archiviazione e l'eliminazione dei dati devono essere gestite in base a un programma di conservazione definito. |
| 12 | La qualità dei dati è gestita | La misurazione della qualità dei dati deve essere attivata per i dati sensibili con metriche distribuite quando disponibili. |
| 13 | I principi di gestione dei costi sono stabiliti e applicati | I principi di progettazione tecnica sono stabiliti e applicati. Le metriche dei costi direttamente associate all'utilizzo, all'archiviazione e allo spostamento dei dati devono essere disponibili nel catalogo. |
| 14 | La provenienza e la tracciabilità dei dati sono comprese | Le informazioni sulla tracciabilità dei dati devono essere disponibili per tutti i dati sensibili. Queste informazioni devono includere almeno l'origine da cui sono stati importati i dati o in cui sono stati creati in un ambiente cloud. |
1. Conformità del controllo dati
Questo controllo richiede di verificare che tutti i dati sensibili vengano monitorati per la conformità a questo framework utilizzando le metriche.
L'architettura utilizza metriche che mostrano in che misura ciascuno dei controlli chiave è operativo. L'architettura include anche dashboard che indicano quando le metriche non soddisfano le soglie definite.
L'architettura include rilevatori che pubblicano risultati e consigli di correzione quando gli asset di dati non soddisfano un controllo chiave. Questi risultati e consigli sono in formato JSON e vengono pubblicati in un argomento Pub/Sub per la distribuzione agli abbonati. Puoi integrare gli strumenti di gestione dei servizi o il service desk interno con l'argomento Pub/Sub in modo che gli incidenti vengano creati automaticamente nel sistema di gestione dei ticket.
L'architettura utilizza Dataflow per creare un abbonato di esempio agli eventi dei risultati, che vengono poi archiviati in un'istanza BigQuery eseguita nel progetto di governance dei dati. Utilizzando una serie di visualizzazioni fornite, puoi eseguire query sui dati utilizzando BigQuery Studio nella console Google Cloud . Puoi anche creare report utilizzando Data Studio o altri strumenti di business intelligence compatibili con BigQuery. I report che puoi visualizzare includono:
- Riepilogo dei risultati dell'ultima esecuzione
- Dettagli dei risultati dell'ultima esecuzione
- Metadati dell'ultima esecuzione
- Asset di dati dell'ultima esecuzione nell'ambito
- Statistiche del set di dati dell'ultima esecuzione
Il seguente diagramma mostra i servizi a cui si applica questo controllo.

Per soddisfare i requisiti di questo controllo, l'architettura utilizza i seguenti servizi:
- Pub/Sub pubblica i risultati.
- Dataflow carica i risultati in un'istanza BigQuery.
- BigQuery archivia i dati dei risultati e fornisce viste riepilogative.
- Data Studio fornisce dashboard e report.
Lo screenshot seguente mostra un esempio di dashboard di riepilogo di Data Studio.
 Lo screenshot seguente mostra una visualizzazione di esempio dei risultati per asset di dati.

2. La proprietà dei dati viene stabilita sia per i dati migrati sia per quelli generati nel cloud
Per soddisfare i requisiti di questo controllo, l'architettura esamina automaticamente i dati nel data warehouse BigQuery e aggiunge tag di classificazione dei dati che indicano che i proprietari sono identificati per tutti i dati sensibili.
Knowledge Catalog gestisce due tipi di metadati: tecnici e aziendali. Per un determinato progetto, Knowledge Catalog cataloga automaticamente set di dati, tabelle e viste BigQuery e compila i metadati tecnici. La sincronizzazione tra il catalogo e gli asset di dati viene mantenuta quasi in tempo reale.
L'architettura utilizza Tag
Engine
per aggiungere i seguenti tag di metadati aziendali a un modello di tag CDMC controls in
Knowledge Catalog:
is_sensitive: indica se l'asset di dati contiene dati sensibili (vedi Controllo 6 per la classificazione dei dati)owner_name: il proprietario dei datiowner_email: l'indirizzo email del proprietario
I tag vengono compilati utilizzando i valori predefiniti archiviati in una tabella BigQuery di riferimento nel progetto di governance dei dati.
Per impostazione predefinita, l'architettura imposta i metadati di proprietà a livello di tabella, ma puoi modificare l'architettura in modo che i metadati vengano impostati a livello di colonna. Per maggiori informazioni, consulta Gestire gli aspetti e arricchire i metadati.
Il seguente diagramma mostra i servizi a cui si applica questo controllo.

Per soddisfare i requisiti di questo controllo, l'architettura utilizza i seguenti servizi:
- Due data warehouse BigQuery: uno archivia i dati riservati e l'altro archivia i valori predefiniti per la proprietà degli asset di dati.
- Knowledge Catalog archivia i metadati di proprietà tramite modelli di tag e tag.
- Due istanze Cloud Run, come segue:
- Un'istanza esegue Report Engine, che verifica se i tag sono applicati e pubblica i risultati.
- Un'altra istanza esegue Tag Engine, che tagga i dati nel data warehouse protetto.
- Pub/Sub pubblica i risultati.
Per rilevare problemi relativi a questo controllo, l'architettura verifica se ai dati sensibili è assegnato un tag con il nome del proprietario.
3. L'origine e il consumo dei dati sono regolati e supportati dall'automazione
Questo controllo richiede la classificazione degli asset di dati e un registro dei dati delle
origini autorevoli e dei distributori autorizzati. L'architettura utilizza
Knowledge Catalog per aggiungere il tag is_authoritative al
modello di tag CDMC controls. Questo tag definisce se l'asset di dati è
autorevole.
Knowledge Catalog cataloga set di dati, tabelle e viste BigQuery con metadati tecnici e aziendali.
I metadati tecnici vengono compilati automaticamente e includono l'URL della risorsa,
ovvero la posizione del punto di provisioning. I metadati aziendali sono definiti nel file di configurazione di Tag Engine e includono il tag is_authoritative.
Durante la successiva esecuzione pianificata, Tag Engine compila il tag is_authoritative
nel modello di tag CDMC controls con i valori predefiniti archiviati in una tabella di riferimento
in BigQuery.
Il seguente diagramma mostra i servizi a cui si applica questo controllo.
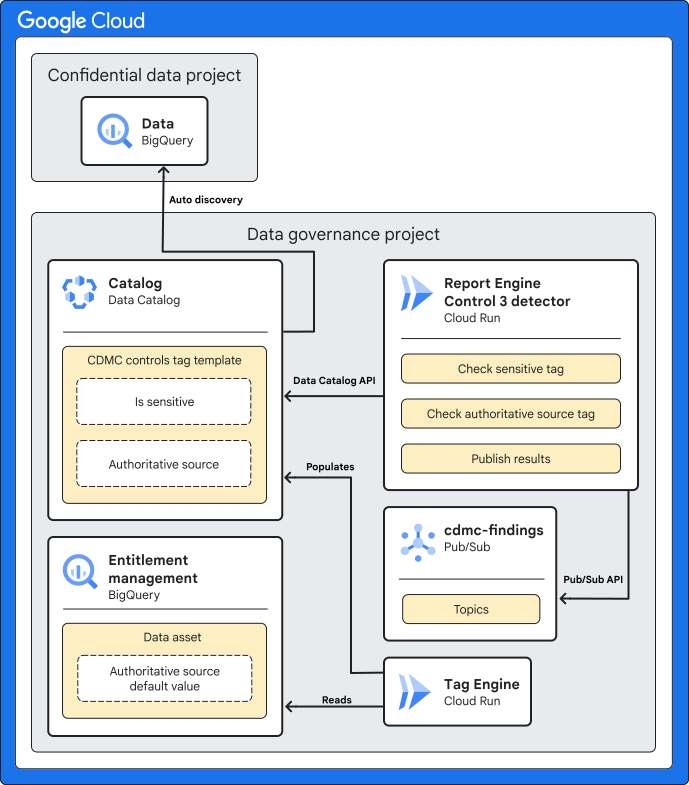
Per soddisfare i requisiti di questo controllo, l'architettura utilizza i seguenti servizi:
- Due data warehouse BigQuery: uno archivia i dati riservati e l'altro archivia i valori predefiniti per l'origine autorevole dell'asset di dati.
- Knowledge Catalog memorizza i metadati della sorgente autorevole tramite i tag.
- Due istanze Cloud Run, come segue:
- Un'istanza esegue Report Engine, che verifica se i tag sono applicati e pubblica i risultati.
- Un'altra istanza esegue Tag Engine, che tagga i dati nel data warehouse protetto.
- Pub/Sub pubblica i risultati.
Per rilevare problemi relativi a questo controllo, l'architettura verifica se ai dati sensibili è assegnato il tag di origine autorevole.
4. La sovranità dei dati e il trasferimento transfrontaliero dei dati vengono gestiti
Questo controllo richiede all'architettura di ispezionare il registro dei dati per i requisiti di archiviazione specifici per regione e applicare le regole di utilizzo. Un report descrive la posizione geografica degli asset di dati.
L'architettura utilizza Knowledge Catalog per aggiungere il tag approved_storage_location al modello di tag CDMC controls. Questo tag
definisce la posizione geografica in cui è consentito archiviare
l'asset di dati.
La posizione effettiva dei dati viene archiviata come metadati tecnici nei dettagli della tabella BigQuery. BigQuery non consente agli amministratori di modificare la posizione di un set di dati o di una tabella. Se gli amministratori vogliono modificare la posizione dei dati, devono copiare il set di dati.
Il vincolo del servizio di policy dell'organizzazione per le località delle risorse
definisce le Google Cloud regioni in cui puoi archiviare i dati. Per impostazione predefinita,
l'architettura imposta il vincolo sul progetto Dati confidenziali, ma puoi
impostarlo a livello di organizzazione o cartella, se preferisci. Tag
Engine replica le località consentite nel
modello di tag Knowledge Catalog e memorizza la località
nel tag approved_storage_location. Se attivi il livello Security Command Center Premium e qualcuno aggiorna il vincolo del criterio dell'organizzazione delle località delle risorse, Security Command Center genera risultati di vulnerabilità per le risorse archiviate al di fuori del criterio aggiornato.
Gestore contesto accesso definisce la posizione geografica in cui devono trovarsi gli utenti prima di poter accedere agli asset di dati. Utilizzando i livelli di accesso, puoi specificare da quali regioni possono provenire le richieste. Poi aggiungi il criterio di accesso al perimetro dei Controlli di servizio VPC per il progetto di dati riservati.
Per monitorare lo spostamento dei dati, BigQuery mantiene una traccia di audit completa per ogni job e query su ogni set di dati. La traccia di audit è archiviata nella vista BigQuery Information Schema Jobs.
Il seguente diagramma mostra i servizi a cui si applica questo controllo.
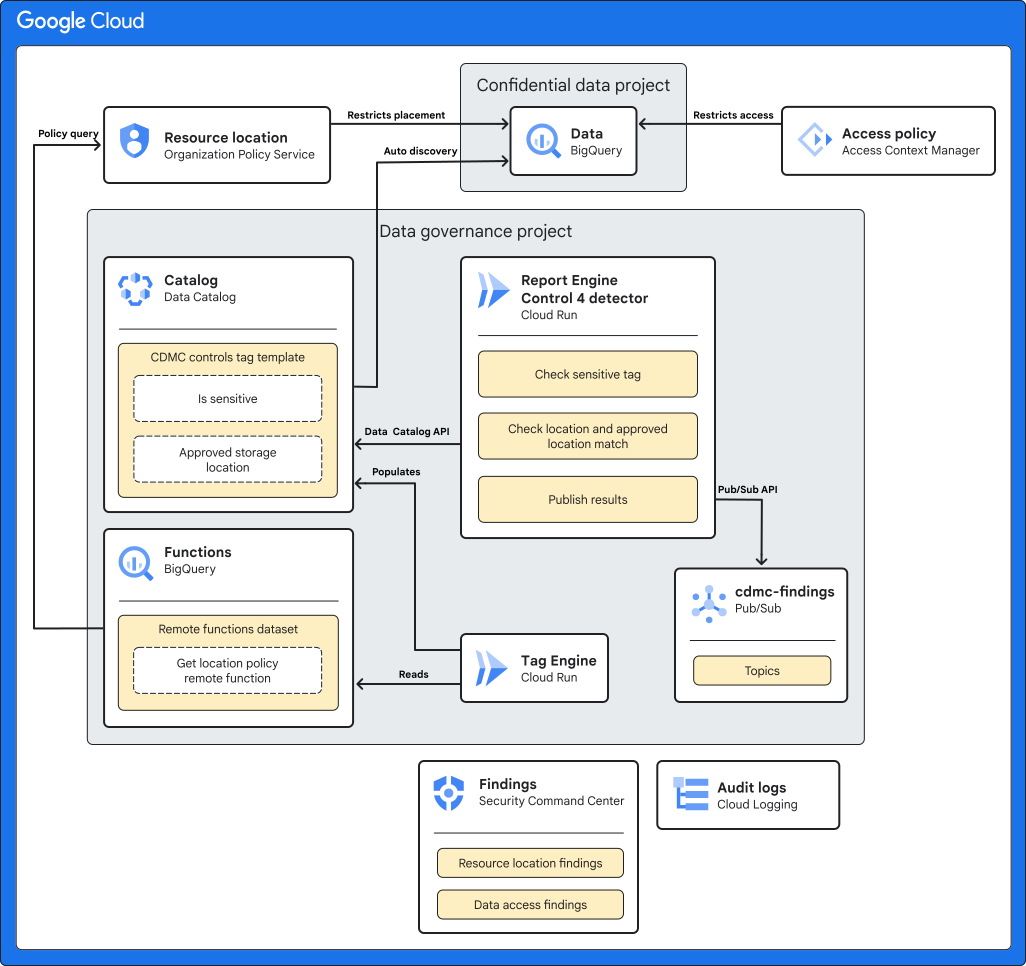
Per soddisfare i requisiti di questo controllo, l'architettura utilizza i seguenti servizi:
- Il criterio dell'organizzazione definisce e applica il vincolo delle località delle risorse.
- Gestore contesto accesso definisce le posizioni da cui gli utenti possono accedere ai dati.
- Due data warehouse BigQuery: uno archivia i dati riservati e l'altro ospita una funzione remota utilizzata per esaminare la norma relativa alla posizione.
- Knowledge Catalog memorizza le posizioni di archiviazione approvate come tag.
- Due istanze Cloud Run, come segue:
- Un'istanza esegue Report Engine, che verifica se i tag sono applicati e pubblica i risultati.
- Un'altra istanza esegue Tag Engine, che tagga i dati nel data warehouse protetto.
- Pub/Sub pubblica i risultati.
- Cloud Logging scrive gli audit log.
- Security Command Center segnala eventuali risultati relativi alla posizione delle risorse o all'accesso ai dati.
Per rilevare problemi relativi a questo controllo, l'architettura include un risultato per verificare se il tag delle località approvate include la posizione dei dati sensibili.
5. I cataloghi di dati vengono implementati, utilizzati e sono interoperabili
Questo controllo richiede l'esistenza di un catalogo dei dati e che l'architettura possa scansionare gli asset nuovi e aggiornati per aggiungere i metadati necessari.
Per soddisfare i requisiti di questo controllo, l'architettura utilizza Knowledge Catalog. Knowledge Catalog registra automaticamente Google Cloud gli asset, inclusi set di dati, tabelle e viste BigQuery. Quando crei una nuova tabella in BigQuery, Knowledge Catalog registra automaticamente i metadati tecnici e lo schema della nuova tabella. Quando aggiorni una tabella in BigQuery, Knowledge Catalog aggiorna le voci quasi istantaneamente.
Il seguente diagramma mostra i servizi a cui si applica questo controllo.

Per soddisfare i requisiti di questo controllo, l'architettura utilizza i seguenti servizi:
- Due data warehouse BigQuery: uno archivia i dati riservati e l'altro i dati non riservati.
- Knowledge Catalog archivia i metadati tecnici per tabelle e campi.
Per impostazione predefinita, in questa architettura Knowledge Catalog memorizza i metadati tecnici di BigQuery. Se necessario, puoi integrare Knowledge Catalog con altre origini dati.
6. Le classificazioni dei dati vengono definite e utilizzate
Questa valutazione richiede che i dati possano essere classificati in base alla loro sensibilità, ad esempio se sono PII, identificano i clienti o soddisfano un altro standard definito dalla tua organizzazione. Per soddisfare i requisiti di questo controllo, l'architettura crea un report delle risorse di dati e della loro sensibilità. Puoi utilizzare questo report per verificare se le impostazioni di sensibilità sono corrette. Inoltre, ogni nuova risorsa di dati o modifica a una risorsa di dati esistente comporta un aggiornamento del catalogo dei dati.
Le classificazioni vengono archiviate nel tag sensitive_category nel modello di tag Knowledge Catalog a livello di tabella e colonna. Una tabella di riferimento per la classificazione consente di classificare i tipi di informazioni (infoType) di Sensitive Data Protection disponibili, con classifiche più alte per i contenuti più sensibili.
Per soddisfare i requisiti di questo controllo, l'architettura utilizza Sensitive Data Protection, Knowledge Catalog e Tag Engine per aggiungere i seguenti tag alle colonne sensibili nelle tabelle BigQuery:
is_sensitive: indica se l'asset di dati contiene informazioni sensibilisensitive_category: la categoria dei dati; una delle seguenti:- Informazioni sensibili che consentono l'identificazione personale
- Informazioni che consentono l'identificazione personale
- Informazioni personali sensibili
- Informazioni personali
- Informazioni pubbliche
Puoi modificare le categorie di dati in base alle tue esigenze. Ad esempio, puoi aggiungere la classificazione delle informazioni non pubbliche materiali (MNPI).
Dopo che Sensitive Data Protection ha esaminato i dati, Tag Engine legge le tabelle DLP results per asset per compilare i risultati. Se una tabella contiene
colonne con uno o più infoType sensibili, viene determinato l'infoType più importante e sia le colonne sensibili sia l'intera tabella vengono taggate come
categoria con il ranking più alto. Tag Engine assegna anche un tag di policy corrispondente alla colonna e il tag booleano is_sensitive alla tabella.
Puoi utilizzare Cloud Scheduler per automatizzare l'ispezione di Sensitive Data Protection.
Il seguente diagramma mostra i servizi a cui si applica questo controllo.

Per soddisfare i requisiti di questo controllo, l'architettura utilizza i seguenti servizi:
- Quattro data warehouse BigQuery archiviano le seguenti
informazioni:
- Dati riservati
- Informazioni sui risultati di Sensitive Data Protection
- Dati di riferimento per la classificazione dei dati
- Informazioni sull'esportazione dei tag
- Knowledge Catalog memorizza i tag di classificazione.
- Sensitive Data Protection ispeziona gli asset per individuare gli infoType sensibili.
- Compute Engine esegue lo script Inspect Datasets, che attiva un job Sensitive Data Protection per ogni set di dati BigQuery.
- Due istanze Cloud Run, come segue:
- Un'istanza esegue Report Engine, che verifica se i tag sono applicati e pubblica i risultati.
- Un'altra istanza esegue Tag Engine, che tagga i dati nel data warehouse protetto.
- Pub/Sub pubblica i risultati.
Per rilevare i problemi relativi a questo controllo, l'architettura include i seguenti risultati:
- Se ai dati sensibili è assegnato un tag di categoria sensibile.
- Indica se ai dati sensibili è stato assegnato un tag di tipo di sensibilità a livello di colonna.
7. I diritti sui dati vengono gestiti, applicati e monitorati
Per impostazione predefinita, solo ai creator e ai proprietari vengono assegnati diritti e accesso ai dati sensibili. Inoltre, questo controllo richiede che l'architettura tenga traccia di tutti gli accessi ai dati sensibili.
Per soddisfare i requisiti di questo controllo, l'architettura utilizza la tassonomia tag di criteri cdmc
sensitive data classification in BigQuery per
controllare l'accesso alle colonne che contengono dati riservati nelle
tabelle BigQuery. La tassonomia include i seguenti tag criterio:
- Informazioni sensibili che consentono l'identificazione personale
- Informazioni che consentono l'identificazione personale
- Informazioni personali sensibili
- Informazioni personali
I tag di criteri ti consentono di controllare chi può visualizzare le colonne sensibili nelle tabelle BigQuery. L'architettura mappa questi tag di policy in classificazioni di sensibilità derivate dagli infoType di Sensitive Data Protection. Ad esempio, il tag di criteri sensitive_personal_identifiable_information e la categoria sensibile vengono mappati a infoType come AGE, DATE_OF_BIRTH, PHONE_NUMBER e EMAIL_ADDRESS.
L'architettura utilizza Identity and Access Management (IAM) per gestire i gruppi, gli utenti e i service account che richiedono l'accesso ai dati. Le autorizzazioni IAM vengono concesse a una determinata risorsa per l'accesso a livello di tabella. Inoltre, l'accesso a livello di colonna basato sui tag criterio consente un accesso granulare agli asset di dati sensibili. Per impostazione predefinita, gli utenti non hanno accesso alle colonne che hanno tag di policy definiti.
Per contribuire a garantire che solo gli utenti autenticati possano accedere ai dati, Google Cloud utilizza Cloud Identity, che puoi federare con i tuoi provider di identità esistenti per autenticare gli utenti.
Questo controllo richiede inoltre che l'architettura verifichi regolarmente le risorse di dati per le quali non sono stati definiti diritti. Il rilevatore, gestito da Cloud Scheduler, verifica i seguenti scenari:
- Una risorsa dati include una categoria sensibile, ma non è presente un tag delle norme correlato.
- Una categoria non corrisponde al tag di criteri.
Quando si verificano questi scenari, il rilevatore genera risultati che vengono pubblicati
da Pub/Sub e poi scritti nella tabella events in
BigQuery da Dataflow. Puoi quindi distribuire i
risultati allo strumento di correzione, come descritto in 1. conformità al controllo dei dati.
Il seguente diagramma mostra i servizi a cui si applica questo controllo.
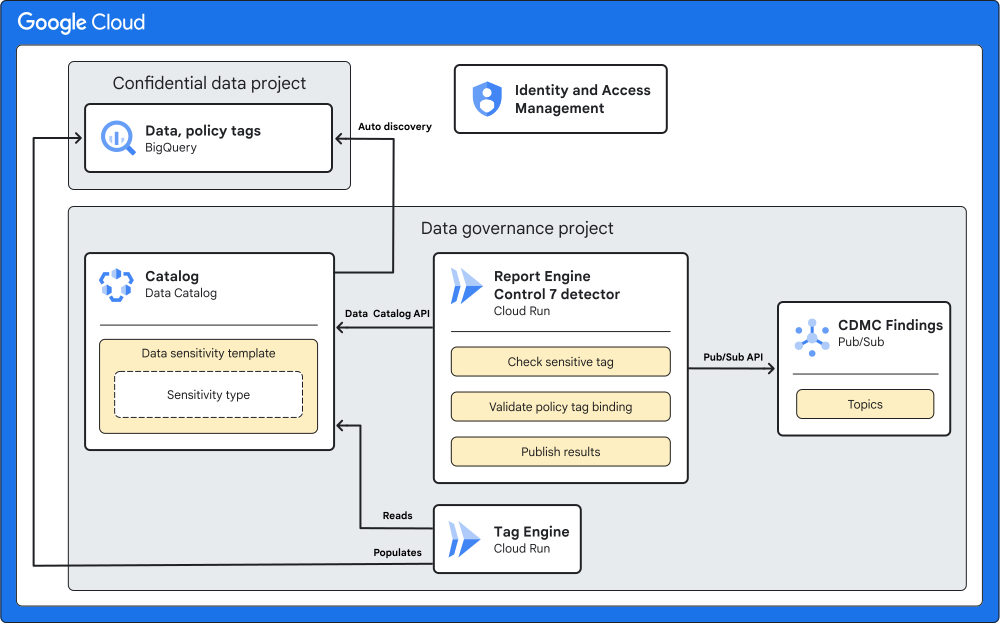
Per soddisfare i requisiti di questo controllo, l'architettura utilizza i seguenti servizi:
- Un data warehouse BigQuery archivia i dati riservati e i binding tag di criteri per i controlli dell'accesso granulare.
- IAM gestisce l'accesso.
- Knowledge Catalog memorizza i tag a livello di tabella e di colonna per la categoria sensibile.
- Due istanze Cloud Run, come segue:
- Un'istanza esegue Report Engine, che verifica se i tag sono applicati e pubblica i risultati.
- Un'altra istanza esegue Tag Engine, che tagga i dati nel data warehouse protetto.
Per rilevare problemi relativi a questo controllo, l'architettura verifica se i dati sensibili hanno untag di criteriy corrispondente.
8. L'accesso, l'utilizzo e i risultati etici dei dati vengono gestiti
Questo controllo richiede che l'architettura memorizzi gli accordi di condivisione dei dati sia del fornitore di dati sia dei consumatori di dati, incluso un elenco di scopi di consumo approvati. Lo scopo di consumo dei dati sensibili viene quindi mappato ai diritti archiviati in BigQuery utilizzando le etichette delle query. Quando un consumatore
esegue query sui dati sensibili in BigQuery, deve specificare uno scopo valido
che corrisponda al suo diritto (ad esempio, SET @@query_label =
"use:3";).
L'architettura utilizza Knowledge Catalog per aggiungere i seguenti tag al modello di tag CDMC controls. Questi tag rappresentano l'accordo di condivisione dei dati con il fornitore di dati:
approved_use: l'utilizzo o gli utenti approvati dell'asset di datisharing_scope_geography: l'elenco delle posizioni geografiche in cui è possibile condividere l'asset di datisharing_scope_legal_entity: l'elenco delle entità concordate che possono condividere l'asset di dati
Un data warehouse BigQuery separato include il
set di dati entitlement_management con le seguenti tabelle:
provider_agreement: l'accordo di condivisione dei dati con il fornitore di dati, inclusi la persona giuridica e l'ambito geografico concordati. Questi dati forniscono i valori predefiniti per i tagsharing_scope_geographyesharing_scope_legal_entity.consumer_agreement: l'accordo di condivisione dei dati con il consumatore di dati, inclusi la persona giuridica e l'ambito geografico concordati. Ogni contratto è associato a un binding IAM per l'asset di dati.use_purpose: lo scopo del consumo, ad esempio la descrizione dell'utilizzo e le operazioni consentite per l'asset di dati.data_asset: informazioni sull'asset di dati, come il nome dell'asset e i dettagli sul proprietario dei dati.
Per controllare gli accordi di condivisione dei dati, BigQuery mantiene una traccia di controllo completa per ogni job e query su ogni set di dati. La traccia di audit viene archiviata nella visualizzazione Information Schema Jobs di BigQuery. Dopo aver associato un'etichetta query a una sessione ed eseguito query all'interno della sessione, puoi raccogliere i log di controllo per le query con quell'etichetta query. Per ulteriori informazioni, consulta la documentazione di riferimento sui log di controllo per BigQuery.
Il seguente diagramma mostra i servizi a cui si applica questo controllo.

Per soddisfare i requisiti di questo controllo, l'architettura utilizza i seguenti servizi:
- Due data warehouse BigQuery: uno memorizza i dati confidenziali e l'altro memorizza i dati sui diritti, che includono gli accordi di condivisione dei dati tra provider e consumatore e lo scopo di utilizzo approvato.
- Knowledge Catalog memorizza le informazioni sull'accordo di condivisione dei dati del fornitore come tag.
- Due istanze Cloud Run, come segue:
- Un'istanza esegue Report Engine, che verifica se i tag sono applicati e pubblica i risultati.
- Un'altra istanza esegue Tag Engine, che tagga i dati nel data warehouse protetto.
- Pub/Sub pubblica i risultati.
Per rilevare i problemi relativi a questo controllo, l'architettura include i seguenti risultati:
- Se esiste una voce per un asset di dati nel set di dati
entitlement_management. - Se un'operazione viene eseguita su una tabella sensibile con un caso d'uso scaduto (ad esempio, la
valid_until_datenella tabellaconsumer_agreementè scaduta). - Se un'operazione viene eseguita su una tabella sensibile con una chiave di etichetta errata.
- Indica se un'operazione viene eseguita su una tabella sensibile con un valore dell'etichetta del caso d'uso vuoto o non approvato.
- Indica se una tabella sensibile viene interrogata con un metodo di operazione non approvato
(ad esempio
SELECToINSERT). - Se lo scopo registrato specificato dal consumatore durante l'esecuzione di query sui dati sensibili corrisponde al contratto di condivisione dei dati.
9. I dati sono protetti e i controlli sono documentati
Questo controllo richiede l'implementazione della crittografia e della deidentificazione dei dati per proteggere i dati sensibili e fornire un record di questi controlli.
Questa architettura si basa sulla sicurezza predefinita di Google, che include la crittografia at-rest. Inoltre, l'architettura ti consente di gestire le tue chiavi utilizzando le chiavi di crittografia gestite dal cliente (CMEK). Cloud Key Management Service ti consente di criptare i tuoi dati con chiavi di crittografia con supporto software o moduli di sicurezza hardware (HSM) convalidati FIPS 140-2 di livello 3.
L'architettura utilizza la mascheratura dinamica dei dati a livello di colonna configurata tramite tag dei criteri e archivia i dati riservati all'interno di un perimetro dei Controlli di servizio VPC separato. Puoi anche aggiungere l'anonimizzazione a livello di applicazione, che puoi implementare on-premise o come parte della pipeline di importazione dati.
Per impostazione predefinita, l'architettura implementa la crittografia CMEK con HSM, ma supporta anche Cloud External Key Manager (Cloud EKM).
La tabella seguente descrive la policy di sicurezza di esempio implementata dall'architettura per la regione us-central1. Puoi adattare le norme per soddisfare i tuoi requisiti, ad esempio aggiungendo norme diverse per regioni diverse.
| Sensibilità dei dati | Metodo di crittografia predefinito | Altri metodi di crittografia consentiti | Metodo di anonimizzazione predefinito | Altri metodi di anonimizzazione consentiti |
|---|---|---|---|---|
| Informazioni pubbliche | Crittografia predefinita | Qualsiasi | Nessuno | Qualsiasi |
| Informazioni sensibili che consentono l'identificazione personale | CMEK con HSM | EKM | Annulla | Hash SHA-256 o valore di mascheramento predefinito |
| Informazioni che consentono l'identificazione personale | CMEK con HSM | EKM | Hash SHA-256 | Annulla o Valore di mascheramento predefinito |
| Informazioni personali sensibili | CMEK con HSM | EKM | Valore di mascheramento predefinito | Hash SHA-256 o annullamento |
| Informazioni personali | CMEK con HSM | EKM | Valore di mascheramento predefinito | Hash SHA-256 o annullamento |
L'architettura utilizza Knowledge Catalog per aggiungere il tag
encryption_method al modello di tag CDMC controls a livello di tabella. encryption_method definisce il metodo di crittografia utilizzato dall'asset di dati.
Inoltre, l'architettura crea un tag security policy template per
identificare il metodo di deidentificazione applicato a un determinato campo. L'architettura utilizza platform_deid_method, che viene applicato utilizzando la maschera dinamica dei dati. Puoi aggiungere app_deid_method e popolarlo utilizzando le pipeline di importazione dati Dataflow e Sensitive Data Protection incluse nel blueprint del data warehouse protetto.
Il seguente diagramma mostra i servizi a cui si applica questo controllo.

Per soddisfare i requisiti di questo controllo, l'architettura utilizza i seguenti servizi:
- Due istanze facoltative di Dataflow, una esegue l'anonimizzazione a livello di applicazione e l'altra esegue la reidentificazione.
- Tre data warehouse BigQuery: uno archivia i dati riservati, uno archivia i dati non riservati e il terzo archivia la policy di sicurezza.
- Knowledge Catalog archivia i modelli di tag di crittografia e anonimizzazione.
- Due istanze Cloud Run, come segue:
- Un'istanza esegue Report Engine, che verifica se i tag sono applicati e pubblica i risultati.
- Un'altra istanza esegue Tag Engine, che tagga i dati nel data warehouse protetto.
- Pub/Sub pubblica i risultati.
Per rilevare i problemi relativi a questo controllo, l'architettura include i seguenti risultati:
- Il valore del tag del metodo di crittografia non corrisponde ai metodi di crittografia consentiti per la sensibilità e la posizione specificate.
- Una tabella contiene colonne sensibili, ma il tag Modello di policy di sicurezza contiene un metodo di anonimizzazione a livello di piattaforma non valido.
- Una tabella contiene colonne sensibili, ma il tag Modello di policy di sicurezza non è presente.
10. Un framework per la privacy dei dati è definito e operativo
Questo controllo richiede che l'architettura esamini il catalogo dei dati e le classificazioni per determinare se devi creare un report di valutazione di impatto sulla protezione dei dati (DPIA) o un report di valutazione di impatto sulla privacy (PIA). Le valutazioni della privacy variano in modo significativo a seconda delle aree geografiche e delle autorità di regolamentazione. Per determinare se è necessaria una valutazione dell'impatto, l'architettura deve considerare la residenza dei dati e la residenza dell'interessato.
L'architettura utilizza Knowledge Catalog per aggiungere i seguenti tag al modello di tag Impact assessment:
subject_locations: la posizione dei soggetti a cui si riferiscono i dati in questo asset.is_dpia: indica se per questo asset è stata completata una valutazione di impatto sulla privacy dei dati (DPIA).is_pia: indica se per questa risorsa è stata completata un'analisi dell'impatto sulla privacy (PIA).impact_assessment_reports: link esterno alla posizione in cui è archiviato il report di valutazione dell'impatto.most_recent_assessment: la data della valutazione dell'impatto più recente.oldest_assessment: la data della prima valutazione dell'impatto.
Tag Engine aggiunge questi tag a ogni asset di dati sensibili, come definito dal controllo 6. Il rilevatore convalida questi tag in base a una tabella delle norme in BigQuery. La tabella delle norme definisce le combinazioni valide di residenza dei dati, posizione del soggetto, sensibilità dei dati (ad esempio, se si tratta di informazioni di identificazione personale) e il tipo di valutazione dell'impatto (PIA o DPIA) richiesto.
Il seguente diagramma mostra i servizi a cui si applica questo controllo.

Per soddisfare i requisiti di questo controllo, l'architettura utilizza i seguenti servizi:
- Quattro data warehouse BigQuery archiviano le seguenti
informazioni:
- Dati riservati
- Dati non riservati
- Policy di valutazione dell'impatto e timestamp dei diritti
- Esportazioni di tag utilizzate per la dashboard
- Knowledge Catalog memorizza i dettagli della valutazione dell'impatto nei tag all'interno dei modelli di tag.
- Due istanze Cloud Run, come segue:
- Un'istanza esegue Report Engine, che verifica se i tag sono applicati e pubblica i risultati.
- Un'altra istanza esegue Tag Engine, che tagga i dati nel data warehouse protetto.
- Pub/Sub pubblica i risultati.
Per rilevare i problemi relativi a questo controllo, l'architettura include i seguenti risultati:
- Esistono dati sensibili senza un modello di valutazione dell'impatto.
- Esistono dati sensibili senza un link a un report DPIA o PIA.
- I tag non soddisfano i requisiti indicati nella tabella delle norme.
- La valutazione dell'impatto è precedente al diritto approvato più di recente per l'asset di dati nella tabella dell'accordo con il consumatore.
11. Il ciclo di vita dei dati è pianificato e gestito
Questo controllo richiede la possibilità di ispezionare tutti gli asset di dati per determinare che esista e venga rispettata una norma del ciclo di vita dei dati.
L'architettura utilizza Knowledge Catalog per aggiungere i seguenti tag al modello di tag CDMC controls:
retention_period: il tempo, in giorni, per conservare la tabellaexpiration_action: indica se archiviare o eliminare la tabella al termine del periodo di conservazione
Per impostazione predefinita, l'architettura utilizza il seguente periodo di conservazione e azione di scadenza:
| Categoria di dati | Periodo di conservazione, in giorni | Azione di scadenza |
|---|---|---|
| Informazioni sensibili che consentono l'identificazione personale | 60 | Elimina definitivamente |
| Informazioni che consentono l'identificazione personale | 90 | Archivia |
| Informazioni personali sensibili | 180 | Archivia |
| Informazioni personali | 180 | Archivia |
Puoi utilizzare le seguenti opzioni per implementare la gestione del ciclo di vita dei dati:
Combina le funzionalità del ciclo di vita di BigQuery con l'orchestrazione serverless. In questo caso, i valori dei tag precedenti definiscono la norma di governance. Cloud Scheduler attiva un flusso di lavoro serverless utilizzando Workflows o Cloud Run Functions. Questo workflow legge i metadati del tag e valuta l'azione di scadenza. Se l'azione è l'eliminazione definitiva, il flusso di lavoro crea uno snapshot della tabella con un tempo di scadenza per supportare l'eliminazione temporanea e il recupero e applica le norme di scadenza della tabella o di scadenza della partizione di BigQuery alla tabella di origine. Se l'azione è l'archiviazione, il flusso di lavoro completa le seguenti operazioni:
- Esporta i dati della tabella in Cloud Storage in formato Parquet.
- Registra una tabella BigLake per supportare il tagging dei metadati esterni.
- Copia i tag di metadati e delle norme dalla tabella di origine alla tabella BigLake (o riapplica i tag utilizzando Tag Engine).
- Elimina o scade la tabella di origine.
Esegui il deployment di Record Manager, un asset open source per BigQuery, per eliminare e archiviare le tabelle BigQuery in base ai valori dei tag precedenti e a un file di configurazione. La procedura di eliminazione imposta una data di scadenza per una tabella e crea una tabella snapshot con un tempo di scadenza definito nella configurazione di Record Manager. Per impostazione predefinita, il tempo di scadenza è di 30 giorni. Durante il periodo di eliminazione temporanea, puoi recuperare la tabella. La procedura di archiviazione crea una tabella esterna per ogni tabella BigQuery che supera il periodo di conservazione. La tabella è archiviata in Cloud Storage in formato Parquet e aggiornata a una tabella BigLake, che consente di taggare il file esterno con metadati in Knowledge Catalog. Record Manager elimina la tabella di origine per completare la procedura di archiviazione.
In entrambe le opzioni, dopo l'archiviazione dei dati in Cloud Storage, puoi configurare la gestione del ciclo di vita degli oggetti Cloud Storage per trasferire automaticamente i file meno recenti a classi di storage a costi inferiori.
Il seguente diagramma mostra i servizi a cui si applica questo controllo quando utilizzi le funzionalità del ciclo di vita di BigQuery.

Per soddisfare i requisiti di questo controllo, l'architettura utilizza i seguenti servizi:
- Due data warehouse BigQuery: uno archivia i dati riservati e l'altro archivia le norme di conservazione dei dati.
- Cloud Storage fornisce l'archiviazione ad accesso sporadico.
- Knowledge Catalog memorizza il periodo di conservazione e l'azione nei modelli di tag e nei tag.
- Due istanze Cloud Run, come segue:
- Un'istanza esegue Report Engine, che verifica se i tag sono applicati, valuta le tabelle in base alle norme di conservazione e pubblica i risultati.
- Un'altra istanza esegue Tag Engine, che tagga i dati nel data warehouse protetto in base alle regole dei criteri aziendali archiviate nel data warehouse di governance.
- Cloud Scheduler attiva il workflow per eseguire le azioni di scadenza o archiviazione.
- Workflows o le esecuzioni di Cloud Run Functions eseguono il workflow serverless.
- Pub/Sub pubblica i risultati.
- BigLake consente controllo dell'accesso e l'assegnazione di tag ai metadati sui dati archiviati.
Il seguente diagramma mostra i servizi a cui si applica questo controllo quando utilizzi Record Manager.

Per soddisfare i requisiti di questo controllo, l'architettura utilizza i seguenti servizi:
- Due data warehouse BigQuery: uno archivia i dati riservati e l'altro archivia le norme di conservazione dei dati.
- Due bucket Cloud Storage, uno fornisce l'archiviazione e l'altro archivia i record.
- Knowledge Catalog memorizza il periodo di conservazione e l'azione nei modelli di tag e nei tag.
- Tre istanze Cloud Run, come segue:
- Un'istanza esegue Report Engine, che verifica se i tag sono applicati e pubblica i risultati.
- Un'altra istanza esegue Tag Engine, che tagga i dati nel data warehouse protetto.
- Un'altra istanza esegue Record Manager, che automatizza l'eliminazione e l'archiviazione delle tabelle BigQuery.
- Pub/Sub pubblica i risultati.
Per rilevare i problemi relativi a questo controllo, l'architettura include i seguenti risultati:
- L'azione di scadenza per un asset sensibile non è in linea con le norme per la posizione dell'asset.
- Il periodo di conservazione di una risorsa sensibile non è allineato alle norme per la località della risorsa.
- Esistono dati sensibili senza tag di azione di scadenza o periodo di conservazione.
12. La qualità dei dati è gestita
Questo controllo richiede la possibilità di misurare la qualità dei dati in base alla profilazione dei dati o alle metriche definite dall'utente.
L'architettura include la possibilità di definire regole di qualità dei dati per un valore individuale o aggregato e assegnare soglie a una colonna specifica della tabella. Include modelli di tag per la correttezza e la completezza. Knowledge Catalog aggiunge i seguenti tag a ogni modello di tag:
column_name: il nome della colonna a cui si applica la metricametric: il nome della metrica o della regola di qualitàrows_validated: il numero di righe convalidatosuccess_percentage: la percentuale di valori che soddisfano questa metricaacceptable_threshold: la soglia accettabile per questa metricameets_threshold: indica se il punteggio di qualità (il valoresuccess_percentage) soddisfa la soglia accettabilemost_recent_run: l'ultima volta che la metrica o la regola di qualità è stata eseguita
Il seguente diagramma mostra i servizi a cui si applica questo controllo.

Per soddisfare i requisiti di questo controllo, l'architettura utilizza i seguenti servizi:
- Tre data warehouse BigQuery: uno archivia i dati sensibili, uno archivia i dati non sensibili e il terzo archivia le metriche delle regole di qualità.
- Knowledge Catalog memorizza i risultati della qualità dei dati in modelli di tag e tag.
- Cloud Scheduler definisce quando viene eseguito Cloud Data Quality Engine.
- Tre istanze Cloud Run, come segue:
- Un'istanza esegue Report Engine, che verifica se i tag sono applicati e pubblica i risultati.
- Un'altra istanza esegue Tag Engine, che tagga i dati nel data warehouse protetto.
- La terza istanza esegue il motore Cloud Data Quality.
- Cloud Data Quality Engine definisce le regole di qualità dei dati e pianifica i controlli di qualità dei dati per tabelle e colonne.
- Pub/Sub pubblica i risultati.
Una dashboard di Data Studio mostra i report sulla qualità dei dati per i livelli di tabella e di colonna.
Per rilevare i problemi relativi a questo controllo, l'architettura include i seguenti risultati:
- I dati sono sensibili, ma non vengono applicati modelli di tag di qualità dei dati (correttezza e completezza).
- I dati sono sensibili, ma il tag di qualità dei dati non viene applicato alla colonna sensibile.
- I dati sono sensibili, ma i risultati sulla qualità dei dati non rientrano nella soglia impostata nella regola.
- I dati non sono sensibili e i risultati sulla qualità dei dati non rientrano nella soglia impostata dalla regola.
In alternativa al motore di qualità dei dati di Cloud, puoi configurare la qualità dei dati automatica di Knowledge Catalog.
13. I principi di gestione dei costi sono stabiliti e applicati
Questo controllo richiede la possibilità di esaminare gli asset di dati per confermare l'utilizzo dei costi, in base ai requisiti delle norme e all'architettura dei dati. Le metriche sui costi devono essere complete e non limitate all'utilizzo e allo spostamento dello spazio di archiviazione.
L'architettura utilizza Knowledge Catalog per aggiungere i seguenti tag al modello di tag cost_metrics:
total_query_bytes_billed: il numero totale di byte di query fatturati per questo asset di dati dall'inizio del mese corrente.total_storage_bytes_billed: il numero totale di byte di spazio di archiviazione fatturati per questo asset di dati dall'inizio del mese corrente.total_bytes_transferred: la somma dei byte trasferiti tra regioni in questo asset di dati.estimated_query_cost: il costo stimato della query, in dollari statunitensi, per l'asset di dati per il mese corrente.estimated_storage_cost: costo di archiviazione stimato, in dollari statunitensi, per l'asset di dati per il mese corrente.estimated_egress_cost: l'uscita stimata in dollari statunitensi per il mese corrente in cui l'asset di dati è stato utilizzato come tabella di destinazione.
L'architettura esporta le informazioni sui prezzi da fatturazione Cloud in una tabella BigQuery denominata cloud_pricing_export.
Il seguente diagramma mostra i servizi a cui si applica questo controllo.

Per soddisfare i requisiti di questo controllo, l'architettura utilizza i seguenti servizi:
- Fatturazione Cloud fornisce i dati di fatturazione.
- Knowledge Catalog memorizza le informazioni sui costi nei modelli di tag e nei tag.
- BigQuery archivia le informazioni sui prezzi esportate e le informazioni storiche sui job di query tramite la visualizzazione INFORMATION_SCHEMA integrata.
- Due istanze Cloud Run, come segue:
- Un'istanza esegue Report Engine, che verifica se i tag sono applicati e pubblica i risultati.
- Un'altra istanza esegue Tag Engine, che tagga i dati nel data warehouse protetto.
- Pub/Sub pubblica i risultati.
Per rilevare i problemi relativi a questo controllo, l'architettura verifica se esistono asset di dati sensibili senza metriche di costo associate.
14. La provenienza e la tracciabilità dei dati sono comprese
Questo controllo richiede la possibilità di ispezionare la tracciabilità dell'asset di dati dalla sua origine e qualsiasi modifica alla derivazione dell'asset di dati.
Per mantenere le informazioni sulla provenienza e sulla derivazione dei dati, l'architettura utilizza le funzionalità di Data Lineage integrate in Knowledge Catalog. Inoltre, gli script di importazione dati definiscono l'origine finale e la aggiungono come nodo aggiuntivo al grafico della derivazione dei dati.
Per soddisfare i requisiti di questo controllo, l'architettura utilizza
Knowledge Catalog per aggiungere il tag ultimate_source al
modello di tag CDMC controls. Il tag ultimate_source definisce l'origine
di questa risorsa dati.
Il seguente diagramma mostra i servizi a cui si applica questo controllo.

Per soddisfare i requisiti di questo controllo, l'architettura utilizza i seguenti servizi:
- Due data warehouse BigQuery: uno archivia i dati riservati e l'altro archivia i dati di origine finali.
- Knowledge Catalog memorizza l'origine definitiva nei modelli di tag e nei tag.
- Gli script di acquisizione dei dati caricano i dati da Cloud Storage, definiscono l'origine finale e aggiungono l'origine al grafico della tracciabilità dei dati.
- Due istanze Cloud Run, come segue:
- Un'istanza esegue Report Engine, che verifica se i tag sono applicati e pubblica i risultati.
- Un'altra istanza esegue Tag Engine, che tagga i dati nel data warehouse protetto.
- Pub/Sub pubblica i risultati.
Per rilevare problemi relativi a questo controllo, l'architettura include i seguenti controlli:
- I dati sensibili vengono identificati senza tag di origine finale.
- Il grafico della derivazione non viene compilato per gli asset di dati sensibili.
Riferimento al tag
Questa sezione descrive i modelli di tag e i tag utilizzati da questa architettura per soddisfare i requisiti dei controlli chiave CDMC.
Modelli di tag di controllo CDMC a livello di tabella
La tabella seguente elenca i tag che fanno parte del modello di tag di controllo CDMC e che vengono applicati alle tabelle.
| Tag | ID tag | Controllo della chiave applicabile |
|---|---|---|
| Località di archiviazione approvata | approved_storage_location |
4 |
| Utilizzo approvato | approved_use |
8 |
| Email del proprietario dei dati | data_owner_email |
2 |
| Nome del proprietario dei dati | data_owner_name |
2 |
| Metodo di crittografia | encryption_method |
9 |
| Azione di scadenza | expiration_action |
11 |
| È autorevole | is_authoritative |
3 |
| È sensibile | is_sensitive |
6 |
| Categoria sensibile | sensitive_category |
6 |
| Regione dell'ambito di condivisione | sharing_scope_geography |
8 |
| Persona giuridica dell'ambito di condivisione | sharing_scope_legal_entity |
8 |
| Periodo di conservazione | retention_period |
11 |
| Ultimate Source | ultimate_source |
14 |
Modello di tag per la valutazione dell'impatto
La tabella seguente elenca i tag che fanno parte del modello di tag Valutazione dell'impatto e che vengono applicati alle tabelle.
| Tag | ID tag | Controllo della chiave applicabile |
|---|---|---|
| Località dei soggetti | subject_locations |
10 |
| La valutazione dell'impatto sulla protezione dei dati | is_dpia |
10 |
| Is PIA Impact Assessment | is_pia |
10 |
| Report sulla valutazione dell'impatto | impact_assessment_reports |
10 |
| Valutazione dell'impatto più recente | most_recent_assessment |
10 |
| Valutazione dell'impatto meno recente | oldest_assessment |
10 |
Modello di tag Metriche relative ai costi
La tabella seguente elenca i tag che fanno parte del modello di tag Metriche dei costi e che vengono applicati alle tabelle.
| Tag | ID tag | Controllo della chiave applicabile |
|---|---|---|
| Costo stimato della query | estimated_query_cost |
13 |
| Costo di archiviazione stimato | estimated_storage_cost |
13 |
| Costo stimato del traffico in uscita | estimated_egress_cost |
13 |
| Byte totali delle query fatturati | total_query_bytes_billed |
13 |
| Byte di archiviazione totali fatturati | total_storage_bytes_billed |
13 |
| Byte totali trasferiti | total_bytes_transferred |
13 |
Modello di tag Sensibilità dei dati
La tabella seguente elenca i tag che fanno parte del modello di tag Sensibilità dei dati e che vengono applicati ai campi.
| Tag | ID tag | Controllo della chiave applicabile |
|---|---|---|
| Campo sensibile | sensitive_field |
6 |
| Tipo di sensibilità | sensitive_category |
6 |
Modello di tag di policy di sicurezza
La tabella seguente elenca i tag che fanno parte del modello di tag di policy di sicurezza e che vengono applicati ai campi.
| Tag | ID tag | Controllo della chiave applicabile |
|---|---|---|
| Metodo di anonimizzazione dell'applicazione | app_deid_method |
9 |
| Metodo di anonimizzazione della piattaforma | platform_deid_method |
9 |
Modelli di tag di qualità dei dati
La tabella seguente elenca i tag che fanno parte dei modelli di tag Qualità dei dati di completezza e correttezza e che vengono applicati ai campi.
| Tag | ID tag | Controllo della chiave applicabile |
|---|---|---|
| Soglia accettabile | acceptable_threshold |
12 |
| Nome colonna | column_name |
12 |
| Soddisfa la soglia | meets_threshold |
12 |
| Metrica | metric |
12 |
| Esecuzione più recente | most_recent_run |
12 |
| Righe convalidate | rows_validated |
12 |
| Percentuale di successo | success_percentage |
12 |
Tag di policy CDMC a livello di campo
La seguente tabella elenca i tag di policy che fanno parte della tassonomia tag di criteri di classificazione dei dati sensibili CDMC e che vengono applicati ai campi. Questi tag dei criteri limitano l'accesso a livello di campo e consentono la deidentificazione dei dati a livello di piattaforma.
| Classificazione dati | Nome tag | Controllo della chiave applicabile |
|---|---|---|
| Informazioni che consentono l'identificazione personale | personal_identifiable_information |
7 |
| Informazioni personali | personal_information |
7 |
| Informazioni sensibili che consentono l'identificazione personale | sensitive_personal_identifiable_information |
7 |
| Informazioni personali sensibili | sensitive_personal_data |
7 |
Metadati tecnici precompilati
La tabella seguente elenca i metadati tecnici sincronizzati per impostazione predefinita in Knowledge Catalog per tutti gli asset di dati BigQuery.
| Metadati | Controllo della chiave applicabile |
|---|---|
| Tipo di asset | — |
| Ora creazione | — |
| Data di scadenza | 11 |
| Località | 4 |
| URL risorsa | 3 |
Passaggi successivi
- Scopri di più sul framework CDMC sul sito web dell'EDM Council.
- Scopri di più sui controlli di sicurezza utilizzati dal progetto base per il data warehouse protetto.
- Tieni traccia della provenienza dei dati di addestramento e delle trasformazioni della pipeline per i carichi di lavoro di AI e machine learning con la derivazione dei dati di Knowledge Catalog.
- Scopri di più su Tag Engine.
- Esamina gli script di automazione di esempio nel repository Google Cloud CDMC Reference Architecture archiviato su GitHub.