


לפני שמתחילים
אם עדיין לא עשיתם את זה, הגדירו פרויקט ב- Google Cloud ושתי (2) קטגוריות ב-Cloud Storage.
הגדרת הפרויקט
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that billing is enabled for your Google Cloud project.
Enable the Dataproc, Compute Engine, Cloud Storage, and Cloud Run functions APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.-
Install the Google Cloud CLI.
-
Configure the gcloud CLI to use your federated identity.
For more information, see Sign in to the gcloud CLI with your federated identity.
-
To initialize the gcloud CLI, run the following command:
gcloud init
יצירה או שימוש בשתי קטגוריות של Cloud Storage בפרויקט
בפרויקט שלכם תצטרכו שתי קטגוריות של Cloud Storage: אחת לקובצי קלט ואחת לפלט.
- במסוף Google Cloud , נכנסים לדף Buckets של Cloud Storage.
- לוחצים על Create.
- ממלאים את פרטי הקטגוריה בדף Create a bucket. כדי לעבור לשלב הבא לוחצים על Continue.
-
בקטע Get started, מבצעים את הפעולות הבאות:
- מזינים שם ייחודי גלובלי שעומד בדרישות למתן שמות של קטגוריות.
- כדי להוסיף תווית לקטגוריה, מרחיבים את הקטע Labels (), לוחצים על add_box Add label ומציינים
keyו-valueבשביל התווית.
-
בקטע Choose where to store your data, מבצעים את הפעולות הבאות:
- בוחרים Location type.
- בתפריט הנפתח Location type, בוחרים את המיקום שבו נתוני הקטגוריה יאוחסנו באופן קבוע.
- אם בוחרים בסוג המיקום בשני אזורים, אפשר גם להפעיל את רפליקציה בקצב טורבו באמצעות תיבת הסימון הרלוונטית.
- כדי להגדיר רפליקציה בין קטגוריות, בוחרים באפשרות Add cross-bucket replication via Storage Transfer Service ופועלים לפי השלבים הבאים:
הגדרת רפליקציה בין קטגוריות
- בתפריט Bucket, בוחרים קטגוריה.
בקטע Replication settings, לוחצים על Configure כדי לקבוע את ההגדרות של משימת הרפליקציה.
מופיעה החלונית Configure cross-bucket replication.
- כדי לסנן אובייקטים לשכפול לפי קידומת של שם האובייקט, מזינים את הקידומת שרוצים לכלול או להחריג אובייקטים ממנה, ואז לוחצים על Add a prefix.
- כדי להגדיר סוג אחסון לאובייקטים שנוצרו ברפליקציה, בוחרים סוג אחסון בתפריט Storage class. אם מדלגים על השלב הזה, האובייקטים המשוכפלים ישתמשו כברירת מחדל בסוג האחסון של קטגוריית היעד.
- לוחצים על סיום.
-
בקטע Choose how to store your data, מבצעים את הפעולות הבאות:
- בוחרים סוג אחסון (storage class) שמוגדר כברירת מחדל לקטגוריה, או בוחרים ב-Autoclass לניהול אוטומטי של סוג האחסון של נתוני הקטגוריה.
- כדי להפעיל מרחב שמות היררכי, בקטע Optimize storage for data-intensive workloads בוחרים באפשרות Enable hierarchical namespace on this bucket.
- בקטע Choose how to control access to objects, בוחרים אם הקטגוריה אוכפת public access prevention או לא, ואז בוחרים access control method לאובייקטים של הקטגוריה.
-
בקטע Choose how to protect object data, מבצעים את הפעולות הבאות:
- בוחרים את האפשרויות שרוצים להגדיר לקטגוריה בקטע הגנה על נתונים.
- כדי להפעיל את האפשרות מחיקה זמנית, לוחצים על תיבת הסימון Soft delete policy (For data recovery) ומציינים את מספר הימים שבהם רוצים לשמור את האובייקטים אחרי המחיקה.
- כדי להגדיר ניהול גרסאות של אובייקטים, לוחצים על תיבת הסימון ניהול גרסאות של אובייקטים (לניהול גרסאות) ומציינים את המספר המקסימלי של גרסאות לכל אובייקט ואת מספר הימים שאחריהם פג התוקף של הגרסאות הלא עדכניות.
- כדי להפעיל את מדיניות שמירת הנתונים על אובייקטים וקטגוריות, לוחצים על תיבת הסימון Retention (For compliance) ואז מבצעים את הפעולות הבאות:
- כדי להפעיל את נעילת שמירת האובייקטים, לוחצים על תיבת הסימון Enable object retention.
- כדי להפעיל את Bucket Lock, לוחצים על תיבת הסימון Set bucket retention policy ובוחרים יחידת זמן ואת משך הזמן של תקופת השמירה.
- כדי לבחור איך להצפין את נתוני האובייקטים, מרחיבים את הקטע Data encryption () ובוחרים שיטה ל-Data encryption.
- בוחרים את האפשרויות שרוצים להגדיר לקטגוריה בקטע הגנה על נתונים.
-
בקטע Get started, מבצעים את הפעולות הבאות:
- לוחצים על יצירה.
יצירת תבנית של תהליך עבודה
כדי ליצור ולהגדיר תבנית של תהליך עבודה, מעתיקים ומריצים את הפקודות הבאות בחלון הטרמינל המקומי או ב-Cloud Shell.
- יוצרים את תבנית תהליך העבודה.
  gcloud dataproc workflow-templates create wordcount-template \
      --region=us-central1
- מוסיפים את המשימה wordcount לתבנית של תהליך העבודה.
-
צריך לציין את output-bucket-name לפני שמריצים את הפקודה (הפונקציה תספק את קטגוריית הקלט).
אחרי שמזינים את הערך של output-bucket-name, הארגומנט של קטגוריית הפלט אמור להיראות כך:
gs://your-output-bucket/wordcount-output". -
מזהה השלב "count" נדרש, והוא מזהה את משימת ה-Hadoop שנוספה.
          gcloud dataproc workflow-templates add-job hadoop \
              --workflow-template=wordcount-template \
              --step-id=count \
              --jar=file:///usr/lib/hadoop-mapreduce/hadoop-mapreduce-examples.jar \
              --region=us-central1 \
              -- wordcount gs://input-bucket gs://output-bucket-name/wordcount-output
-
צריך לציין את output-bucket-name לפני שמריצים את הפקודה (הפונקציה תספק את קטגוריית הקלט).
אחרי שמזינים את הערך של output-bucket-name, הארגומנט של קטגוריית הפלט אמור להיראות כך:
- משתמשים באשכול מנוהל עם צומת יחיד כדי להריץ את תהליך העבודה. Managed Service for Apache Spark ייצור את האשכול, יריץ עליו את תהליך העבודה וימחק את האשכול כשתהליך העבודה יסתיים.
gcloud dataproc workflow-templates set-managed-cluster wordcount-template \ --cluster-name=wordcount \ --single-node \ --region=us-central1 - לוחצים על השם של
wordcount-templateבדף Workflows של Managed Service for Apache Spark במסוף Google Cloud כדי לפתוח את הדף Workflow template details. מאשרים את המאפיינים של wordcount-template.
הגדרת פרמטרים לתבנית של תהליך העבודה
מגדירים פרמטרים למשתנה של קטגוריית הקלט כדי להעביר אותו לתבנית של תהליך העבודה.
- מייצאים את תבנית תהליך העבודה לקובץ טקסט בפורמט
wordcount.yamlכדי להגדיר פרמטרים.gcloud dataproc workflow-templates export wordcount-template \ --destination=wordcount.yaml \ --region=us-central1
- בכלי לעריכת טקסט, פותחים את
wordcount.yamlומוסיפים בלוקparametersבסוף קובץ ה-YAML, כדי שאפשר יהיה להעביר את INPUT_BUCKET_URI של Cloud Storage בתורargs[1]לקובץ הבינארי של wordcount כשתהליך העבודה מופעל.בהמשך מוצגת דוגמה לקובץ YAML שיוצא. יש שתי דרכים לעדכן את התבנית:
- מעתיקים את כל הקובץ ומדביקים אותו כדי להחליף את קובץ ה-
wordcount.yamlשיוצא, אחרי שמחליפים את your-output_bucket בשם של קטגוריית הפלט, או - מעתיקים ומדביקים רק את הקטע
parametersבסוף קובץ ה-wordcount.yamlשייצאתם.
jobs: - hadoopJob: args: - wordcount - gs://input-bucket - gs://your-output-bucket/wordcount-output mainJarFileUri: file:///usr/lib/hadoop-mapreduce/hadoop-mapreduce-examples.jar stepId: count placement: managedCluster: clusterName: wordcount config: softwareConfig: properties: dataproc:dataproc.allow.zero.workers: 'true' parameters: - name: INPUT_BUCKET_URI description: wordcount input bucket URI fields: - jobs['count'].hadoopJob.args[1] - מעתיקים את כל הקובץ ומדביקים אותו כדי להחליף את קובץ ה-
- מייבאים את קובץ הטקסט
wordcount.yamlעם הפרמטרים. מקלידים "כן" כשמוצגת בקשה להחליף את התבנית.gcloud dataproc workflow-templates import wordcount-template \ --source=wordcount.yaml \ --region=us-central1
יצירת פונקציה של Cloud Functions
פותחים את הדף פונקציות Cloud Run במסוףGoogle Cloud ולוחצים על CREATE FUNCTION.
בדף Create function, מזינים או בוחרים את הפרטים הבאים:
- Name: wordcount
- Memory allocated: משאירים את בחירת ברירת המחדל.
- טריגר:
- Cloud Storage
- סוג האירוע: סיום/יצירה
- Bucket: בוחרים את קטגוריית הקלט (ראו יצירת קטגוריה של Cloud Storage בפרויקט). כשמוסיפים קובץ לקטגוריה הזו, הפונקציה מפעילה את תהליך העבודה. תהליך העבודה יריץ את האפליקציה wordcount, שתעבד את כל קובצי הטקסט בקטגוריה.
קוד מקור:
- עריכה ישירה
- סביבת זמן ריצה: Node.js 8
- בכרטיסייה
INDEX.JS: מחליפים את קטע הקוד שמוגדר כברירת מחדל בקוד הבא, ואז עורכים את השורהconst projectIdכדי לספק את -your-project-id- (בלי "-" בהתחלה או בסוף).
const dataproc = require('@google-cloud/dataproc').v1; exports.startWorkflow = (data) => { const projectId = '-your-project-id-' const region = 'us-central1' const workflowTemplate = 'wordcount-template' const client = new dataproc.WorkflowTemplateServiceClient({ apiEndpoint: `${region}-dataproc.googleapis.com`, }); const file = data; console.log("Event: ", file); const inputBucketUri = `gs://${file.bucket}/${file.name}`; const request = { name: client.projectRegionWorkflowTemplatePath(projectId, region, workflowTemplate), parameters: {"INPUT_BUCKET_URI": inputBucketUri} }; client.instantiateWorkflowTemplate(request) .then(responses => { console.log("Launched Dataproc Workflow:", responses[1]); }) .catch(err => { console.error(err); }); };- בכרטיסייה
PACKAGE.JSON: מחליפים את קטע הקוד שמוגדר כברירת מחדל בקוד הבא.
{ "name": "dataproc-workflow", "version": "1.0.0", "dependencies":{ "@google-cloud/dataproc": ">=1.0.0"} }- הפונקציה לביצוע: מזינים "startWorkflow".
לוחצים על "יצירה".
בדיקת הפונקציה
מעתיקים את הקובץ הציבורי
rose.txtלקטגוריה כדי להפעיל את הפונקציה. בפקודה, מחליפים את your-input-bucket-name בקטגוריה שמשמשת להפעלת הפונקציה.gcloud storage cp gs://pub/shakespeare/rose.txt gs://your-input-bucket-name
ממתינים 30 שניות ואז מריצים את הפקודה הבאה כדי לוודא שהפונקציה הושלמה בהצלחה.
gcloud functions logs read wordcount
...
Function execution took 1348 ms, finished with status: 'ok'
כדי לראות את יומני הפונקציות מדף הרשימה Functions במסוף Google Cloud , לוחצים על שם הפונקציה
wordcountואז על VIEW LOGS בדף Function details.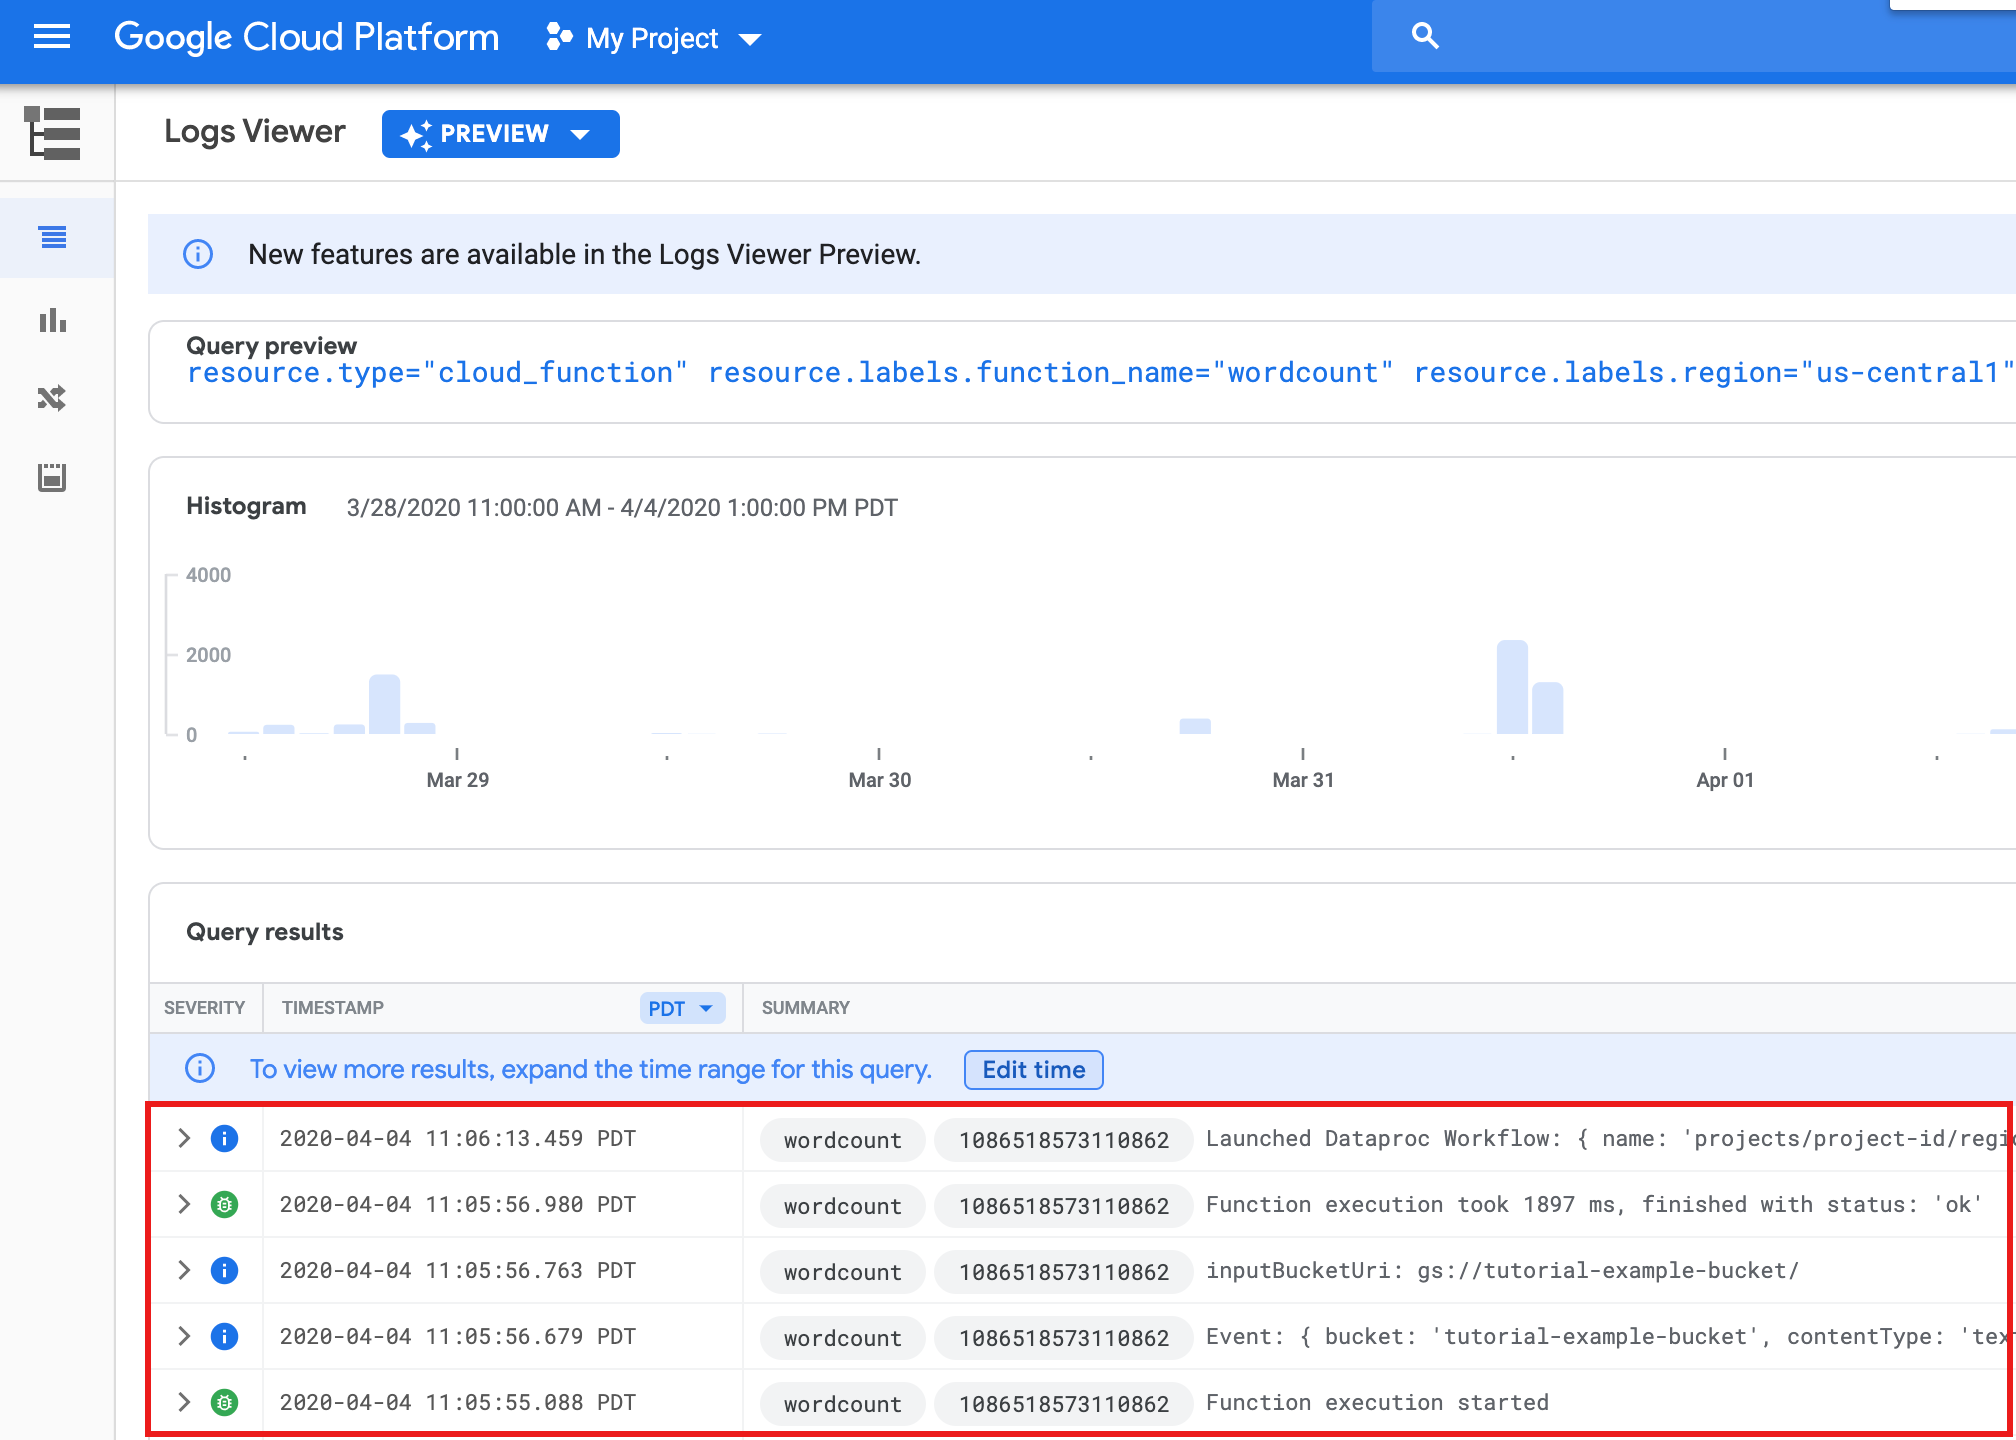
אפשר לראות את התיקייה
wordcount-outputבקטגוריית הפלט בדף Storage browser במסוףGoogle Cloud .
אחרי שהתהליך מסתיים, פרטי המשימה נשמרים במסוףGoogle Cloud . לוחצים על המשימה
count...שמופיעה בדף Jobs ב-Managed Service for Apache Spark כדי לראות את פרטי המשימה בתהליך העבודה.
הסרת המשאבים
תהליך העבודה במדריך הזה מוחק את האשכול המנוהל שלו בסיום תהליך העבודה. כדי להימנע מעלויות חוזרות, אתם יכולים למחוק משאבים אחרים שמשויכים למדריך הזה.
מחיקת פרויקטים
- במסוף Google Cloud , נכנסים לדף Manage resources.
- ברשימת הפרויקטים, בוחרים את הפרויקט שרוצים למחוק ולוחצים על Delete.
- כדי למחוק את הפרויקט, כותבים את מזהה הפרויקט בתיבת הדו-שיח ולוחצים על Shut down.
מחיקת קטגוריות של Cloud Storage
- במסוף Google Cloud , נכנסים לדף Buckets של Cloud Storage.
- לוחצים על תיבת הסימון של הקטגוריה שרוצים למחוק.
- כדי למחוק את הקטגוריה, לוחצים על Delete ופועלים לפי ההוראות.
מחיקת תבנית של תהליך עבודה
gcloud dataproc workflow-templates delete wordcount-template \
    --region=us-central1
מחיקת הפונקציה של Cloud Functions
פותחים את הדף פונקציות Cloud Run במסוף Google Cloud , מסמנים את התיבה שמימין לפונקציה wordcount ולוחצים על Delete.